Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 18 października 2026 02:26
Zakończenie: 18 października 2026 02:30
Egzamin niezdany
Wynik: 5/40 punktów (12,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 10% podejść do kwalifikacji INF.04.
Porównanie z 24570 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
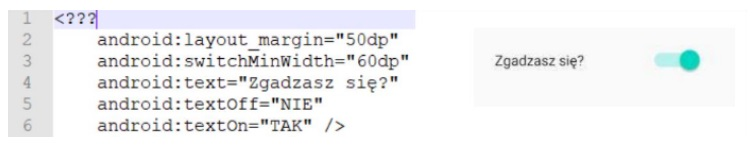
Jaką nazwę kontrolki powinno się umieścić w początkowej linii kodu, w miejscu <???, aby została ona wyświetlona w podany sposób?
A. Spinner
B. SeekBar
C. RatinoBar
D. Switch
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Switch to kontrolka używana w Androidzie do stworzenia elementu interfejsu użytkownika, który pozwala użytkownikowi przełączać się między dwoma stanami. Domyślnie stany te są identyfikowane jako włączone i wyłączone, co jest szczególnie przydatne w przypadku funkcji wymagających prostego wyboru binarnego, jak na przykład włączanie lub wyłączanie ustawień. Kod XML użyty w pytaniu zawiera atrybuty android:textOff i android:textOn, które są typowe dla klasy Switch i pozwalają zdefiniować tekst, jaki ma być wyświetlany w stanie wyłączonym i włączonym. W praktyce Switch jest często stosowany w aplikacjach mobilnych do kontroli ustawień użytkownika, co pozwala na łatwą i intuicyjną obsługę. Dobrymi praktykami jest używanie Switch w kontekście jednoznacznego wyboru, aby nie wprowadzać użytkownika w błąd. Warto również zadbać o dostępność i odpowiednie etykietowanie kontrolki, co zapewnia jej zrozumiałość dla wszystkich użytkowników.
Pytanie 2
Jakie są kluczowe różnice pomiędzy strukturą (struct) a unią (union) w języku C?
A. Unia umożliwia dynamiczne przypisywanie typów danych, struktura natomiast nie
B. Struktura wymaga więcej miejsca w pamięci niż unia
C. Struktura przechowuje wiele wartości równocześnie, unia tylko jedną
Poprawna odpowiedź
D. Unia nie jest obsługiwana przez kompilatory współczesnych języków
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Główna różnica między strukturą ('struct') a unią ('union') w języku C polega na sposobie przechowywania danych. Struktura przechowuje wszystkie pola jednocześnie, przydzielając każdemu z nich osobne miejsce w pamięci, natomiast unia używa wspólnej przestrzeni pamięci dla wszystkich swoich pól – w danym momencie można przechowywać tylko jedną wartość. Unia jest bardziej efektywna pod względem pamięci, ale mniej wszechstronna, ponieważ zmiana wartości jednego pola nadpisuje pozostałe. Struktury są powszechnie wykorzystywane w aplikacjach, gdzie konieczne jest przechowywanie wielu niezależnych danych, podczas gdy unie są używane do oszczędzania pamięci.
Pytanie 3
W frameworkach do budowy aplikacji mobilnych lub desktopowych znajduje zastosowanie wzorzec MVVM, oznaczający Model-View-ViewModel. Te podejście do programowania oznacza, że
A. interfejs użytkownika i logika aplikacji są umieszczone w jednym pliku
B. w aplikacji obecny jest jedynie interfejs użytkownika
C. kontrolki i widoki interfejsu użytkownika są zintegrowane z logiką aplikacji
D. interfejs użytkownika oraz logika aplikacji są oddzielone
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wzorzec MVVM, czyli Model-View-ViewModel, jest jednym z kluczowych podejść w architekturze aplikacji, szczególnie w kontekście aplikacji mobilnych i desktopowych. Zakłada on wyraźne rozdzielenie logiki aplikacji (Model) od warstwy prezentacji (View), z pomocą komponentu ViewModel, który działa jako mediator. Dzięki temu programiści mogą łatwiej zarządzać kodem, testować poszczególne komponenty oraz wprowadzać zmiany w interfejsie użytkownika bez wpływu na logikę aplikacji. Przykładem zastosowania MVVM jest framework WPF (Windows Presentation Foundation), w którym dane są wiązane do kontrolek w interfejsie użytkownika, co pozwala na automatyczną aktualizację widoków w przypadku zmian w modelu. Standardy takie jak Data Binding w WPF oraz Reactive Programming w Xamarin i Avalonia, pokazują, jak MVVM ułatwia rozwój aplikacji poprzez separację odpowiedzialności, co prowadzi do większej przejrzystości kodu i łatwości w jego utrzymywaniu.
Pytanie 4
Jaką cechą odznacza się framework w porównaniu do biblioteki?
A. Framework stanowi zbiór funkcji, które programista ma możliwość wykorzystania
B. Framework zapewnia API do szerszego zestawu funkcji
C. Framework określa strukturę aplikacji i zapewnia jej fundament
Poprawna odpowiedź
D. Framework oferuje funkcje użyteczne w konkretnej dziedzinie problemu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Framework dostarcza gotowy szkielet aplikacji i narzuca architekturę, zgodnie z którą programista musi budować swoją aplikację. Oferuje zestaw narzędzi i komponentów, które upraszczają rozwój oprogramowania, przy jednoczesnym ograniczeniu swobody działania. Dzięki frameworkowi, programista nie musi tworzyć aplikacji od podstaw – dostaje narzędzia, które integrują się ze sobą, co przyspiesza proces developmentu i zapewnia spójność aplikacji.
Pytanie 5
Programista pragnie wybrać algorytm, który najszybciej przetwarza dane w jego aplikacji. Na podstawie złożoności obliczeniowej przedstawionej w tabeli, należy wskazać algorytm numer
Algorytm 1
O(n²)
Algorytm 2
O(n!)
Algorytm 3
O(n³)
Algorytm 4
O(n)
Algorytm 5
O(n²)
A. 1 lub 5
B. 4
Poprawna odpowiedź
C. 2 lub 3
D. 3
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wybierając algorytm o najniższej złożoności obliczeniowej, zawsze warto patrzeć na oznaczenia w notacji dużego O. O(n) oznacza, że czas wykonywania algorytmu rośnie liniowo wraz z rozmiarem danych wejściowych. To zdecydowanie najlepszy wynik z dostępnych, szczególnie jeśli porównać do O(n²), O(n³) albo już totalnie niepraktycznego przy większych n: O(n!). Dlatego Algorytm 4, który ma złożoność O(n), to najrozsądniejszy wybór, jeśli zależy nam na szybkości działania programu. Z mojego doświadczenia, właśnie takie algorytmy są wykorzystywane np. do przetwarzania dużych zbiorów danych w aplikacjach webowych albo w sytuacjach, gdzie liczy się czas odpowiedzi dla użytkownika końcowego. W branży IT, jeśli tylko można zejść poniżej złożoności kwadratowej – raczej zawsze warto to zrobić. Oczywiście, sama złożoność to nie wszystko – czasem prostszy, liniowy algorytm może mieć duże stałe ukryte w implementacji, ale w praktyce O(n) to standard optymalny. Warto też pamiętać, że w rekrutacjach często padają pytania o takie porównania złożoności, bo to podstawowa wiedza każdego programisty. Takie podejście pozwala budować skalowalne systemy, które nie „duszą się” przy większej ilości danych. Moim zdaniem, to jedna z tych rzeczy, które naprawdę się przydają w codziennej pracy.
Pytanie 6
Który z wymienionych typów danych języka C++ jest typem stałoprzecinkowym?
A.
int
Poprawna odpowiedź
B.
long double
C.
float
D.
double
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Typ int jest w tym pytaniu właściwą odpowiedzią, bo przechowuje liczby całkowite, czyli bez części ułamkowej. W szkolnym i praktycznym uproszczeniu taki typ traktuje się jako stałoprzecinkowy: pozycja przecinka jest stała, a konkretnie znajduje się za ostatnią cyfrą liczby, więc int nie zapisze wartości typu 3,14 albo 0,5. Formalnie w standardzie C++ int należy do typów całkowitych, czyli integral types, a nie do typów zmiennoprzecinkowych. To ważne rozróżnienie, bo float, double i long double używają reprezentacji z mantysą i wykładnikiem, przez co mogą zapisywać ułamki, ale też mają problemy z zaokrągleniami.
W praktyce int stosuje się do liczników pętli, numerów opcji w menu, liczby punktów, indeksów pomocniczych czy prostych obliczeń całkowitych. Moim zdaniem warto od razu pamiętać o dobrej praktyce: jeśli rozmiar typu ma znaczenie, lepiej użyć typów z biblioteki <cstdint>, np. std::int32_t, bo zwykły int może mieć różny zakres na różnych platformach. Do rozmiarów tablic i kontenerów częściej używa się std::size_t. Najważniejsza myśl jest taka: int nie przechowuje części po przecinku, więc spośród podanych odpowiedzi najlepiej pasuje do typu stałoprzecinkowego.
Pytanie 7
Jakie znaczenie ma krajowa normalizacja dla produktów i usług?
A. Ogranicza liczbę dostępnych towarów
B. Gwarantuje lepszą zgodność oraz jakość
Poprawna odpowiedź
C. Restrukcjonuje innowacje technologiczne
D. Usuwa konieczność przeprowadzania kontroli jakości
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Normalizacja krajowa to świetny sposób na to, żeby produkty i usługi były bardziej spójne i lepszej jakości. Kiedy mamy standardy, to producenci mogą robić rzeczy, które są zgodne z wymaganiami technicznymi. To z kolei sprawia, że konsumenci mogą bardziej ufać produktom, a ryzyko, że coś będzie wadliwe, spada. Dzięki normalizacji zwiększa się bezpieczeństwo, poprawia interoperacyjność, a to wszystko wspiera rozwój technologiczny. No i jest jeszcze to, że łatwiej jest wymieniać produkty między różnymi rynkami, co ma pozytywny wpływ na całą gospodarkę.
Pytanie 8
Fragment kodu w języku JavaScript to
letmodulo=(x,y)=>x%y;
A. Prototyp interfejsu
B. Prototyp metody klasy
C. Definicja zmiennej typu tablicowego
D. Definicja funkcji strzałkowej
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Ten fragment kodu w JavaScript to klasyczny przykład funkcji strzałkowej, czyli tzw. arrow function. To funkcja zdefiniowana w bardzo nowoczesny, oszczędny sposób, który pojawił się wraz z ES6 (ECMAScript 2015). Taki zapis pozwala na szybkie tworzenie prostych funkcji anonimowych, bez potrzeby używania słowa kluczowego 'function'. Ma to ogromne znaczenie np. przy pracy z wyrażeniami funkcyjnymi, callbackami albo wszędzie tam, gdzie liczy się zwięzłość kodu. Samo 'let modulo = (x, y) => x % y;' oznacza, że tworzymy zmienną 'modulo', która przechowuje funkcję przyjmującą dwa argumenty i od razu zwracającą resztę z dzielenia x przez y. Co ciekawe, funkcje strzałkowe różnią się od tradycyjnych tym, że nie mają własnego kontekstu this (dziedziczą go z otoczenia). To jest bardzo przydatne np. przy pracy w metodach klas lub obiektach, gdzie nie chcemy nieoczekiwanej zmiany kontekstu. Moim zdaniem warto nawykowo korzystać z tej składni, bo kod robi się dużo czytelniejszy i łatwiejszy w utrzymaniu. W różnych frameworkach (np. React) funkcje strzałkowe są wręcz codziennością – definiuje się tak np. proste event handlery czy filtry. No i jeszcze jedno: taka funkcja jest idealna, gdy chcemy przekazać logikę w jednym krótkim wyrażeniu bez robienia bałaganu w kodzie.
Pytanie 9
Jakie narzędzie najlepiej sprawdza się w przekształcaniu liczby szesnastkowej na binarną?
A. Aplikacja internetowa
B. Kalkulator programisty
Poprawna odpowiedź
C. Program do arkuszy kalkulacyjnych
D. Program do edycji tekstu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Kalkulator programisty jest najbardziej odpowiednim narzędziem do konwersji liczby szesnastkowej na binarną ze względu na swoje wyspecjalizowane funkcje matematyczne i programistyczne. Narzędzia te umożliwiają użytkownikom łatwe przekształcanie różnych systemów liczbowych, w tym konwersji z systemu szesnastkowego (hex) na system binarny. Kalkulatory programistyczne często zawierają dedykowane opcje dla konwersji liczbowej, co pozwala na szybkie i dokładne uzyskanie wyników bez potrzeby stosowania skomplikowanych algorytmów lub wzorów. Na przykład, aby przekształcić liczbę szesnastkową '1A' na binarną, użytkownik wprowadza '1A' do kalkulatora, a wynik '00011010' zostaje automatycznie wygenerowany. Dodatkowo, wiele kalkulatorów programistycznych jest zgodnych z międzynarodowymi standardami, co zapewnia ich wiarygodność w obliczeniach. Warto również zauważyć, że kalkulatory programistyczne mogą obsługiwać konwersje z różnych systemów liczbowych, co czyni je wszechstronnym narzędziem w pracy z danymi cyfrowymi i kodowaniem. Dzięki temu, kalkulator programisty stanowi idealne rozwiązanie dla programistów i inżynierów, którzy regularnie pracują z różnymi formatami danych.
Pytanie 10
Jakie informacje zawiera zestaw instrukcji (ISA) danego procesora?
A. Układ połączeń między procesorem a innymi elementami
B. Typy danych, które są trzymane w pamięci
C. Metodę obsługi pamięci podręcznej
D. Instrukcje, które procesor jest w stanie wykonać
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Zestaw instrukcji, znany jako ISA, to taki jakby słownik poleceń, które procesor potrafi zrozumieć i wykonać. To mega ważny element w projektowaniu komputerów, bo to właśnie od niego zależy, jak dobrze i szybko działa system. Mamy różne rodzaje instrukcji, na przykład te do wykonywania działań matematycznych, logicznych, czy do przenoszenia danych. Popularne zestawy jak x86 albo ARM pokazują, jak programy rozmawiają z procesorem. Jak zrozumiesz ISA, to będzie łatwiej pisać lepszy kod i dostosowywać aplikacje do różnych architektur. No i co ważne, ISA też mówi, jak procesor interpretuje te instrukcje i zarządza danymi, co ma ogromny wpływ na to, jak wydajnie wszystko działa.
Pytanie 11
Który z wymienionych elementów stanowi przykład złożonego typu danych?
A.
char
B.
struct
Poprawna odpowiedź
C.
bool
D.
int
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Typ 'struct' w C++ to super sprawa, bo pozwala na trzymanie różnych danych pod jedną nazwą. Dzięki temu można łatwo zorganizować zmienne, które różnią się typami. Wyobraź sobie, że możesz stworzyć strukturę, która będzie reprezentować na przykład samochód z jego marką, rocznikiem i ceną. To naprawdę ułatwia pracę z danymi! Każde pole w strukturze może mieć inny typ, co czyni 'struct' bardzo uniwersalnym narzędziem do modelowania różnych obiektów, jak ludzie czy produkty. W zasadzie, to takie logiczne pudełko, do którego wrzucasz różne informacje i masz do nich szybki dostęp.
Pytanie 12
Który z wymienionych parametrów określa prędkość procesora?
A. Wielkość pamięci podręcznej
B. Częstotliwość taktowania
Twoja odpowiedź
C. Liczba rdzeni
D. Rodzaj złącza
Poprawna odpowiedź. Częstotliwość taktowania procesora, wyrażana najczęściej w gigahercach (GHz), jest kluczowym parametrem opisującym szybkość działania jednostki centralnej. Określa, ile cykli zegara procesor jest w stanie wykonać w ciągu jednej sekundy. Wyższa częstotliwość oznacza większą ilość operacji, które procesor może przetworzyć w danym czasie, co bezpośrednio wpływa na jego wydajność. Przykładowo, procesor o częstotliwości 3,0 GHz może wykonać 3 miliardy cykli na sekundę, co sprawia, że jest w stanie przeprowadzać bardziej skomplikowane obliczenia i efektywniej zarządzać zadaniami. W praktyce jednak sama częstotliwość nie jest jedynym wskaźnikiem wydajności; istotne są też inne czynniki, takie jak architektura procesora, liczba rdzeni czy szybkość pamięci RAM. Standardy, takie jak Intel Core i9 czy AMD Ryzen 5000, dostarczają informacji na temat maksymalnej częstotliwości taktowania, co pozwala konsumentom lepiej dobierać sprzęt do swoich potrzeb. Warto również zauważyć, że wielu nowoczesnych procesorów stosuje technologię Turbo Boost, która pozwala na chwilowe zwiększenie częstotliwości w celu uzyskania lepszej wydajności przy intensywnych obciążeniach.
Pytanie 13
Wskaż właściwość charakterystyczną dla metody abstrakcyjnej?
A. zawsze jest prywatna
B. jest pusta w klasach dziedziczących
C. jest pusta w klasie nadrzędnej
D. nie ma implementacji w klasie bazowej
Twoja odpowiedź
Poprawna odpowiedź. Metoda abstrakcyjna to taki specjalny rodzaj metody, który pojawia się w programowaniu obiektowym, głównie w językach jak Java, C# czy Python (tam nazywa się abstractmethod). Jej kluczową właściwością jest to, że nie ma własnej implementacji w klasie bazowej, czyli tej nadrzędnej. To trochę jakby ktoś powiedział: 'Hej, tutaj powinna być jakaś funkcja, ale jeszcze nie wiem, jak dokładnie ma działać – niech ktoś, kto będzie po mnie dziedziczył po tej klasie, sam ją zdefiniuje.' Dzięki temu daje się klasom pochodnym jasny sygnał, że muszą tę metodę zaimplementować, żeby klasa mogła poprawnie funkcjonować. W praktyce, jeśli próbujesz stworzyć obiekt klasy bazowej zawierającej metody abstrakcyjne, kompilator się obrazi (no, rzuci wyjątkiem albo nawet nie pozwoli na kompilację). Moim zdaniem to bardzo praktyczne podejście, bo wymusza spójność w architekturze kodu – każdy, kto dziedziczy po klasie bazowej, nie może zapomnieć o kluczowych metodach. Standardy branżowe, jak SOLID, promują taką separację odpowiedzialności i abstrakcję, dzięki czemu kod jest czytelniejszy i łatwiejszy do rozbudowy. Przykładowo, jeśli masz klasę abstrakcyjną 'Figura', to metoda obliczPole() nie ma sensu bez konkretnej figury, więc w klasie bazowej zostaje abstrakcyjna, a dopiero w 'Kwadracie' czy 'Kole' dostaje realną implementację. Z mojego doświadczenia, takie podejście bardzo pomaga, kiedy projekt robi się większy, bo jasno wiadomo, co jeszcze trzeba dopisać w klasach pochodnych. Jest to wręcz obowiązkowe w wielu wzorcach projektowych, na przykład w strategii albo szablonie metody.
Pytanie 14
Jaką wartość zwróci funkcja napisana w języku C++, jeżeli jej argumentem wejściowym jest tablica stworzona w następujący sposób:
Poprawna odpowiedź. Rozwiązując takie zadania, warto nauczyć się dokładnie patrzeć na strukturę kodu. Funkcja fun1 przyjmuje tablicę intów i sumuje jej elementy. Tu pętla for przechodzi po wszystkich sześciu indeksach – od 0 do 5. Gdy podmienisz na liczby z zadania: 3, 4, 2, 4, 10 oraz 0 – po prostu dodajesz te wartości do siebie. Suma wychodzi 23. Czyli wynik funkcji to właśnie 23. To taki bardzo typowy przykład sumowania elementów tablicy – nie tylko na lekcjach, ale praktycznie wszędzie, np. jak liczysz sumę zamówień w sklepie internetowym albo punkty gracza w grze. Jeśli chodzi o dobre praktyki w C++, to warto wiedzieć, że lepiej przekazywać tablicę z dodatkowym parametrem długości, żeby nie robić magicznych liczb jak to '6' w pętli – można się wtedy łatwo pomylić przy zmianie rozmiaru. Moim zdaniem dobrze jest od razu przyswoić sobie nawyk wykorzystywania std::vector zamiast „gołych” tablic, bo są bezpieczniejsze i elastyczniejsze. To już taki krok w stronę kodu produkcyjnego. Ale podsumowując – jeśli widzisz tak napisany kod, to zawsze patrz, ile razy pętla się wykona i jakie są wartości w tablicy. Tylko tyle i aż tyle. W praktyce ta umiejętność przekłada się na szybkie debugowanie i pisanie niezawodnych programów.
Pytanie 15
Przeprowadzając analizę kodu interfejsu graficznego napisanego w języku XAML, można zauważyć, że:
A. obraz znajduje się po lewej stronie, a pozostałe elementy po prawej
B. elementy: tekst, obraz, przycisk Like, przycisk Share, tekst są ułożone jeden pod drugim
Twoja odpowiedź
C. przyciski są ustawione poziomo obok siebie
Poprawna odpowiedź
D. tekst "Fotograf" znajduje się po prawej stronie obrazu
Niepoprawna odpowiedź. Analizując przedstawione opcje, możemy zauważyć kilka nieporozumień dotyczących sposobu układania elementów w XAML przy użyciu StackLayout. Pierwsza niepoprawna koncepcja sugeruje, że napis "Fotograf" jest położony po prawej stronie obrazu, co nie jest zgodne z rzeczywistym układem. W przypadku orientacji pionowej, jaką posiada zewnętrzny StackLayout, elementy są układane jeden pod drugim, co oznacza, że "Fotograf" znajduje się nad obrazem, a nie po jego prawej stronie. Druga koncepcja twierdzi, że wszystkie elementy są ułożone jeden pod drugim, co częściowo jest prawdą dla zewnętrznego układu, ale ignoruje fakt, że wewnętrzny StackLayout zawiera przyciski ułożone poziomo. Trzecia opcja była poprawna, co już omówiono powyżej. Czwarta nieprawidłowa koncepcja sugeruje, że obraz znajduje się po lewej, a inne elementy po prawej stronie, co nie odpowiada specyfice układu pionowego w StackLayout. Błędne myślenie często wynika z niewłaściwego rozumienia hierarchii i interakcji między zagnieżdżonymi układami w XAML. Zrozumienie, jak działa orientacja w StackLayout, jest kluczem do uniknięcia takich błędów i efektywnego projektowania interfejsów użytkownika.
Pytanie 16
Która metoda w obrębie klasy jest uruchamiana automatycznie podczas tworzenia kopii obiektu?
A. Metoda statyczna
B. Konstruktor kopiujący
Twoja odpowiedź
C. Metoda zaprzyjaźniona
D. Destruktor
Poprawna odpowiedź. Konstruktor kopiujący to taka specyficzna metoda w klasie, która działa, kiedy robimy nowy obiekt jako kopię już istniejącego. Dzięki temu możemy skopiować wartości pól z jednego obiektu do drugiego. To naprawdę ważne, zwłaszcza gdy mówimy o zarządzaniu pamięcią. Na przykład w C++ może to wyglądać tak: `Samochod(const Samochod &inny) { marka = inny.marka; przebieg = inny.przebieg; }`. Konstruktor kopiujący ma na celu uniknięcie problemów związanych z tzw. płytkim kopiowaniem, co może prowadzić do różnych błędów, jak wielokrotne zwolnienie tej samej pamięci. Generalnie mówiąc, jest to kluczowy mechanizm, który pomaga utrzymać bezpieczeństwo i poprawność działania naszej aplikacji.
Pytanie 17
Jakie metody umożliwiają przesyłanie danych z serwera do aplikacji front-end?
A. biblioteki jQuery
B. formatu JSON
Twoja odpowiedź
C. protokołem SSH
D. metody POST
Poprawna odpowiedź. JSON, czyli JavaScript Object Notation, to dość lekki format wymiany danych. Jest prosty do zrozumienia zarówno dla ludzi, jak i komputerów. To dlatego jest tak popularny w aplikacjach webowych, gdzie przesyła się dane między serwerem a klientem. Dzięki strukturze klucz-wartość łatwo jest mapować obiekty w JavaScript, co przyspiesza cały proces z danymi. Pomysł na zastosowanie? Na przykład, gdy przesyłasz dane użytkownika z serwera do swojej aplikacji, to często zamieniasz obiekt JavaScript na format JSON i wysyłasz go przez AJAX. A co ważne, JSON jest zgodny z różnymi standardami, więc możesz go używać praktycznie wszędzie. Co ciekawe, w nowoczesnych aplikacjach JSON jest zdecydowanie bardziej popularny niż XML, bo jest prostszy i mniej obciążający dla sieci. To wszystko sprawia, że strony ładują się szybciej, a użytkownicy mają lepsze doświadczenia.
Pytanie 18
Które z wymienionych działań, które są częścią procesu kreowania prostej galerii zdjęć w formie aplikacji mobilnej, powinno być realizowane przez zespół?
A. Wdrożenie funkcji dodajZdjecie()
Twoja odpowiedź
B. Przygotowanie i konfiguracja repozytorium dla projektu
C. Przygotowanie testu jednostkowego dla funkcji przegladajZdjecia()
D. Stworzenie dokumentacji kodu aplikacji
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe odpowiedzi są zadaniami, które w większości przypadków mogą być realizowane indywidualnie, co czyni je zadaniami jednostkowymi. Implementacja funkcji dodajZdjecie() dotyczy konkretnego aspektu programistycznego, który może być wykonany przez jednego dewelopera. Wymaga ona znajomości języka programowania oraz logiki potrzebnej do dodawania zdjęć do galerii, co zazwyczaj nie wymaga współpracy z innymi członkami zespołu. Przygotowanie i skonfigurowanie repozytorium dla projektu natomiast to techniczny proces, który również najczęściej realizuje jedna osoba, odpowiedzialna za ustawienie środowiska pracy. Tworzenie testu jednostkowego dla funkcji przegladajZdjecia() to kolejny krok, który można wykonać samodzielnie, koncentrując się na testowaniu konkretnej funkcji w izolacji, bez potrzeby angażowania innych programistów. W przypadku tych zadań, choć mogą one być częścią większego projektu, to ich realizacja nie wymaga współpracy zespołowej, co sprawia, że nie są to zadania zespołowe.
Pytanie 19
Jakie polecenie w Gicie jest używane do zapisywania zmian w lokalnym repozytorium?
A. git clone
B. git push
C. git commit
Poprawna odpowiedź
D. git pull
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie 'git commit' zapisuje zmiany w lokalnym repozytorium Git. Jest to kluczowy krok w procesie kontroli wersji, ponieważ każdy commit tworzy nową migawkę (snapshot) projektu, która może być w przyszłości przywrócona lub porównana z innymi wersjami. Polecenie to jest często używane razem z opcją -m, która umożliwia dodanie wiadomości opisującej zmiany. Dzięki temu możliwe jest efektywne śledzenie historii zmian w projekcie i przywracanie wcześniejszych wersji w razie potrzeby. Git commit to podstawowe narzędzie w pracy zespołowej nad kodem, szczególnie w środowisku deweloperskim, gdzie wersjonowanie jest niezbędne do zapewnienia stabilności kodu i łatwej współpracy.
Pytanie 20
Który z podanych terminów najlepiej odnosi się do składnika statycznego w klasie?
A. Metoda z dostępem ograniczonym tylko do tej samej klasy
B. Pole lub metoda, która jest przypisana do klasy, a nie do jej instancji
Poprawna odpowiedź
C. Funkcja, która wywołuje destruktor danej klasy
D. Zmienna lokalna wewnątrz danej klasy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Składnik statyczny klasy to pole lub metoda, która należy do klasy jako całości, a nie do konkretnego obiektu. Oznacza to, że istnieje tylko jedna kopia składnika statycznego współdzielona przez wszystkie obiekty tej klasy. Przykład w C++: `class Licznik { public: static int liczbaObiektow; }`. Zmienna `liczbaObiektow` przechowuje liczbę utworzonych instancji klasy i jest wspólna dla wszystkich obiektów. Składniki statyczne są często używane do implementacji liczników, zarządzania zasobami lub przechowywania danych globalnych w obrębie klasy.
Pytanie 21
Który z poniższych elementów nie jest związany z architekturą mikroserwisów?
A. Komunikacja przez API
B. Monolityczny kod źródłowy
Poprawna odpowiedź
C. Skalowalność poszczególnych usług
D. Niezależne wdrażanie usług
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Monolityczny kod źródłowy to podejście, w którym wszystkie komponenty aplikacji są ze sobą ściśle powiązane i zintegrowane w jedną całość. W przeciwieństwie do architektury mikroserwisów, która pozwala na budowę systemów jako zbioru niezależnych usług, monolityczne podejście ogranicza możliwości rozwoju i skalowania aplikacji. W mikroserwisach poszczególne usługi mogą być rozwijane, wdrażane i skalowane niezależnie od siebie, co zwiększa elastyczność i skraca czas realizacji. Przykładem zastosowania architektury mikroserwisów może być serwis e-commerce, w którym oddzielne mikroserwisy obsługują płatności, zarządzanie produktami i wysyłkę. Dzięki temu, jeśli chcemy wprowadzić zmiany w systemie płatności, możemy to zrobić bez wpływu na inne obszary aplikacji. Warto również zauważyć, że podejście to umożliwia lepsze zarządzanie zespołami deweloperskimi, które mogą pracować równolegle nad różnymi usługami, co przyspiesza proces dostarczania wartości dla użytkowników.
Wyjaśnienie poprawnej odpowiedzi: Kod przedstawiony w pytaniu to klasyczny przykład wykorzystania komponentu Switch w Androidzie. Switch, jak sama nazwa wskazuje, służy do przełączania między dwoma stanami — najczęściej włącz/wyłącz, aktywne/nieaktywne. Z punktu widzenia interfejsów mobilnych, przełącznik bardzo często znajduje zastosowanie w ustawieniach aplikacji, np. do szybkiego włączania trybu ciemnego, aktywacji powiadomień czy zezwalania na lokalizację. Ten konkretny xml zawiera podstawowe atrybuty, jak android:id, layout_width, layout_height oraz background, czyli kolor tła, co od razu sugeruje, że nie jest to np. dropdown czy suwak. Co ciekawe, Switch różni się od CheckBoxa tym, że wizualnie lepiej komunikuje zmianę trybu (przesuwający się znacznik), co moim zdaniem zwiększa użyteczność, szczególnie jeśli użytkownik ma szybko zrozumieć, co ustawia. Standardy Material Design wręcz zalecają stosowanie Switch do kontrolowania pojedynczych ustawień, bo jest to bardziej czytelne niż inne widgety. Warto pamiętać, że Switch ma różne warianty i można go rozbudować o obsługę zdarzeń onCheckedChangeListener w kodzie Java albo Kotlin, przez co staje się bardzo elastyczny. Odpowiedź przełącznik jest więc zgodna ze wszystkimi cechami tej kontrolki i jej zastosowaniami w praktyce.
Pytanie 23
Jakie są główne różnice między środowiskiem RAD (Rapid Application Development) a klasycznymi IDE w odniesieniu do aplikacji mobilnych?
A. RAD koncentruje się wyłącznie na procesie debugowania aplikacji
B. RAD pozwala na szybsze budowanie aplikacji dzięki narzędziom do wizualnego designu i automatycznego generowania kodu
Poprawna odpowiedź
C. RAD działa tylko na urządzeniach z systemem iOS
D. RAD nie obsługuje interfejsu użytkownika
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: RAD (Rapid Application Development) umożliwia szybsze tworzenie aplikacji mobilnych dzięki narzędziom do wizualnego projektowania i automatycznego generowania kodu. RAD koncentruje się na iteracyjnym podejściu do rozwoju oprogramowania, w którym prototypy są budowane i testowane w krótkich cyklach, co pozwala na szybkie dostosowywanie aplikacji do zmieniających się wymagań użytkowników. W kontekście aplikacji mobilnych, RAD skraca czas tworzenia poprzez graficzne narzędzia do budowy interfejsów, gotowe komponenty oraz integrację z backendem. Frameworki RAD, takie jak OutSystems, Mendix czy Flutter, pozwalają na szybkie wdrażanie i modyfikację aplikacji mobilnych, co znacząco zwiększa efektywność programistów.
Pytanie 24
Która z wymienionych bibliotek pozwala na obsługę zdarzeń związanych z myszą w aplikacjach desktopowych?
A. Numpy
B. TensorFlow
C. Qt
Poprawna odpowiedź
D. Django
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Qt to jedna z najpopularniejszych bibliotek, która umożliwia obsługę zdarzeń myszy i klawiatury w aplikacjach desktopowych. Dzięki Qt możliwe jest tworzenie interaktywnych aplikacji, które reagują na kliknięcia, przesunięcia kursora oraz inne zdarzenia generowane przez urządzenia wejściowe. Qt oferuje obszerną dokumentację i gotowe klasy, takie jak QPushButton, QLabel czy QSlider, które mogą nasłuchiwać zdarzeń i dynamicznie zmieniać stan aplikacji. Co więcej, Qt pozwala na implementację niestandardowych zdarzeń i tworzenie zaawansowanych interfejsów graficznych, które są w pełni interaktywne i responsywne.
Pytanie 25
Który z poniższych przykładów stanowi aplikację mobilną wykorzystującą bazę danych?
A. Aplikacja wyświetlająca lokalny czas
B. Aplikacja gromadząca listę kontaktów użytkownika
Poprawna odpowiedź
C. Aplikacja do robienia zdjęć
D. Aplikacja kalkulator
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Aplikacja przechowująca listę kontaktów użytkownika korzysta z bazy danych do przechowywania, odczytywania i zarządzania danymi. Tego typu aplikacje mobilne muszą efektywnie zarządzać dużą ilością danych i zapewniać ich szybki dostęp. Bazy danych, takie jak SQLite czy Firebase, są szeroko stosowane w aplikacjach mobilnych, umożliwiając przechowywanie kontaktów, wiadomości, notatek i innych informacji użytkownika. Dzięki bazom danych możliwe jest także synchronizowanie danych pomiędzy urządzeniami i przechowywanie ich w chmurze.
Pytanie 26
Który z poniższych elementów UI umożliwia graficzną nawigację pomiędzy różnymi sekcjami aplikacji?
A. Rozwijana lista
B. Menu
Poprawna odpowiedź
C. Obszar tekstowy
D. Przycisk opcji
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Pasek menu to kluczowy element interfejsu użytkownika, który umożliwia wizualną nawigację pomiędzy różnymi sekcjami aplikacji. Paski menu są powszechnie stosowane w aplikacjach desktopowych i mobilnych, ponieważ pozwalają na szybki dostęp do różnych funkcji oraz ustawień. Dzięki ich hierarchicznej strukturze użytkownicy mogą łatwo odnaleźć potrzebne narzędzia i opcje, co zwiększa intuicyjność i wygodę korzystania z aplikacji.
Pytanie 27
Która z poniższych nie jest poprawną metodą HTTP?
A. DELETE
B. GET
C. SEARCH
Poprawna odpowiedź
D. POST
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź SEARCH jest prawidłowa, ponieważ metoda ta nie jest uznawana za standardową metodę HTTP określoną w dokumentach specyfikacji HTTP. W protokole HTTP, który jest podstawą komunikacji w Internecie, istnieje zestaw standardowych metod, takich jak GET, POST i DELETE. GET służy do pobierania zasobów z serwera, POST do wysyłania danych na serwer, a DELETE do usuwania zasobów. Metoda SEARCH nie znajduje się w dokumentacji IETF dotyczącej HTTP, co oznacza, że nie jest zdefiniowana ani szeroko stosowana w praktyce. Warto zwrócić uwagę na to, że standardowe metody HTTP są kluczowe w projektowaniu API oraz architekturze aplikacji webowych, ponieważ zapewniają one spójność i przewidywalność w interakcji z serwerami. Znajomość tych metod jest niezbędna dla programistów pracujących z RESTful API, gdzie poprawne użycie metod HTTP ma kluczowe znaczenie dla efektywności i bezpieczeństwa aplikacji.
Pytanie 28
Co to jest IndexedDB?
A. Format indeksowania danych w bazach NoSQL
B. Indeks danych używany przez wyszukiwarki internetowe
C. System zarządzania bazami SQL w aplikacjach backendowych
D. Niskopoziomowe API do przechowywania dużych ilości danych w przeglądarce użytkownika
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: IndexedDB to niskopoziomowe API, które umożliwia przechowywanie dużych ilości danych bezpośrednio w przeglądarce użytkownika. Dzięki temu programiści mogą tworzyć aplikacje webowe, które wykorzystują lokalne bazy danych, co pozwala na szybki dostęp do informacji, a także na pracę offline. IndexedDB jest asynchroniczny, co oznacza, że operacje na bazie danych nie blokują interfejsu użytkownika, co jest zgodne z dobrymi praktykami w tworzeniu responsywnych aplikacji webowych. Przykłady zastosowania to aplikacje e-commerce, które mogą przechowywać historię zakupów czy koszyk użytkownika lokalnie, co zwiększa wydajność i komfort użytkowania. Warto również zwrócić uwagę, że IndexedDB obsługuje obiekty JavaScript, co umożliwia przechowywanie złożonych struktur danych. Standardy związane z IndexedDB są częścią W3C i są szeroko wspierane przez nowoczesne przeglądarki, co czyni tę technologię wiarygodnym rozwiązaniem do przetwarzania danych w aplikacjach webowych.
Pytanie 29
Zamieszczony kawałek kodu w języku C# tworzy hasło. Wskaż prawdziwe stwierdzenie dotyczące cech tego hasła?
A. Może zawierać małe i wielkie litery oraz cyfry.
Poprawna odpowiedź
B. Może zawierać małe oraz wielkie litery, cyfry i znaki specjalne.
C. Ma 8 znaków lub więcej i zawiera małe oraz wielkie litery, a także cyfry.
D. Ma maksymalną długość 7 znaków, co ustala zmienna i.
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Fragment programu w języku C# generuje hasło, które zawiera małe i wielkie litery oraz cyfry. W kodzie widzimy, że zmienna pulaZnakow zawiera wszystkie małe litery alfabetu, wszystkie wielkie litery oraz cyfry od 0 do 9. Zmienna dlPuli przechowuje długość ciągu znaków, co umożliwia losowe wybieranie znaków z pełnego zakresu dostępnych znaków. W pętli for odbywa się iteracja 8 razy, co oznacza, że każde generowane hasło ma długość 8 znaków. Każdy znak jest losowo wybierany z puli, co zapewnia różnorodność i brak uprzedzeń w doborze znaków. Warto również zwrócić uwagę na praktyczne użycie klasy Random, która jest standardem w przypadkowej generacji danych w C#. Takie podejście jest zgodne z najlepszymi praktykami, gdzie hasła powinny mieć różnorodne znaki, co zwiększa ich siłę i trudność złamania. Dobrym pomysłem jest również dodanie symboli specjalnych dla jeszcze większego bezpieczeństwa, co można łatwo zaimplementować modyfikując pule dostępnych znaków.
Pytanie 30
Które z wymienionych praw autorskich nie wygasa po pewnym czasie?
A. Autorskie prawa osobiste
Poprawna odpowiedź
B. Licencje wolnego oprogramowania
C. Prawa pokrewne
D. Autorskie prawa majątkowe
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Autorskie prawa osobiste to rodzaj praw autorskich, które nie wygasają po upływie określonego czasu i są bezterminowe. Obejmują one prawo do autorstwa, oznaczania dzieła swoim nazwiskiem oraz sprzeciwiania się wszelkim zmianom, które mogłyby naruszać reputację twórcy. Prawa osobiste są niezbywalne, co oznacza, że nie można ich przenieść na inną osobę ani sprzedać. Nawet po śmierci twórcy, prawo do ochrony integralności jego dzieła jest respektowane. W praktyce oznacza to, że choć prawa majątkowe mogą wygasnąć (np. po 70 latach od śmierci autora), prawo do bycia uznanym za twórcę trwa wiecznie.
Pytanie 31
Która z poniższych metod HTTP jest idempotentna?
A. CONNECT
B. PATCH
C. GET
Poprawna odpowiedź
D. POST
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Metoda GET jest uznawana za idempotentną, co oznacza, że wielokrotne wykonanie tej samej operacji nie zmienia stanu zasobu na serwerze. W praktyce, jeżeli wysyłamy zapytanie GET do określonego zasobu, niezależnie od tego, ile razy je powtórzymy, zwróci ono tę samą odpowiedź oraz nie wpłynie na stan zasobu. Wykorzystanie metody GET jest powszechne w aplikacjach webowych, na przykład podczas ładowania strony, gdzie użytkownik chce pobrać informacje, takie jak artykuły lub dane z bazy. Zgodnie z zasadami RESTful, metody idempotentne powinny być stosowane w przypadkach, gdy zależy nam na stabilności i przewidywalności działania systemu. Przykładem zastosowania metody GET w praktyce może być API, które zwraca szczegóły użytkownika na podstawie jego identyfikatora. W takim przypadku, wywołanie GET na danym URI zawsze zwróci te same dane, o ile nie nastąpią zmiany w bazie danych.
Pytanie 32
Przykład wywołania funkcji zamien w języku C++ może wyglądać w następujący sposób:
voidzamien(int *a, int *b) {inttmp;tmp= *a;
*a= *b;
*b=tmp;}
A.
zamien(&a,&b);// a, b - zmienne całkowite
Poprawna odpowiedź
B.
zamien(12,34)
C.
zamien(*a,*b);// a, b - zmienne całkowite
D.
zamien(m,n);// m, n - zmienne całkowite
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W tym przypadku wywołanie zamien(&a, &b); jest prawidłowe, bo funkcja zamien oczekuje wskaźników do zmiennych całkowitych, nie samych wartości tych zmiennych ani ich referencji. Przekazując adresy przez &a i &b, pozwalamy funkcji modyfikować oryginalne zmienne, a nie ich kopie. To jest fundament operacji wskaźnikowych w C++. Takie podejście umożliwia tzw. przekazywanie przez adres, które jest wykorzystywane wszędzie tam, gdzie trzeba w funkcji podmienić faktyczną zawartość zmiennej, a nie tylko jej kopię. W praktyce, na przykład podczas sortowania tablic czy zamiany miejscami dwóch wartości, korzysta się właśnie z takiego mechanizmu. Przekazywanie wskaźników jest bardzo uniwersalne – pozwala nie tylko zmieniać wartości, ale też np. przekazywać duże struktury bez kopiowania całej ich zawartości, co przyspiesza program i zmniejsza zużycie pamięci. Moim zdaniem warto też zauważyć, że użycie wskaźników jest jednym z filarów programowania na niskim poziomie w C i C++. Wielu początkujących programistów boi się wskaźników (nie wiem czemu, chyba przez te wszystkie historie o błędach i segfaultach), ale jak się już zrozumie, dlaczego i jak przekazywać adresy zmiennych, to potem dużo łatwiej korzystać z bardziej zaawansowanych mechanizmów np. dynamicznej alokacji pamięci czy tablic wskaźników. Standard C++ wręcz zaleca, by wszędzie tam, gdzie funkcja ma zmienić przekazane wartości, używać wskaźników lub referencji. W tym przypadku wskaźniki są idealne, bo dokładnie tego wymaga deklaracja funkcji. Dobrze jest też znać różnicę między przekazywaniem przez wartość, wskaźnik i referencję, bo to pozwala świadomie projektować interfejsy funkcji.
Pytanie 33
Jaki będzie wynik działania poniższego kodu JavaScript?
letx=5;lety='10';console.log(x+y);
A. error
B. 510
Poprawna odpowiedź
C. undefined
D. 15
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wynik działania podanego kodu to 510, co może być zaskakujące dla osób nieznających typów danych w JavaScript. W tym przypadku zmienna x jest liczbą całkowitą (5), a zmienna y jest łańcuchem tekstowym ('10'). Kiedy używamy operatora + w JavaScript, następuje tzw. "przesunięcie typów". Gdy jeden z operandów jest łańcuchem, to JavaScript konwertuje pozostałe typy na łańcuch, a następnie wykonuje konkatenację. W efekcie 5 konwertowane jest na '5', a wynik końcowy to '5' + '10', co daje '510'. To zachowanie jest zgodne z regułami języka JavaScript i jego dynamicznym typowaniem. Warto zwrócić uwagę, że taka konwersja może prowadzić do niezamierzonych wyników, dlatego ważne jest, aby zrozumieć, kiedy i jak działają operatory w JavaScript. Dla większej jasności, w sytuacjach, gdy chcemy dodać dwie liczby, lepiej jest upewnić się, że obie zmienne mają ten sam typ danych, np. przez użycie funkcji parseInt() lub parseFloat().
Pytanie 34
Który z wymienionych algorytmów najczęściej wykorzystuje rekurencję?
A. Obliczanie liczb Fibonacciego
Poprawna odpowiedź
B. Wyszukiwanie liniowe
C. Sortowanie przez wstawianie
D. Sortowanie bąbelkowe
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Algorytmy obliczania liczb Fibonacciego są jednym z najbardziej klasycznych przykładów rekurencji. Algorytm ten polega na wywoływaniu funkcji, która sama odwołuje się do siebie, aby obliczyć kolejne liczby w sekwencji. Rekurencyjna natura obliczeń Fibonacciego sprawia, że algorytm jest prosty i intuicyjny w implementacji, choć może być mniej wydajny niż wersje iteracyjne. Rekurencja jest szeroko stosowana w problemach matematycznych i algorytmicznych, gdzie rozwiązanie większego problemu można uzyskać poprzez rozwiązywanie mniejszych, podobnych podproblemów.
Pytanie 35
Zasada programowania obiektowego, która polega na ukrywaniu elementów klasy tak, aby były one dostępne wyłącznie dla metod tej klasy lub funkcji zaprzyjaźnionych, to
A. dziedziczenie
B. polimorfizm
C. hermetyzacja
Poprawna odpowiedź
D. wyjątki
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Hermetyzacja to taka esencja programowania obiektowego, która polega na ukrywaniu szczegółów implementacyjnych wewnątrz klasy. Dzięki temu tylko wybrane fragmenty kodu mają dostęp do danych czy metod, które faktycznie powinny być widoczne na zewnątrz. W praktyce sprowadza się to do korzystania z modyfikatorów dostępu, takich jak private, protected czy public, co jest podstawą w językach takich jak Java, C++ czy C#. Daje to ogromną przewagę, bo ochrania dane przed przypadkowymi (albo celowymi!) zmianami z zewnątrz. Z mojego doświadczenia wynika, że dobrze zaprojektowana hermetyzacja sprawia, że kod jest bardziej przejrzysty i łatwiejszy do testowania i utrzymania. Przykład? Załóżmy, że mamy klasę KontoBankowe i chcemy, żeby saldo dało się zmieniać tylko poprzez wpłatę i wypłatę, a nie żeby każdy mógł ustawić dowolną kwotę. Wtedy pole 'saldo' robimy private, a dostęp dajemy przez metody public wpłata() i wypłata(). Branżowe praktyki, np. SOLID, wręcz podkreślają wagę hermetyzacji. Ułatwia to też refaktoryzację – jeśli coś zmienisz w środku klasy, a interfejs zewnętrzny zostaje taki sam, reszta programu nawet nie zauważy. Także, moim zdaniem, bez hermetyzacji nie ma sensownego programowania obiektowego – to absolutna podstawa.
Pytanie 36
Który aspekt projektu aplikacji jest kluczowy dla zabezpieczenia danych użytkowników?
A. Pominięcie testowania aplikacji w etapie produkcji
B. Zastosowanie zaawansowanych systemów ochrony
Poprawna odpowiedź
C. Koncentracja na wyglądzie interfejsu użytkownika
D. Tworzenie prostych formularzy do rejestracji
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Stosowanie zaawansowanych mechanizmów bezpieczeństwa jest kluczowe dla ochrony danych użytkowników w aplikacjach. Wdrożenie technologii takich jak szyfrowanie, autoryzacja dwuskładnikowa (2FA), firewalle oraz regularne testy penetracyjne pozwala na minimalizację ryzyka ataków i naruszeń danych. Mechanizmy te nie tylko zabezpieczają dane, ale również budują zaufanie użytkowników do aplikacji, co jest niezwykle istotne w branżach takich jak bankowość, medycyna czy e-commerce.
Pytanie 37
Który typ testów jest wykonywany na pojedynczych komponentach lub funkcjach w izolacji?
A. Testy systemowe
B. Testy jednostkowe
Poprawna odpowiedź
C. Testy akceptacyjne
D. Testy integracyjne
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Testy jednostkowe to podstawowy rodzaj testów, które koncentrują się na weryfikacji pojedynczych komponentów lub funkcji aplikacji w izolacji. Ich celem jest upewnienie się, że dany element kodu działa zgodnie z oczekiwaniami. Przykładowo, jeśli mamy funkcję, która oblicza sumę dwóch liczb, test jednostkowy sprawdzi, czy ta funkcja poprawnie zwraca wynik dla różnych zestawów danych wejściowych. Zastosowanie testów jednostkowych jest kluczowe w nowoczesnym programowaniu, ponieważ pozwala na szybkie wykrywanie błędów na wczesnym etapie rozwoju oprogramowania. Dzięki nim można również łatwiej wprowadzać zmiany w kodzie, gdyż mając pewność, że pojedyncze komponenty działają prawidłowo, można modyfikować całą aplikację bez obaw o wprowadzenie nowych błędów. W praktyce, testy jednostkowe są często zautomatyzowane i stanowią integralną część ciągłej integracji (CI), co pozwala na szybkie i efektywne testowanie kodu przy każdej zmianie. Dobre praktyki w zakresie testów jednostkowych obejmują pisanie testów przed właściwą implementacją kodu (tzw. TDD - Test Driven Development) oraz stosowanie odpowiednich narzędzi, takich jak JUnit dla Javy czy NUnit dla .NET.
Pytanie 38
Co to jest JWT (JSON Web Token)?
A. Format zapisu danych używany w bazach NoSQL
B. Standard definiujący sposób bezpiecznego przekazywania informacji jako obiekt JSON
Poprawna odpowiedź
C. Protokół komunikacyjny do transferu danych między klientem a serwerem
D. Biblioteka JavaScript do walidacji formularzy webowych
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: JWT, czyli JSON Web Token, jest standardem, który definiuje sposób bezpiecznego przekazywania informacji między dwiema stronami w postaci obiektu JSON. Tokeny JWT są powszechnie wykorzystywane w systemach autoryzacji i autoryzacji, umożliwiając przekazywanie zweryfikowanych i podpisanych danych. Struktura tokena składa się z trzech części: nagłówka, ładunku (payload) oraz podpisu. Nagłówek zazwyczaj określa typ tokena oraz algorytm użyty do podpisania, ładunek zawiera dane, które chcemy przesłać, a podpis jest generowany przy użyciu tajnego klucza, co zapewnia integralność danych. Przykładem zastosowania JWT może być system logowania, gdzie po pomyślnym zalogowaniu użytkownik otrzymuje token, który jest następnie używany do autoryzacji kolejnych zapytań do serwera. Dzięki swojej strukturze, JWT nie tylko zwiększa bezpieczeństwo, ale także umożliwia łatwą wymianę informacji między różnymi systemami, co jest szczególnie ważne w architekturach mikroserwisowych.
Pytanie 39
W przedstawionym filmie ukazano kreator interfejsu użytkownika, dla którego automatycznie powstaje
A. obsługa wciśniętego przycisku
B. kod Java
C. obsługa przycisku ekranu dotykowego
D. kod XML
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Kod XML jest obecnie najczęściej stosowanym formatem do definiowania wyglądu interfejsów użytkownika w takich narzędziach jak Android Studio czy różnego rodzaju designery graficzne. Kiedy projektujesz layout aplikacji mobilnej albo desktopowej, duża część nowoczesnych narzędzi tworzy właśnie pliki XML, które następnie są interpretowane przez system w czasie uruchamiania aplikacji. Ułatwia to rozdzielenie logiki aplikacji od jej prezentacji, co wydaje się fundamentalne przy większych projektach. Moim zdaniem takie podejście daje ogromne korzyści – można łatwo modyfikować wygląd bez dotykania kodu źródłowego. W praktyce, jeśli używasz np. Android Studio, zbudujesz interfejs przeciągając przyciski czy pola tekstowe, a pod spodem dostaniesz czytelny plik XML. To przyspiesza pracę, zwiększa czytelność projektu i pozwala na późniejsze automatyczne generowanie dokumentacji albo testów interfejsu. Takie standardy są rekomendowane nie tylko przez Google, ale też szeroko stosowane w innych środowiskach, jak chociażby XAML w Microsoft czy FXML w JavaFX. Przezroczystość działania tych narzędzi sprawia, że łatwiej jest pracować zespołowo, bo każdy może szybko zorientować się w strukturze UI patrząc na XML-a. Samo generowanie kodu XML przez narzędzia graficzne to duży krok w kierunku lepszej organizacji pracy i zgodności ze współczesnymi praktykami branżowymi.
Pytanie 40
Co zostanie wyświetlone w konsoli po wykonaniu poniższego kodu?
Wyjaśnienie poprawnej odpowiedzi: Wynik działania podanego kodu to [2, 4], ponieważ zastosowana funkcja filter tworzy nową tablicę, w której znajdują się tylko te elementy, które spełniają określony warunek. W tym przypadku warunkiem jest to, że element musi być parzysty (num % 2 === 0). Z tablicy arr, która zawiera liczby od 1 do 5, tylko liczby 2 i 4 spełniają ten warunek. Filtracja danych jest bardzo przydatna w programowaniu, zwłaszcza w kontekście pracy z dużymi zbiorami danych, gdzie można łatwo wyodrębnić interesujące nas elementy. Stosowanie takich metod, jak filter, jest zgodne z zasadami programowania funkcyjnego, które promują użycie funkcji do przetwarzania danych w sposób bardziej zwięzły i czytelny. W praktyce, funkcja filter może być używana do filtrowania danych z API, przetwarzania zbiorów danych w aplikacjach, czy też w analizach danych. Takie podejście zwiększa wydajność i czytelność kodu, co jest istotne w długoterminowym utrzymaniu projektów.