Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 00:33
Zakończenie: 29 września 2026 00:42 Rozwiązano w aplikacji mobilnej
Egzamin zdany!
Wynik: 21/40 punktów (52,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Jako strzał oznaczono 1 odpowiedź - trafionych: 0.
Z odpowiedzi deklarowanych jako pewne poprawnych było 21 z 39. Trafiony strzał to nie jest wiedza - te pytania warto powtórzyć w pierwszej kolejności.
Twój wynik na tle innych
Twój wynik jest lepszy niż 21% podejść do kwalifikacji INF.04.
Porównanie z 23418 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 60,0%, teraz 52,5% (-7,5 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Zapis w języku C# przedstawia definicję klasy Car, która:
publicclassCar: Vehicle{ ... }
A. odziedzicza po VehicleTwoja odpowiedź
B. jest klasą podstawową (nie dziedziczy po innej klasie)
C. używa pól prywatnych klasy Vehicle
D. jest zaprzyjaźniona z klasą Vehicle
Poprawna odpowiedź. Słusznie, zapis public class Car : Vehicle { ... } w języku C# oznacza, że klasa Car dziedziczy po klasie Vehicle. To jest tak zwane dziedziczenie, jeden z fundamentalnych mechanizmów programowania obiektowego. Dzięki temu Car odzyskuje wszystkie publiczne i chronione (protected) człony klasy Vehicle, a dodatkowo może wprowadzać własne składowe albo nadpisywać metody bazowe. Przykładowo, jeśli Vehicle ma metodę Start(), to Car również ją posiada, chyba że ją nadpisze słówkiem override. Moim zdaniem, znajomość dziedziczenia ułatwia projektowanie czytelnych oraz rozszerzalnych systemów, zwłaszcza w większych projektach. W praktyce — jeśli tworzysz aplikację zarządzającą różnymi pojazdami, to możesz mieć np. klasę Vehicle z uniwersalnymi funkcjami i kilka pochodnych (takich jak Car, Truck, Motorcycle), co pozwala trzymać wspólną logikę w jednym miejscu. Warto pamiętać, że w C# jest tylko dziedziczenie pojedyncze jeśli chodzi o klasy (w przeciwieństwie do niektórych innych języków). To też zgodne z SOLID, gdzie jedna klasa powinna mieć jasno określoną odpowiedzialność. Ja często spotykam się z tym podejściem w kodzie produkcyjnym – porządek w strukturze to podstawa, a dziedziczenie bardzo w tym pomaga.
Pytanie 2
Aplikacje webowe stworzone z użyciem frameworka Angular lub biblioteki React, działające na standardowych portach, można uruchomić na lokalnym serwerze, wpisując w przeglądarkę
A. localhost:8080 (React) lub localhost:8000 (Angular)
B. localhost:8000 (React) lub localhost:49887 (Angular)
C. localhost:3000 (React) lub localhost:4200 (Angular)Twoja odpowiedź
D. localhost:5001 (React) lub localhost:8080 (Angular)
Poprawna odpowiedź. React domyślnie startuje na porcie 3000, a Angular na 4200 – to są takie standardy, które praktycznie wszyscy w branży znają i stosują. Kiedy zaczynasz nowy projekt w React, korzystając na przykład z create-react-app, serwer deweloperski po prostu nasłuchuje na http://localhost:3000. Analogicznie, jak generujesz projekt w Angular CLI i odpalasz ng serve, wtedy aplikacja wystartuje na http://localhost:4200. To są domyślne porty – nie musisz nic specjalnie ustawiać, wystarczy wpisać te adresy w przeglądarce. Z mojego doświadczenia, dobrze jest zapamiętać te ustawienia, bo praktycznie na każdym warsztacie czy bootcampie te adresy padają od ręki. Jeśli chodzi o praktykę, czasami port jest już zajęty i wtedy narzędzie zaproponuje inny, ale te wartości startowe to taka baza. Warto pamiętać, że zmiana portu wynika zazwyczaj z konfliktu, a nie z jakiejś specjalnej potrzeby. Dodatkowo, rozpoznanie tych portów pozwala szybciej debugować problemy z uruchomieniem aplikacji – jak coś nie wstaje na tych adresach, to od razu wiadomo, gdzie szukać. Ogólnie rzecz biorąc, korzystanie z tych domyślnych portów przyspiesza współpracę w zespole, bo każdy wie, gdzie szukać aplikacji, więc nie trzeba się rozpisywać w README, na jakim porcie coś działa. Moim zdaniem, to jeden z tych drobnych szczegółów, które składają się na dobre nawyki programistyczne.
Pytanie 3
Wskaż rodzaj testów, które przeprowadza się podczas fazy tworzenia kodu źródłowego
A. testy wydajnościowe
B. testy kompatybilności
C. testy wdrożenioweTwoja odpowiedź
D. testy jednostkowePoprawna odpowiedź
Niepoprawna odpowiedź. Wiele osób zaczyna od myślenia, że testy wydajnościowe lub kompatybilnościowe to coś, co można robić już w trakcie pisania kodu, ale jednak tak nie jest. Testy wydajnościowe polegają na sprawdzaniu, jak szybko działa cały system albo jego większa część pod różnym obciążeniem – robi się to raczej po zintegrowaniu większych fragmentów aplikacji, nie w momencie pisania pojedynczych funkcji czy klas. Podobnie jest z testami kompatybilności – one sprawdzają, czy program działa poprawnie na różnych systemach operacyjnych, przeglądarkach albo w połączeniu z innymi aplikacjami. Tego typu testy są ważne, ale zwykle nie mają sensu, dopóki nie masz gotowej lub prawie gotowej aplikacji. Testy wdrożeniowe z kolei pojawiają się na samym końcu procesu – dotyczą sprawdzania, czy oprogramowanie zostało prawidłowo zainstalowane i czy działa w środowisku produkcyjnym. To już jest zupełnie inny etap, kiedy kod jest gotowy, przetestowany na innych poziomach i deweloperzy mają nadzieję, że wszystko pójdzie gładko. Często spotykam się z podejściem, że testowanie można zostawić na później, a to jest, szczerze mówiąc, bardzo ryzykowne. Największym błędem jest niedocenianie testów jednostkowych i mylenie ich z większymi testami integracyjnymi, wydajnościowymi czy wdrożeniowymi. To właśnie testy jednostkowe są najbliżej kodu źródłowego i to ich się używa podczas jego pisania – pozwalają szybko wychwycić błędy, zanim rozrosną się w poważniejsze problemy. Branża już dawno pogodziła się z tym, że testy jednostkowe to nie jest żadna fanaberia, tylko podstawowe narzędzie każdego programisty dbającego o jakość. Bez nich ryzykujesz, że małe błędy prześlizgną się do dalszych etapów i później naprawa jest dużo trudniejsza oraz bardziej kosztowna.
Pytanie 4
Na równoważnych pod względem funkcjonalnym listingach fragmentów aplikacji Angular oraz React.js utworzono listę punktowaną, która zawiera:
<ul>
    <li *ngFor = "let book of books"> {{book}} </li>
</ul>
Kod React.js:
<ul>
{this.books.map(book=> <li key={book}> book </li>)}
</ul>
A. Taką liczbę elementów, ile znajduje się w tablicy books; w każdym punkcie listy umieszczony jest jeden element tablicy.Twoja odpowiedź
B. Tyle elementów, ile znajduje się w tablicy books; w każdym punkcie listy widnieje element o treści {book}.
C. Wyłącznie jeden element o treści Harry Potter, Hobbit, Władca pierścieni.
D. Jedynie jeden element o treści Harry Potter.
Poprawna odpowiedź. Dokładnie tak właśnie działa iteracja po tablicy w Angularze i React.js. Zarówno Angularowy *ngFor, jak i funkcja map() w Reactcie to narzędzia do dynamicznego generowania elementów listy na podstawie danych z tablicy – w tym przypadku books. Każdy element tablicy tworzy osobny <li>, a więc liczba elementów na stronie zawsze odpowiada długości tablicy. To jest bardzo praktyczne, bo pozwala wyświetlać listy o dowolnej długości, zależnie od zawartości danych, bez przepisywania kodu – wystarczy zmienić dane źródłowe. W Angularze taki sposób budowania widoków jest zgodny z podejściem deklaratywnym – opisujesz, co ma się pojawić, a nie jak dokładnie to zrobić krok po kroku. React „mapuje” dane na elementy JSX, przy okazji warto pamiętać o kluczach (key), bo to pomaga w optymalizacji pracy wirtualnego DOM-u. Takie podejście to dzisiaj absolutny standard w branży – ułatwia utrzymanie kodu, testy i reużywalność komponentów. Moim zdaniem, kiedy raz się to opanuje, ciężko wyobrazić sobie inne podejście do budowy dynamicznych interfejsów. Zauważ, że każdy <li> wyświetla dokładny tekst z tablicy, a nie jakieś szablony czy placeholdery – to bardzo czytelne i naturalne dla użytkownika. W realnych projektach często tak renderuje się np. listy produktów, komentarzy czy zadań do wykonania. Dodatkowo, jeśli zmodyfikujesz tablicę, to widok automatycznie się odświeży – nie musisz ręcznie aktualizować DOM. To ogromne ułatwienie i podstawa nowoczesnego frontendu.
Pytanie 5
W przedstawionym filmie ukazano kreator interfejsu użytkownika, dla którego automatycznie powstaje
A. kod Java
B. obsługa wciśniętego przycisku
C. kod XMLTwoja odpowiedź
D. obsługa przycisku ekranu dotykowego
Poprawna odpowiedź. Kod XML jest obecnie najczęściej stosowanym formatem do definiowania wyglądu interfejsów użytkownika w takich narzędziach jak Android Studio czy różnego rodzaju designery graficzne. Kiedy projektujesz layout aplikacji mobilnej albo desktopowej, duża część nowoczesnych narzędzi tworzy właśnie pliki XML, które następnie są interpretowane przez system w czasie uruchamiania aplikacji. Ułatwia to rozdzielenie logiki aplikacji od jej prezentacji, co wydaje się fundamentalne przy większych projektach. Moim zdaniem takie podejście daje ogromne korzyści – można łatwo modyfikować wygląd bez dotykania kodu źródłowego. W praktyce, jeśli używasz np. Android Studio, zbudujesz interfejs przeciągając przyciski czy pola tekstowe, a pod spodem dostaniesz czytelny plik XML. To przyspiesza pracę, zwiększa czytelność projektu i pozwala na późniejsze automatyczne generowanie dokumentacji albo testów interfejsu. Takie standardy są rekomendowane nie tylko przez Google, ale też szeroko stosowane w innych środowiskach, jak chociażby XAML w Microsoft czy FXML w JavaFX. Przezroczystość działania tych narzędzi sprawia, że łatwiej jest pracować zespołowo, bo każdy może szybko zorientować się w strukturze UI patrząc na XML-a. Samo generowanie kodu XML przez narzędzia graficzne to duży krok w kierunku lepszej organizacji pracy i zgodności ze współczesnymi praktykami branżowymi.
Pytanie 6
Podaj przykład incydentu w miejscu pracy?
A. oparzenie dłoni, które miało miejsce podczas nieobowiązkowego szkolenia w czasie prywatnym pracownika
B. złe samopoczucie spowodowane przewlekłą chorobą zatrudnionego, które wystąpiło w biurzeTwoja odpowiedź
C. kontuzja stawu skokowego, która zdarzyła się w trakcie bezpośredniej drogi do miejsca zatrudnieniaPoprawna odpowiedź
D. złamanie nogi w trakcie urlopu wypoczynkowego przyznanego przez pracodawcę
Niepoprawna odpowiedź. Wiele osób ma mylne wyobrażenie, że incydent w miejscu pracy to tylko sytuacja, która zdarza się fizycznie na obszarze zakładu pracy czy w godzinach wykonywania obowiązków służbowych. Takie myślenie prowadzi do błędnych wniosków. Przykład oparzenia dłoni podczas nieobowiązkowego szkolenia w czasie wolnym pracownika nie spełnia definicji incydentu w pracy, bo nie jest związany z realizacją obowiązków ani nawet z formalną drogą do pracy. Z kolei pogorszenie samopoczucia wynikające z przewlekłej choroby, które zdarza się w biurze, to sytuacja z pogranicza – typowe regulacje BHP i ubezpieczeniowe nie zaliczają przypadków związanych z chorobami przewlekłymi do incydentów w pracy, o ile nie były one wywołane czynnikami zawodowymi lub nagłym zdarzeniem w trakcie pracy. To częsty błąd, bo ludzie utożsamiają każde pogorszenie stanu zdrowia w biurze z incydentem, a to nie jest zgodne z przepisami. Z kolei złamanie nogi podczas urlopu też nie kwalifikuje się jako wypadek w pracy – urlop wypoczynkowy to czas prywatny pracownika, niezwiązany z realizacją obowiązków służbowych, więc zdarzenia w tym okresie nie mają powiązania z miejscem pracy. Z doświadczenia wiem, że to dosyć częsty dylemat, zwłaszcza przy sporach z ubezpieczycielem. Kluczowe jest rozumienie, że przepisy BHP i standardy branżowe jak wytyczne Głównego Inspektora Pracy czy normy ISO jasno wskazują na potrzebę rozróżniania zdarzeń bezpośrednio związanych z pracą i tych, które są poza jej zakresem. Najczęstszy błąd to utożsamianie miejsca i czasu przebywania pracownika z samym incydentem. W praktyce tylko wypadki powstałe w wyniku pracy lub w drodze bezpośrednio do lub z pracy (bez przerywania jej innymi sprawami) podlegają zgłoszeniu jako incydent w miejscu pracy. Warto dokładnie analizować kontekst zdarzenia, bo to ma ogromne znaczenie przy późniejszych roszczeniach i obowiązkach pracodawcy względem BHP.
Pytanie 7
W jakim celu wykorzystuje się diagram Gantta?
A. do przedstawiania funkcjonalności systemu
B. do dokładnej analizy czasowo-kosztowej projektu
C. do planowania i zarządzania projektemTwoja odpowiedź
D. do wizualizacji powiązań między elementami systemów
Poprawna odpowiedź. Diagram Gantta to jeden z podstawowych i – moim zdaniem – najfajniejszych narzędzi używanych w zarządzaniu projektami, zwłaszcza w budowlance, IT czy produkcji. Jest bardzo praktyczny, bo pozwala wizualnie rozplanować, jakie zadania są do wykonania, ile mają trwać i co od czego zależy. Dzięki prostemu układowi poziomych pasków na osi czasu można szybko ogarnąć całość projektu, zobaczyć które zadania się pokrywają i gdzie mogą być wąskie gardła. Branżowe standardy, np. PMBOK, zalecają korzystanie z diagramu Gantta właśnie do planowania i monitorowania postępu. Z mojego doświadczenia to narzędzie, które łączy ludzi – wszyscy od razu widzą, kto co robi i na kiedy. Fajne jest też to, że łatwo aktualizować taki diagram w miarę zmian w projekcie. Diagram Gantta pomaga też w kontroli terminowości i identyfikacji opóźnień. Jeśli ktoś kiedyś miał styczność z programami jak MS Project czy nawet prostym Excelem – na pewno widział taki wykres. Można tam nawet dodać kamienie milowe czy zależności między zadaniami (np. jedno musi się skończyć, zanim drugie się zacznie). Tak naprawdę, w profesjonalnych firmach, zarządzanie projektem bez takiego narzędzia byłoby trochę strzałem w stopę.
Pytanie 8
Jakie wyrażenie logiczne powinno być użyte, aby zweryfikować, czy zmienna x zawiera wartości ujemne lub znajduje się w zakresie (10, 100)?
A. x > 10 || x < 100 || x < 0
B. (x > 10 && x < 100) || x < 0Twoja odpowiedź
C. x > 10 || x < 100 || x < 0
D. (x > 10 || x < 100) && x < 0
Poprawna odpowiedź. To wyrażenie logiczne: (x > 10 && x < 100) || x < 0 jest najtrafniejsze, bo dokładnie oddaje założone warunki: zmienna x powinna być ujemna lub znajdować się w zakresie od 10 do 100 (bez tych wartości granicznych, czyli przedział otwarty). Z mojego doświadczenia wynika, że takie podejście jest stosowane wszędzie tam, gdzie istotne są szczegółowe warunki – np. w walidacji danych wejściowych czy podczas filtrowania w bazach danych. Operator || gwarantuje, że jeśli chociaż jeden z warunków jest prawdziwy (czyli x jest mniejsze od 0 lub należy do przedziału 10-100), całe wyrażenie zwróci true. Warto też pamiętać, że zastosowanie operatora && wewnątrz nawiasu zapewnia, że oba warunki (x > 10 oraz x < 100) muszą być spełnione jednocześnie, czyli x leży pomiędzy tymi liczbami. Odpowiedniki takiego zapisu znajdziesz praktycznie w każdym języku programowania – od Javy po Pythona. Branżowe standardy jasno wskazują na czytelność i jednoznaczność warunków logicznych, szczególnie jeśli kod ma być utrzymywany przez inne osoby lub przez nas samych za kilka miesięcy. Uważam, że precyzyjne formułowanie wyrażeń tego typu to podstawa dobrego programisty – naprawdę warto się tego trzymać, bo później mniej błędów wychodzi na produkcji, a kod jest dużo łatwiej przetestować. Często spotykam się z przypadkami, gdzie ktoś pomija nawiasy lub źle łączy operatory i potem są problemy z błędami logicznymi, dlatego warto wyrobić sobie taki nawyk dokładnego zapisywania warunków.
Pytanie 9
W klasie o nazwie samochod przypisano atrybuty: marka, rocznik, parametry[]. Atrybuty te powinny zostać zdefiniowane jako
A. funkcje
B. polaTwoja odpowiedź
C. interfejsy
D. metody
Poprawna odpowiedź. Pola w klasie samochod to właśnie te elementy, które przechowują dane, takie jak marka, rocznik czy tablica parametry. To jest absolutna podstawa programowania obiektowego – najczęściej spotyka się to w językach takich jak Java, C# albo nawet w Pythonie, choć tam często nazywamy je po prostu atrybutami. Dla przykładu, jeśli tworzysz klasę Samochod w C#, to pole 'marka' będzie np. typu string, 'rocznik' – int, a 'parametry' możesz zadeklarować jako tablicę albo listę (List<T>) zależnie od potrzeb. Przechowywanie danych w polach pozwala na lepszą organizację, bo każda instancja klasy ma swoje własne wartości tych pól. Tak się właśnie tworzy modele danych, na których potem operuje cała aplikacja – czy to baza samochodów w warsztacie, czy system ubezpieczeń komunikacyjnych. Takie podejście jest zgodne z zasadami hermetyzacji i solidnych, nowoczesnych standardów pisania kodu. Dużo profesjonalnych frameworków i narzędzi (np. Entity Framework, Hibernate) korzysta z takiego podejścia, nawet jeśli potem te pola opakowujesz w właściwości (properties). Krótko mówiąc, pola to nieodłączny element każdej klasy, która coś reprezentuje, i moim zdaniem nie da się dobrze projektować kodu obiektowego bez zrozumienia tej konwencji.
Pytanie 10Strzał
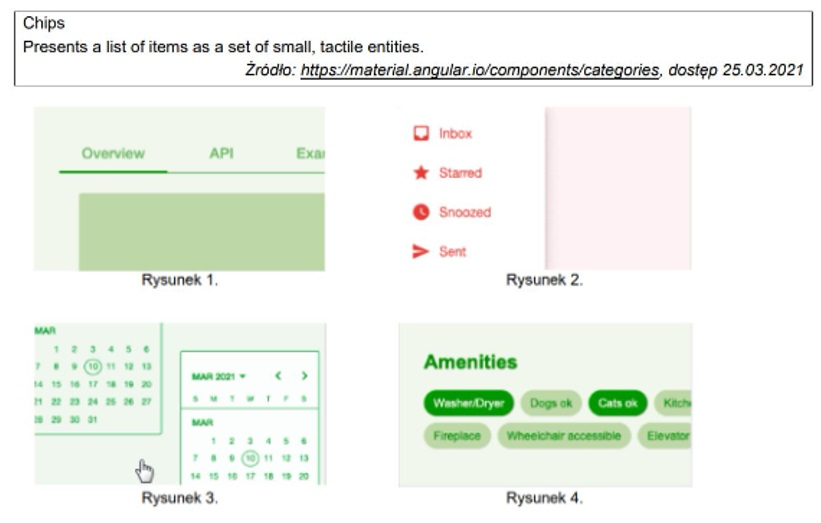
Na podstawie definicji zamieszczonej w ramce, wskaż, który z rysunków ilustruje komponent Chip zdefiniowany w bibliotece Angular Material?
Rysunek 1
Rysunek 2
Rysunek 3Twoja odpowiedź
Rysunek 4Poprawna odpowiedź
Niepoprawna odpowiedź. Rysunek 1 i 2 mogą przedstawiać inne komponenty, takie jak przyciski lub pola tekstowe, które nie pełnią funkcji interaktywnych znaczników. Rysunek 3 najprawdopodobniej reprezentuje suwak lub inny element nawigacyjny, który nie posiada cech charakterystycznych dla komponentu Chip. Komponenty Chip mają specyficzną strukturę, która odróżnia je od standardowych kontrolek interfejsu użytkownika.
Pytanie 11
Programista projektuje obsługę bufora drukowania dokumentów. Najnowsze zadanie drukowania jest ustawiane na końcu kolejki, a najstarsze jest przekazywane do wydruku. Strukturą danych najlepiej pasującą do problemu jest
A. stosTwoja odpowiedź
B. sterta
C. LIFO
D. FIFOPoprawna odpowiedź
Niepoprawna odpowiedź. W tym zadaniu łatwo pomylić pojęcia, bo kilka odpowiedzi brzmi podobnie technicznie, ale opisują zupełnie inne zachowanie. Stos działa według zasady LIFO, czyli Last In, First Out. Oznacza to, że element dodany jako ostatni jest zdejmowany jako pierwszy. Gdyby bufor drukowania działał jak stos, to najnowszy dokument byłby drukowany przed starszymi. W praktyce byłoby to dość kiepskie i niesprawiedliwe, bo starsze zadania mogłyby czekać bardzo długo, a nawet zostać ciągle spychane przez nowsze dokumenty. Z mojego doświadczenia uczniowie często kojarzą dodawanie na koniec z operacją push na stosie, ale zapominają, że kluczowe jest też to, skąd element jest później pobierany.
Sterta też nie jest właściwym wyborem dla zwykłego bufora drukowania. Heap służy głównie do sprawnego wybierania elementu o największym albo najmniejszym priorytecie, na przykład w kolejce priorytetowej. To ma sens, gdy zadania mają priorytety, terminy lub koszty, ale w treści pytania nie ma nic o priorytetach. Jest za to wyraźnie powiedziane, że najstarsze zadanie ma iść do wydruku. LIFO jako sama zasada również odpada, bo jest przeciwieństwem oczekiwanego zachowania. Poprawne myślenie jest takie: skoro pierwszy dokument, który trafił do bufora, ma być pierwszy obsłużony, to potrzebujemy kolejki FIFO. W profesjonalnych systemach taki wybór daje przewidywalność, prostszą diagnostykę i zachowanie zgodne z intuicją użytkownika.
Pytanie 12
W C++ mechanizm programowania obiektowego, który wykorzystuje funkcje wirtualne (ang. Virtual) i umożliwia programiście pominięcie kontroli klasy pochodnej podczas wywoływania metod, nazywa się
A. dziedziczeniemTwoja odpowiedź
B. przeciążeniem
C. hermetyzacją
D. polimorfizmemPoprawna odpowiedź
Niepoprawna odpowiedź. Dziedziczenie pozwala na przejmowanie metod i właściwości z klasy bazowej, ale samo w sobie nie umożliwia dynamicznego wyboru metody w czasie działania programu. Przeciążenie (overloading) polega na definiowaniu wielu metod o tej samej nazwie, ale różnych parametrach, co nie jest równoznaczne z polimorfizmem. Hermetyzacja (encapsulation) koncentruje się na ukrywaniu szczegółów implementacyjnych i dostępie do danych tylko przez interfejs klasy, ale nie dotyczy mechanizmu wyboru metody w trakcie działania aplikacji.
Pytanie 13
Który z podanych algorytmów operujących na jednowymiarowej tablicy posiada złożoność obliczeniową O(n²)?
A. Sortowanie szybkie
B. Wyszukiwanie binarne
C. Sortowanie bąbelkoweTwoja odpowiedź
D. Wypisanie elementów
Poprawna odpowiedź. Sortowanie bąbelkowe, znane również jako bubble sort, to prosty algorytm sortowania, który działa na zasadzie wielokrotnego przechodzenia przez tablicę i porównywania sąsiadujących ze sobą elementów. Algorytm ten ma złożoność obliczeniową O(n^2), co oznacza, że w najgorszym przypadku liczba operacji porównania wzrasta kwadratowo wraz ze wzrostem liczby elementów w tablicy. Przykładowo, dla tablicy o 5 elementach algorytm może wykonać do 10 porównań. W praktyce sortowanie bąbelkowe jest rzadko stosowane w dużych zbiorach danych ze względu na swoją niską efektywność, jednak jest to dobry przykład do nauki podstaw algorytmów sortujących. Standardy algorytmów sortujących, takie jak te zawarte w podręcznikach algorytmiki, często używają sortowania bąbelkowego jako przykładu do omówienia prostych koncepcji związanych z sortowaniem. Warto zauważyć, że chociaż algorytm ten jest prosty do zrozumienia, jego złożoność czasowa sprawia, że nie jest on praktyczny do stosowania w produkcyjnych rozwiązaniach, gdyż bardziej optymalne algorytmy, jak sortowanie szybkie czy sortowanie przez scalanie, osiągają złożoność O(n log n).
Pytanie 14
Algorytm wyszukiwania sekwencyjnego z wykorzystaniem wartownika opiera się na założeniu, że
A. na końcu analizowanego zbioru należy dodać wartownikaPoprawna odpowiedź
B. zbiór danych wejściowych musi być uporządkowanyTwoja odpowiedź
C. zbiór ma zawsze 100 elementów
D. szukany element powinien wystąpić wielokrotnie w zbiorze
Niepoprawna odpowiedź. Zbiór wejściowy musi być posortowany to błędna informacja, ponieważ algorytm sekwencyjnego wyszukiwania działającego z wartownikiem nie wymaga sortowania danych. W rzeczywistości przeszukiwany zbiór może być w dowolnej kolejności, co jest jedną z jego zalet w porównaniu do bardziej złożonych algorytmów, takich jak wyszukiwanie binarne, które rzeczywiście wymaga posortowanych danych. Kolejna nieprawidłowa opcja odnosi się do założenia, że zbiór jest zawsze 100 elementowy. Algorytm sekwencyjnego wyszukiwania działa na zbiorach o dowolnej wielkości, co czyni go elastycznym rozwiązaniem w różnych kontekstach aplikacyjnych. Ostatnim niepoprawnym stwierdzeniem jest to, że szukany element musi powtórzyć się kilkakrotnie w zbiorze. Algorytm ten jest w stanie zidentyfikować element, który występuje w zbiorze jednorazowo, jak i taki, który występuje wielokrotnie. Jego głównym celem jest zlokalizowanie przynajmniej jednego wystąpienia poszukiwanego elementu, niezależnie od jego ilości w zbiorze. Dlatego każda z tych odpowiedzi jest nieprawidłowa i nie oddaje rzeczywistej natury funkcjonowania algorytmu sekwencyjnego wyszukiwania z wartownikiem.
Pytanie 15
Zalecenia standardu WCAG 2.0 dotyczące percepcji koncentrują się na
A. zrozumieniu i wiarygodności prezentowanych treści na stronie
B. zapewnieniu odpowiedniej ilości czasu na przeczytanie i zrozumienie treściTwoja odpowiedź
C. prezentacji elementów interfejsu użytkownikaPoprawna odpowiedź
D. umożliwieniu interakcji między komponentami użytkownika za pomocą klawiatury
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi odnosi się do zrozumienia i rzetelności w dostarczonych treściach na stronie, co jest ważnym aspektem, ale nie dotyczy bezpośrednio percepcji komponentów interfejsu użytkownika. Zrozumienie treści jest związane z czytelnością tekstu oraz jego strukturalną formą, co nie jest bezpośrednio związane z interfejsem. Kolejna niepoprawna odpowiedź, dotycząca zapewnienia wystarczającej ilości czasu na przeczytanie i przetworzenie treści, odnosi się bardziej do zasad dostępności dotyczących czasu, które są istotne dla użytkowników z różnymi zdolnościami przetwarzania informacji, ale nie dotyczą samej percepcji komponentów interfejsu. Ostatnia odpowiedź, dotycząca zapewnienia interakcji pomiędzy komponentami użytkownika przy użyciu klawiatury, również nie odnosi się bezpośrednio do percepcji, a bardziej do interakcji użytkownika z systemem. Choć interakcja jest istotna, kluczowe jest zrozumienie, że percepcja skupia się na sposobie, w jaki użytkownicy dostrzegają i interpretują te komponenty, a nie na ich interakcji. Dlatego też, te odpowiedzi, choć dotyczą ważnych kwestii dostępności, nie są zgodne z istotą pytania.
Pytanie 16
Który z wymienionych poniżej przykładów stanowi system informacji przetwarzany przez system informatyczny?
A. System wentylacyjny w biurowcach
B. System PESELTwoja odpowiedź
C. System do monitorowania temperatury serwerów
D. System zarządzania oświetleniem drogowym
Poprawna odpowiedź. System PESEL (Powszechny Elektroniczny System Ewidencji Ludności) jest przykładem systemu informacji przetwarzanym przez system informatyczny, ponieważ gromadzi, przetwarza i udostępnia dane osobowe obywateli Polski. Jest to złożony system, który działa na bazie zintegrowanych baz danych, umożliwiający identyfikację osób, przydzielanie numerów PESEL oraz zarządzanie informacjami o statusie mieszkańców. System ten jest niezbędny dla organów administracji publicznej, umożliwiając im efektywne zarządzanie danymi obywateli w kontekście takich usług, jak wydawanie dowodów osobistych, rejestracja wyborców, a także w kontekście ochrony zdrowia i ubezpieczeń społecznych. PESEL jest zgodny z Europejskim Ogólnochronnym Rozporządzeniem o Ochronie Danych Osobowych (RODO), co dodatkowo podkreśla jego rolę jako kluczowego systemu informacyjnego w obiegu danych w Polsce. Przykłady zastosowań systemu PESEL obejmują obsługę wniosków o świadczenia socjalne oraz dostęp do e-usług, co świadczy o jego fundamentalnym znaczeniu w administrowaniu danymi ludnościowymi.
Pytanie 17
Która z wymienionych zasad jest istotna dla bezpiecznego użytkowania portali społecznościowych?
A. Udostępnianie jak największej ilości informacji osobowych
B. Unikanie stosowania silnych haseł do konta
C. Regularne kontrolowanie ustawień prywatnościTwoja odpowiedź
D. Zgłaszanie treści, które naruszają regulamin
Poprawna odpowiedź. Regularne sprawdzanie ustawień prywatności jest kluczowym aspektem bezpiecznego korzystania z portali społecznościowych, ponieważ to właśnie te ustawienia decydują o tym, jakie informacje udostępniamy innym użytkownikom. Użytkownicy powinni być świadomi, że domyślne ustawienia prywatności często są skonfigurowane w sposób, który umożliwia szeroką dostępność ich danych osobowych. Przykładowo, wiele platform społecznościowych domyślnie ustawia profile jako publiczne, co oznacza, że każdy może zobaczyć ich zawartość. Zmieniając te ustawienia, użytkownicy mogą ograniczyć widoczność swoich postów, zdjęć, a także informacji osobistych tylko do wybranej grupy osób, co znacząco zwiększa ich bezpieczeństwo. Warto także regularnie aktualizować te ustawienia, ponieważ platformy często wprowadzają nowe funkcje, które mogą zmieniać domyślne zasady dotyczące prywatności. Zgodnie z wytycznymi RODO oraz innymi standardami ochrony danych osobowych, użytkownicy mają prawo do kontrolowania swoich informacji, co czyni regularne sprawdzanie ustawień prywatności nie tylko zaleceniem, ale również obowiązkiem każdego świadomego użytkownika internetu.
Pytanie 18
Jaki będzie rezultat operacji logicznej AND dla wartości binarnych 1010 oraz 1100?
A. 1000Poprawna odpowiedź
B. 1110Twoja odpowiedź
C. 1100
D. 1010
Niepoprawna odpowiedź. Wszystkie inne proponowane odpowiedzi są nieprawidłowe z różnych powodów. Odpowiedź 1110 jest niepoprawna, ponieważ wynikiem operacji AND nie może być 1 na pozycji bitu, gdzie przynajmniej jeden z porównywanych bitów wynosi 0. W tej operacji, gdy bierzemy pod uwagę drugi i trzeci bit, oba są odpowiednio 0 i 1, co daje wynik 0, a nie 1. Kolejna nieprawidłowość dotyczy odpowiedzi 1100. W tej odpowiedzi otrzymujemy 1 w pierwszym i drugim bicie, co jest sprzeczne z zasadą operacji AND, gdzie jeden z porównywanych bitów również musi być 0. W związku z tym, operacja AND dla tych bitów powinna również zwrócić 0 w tych pozycjach. Ostatnią niepoprawną odpowiedzią jest 1010. Choć ta liczba jest jedną z operowanych i rzeczywiście zawiera bity 1 i 0, wynik operacji AND nie powinien być równy któremuś z oryginalnych operandów, ale rezultatem zgodnym z zasadami logiki binarnej. To pokazuje, że niektóre odpowiedzi mogą zawierać bity, które są zgodne z jednym z operandów, jednak nie są wynikiem właściwej operacji AND. W kontekście systemów logicznych oraz algorytmów cyfrowych, zrozumienie tych zasad jest kluczowe dla prawidłowego manipulowania danymi i projektowania układów cyfrowych.
Pytanie 19
Które z wymienionych działań stanowi zagrożenie dla emocjonalnego dobrostanu człowieka w sieci?
A. CyberstalkingTwoja odpowiedź
B. Nadmierne korzystanie z mediów społecznościowych
C. Zła postawa podczas pracy przy komputerze
D. Przesyłanie niezaszyfrowanych plików
Poprawna odpowiedź. Cyberstalking to groźne zjawisko polegające na uporczywym prześladowaniu, nękaniu lub groźbach w przestrzeni internetowej. Może prowadzić do poważnych problemów emocjonalnych, takich jak lęki, depresja, a nawet zespół stresu pourazowego (PTSD). Cyberstalking narusza prywatność ofiary, wywołując poczucie zagrożenia i bezradności. Walka z tym zjawiskiem obejmuje zgłaszanie przypadków organom ścigania, blokowanie prześladowców i korzystanie z narzędzi ochrony prywatności.
Pytanie 20
Czym jest ochrona własności intelektualnej?
A. Zbiór informacji osobowych
B. Koncepcja prawa zabezpieczającego twórczość i innowacjeTwoja odpowiedź
C. Zestaw przepisów dotyczących ochrony prywatności
D. Rejestr plików przechowywanych w chmurze
Poprawna odpowiedź. Własność intelektualna to zbiór praw chroniących twórczość i wynalazki, obejmujący patenty, prawa autorskie, znaki towarowe i wzory przemysłowe. Własność intelektualna pozwala twórcom na zarabianie na swoich dziełach oraz kontrolowanie, kto i w jaki sposób może z nich korzystać. W wielu krajach naruszenie praw własności intelektualnej wiąże się z poważnymi konsekwencjami prawnymi. Dla przedsiębiorstw i innowatorów ochrona własności intelektualnej jest kluczowa dla zabezpieczenia ich inwestycji oraz rozwijania nowych technologii.
Pytanie 21
Jakie oznaczenie posiada norma krajowa w Polsce?
A. ISOTwoja odpowiedź
B. PNPoprawna odpowiedź
C. EN
D. IEC
Niepoprawna odpowiedź. ISO to coś międzynarodowego, a nie krajowego. EN to jakieś standardy, które obowiązują w całej Unii Europejskiej. Jeszcze IEC, to międzynarodowe normy dotyczące elektrotechniki i nie są to normy, które znajdziesz w Polsce. Polska Norma, czyli PN, to coś, co mamy tylko w naszym kraju i odnosi się tylko do polskiego systemu normalizacyjnego.
Pytanie 22
Które z poniższych stwierdzeń najlepiej charakteryzuje tablicę asocjacyjną?
A. Tablica, która przechowuje wartości, do których można uzyskać dostęp tylko za pomocą indeksów numerycznychTwoja odpowiedź
B. Tablica przechowująca dane w formie par klucz-wartośćPoprawna odpowiedź
C. Tablica, która zmienia swoje wymiary w trakcie działania programu
D. Tablica, która przechowuje wyłącznie dane tekstowe
Niepoprawna odpowiedź. A więc zwykła tablica działa na zasadzie numerów, nie ma kluczy tekstowych, więc nie ma mowy o parach klucz-wartość. Co prawda, tablice dynamiczne potrafią zmieniać rozmiar, ale mimo to, nie dadzą rady zorganizować danych w taki sposób. Tekst czy inne typy danych w tablicach są po prostu przechowywane jak inne. Kluczowa różnica jest taka, że tablice asocjacyjne pozwalają na użycie kluczy, co czyni je bardziej elastycznymi. Trochę się zgubiłeś w tym wszystkim.
Pytanie 23
Jakie korzyści płyną z użycia pseudokodu przy tworzeniu algorytmu?
A. Możliwość szybkie zrealizowania algorytmu w którymkolwiek języku
B. Łatwość w zmianie kodu maszynowego
C. Zrozumiałość dla osób nieznających się na programowaniuTwoja odpowiedź
D. Generowanie dynamicznych struktur danych
Poprawna odpowiedź. Zaletą wykorzystania pseudokodu podczas projektowania algorytmu jest jego czytelność i prostota, dzięki czemu jest zrozumiały nawet dla osób, które nie są biegłe w programowaniu. Pseudokod pozwala skupić się na logice działania algorytmu bez konieczności przestrzegania ścisłej składni konkretnego języka programowania. Dzięki temu proces projektowania jest szybszy, a algorytm można łatwo przełożyć na dowolny język programowania. Pseudokod ułatwia również współpracę między programistami i analitykami, wspierając tworzenie i dokumentowanie złożonych rozwiązań.
Pytanie 24
Jakie jest przeznaczenie polecenia "git merge"?
A. Do pobierania aktualizacji zdalnego repozytorium
B. Do łączenia zmian z różnych gałęziPoprawna odpowiedź
C. Do zakładania nowego repozytoriumTwoja odpowiedź
D. Do usuwania zmian w repozytorium
Niepoprawna odpowiedź. Wiele osób na początku nauki Gita myli różne polecenia, bo brzmią podobnie albo wydają się robić coś bliskiego. "git merge" często bywa mylone z poleceniami typu "git pull" czy "git clone", które mają jednak zupełnie inne zastosowanie. Pobieranie aktualizacji ze zdalnego repozytorium to domena "git pull" – to polecenie automatycznie pobiera nowe commity i próbuje je od razu zintegrować z lokalną gałęzią, często zresztą używając w tle właśnie "merge". Ale samo "git merge" nie ściąga niczego z internetu, ono tylko łączy zmiany już obecne w lokalnych gałęziach. Z kolei tworzenie nowego repozytorium to zadanie "git init"; to zupełnie inny etap pracy, bo dotyczy rozpoczęcia projektu, a nie zarządzania jego rozwojem. Usuwanie zmian w repozytorium – tutaj najczęściej używa się "git reset" czy "git revert", zależnie od tego czy chcemy cofnąć zmiany lokalnie czy naprawić coś w historii. Merge natomiast nie służy do usuwania ani cofania, tylko do scalania zmian – to kluczowe, żeby nie pomylić tych narzędzi, bo można przez to nieźle namieszać w kodzie. Moim zdaniem, głównym błędem jest założenie, że wszystkie polecenia związane z aktualizacją kodu robią to samo, podczas gdy w Git każde z nich ma bardzo konkretne zadanie i konsekwencje. Dla dobrych praktyk w zespole ważne jest, żeby rozumieć subtelne różnice między tymi operacjami. Praktyka pokazuje, że błędne użycie "merge" – jak również zamiana go z "pull" albo "reset" – potrafi prowadzić do chaosu w historii projektu. Warto zatem dobrze opanować przeznaczenie każdego z poleceń przed rozpoczęciem pracy nad większym projektem.
Pytanie 25
Jakie stwierdzenie najlepiej tłumaczy cel podziału programu na funkcje (metody)?
A. Umożliwia skrócenie kodu przez eliminację wszelkich komentarzy
B. Ułatwia proces debugowania oraz ponowne wykorzystanie fragmentów koduPoprawna odpowiedź
C. Gwarantuje automatyczną kompilację programu
D. Eliminuje potrzebę korzystania ze zmiennych globalnychTwoja odpowiedź
Niepoprawna odpowiedź. Usunięcie komentarzy w kodzie nie ma wpływu na podział programu na funkcje. Komentarze pełnią rolę informacyjną dla programistów i nie wpływają na działanie kodu. Automatyczna kompilacja programu to proces wykonywany przez kompilator i nie ma związku z dzieleniem programu na funkcje – kompilator przetwarza kod niezależnie od tego, czy program jest podzielony na funkcje czy napisany jako jeden blok. Eliminacja zmiennych globalnych to dobra praktyka, ale dzielenie programu na funkcje nie eliminuje automatycznie potrzeby ich stosowania. W rzeczywistości funkcje mogą nadal korzystać ze zmiennych globalnych, jeśli nie zostaną odpowiednio zaprojektowane.
Pytanie 26
Jakie ma znaczenie "operacja wejścia" w kontekście programowania?
A. Przekazywanie danych do programu z zewnętrznych źródełPoprawna odpowiedź
B. Wprowadzanie nowych funkcji do aplikacji
C. Zmiana wartości zmiennych globalnychTwoja odpowiedź
D. Naprawianie błędów w kodzie aplikacji
Niepoprawna odpowiedź. Dodawanie nowych funkcji do programu to element programowania, ale nie jest to związane z operacją wejścia. Modyfikowanie wartości zmiennych globalnych to operacja na poziomie kodu, a nie proces wejścia danych. Usuwanie błędów w kodzie programu to etap debugowania, a nie operacja wejścia. Operacje wejścia koncentrują się na interakcji z użytkownikiem lub innymi źródłami danych, co odróżnia je od modyfikacji kodu czy zarządzania błędami.
Pytanie 27
Jakie z wymienionych czynności można zrealizować przy pomocy składnika statycznego danej klasy?
A. Zachowanie wartości wspólnych dla wszystkich instancji klasyPoprawna odpowiedź
B. Tworzenie prywatnych kopii pól dla każdej instancji
C. Umożliwienie dzielenia pól klasy pomiędzy zaprzyjaźnione klasyTwoja odpowiedź
D. Wywołanie destruktora klasy bez jej usuwania
Niepoprawna odpowiedź. Tworzenie prywatnych kopii pól dla każdego obiektu to cecha pól niestatycznych – każda instancja klasy ma swoją własną kopię takich pól. Dzielenie pól klasy pomiędzy zaprzyjaźnione klasy nie odnosi się do mechanizmu statycznego – przyjaźń między klasami pozwala na dostęp do prywatnych składowych, ale nie oznacza współdzielenia pól między instancjami. Destruktory nie mogą być wywoływane w sposób statyczny – są one automatycznie uruchamiane w momencie usunięcia obiektu, a nie przez klasę jako całość.
Pytanie 28
Jakie znaczenie ma termin "przesłanianie metody" w kontekście programowania obiektowego?
A. Tworzenie nowej metody w klasie bazowej
B. Zastosowanie tej samej nazwy metody w klasie bazowej i pochodnej, ale z inną implementacją w klasie pochodnejTwoja odpowiedź
C. Zmiana metody prywatnej na metodę publiczną
D. Przenoszenie metod z jednej klasy do drugiej
Poprawna odpowiedź. Przesłanianie metody to mechanizm, w którym metoda w klasie pochodnej ma taką samą nazwę, typ zwracany i listę parametrów jak metoda w klasie bazowej, ale zawiera inną implementację. To kluczowy element polimorfizmu, umożliwiający dostosowanie zachowania klasy pochodnej do jej specyficznych potrzeb, przy zachowaniu spójnego interfejsu. Przesłanianie metod pozwala na elastyczne projektowanie kodu i jest szeroko stosowane w dużych projektach, aby umożliwić rozszerzalność oraz ponowne wykorzystanie istniejącej logiki. W C++ przesłanianie osiąga się za pomocą słowa kluczowego 'virtual' w klasie bazowej, a następnie redefinicji metody w klasie pochodnej.
Pytanie 29
Jakie są kluczowe etapy resuscytacji krążeniowo-oddechowej?
A. 30 uciśnięć klatki piersiowej na przemian z 2 wdechami ratowniczymiTwoja odpowiedź
B. 20 uciśnięć klatki piersiowej na przemian z 5 wdechami ratowniczymi
C. 10 uciśnięć klatki piersiowej bez wdechów
D. 30 wdechów ratowniczych bez uciśnięć
Poprawna odpowiedź. 30 uciśnięć klatki piersiowej na przemian z 2 wdechami ratowniczymi to standardowy protokół resuscytacji krążeniowo-oddechowej (RKO) zgodny z wytycznymi Europejskiej Rady Resuscytacji (ERC). Uciśnięcia wykonywane są na głębokość około 5-6 cm w tempie 100-120 uciśnięć na minutę. Po 30 uciśnięciach wykonuje się 2 wdechy ratownicze, które powinny być wykonywane z odpowiednią siłą, aby unieść klatkę piersiową poszkodowanego. Taka sekwencja jest podstawą pierwszej pomocy i może uratować życie osoby, u której doszło do zatrzymania akcji serca. Resuscytację należy kontynuować do momentu przybycia służb ratunkowych lub odzyskania przytomności przez poszkodowanego.
Pytanie 30
Który framework jest szeroko stosowany do tworzenia aplikacji desktopowych w języku C++?
A. Node.js
B. WPF
C. QtPoprawna odpowiedź
D. FlutterTwoja odpowiedź
Niepoprawna odpowiedź. W tym pytaniu łatwo pomylić różne technologie, bo wiele z nich służy do tworzenia aplikacji, ale niekoniecznie klasycznych aplikacji desktopowych w C++. Node.js kojarzy się z programowaniem aplikacji, jednak jego główne zastosowanie to środowisko uruchomieniowe JavaScriptu, szczególnie po stronie serwera, w backendzie, narzędziach CLI albo aplikacjach sieciowych. Da się z nim pośrednio budować aplikacje desktopowe, na przykład przez Electron, ale wtedy mówimy raczej o stosie JavaScript/HTML/CSS, a nie typowym frameworku C++ do GUI. WPF jest mocnym rozwiązaniem do desktopu, ale należy do ekosystemu .NET i jest używany głównie z C# na Windowsie. To dobra technologia, tylko nie ta, o którą chodzi w kontekście C++. Flutter z kolei jest frameworkiem od Google, popularnym w aplikacjach mobilnych i coraz częściej desktopowych, ale jego podstawowym językiem jest Dart, a nie C++. Typowy błąd myślowy polega tu na tym, że ktoś wybiera dowolny znany framework do aplikacji z oknami, nie patrząc na język i środowisko. W pytaniu kluczowe są dwa słowa: desktopowych oraz C++. Dla takiego zestawu Qt jest najbardziej klasyczną i branżowo rozpoznawalną odpowiedzią. Oferuje wieloplatformowy interfejs graficzny, rozbudowane biblioteki pomocnicze i narzędzia projektowe, dlatego często spotyka się go w realnych projektach komercyjnych, technicznych i przemysłowych.
Pytanie 31
Który z wymienionych elementów interfejsu użytkownika jest charakterystyczny dla aplikacji działającej na komputerze?
A. Przycisk (Button)Twoja odpowiedź
B. Strona HTML
C. API REST
D. Routing
Poprawna odpowiedź. Przycisk, czyli ten mały element, co go klikamy w aplikacjach, to naprawdę ważna część interfejsu. Używamy go, żeby coś zainicjować, na przykład zapisać dane czy wywołać jakąś funkcję. Fajnie, że można go dowolnie ustawiać – zmieniać wygląd, rozmiar, a nawet to, jak się zachowuje. Dzięki temu pasuje do każdej aplikacji. W dzisiejszych programach, jak WPF, te przyciski mogą mieć różne kolorowe ikony albo nawet animacje, co sprawia, że aplikacja wygląda super. Generalnie, bez przycisków użytkownik by się w aplikacji nie połapał, bo to dzięki nim możemy nawigować, zatwierdzać formularze czy otwierać nowe okna dialogowe.
Pytanie 32
Jaki komponent środowiska IDE jest niezbędny do tworzenia aplikacji webowych?
A. Narzędzie do tworzenia grafiki
B. Emulator urządzeń mobilnych
C. Debugger, edytor kodu, integracja z systemem kontroli wersjiTwoja odpowiedź
D. Zarządzanie bazami danych
Poprawna odpowiedź. Debugger, edytor kodu oraz integracja z systemem kontroli wersji to kluczowe elementy środowiska IDE, które umożliwiają efektywną pracę nad aplikacjami webowymi. Debugger pozwala na wykrywanie i naprawianie błędów w czasie rzeczywistym, edytor kodu umożliwia szybkie pisanie i modyfikowanie kodu, a integracja z systemem kontroli wersji (np. Git) pozwala śledzić zmiany i współpracować w zespołach programistycznych. Te narzędzia stanowią podstawę pracy każdego dewelopera webowego.
Pytanie 33
Które z wymienionych zastosowań najlepiej definiuje bibliotekę jQuery?
A. Budowanie aplikacji mobilnych
B. Ułatwienie manipulacji DOM oraz obsługi zdarzeń w JavaScriptTwoja odpowiedź
C. Tworzenie interfejsów w programach desktopowych
D. Projektowanie struktur baz danych
Poprawna odpowiedź. jQuery to popularna biblioteka JavaScript, która ułatwia manipulację DOM (Document Object Model), obsługę zdarzeń oraz wykonywanie animacji na stronach internetowych. Dzięki jQuery programiści mogą znacznie skrócić ilość kodu potrzebnego do realizacji operacji na elementach HTML. Biblioteka ta zapewnia również wygodny sposób na wykonywanie asynchronicznych żądań HTTP (AJAX), co pozwala na dynamiczne pobieranie danych z serwera bez konieczności przeładowywania całej strony. jQuery jest szeroko stosowane w projektach, które wymagają interaktywności oraz lekkich efektów wizualnych. Choć w ostatnich latach jego popularność spadła na rzecz bardziej zaawansowanych frameworków takich jak React czy Angular, jQuery nadal jest cenione za prostotę, wydajność oraz bogaty ekosystem gotowych wtyczek i rozszerzeń.
Pytanie 34
Co to jest automatyzacja testowania procesów?
A. Integracją testów w środowisku deweloperskim
B. Używaniem narzędzi oraz skryptów do wykonywania testów w sposób automatyczny bez udziału człowiekaTwoja odpowiedź
C. Sprawdzaniem poprawności działania aplikacji na urządzeniach przenośnych
D. Kompilowaniem kodu w celu zwiększenia efektywności
Poprawna odpowiedź. Automatyzacja procesu testowania to zastosowanie narzędzi, skryptów i technologii do przeprowadzania testów oprogramowania w sposób zautomatyzowany, bez konieczności ciągłej ingerencji człowieka. Automatyzacja pozwala na szybkie i wielokrotne uruchamianie testów regresyjnych, co znacząco zwiększa efektywność testowania, redukuje czas potrzebny na wykrycie błędów i umożliwia jednoczesne testowanie wielu funkcji. Narzędzia takie jak Selenium, JUnit czy TestNG pozwalają na tworzenie skryptów testowych, które automatycznie weryfikują poprawność działania aplikacji na różnych urządzeniach i w różnych środowiskach. Automatyzacja testów to nie tylko oszczędność czasu, ale także wyższa dokładność i powtarzalność testów, co minimalizuje ryzyko przeoczenia krytycznych błędów.
Pytanie 35
Która z poniższych metod nie należy do cyklu życia komponentu w React.js?
A.
componentWillPublish()
Twoja odpowiedź
B.
componentDidMount()
C.
componentWillUnmount()
D.
componentDidUpdate()
Poprawna odpowiedź. Metoda componentWillPublish() nie jest częścią cyklu życia komponentu w React.js, co czyni ją poprawną odpowiedzią na to pytanie. W React.js istnieje szereg zdefiniowanych metod cyklu życia, które umożliwiają programistom zarządzanie stanem komponentów w określonych momentach ich istnienia. Do najbardziej istotnych z nich należą: componentDidMount(), componentDidUpdate() oraz componentWillUnmount(). Metoda componentDidMount() jest wywoływana po zamontowaniu komponentu w DOM, co pozwala na inicjalizację danych, takich jak pobieranie danych z API. Z kolei componentDidUpdate() jest wywoływana, gdy komponent zostaje zaktualizowany, co jest doskonałym momentem na reagowanie na zmiany w stanie lub propach. Metoda componentWillUnmount() jest wywoływana tuż przed odmontowaniem komponentu, co jest przydatne do czyszczenia zasobów, takich jak anulowanie subskrypcji lub usuwanie nasłuchiwaczy. Zrozumienie tych metod jest kluczowe dla efektywnego zarządzania cyklem życia komponentów w aplikacjach React, co prowadzi do lepszej wydajności i utrzymania kodu.
Pytanie 36
Co oznacza skrót CDN w kontekście aplikacji webowych?
A. Content Delivery Network - sieć rozproszona geograficznie, służąca do dostarczania treściPoprawna odpowiedź
B. Cross Domain Navigation - metoda nawigacji między domenami w aplikacjach webowychTwoja odpowiedź
C. Compressed Data Node - węzeł kompresji danych w architekturze mikrousług
D. Content Definition Notation - notacja do definiowania treści w aplikacjach
Niepoprawna odpowiedź. W kontekście aplikacji webowych błędne skróty i pojęcia często prowadzą do nieporozumień dotyczących architektury i technologii. Cross Domain Navigation, chociaż istotne w kontekście bezpieczeństwa i wymiany danych między różnymi domenami, nie jest związane z dostarczaniem treści. Metoda ta dotyczy głównie sposobów nawigacji w aplikacjach, które mogą wymagać zarządzania różnymi politykami CORS (Cross-Origin Resource Sharing), ale nie definiuje sposobów optymalizacji dostarczania treści. Compressed Data Node to termin, który sugeruje węzeł odpowiedzialny za kompresję danych w architekturze mikrousług, ale nie wiąże się z geograficznie rozproszonym dostarczaniem treści, co jest kluczowym aspektem działania CDN. Content Definition Notation to z kolei nieznany termin w literaturze dotyczącej technologii webowej, nie mający powszechnie uznawanej definicji w branży. Błędem myślowym byłoby utożsamianie tych terminów z sieciami dostarczania treści, ponieważ każde z nich ma swoją specyfikę i zastosowanie. W kontekście aplikacji internetowych kluczowe jest zrozumienie, że CDN ma na celu poprawę szybkości i efektywności dostarczania treści, co jest niezrównanie bardziej złożonym i istotnym zagadnieniem niż tylko nawigacja czy kompresja danych. Praktyki związane z sieciami CDN są dobrze udokumentowane i należy je stosować zgodnie z najlepszymi standardami branżowymi, aby zapewnić wysoką jakość usług dla użytkowników.
Pytanie 37
Który z poniższych nie jest typem danych w języku JavaScript?
A.
Integer
Poprawna odpowiedź
B.
Boolean
C.
String
D.
Object
Twoja odpowiedź
Niepoprawna odpowiedź. Wybór typów danych, takich jak Boolean, String i Object, jest prawidłowy w kontekście JavaScript, ponieważ wszystkie te typy są integralnymi elementami tego języka. Boolean reprezentuje dwie wartości: true i false, co jest niezbędne do tworzenia warunków i logiki w kodzie. Z kolei typ String służy do przechowywania tekstu, co jest kluczowe w każdej aplikacji webowej, umożliwiając manipulację danymi tekstowymi. Przykładowo, można korzystać z metod takich jak `toUpperCase()` czy `substring()`, aby przetwarzać napisy. Typ Object, z kolei, to bardziej złożona struktura, która może przechowywać wiele par klucz-wartość, co pozwala na modelowanie bardziej złożonych danych, takich jak obiekty użytkowników, produkty, czy cokolwiek, co wymaga złożonej struktury danych. Typowe błędy myślowe, które prowadzą do nieprawidłowych wniosków dotyczących typów danych, mogą wynikać z braku zrozumienia różnicy między typami w różnych językach programowania. Na przykład, w językach takich jak Java czy C#, Integer jest odrębnym typem, co może prowadzić do myślenia, że JavaScript działa w podobny sposób. W rzeczywistości jednak, JavaScript zapewnia uproszczoną i bardziej elastyczną obsługę typów numerycznych, a zrozumienie tych różnic jest kluczowe dla efektywnego programowania w tym języku.
Pytanie 38
Co to jest BEM w kontekście CSS?
A. Metodologia nazewnictwa klas CSS: Block, Element, ModifierPoprawna odpowiedź
B. Browser Extension Module - moduł rozszerzeń przeglądarki
C. Backend Encryption Method - metoda szyfrowania danych w backendzie
D. Bootstrap Element Manager - narzędzie do zarządzania elementami BootstrapTwoja odpowiedź
Niepoprawna odpowiedź. Wybór innych odpowiedzi wskazuje na nieporozumienie dotyczące koncepcji BEM oraz jego zastosowania w CSS. Browser Extension Module, czyli moduł rozszerzeń przeglądarki, jest całkowicie niepowiązany z tematyką stylizacji stron internetowych. Takie podejście do ładowania lub tworzenia stylów w przeglądarkach nie dotyczy metodologii organizacji kodu CSS, jaką jest BEM. Backend Encryption Method natomiast odnosi się do bezpieczeństwa i szyfrowania danych w systemach serwerowych, co także nie ma związku z front-endowym podejściem do stylizacji. Pojęcie Bootstrap Element Manager mogłoby sugerować narzędzie do zarządzania komponentami w frameworku Bootstrap, jednak nie odnosi się do BEM, który jest niezależny od konkretnego frameworka i koncentruje się na organizacji kodu CSS. Typowym błędem myślowym przy wyborze tych odpowiedzi jest skupienie się na technologiach związanych z przeglądarką lub backendem, zamiast na metodologii stylistycznej, która ma na celu ułatwienie pracy z CSS. Kluczowe jest zrozumienie, że BEM jest narzędziem używanym do poprawy struktury i czytelności kodu CSS, co jest niezbędne w procesie tworzenia nowoczesnych, skalowalnych aplikacji webowych. Zwracanie uwagi na te różnice jest istotne dla każdej osoby zajmującej się front-endem, aby uniknąć zamieszania w terminologii i użyciu odpowiednich narzędzi do właściwych zadań.
Pytanie 39
Co to jest REST API?
A. Architektura API oparta o zasoby i standardowe operacje HTTPPoprawna odpowiedź
B. Framework do testowania API
C. Protokół sieciowy do transferu danych binarnych
D. Biblioteka JavaScript do komunikacji z bazami danychTwoja odpowiedź
Niepoprawna odpowiedź. Odpowiedzi wskazujące na frameworki do testowania API, protokoły sieciowe oraz biblioteki JavaScript do komunikacji z bazami danych są mylące, ponieważ nie oddają istoty REST API. Framework do testowania API, choć istotny w procesie tworzenia aplikacji, nie ma nic wspólnego z architekturą REST, która dotyczy sposobu projektowania API opartego na zasobach. Z kolei protokół sieciowy do transferu danych binarnych nie ma zastosowania w kontekście REST API, które używa HTTP jako swojego protokołu komunikacyjnego, a także preferuje formaty tekstowe, takie jak JSON czy XML, do wymiany danych. Ostatnia koncepcja, dotycząca bibliotek JavaScript, myli pojęcia, ponieważ REST API nie jest narzędziem do komunikacji z bazami danych, lecz sposobem na interakcję między różnymi systemami. Typowym błędem myślowym jest utożsamienie REST API z jedną konkretną technologią lub narzędziem, podczas gdy w rzeczywistości jest to zestaw zasad i praktyk dotyczących projektowania API. Kluczowe jest zrozumienie, że REST API to podejście, które może być implementowane w różnych językach i technologiach, a jego celem jest stworzenie prostego, elastycznego i wydajnego interfejsu do komunikacji z zasobami.
Pytanie 40
Co to jest SPA (Single Page Application)?
A. Aplikacja webowa działająca na jednej stronie, dynamicznie aktualizująca treść bez przeładowywania całej stronyTwoja odpowiedź
B. Metoda projektowania interfejsu użytkownika dla aplikacji mobilnych
C. Format pliku używany w aplikacjach do przetwarzania danych
D. Technika optymalizacji kodu w aplikacjach JavaScript
Poprawna odpowiedź. Single Page Application (SPA) to typ aplikacji internetowej, która działa na jednej stronie, umożliwiając dynamiczne ładowanie treści bez konieczności przeładowania całej witryny. W tradycyjnych aplikacjach webowych, każda interakcja użytkownika, która wymagała zmiany treści, wiązała się z odświeżeniem strony. W przypadku SPA, korzysta się z technologii takich jak AJAX, WebSockets czy API, co pozwala na asynchroniczne pobieranie danych z serwera. Przykłady SPA to popularne frameworki i biblioteki, takie jak React, Angular czy Vue.js. Dzięki tym technologiom, użytkownicy mogą doświadczyć płynniejszego i bardziej responsywnego interfejsu. Dobrą praktyką w projektowaniu SPA jest stosowanie wzorców projektowych, takich jak MVC (Model-View-Controller), co ułatwia zarządzanie kodem oraz jego modułowość. SPA są szczególnie przydatne w aplikacjach wymagających intensywnej interakcji, takich jak platformy e-commerce czy aplikacje społecznościowe, gdzie kluczowa jest szybkość i komfort użytkowania.