Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 01:11
Zakończenie: 29 września 2026 01:29 Rozwiązano w aplikacji mobilnej
Egzamin zdany!
Wynik: 25/40 punktów (62,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Jako strzał oznaczono 3 odpowiedzi - trafionych: 1.
Z odpowiedzi deklarowanych jako pewne poprawnych było 24 z 37. Trafiony strzał to nie jest wiedza - te pytania warto powtórzyć w pierwszej kolejności.
Twój wynik na tle innych
Twój wynik jest lepszy niż 31% podejść do kwalifikacji INF.04.
Porównanie z 23418 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Taki sam wynik jak poprzednio (62,5%).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Algorytm przedstawiony powyżej może zostać zaimplementowany w języku Java z wykorzystaniem instrukcji:
A.
while
Poprawna odpowiedź
B.
switch
C.
if
Twoja odpowiedź
D.
try
Niepoprawna odpowiedź. Instrukcja 'switch' to coś, co służy do wyboru pomiędzy kilkoma opcjami, więc nie da się jej użyć do powtarzania czegoś. 'if' to z kolei taki sposób na sprawdzenie warunku raz, a 'try' to konstrukcja do obsługi wyjątków, a nie do pętli. Chociaż 'if' może czasem być używane w bardziej złożonych pętlach, to nie jest to jego główna rola.
Pytanie 2
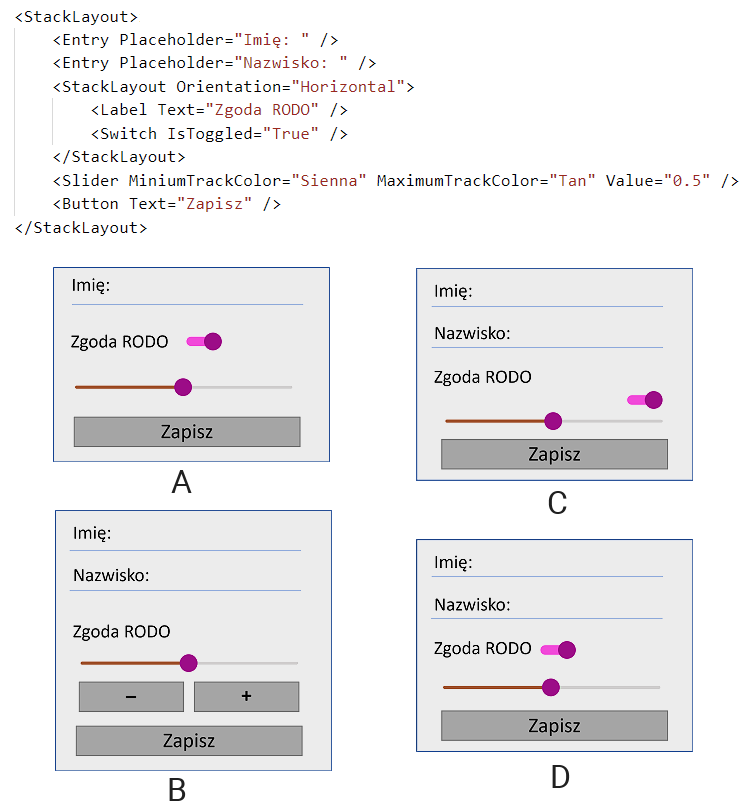
Kod XAML zaprezentowany powyżej zostanie wyświetlony jako:
A
B
C
DTwoja odpowiedź
Poprawna odpowiedź. Wybrałeś dokładnie taką odpowiedź, jaką powinien wskazać każdy, kto dobrze rozumie XAML i układ StackLayout. Zobacz, co tu się dzieje: dwa pola Entry wyświetlają się jedno pod drugim, co daje klasyczną strukturę formularza – najpierw pole "Imię", potem "Nazwisko". Dalej mamy StackLayout z orientacją poziomą (Horizontal), więc etykieta "Zgoda RODO" oraz przełącznik Switch pojawiają się obok siebie – to bardzo typowy sposób na prezentację zgody na coś w aplikacjach, bo nie ma sensu rozdzielać tego na dwie linie. Po nich pojawia się Slider z ustawionym Value na 0.5 i kolorami MinimumTrackColor oraz MaximumTrackColor, czyli dokładnie tak jak widać na obrazku – jeden kolor po lewej, drugi po prawej i kółko pośrodku. Na końcu jest Button "Zapisz". Moim zdaniem, taki układ to wręcz klasyka budowy prostych formularzy w aplikacjach mobilnych opartych na XAML. Swoją drogą, to świetny przykład, jak StackLayout pozwala na szybkie i czytelne układanie elementów na ekranie, bez zbędnego komplikowania interfejsu. W praktyce warto jeszcze pamiętać, że oddzielenie pól Entry podnosi czytelność, a stosowanie układów poziomych sprawdza się wtedy, gdy chcesz, żeby użytkownik od razu widział etykietę i jej kontrolkę. Widać tu też dbałość o kolory i spójność wizualną. Według mnie, warto od razu testować takie formularze na różnych urządzeniach, bo StackLayout zachowuje się przewidywalnie, ale warto mieć na uwadze responsywność – no i nie zapomnij, że Slider i Switch mają swoje domyślne wartości, które można łatwo sterować z kodu.
Pytanie 3
Kod w bibliotece React.js oraz w frameworku Angular, który został zaprezentowany, ma na celu wyświetlenie
D. wyłącznie przycisku oraz obsłużenie zdarzenia click, które ono generujeTwoja odpowiedź
Niepoprawna odpowiedź. Wydaje się, że łatwo tu popaść w uproszczenia lub ulec pierwszemu wrażeniu na temat działania tego kodu, zwłaszcza jeśli nie patrzy się na całą strukturę zarówno w React, jak i Angularze. Sam przycisk z napisem BTN_1 faktycznie występuje, ale nie to jest sednem – komponenty nie ograniczają się tylko do wyświetlania przycisku. Ich główną rolą jest obsługa interakcji: kliknięcie nie tylko wywołuje zdarzenie, lecz przede wszystkim modyfikuje stan licznika i od razu aktualizuje widok. Sądząc, że program ma wyświetlać „tylko napis” lub „tylko przycisk i obsługę click”, pomija się istotę działania frameworków: dynamiczną prezentację danych w odpowiedzi na działania użytkownika. Pojawia się też czasem mylne założenie, że widok pokazuje wartość 0 po kliknięciu – to nieprawda, bo oba fragmenty kodu startują z wartością 0, ale po kliknięciu ta wartość jest zwiększana i od razu pokazuje nową liczbę kliknięć. To bardzo typowy błąd, wynikający z niezrozumienia jak aktualizowany jest stan komponentu i jak natychmiast to wpływa na renderowanie widoku. Trzeba jeszcze pamiętać, że samo „obsłużenie zdarzenia click” jest tylko częścią procesu – pełna funkcjonalność polega na wyświetleniu aktualnej liczby kliknięć, czyli dynamicznej reakcji na akcje użytkownika. Dlatego w branży kładzie się nacisk na powiązanie warstwy widoku z logiką biznesową poprzez stan komponentu – to jest podstawa nowoczesnych aplikacji. Zakładając, że chodzi tylko o statyczny element lub samo zdarzenie, zupełnie pomija się sedno tego typu zadań, gdzie właśnie dynamiczna aktualizacja UI po akcji użytkownika jest kluczowa. Takie błędne założenia często biorą się z pobieżnego czytania kodu lub nieznajomości mechanizmów reaktywności i data bindingu, które są fundamentem zarówno Reacta, jak i Angulara.
Pytanie 4
Jaką strukturę danych można zrealizować, korzystając jedynie z wymienionych metod?
push(arg) – dodaje element pop() – usuwa ostatnio dodany element peek() – zwraca ostatnio dodany element bez usuwania isEmpty() – sprawdza czy istnieją dane w strukturze
A. stosPoprawna odpowiedź
B. kolejka FIFO
C. tablicaTwoja odpowiedź
D. drzewo binarne
Niepoprawna odpowiedź. Każda z błędnych odpowiedzi w tym pytaniu odnosi się do popularnych struktur danych, jednak żadna z nich nie pasuje do zestawu metod, które tutaj pokazano. Zacznijmy od kolejki FIFO – tam główną zasadą jest First In, First Out, czyli pierwszy dodany element wypada jako pierwszy. Aby zrealizować kolejkę, potrzebne są zwykle metody enqueue (dodawanie na koniec) i dequeue (usuwanie z początku), czasem jeszcze peek do podejrzenia pierwszego elementu. Natomiast w prezentowanym zestawie nie mamy operacji rozróżniających początek i koniec – wszystko dzieje się tylko „na górze”, co zupełnie nie oddaje natury kolejki. Tablica z kolei daje dostęp do elementów przez indeksy, można przeskakiwać losowo po jej zawartości, zmieniać konkretne pozycje – czego w ogóle nie da się zrobić, mając tylko push, pop, peek i isEmpty. Dla drzewa binarnego brakuje tu zupełnie kluczowych mechanizmów – nie ma odniesień do lewego czy prawego potomka, nie da się wstawić elementu zgodnie z regułami drzewa, ani przeszukiwać go w odpowiedni sposób. Często na etapie nauki pojawia się taki błąd, że ktoś patrzy na pojedyncze funkcje, a nie dostrzega całej filozofii stojącej za strukturą. W praktyce, żeby dobrze dopasować strukturę do zadania, trzeba zawsze pytać, jakie są zasady dostępu do danych i jakich operacji naprawdę potrzebujemy. Dopiero wtedy można ocenić, czy pasuje nam stos, kolejka, tablica czy drzewo – a w tym przypadku, patrząc na metody, tylko stos jest odpowiedzią zgodną z logiką i branżowymi standardami.
Pytanie 5
Jaką strukturę danych obrazuje zamieszczony kod w języku C#?
int[,]array=newint[3,3];
A. tablicę jednowymiarową
B. tablicę dwuwymiarowąTwoja odpowiedź
C. stos
D. listę
Poprawna odpowiedź. Kod, który widzisz, tworzy tablicę dwuwymiarową w języku C#. Zapis int[,] array = new int[3, 3]; oznacza, że deklarujesz strukturę, gdzie każdy element jest dostępny przez dwa indeksy – pierwszy wskazuje wiersz, drugi kolumnę. Tablice dwuwymiarowe są bardzo popularne przy przechowywaniu macierzy, plansz w grach (na przykład szachownicy czy sudoku), a nawet obrazów, gdzie każdy piksel opisuje się przez współrzędne. Moim zdaniem, znajomość takich struktur naprawdę ułatwia tworzenie bardziej złożonych algorytmów, bo niekiedy dostępu do danych nie da się zamknąć w jednej linii, tylko trzeba się poruszać w dwóch wymiarach. Jeżeli chodzi o dobre praktyki, to warto pamiętać, że tablica dwuwymiarowa w .NET jest strukturą "prostokątną", czyli każdy wiersz ma tyle samo kolumn – coś jak klasyczna tabela w Excelu. To różni się od tzw. tablic tablic (ang. jagged arrays), które pozwalają mieć nierówną liczbę elementów w wierszach, ale to już trochę inna bajka. W twoim przykładzie stworzyłeś tablicę o rozmiarze 3x3, czyli 9 elementów, do których odwołujesz się za pomocą array[wiersz, kolumna]. Może się to wydawać proste, ale z mojego doświadczenia to właśnie takie zrozumienie podstawowych konstrukcji pozwala pisać czytelny i wydajny kod. W branży często spotyka się sytuacje, gdzie optymalizacja działania na tablicach – zwłaszcza tych dwuwymiarowych – robi różnicę, więc warto to mieć dobrze opanowane.
Pytanie 6
Fragment kodu w języku JavaScript to
letmodulo=(x,y)=>x%y;
A. Prototyp metody klasy
B. Definicja zmiennej typu tablicowego
C. Prototyp interfejsu
D. Definicja funkcji strzałkowejTwoja odpowiedź
Poprawna odpowiedź. Ten fragment kodu w JavaScript to klasyczny przykład funkcji strzałkowej, czyli tzw. arrow function. To funkcja zdefiniowana w bardzo nowoczesny, oszczędny sposób, który pojawił się wraz z ES6 (ECMAScript 2015). Taki zapis pozwala na szybkie tworzenie prostych funkcji anonimowych, bez potrzeby używania słowa kluczowego 'function'. Ma to ogromne znaczenie np. przy pracy z wyrażeniami funkcyjnymi, callbackami albo wszędzie tam, gdzie liczy się zwięzłość kodu. Samo 'let modulo = (x, y) => x % y;' oznacza, że tworzymy zmienną 'modulo', która przechowuje funkcję przyjmującą dwa argumenty i od razu zwracającą resztę z dzielenia x przez y. Co ciekawe, funkcje strzałkowe różnią się od tradycyjnych tym, że nie mają własnego kontekstu this (dziedziczą go z otoczenia). To jest bardzo przydatne np. przy pracy w metodach klas lub obiektach, gdzie nie chcemy nieoczekiwanej zmiany kontekstu. Moim zdaniem warto nawykowo korzystać z tej składni, bo kod robi się dużo czytelniejszy i łatwiejszy w utrzymaniu. W różnych frameworkach (np. React) funkcje strzałkowe są wręcz codziennością – definiuje się tak np. proste event handlery czy filtry. No i jeszcze jedno: taka funkcja jest idealna, gdy chcemy przekazać logikę w jednym krótkim wyrażeniu bez robienia bałaganu w kodzie.
Pytanie 7
Przykład wywołania funkcji zamien w języku C++ może wyglądać w następujący sposób:
voidzamien(int *a, int *b) {inttmp;tmp= *a;
*a= *b;
*b=tmp;}
A.
zamien(12,34)
B.
zamien(*a,*b);// a, b - zmienne całkowite
C.
zamien(&a,&b);// a, b - zmienne całkowite
Twoja odpowiedź
D.
zamien(m,n);// m, n - zmienne całkowite
Poprawna odpowiedź. W tym przypadku wywołanie zamien(&a, &b); jest prawidłowe, bo funkcja zamien oczekuje wskaźników do zmiennych całkowitych, nie samych wartości tych zmiennych ani ich referencji. Przekazując adresy przez &a i &b, pozwalamy funkcji modyfikować oryginalne zmienne, a nie ich kopie. To jest fundament operacji wskaźnikowych w C++. Takie podejście umożliwia tzw. przekazywanie przez adres, które jest wykorzystywane wszędzie tam, gdzie trzeba w funkcji podmienić faktyczną zawartość zmiennej, a nie tylko jej kopię. W praktyce, na przykład podczas sortowania tablic czy zamiany miejscami dwóch wartości, korzysta się właśnie z takiego mechanizmu. Przekazywanie wskaźników jest bardzo uniwersalne – pozwala nie tylko zmieniać wartości, ale też np. przekazywać duże struktury bez kopiowania całej ich zawartości, co przyspiesza program i zmniejsza zużycie pamięci. Moim zdaniem warto też zauważyć, że użycie wskaźników jest jednym z filarów programowania na niskim poziomie w C i C++. Wielu początkujących programistów boi się wskaźników (nie wiem czemu, chyba przez te wszystkie historie o błędach i segfaultach), ale jak się już zrozumie, dlaczego i jak przekazywać adresy zmiennych, to potem dużo łatwiej korzystać z bardziej zaawansowanych mechanizmów np. dynamicznej alokacji pamięci czy tablic wskaźników. Standard C++ wręcz zaleca, by wszędzie tam, gdzie funkcja ma zmienić przekazane wartości, używać wskaźników lub referencji. W tym przypadku wskaźniki są idealne, bo dokładnie tego wymaga deklaracja funkcji. Dobrze jest też znać różnicę między przekazywaniem przez wartość, wskaźnik i referencję, bo to pozwala świadomie projektować interfejsy funkcji.
Pytanie 8
W programie stworzonym w języku C++ trzeba zadeklarować zmienną, która będzie przechowywać wartość rzeczywistą. Jakiego typu powinna być ta zmienna?
A.
int
Twoja odpowiedź
B.
double
Poprawna odpowiedź
C.
number
D.
numeric
Niepoprawna odpowiedź. Intuicyjnie można by pomyśleć, że każda zmienna liczbową da się zadeklarować przez int, bo przecież to najprostszy i najpopularniejszy typ w języku C++. Jednak int przechowuje wyłącznie liczby całkowite – nie pozwala na zapis ułamków czy wartości dziesiętnych. To bardzo częsty błąd początkujących programistów, którzy próbują przechować 7.5 w int i są zaskoczeni, że wynik zawsze jest zaokrąglany w dół. Równie problematyczne są próby użycia typów, które wyglądają na sensowne, ale w rzeczywistości nie istnieją w C++. Przykłady to number i numeric – brzmią profesjonalnie, można je spotkać w innych językach (np. number w JavaScript), ale C++ nie przewiduje takich deklaracji. Kompilator po prostu zgłosi błąd i nie skompiluje programu. Z mojego doświadczenia, wielu uczniów daje się nabrać na te angielskie słówka, bo wydają się logiczne. Tymczasem C++ ma ścisłe zasady i ogranicza się do konkretnych typów jak int, float, double czy long double. Jeśli chodzi o double, to jest to oficjalnie wspierany przez standard ISO typ do zmiennych rzeczywistych, stosowany wszędzie tam, gdzie float nie daje wystarczającej precyzji. Warto też zauważyć, że korzystanie z nieistniejących typów prowadzi do błędów kompilacji, co jest nie tylko stratą czasu, ale i może utrudnić dalszą naukę programowania, bo utrwala złe nawyki. Podsumowując, jeśli chcesz przechowywać liczby rzeczywiste w C++, musisz użyć double lub ewentualnie float, a nie int, number czy numeric – te ostatnie po prostu w tym języku nie działają.
Pytanie 9
Po uruchomieniu poniższego kodu w języku C++ w konsoli pojawi się ciąg liczb:
inta=1;while(a++ < 6){cout<< a<< " ";}
A. 1 2 3 4 5 6
B. 2 3 4 5 6 7
C. 1 2 3 4 5Twoja odpowiedź
D. 2 3 4 5 6Poprawna odpowiedź
Niepoprawna odpowiedź. Z tego co widzę, najczęstsze nieporozumienia związane z tym pytaniem wynikają z mylenia sposobu działania operatora postinkrementacji z preinkrementacją, a także niezrozumienia kolejności wykonania instrukcji w pętli. W tym przykładzie zapis a++ < 6 sprawia, że najpierw do warunku trafia obecna wartość a (sprawdzana jest 1 < 6), dopiero potem następuje zwiększenie a do 2. Wewnątrz pętli wypisywana jest już ta nowa wartość. To może być mylące, bo ktoś mógłby założyć, że najpierw następuje inkrementacja, a potem sprawdzenie warunku – tak by było przy ++a < 6, ale nie przy a++ < 6. Kolejna rzecz: wybierając odpowiedzi typu 1 2 3 4 5 6 lub 2 3 4 5 6 7, można nieświadomie przyjąć, że pętla wypisuje także wartości początkową lub końcową poza zakresem warunku, co w tym kodzie nie ma miejsca. Częstym błędem jest też założenie, że warunek a++ < 6 przepuszcza do wypisania wartość 6 lub nawet 7, ale w rzeczywistości przy a równym 6 warunek staje się fałszywy i pętla się kończy. Takie subtelności są bardzo istotne w codziennym programowaniu, szczególnie kiedy pracuje się z pętlami sterującymi wykonywaniem algorytmów czy przetwarzaniem danych w tablicach. Praktyka pokazuje, że przeoczenie różnic między post- i pre-inkrementacją prowadzi do bugów, które często trudno namierzyć, a ich efekty mogą wychodzić dopiero po dłuższym czasie. Moim zdaniem najlepiej przyjąć zasadę, by czytać kod spokojnie linijka po linijce i zwracać uwagę na to, co dzieje się z każdą zmienną w każdej iteracji. Uczy to logicznego myślenia i pozwala lepiej rozumieć mechanizmy języka – a to podstawa do pisania solidnego, przewidywalnego kodu.
Pytanie 10
Jaki tekst zostanie wyświetlony po uruchomieniu jednego z poniższych fragmentów kodu? Kod w React:
<h2>{2+2}</h2>
Kod w Angular:
<h2>{{2+2}}</h2>
A. {{2+2}}
B. {2+2}
C. 4Twoja odpowiedź
D. {4}
Poprawna odpowiedź. To pytanie jest świetną okazją, żeby zobaczyć, jak działają wyrażenia w szablonach Reacta i Angulara. Odpowiedź „4” jest prawidłowa, bo zarówno w React, jak i w Angularze, zawarte w nawiasach klamrowych wyrażenie matematyczne 2+2 jest oceniane przez silnik JavaScript podczas renderowania komponentu. Nie jest to zwykły tekst, tylko dynamiczne wyliczenie. Dzięki temu React (w JSX) oraz Angular (w interpolacji {{}}) najpierw obliczają sumę, a potem podstawiają wynik w miejsce wyrażenia – czyli na ekranie pojawia się zwykły tekst „4”. Moim zdaniem to jedna z największych zalet tych frameworków, bo pozwala na bardzo elastyczne budowanie UI, gdzie dynamiczne dane mogą być wstawiane praktycznie wszędzie, bez potrzeby ręcznego tworzenia dodatkowych zmiennych czy długich instrukcji warunkowych. W praktyce często stosuje się takie podejście chociażby do wyświetlania wyników obliczeń, liczników, czy dynamicznych podsumowań. Z mojego doświadczenia, warto pamiętać, że każde wyrażenie w takich miejscach powinno być możliwie proste — złożone logiki lepiej wynieść do funkcji, bo wtedy szablon pozostaje czytelny. Warto też mieć świadomość, że React i Angular automatycznie konwertują wynik na tekst, więc nie trzeba się martwić o jawne rzutowanie. To podejście jest zgodne z dobrymi praktykami branżowymi – prosty, czytelny kod to podstawa w nowoczesnych aplikacjach webowych.
Pytanie 11
Wynik dodawania liczb binarnych 1101 i 1001 to
A. 1110
B. 10111Twoja odpowiedź
C. 1001
D. 10110Poprawna odpowiedź
Niepoprawna odpowiedź. Bardzo często w zadaniach z dodawaniem liczb binarnych pojawiają się podobne wyniki, które wydają się poprawne na pierwszy rzut oka, ale kryją w sobie pewne pułapki. Niektórzy mylą się, bo patrzą na liczby binarne tak, jakby były dziesiętne – i wtedy np. widząc dwie jedynki na końcu, chcą je po prostu zsumować bez uwzględnienia reguł przeniesienia. Podejście, w którym wynik brzmi 1110, może wynikać z zignorowania przeniesień albo nieuwzględnienia wszystkich pozycji. Z kolei odpowiedź 10111 sugeruje, że ktoś mógł źle policzyć liczbę bitów lub źle zinterpretował przeniesienie (może dodał je do niewłaściwej pozycji). Wybór 1001 to już typowy błąd polegający na przepisaniu jednej z liczb wejściowych – czasem przez pośpiech lub nieuwagę. Takie błędy zdarzają się nawet osobom, które już trochę mają doświadczenia z binarką. W praktyce, sumowanie binarne wymaga skrupulatności: każdą kolumnę trzeba dokładnie przeanalizować, a przeniesienia wpisywać do kolejnej pozycji. To trochę jak dodawanie w podstawówce, tylko wszystko odbywa się w systemie dwójkowym. Moim zdaniem kluczową sprawą jest wyrobienie nawyku rozpisywania operacji krok po kroku, szczególnie na początku nauki. W branży elektronicznej czy informatycznej takie błędy mogą prowadzić do poważnych problemów – np. niewłaściwego działania algorytmów lub błędów w transmisji danych. Standardy, takie jak opis działania sumatorów pełnych (full adder) w układach cyfrowych, jasno wskazują na konieczność uwzględniania przeniesień i poprawnego zapisywania wyników. Moim zdaniem warto za każdym razem weryfikować swój wynik, bo nawet drobna pomyłka na tym etapie potrafi potem odbić się czkawką w dalszych obliczeniach. Sprawdzanie binarnych operacji na piechotę jest dobrym nawykiem, bo pozwala wyłapać takie typowe błędy i utrwala zrozumienie systemu dwójkowego.
Pytanie 12Strzał
W jakim języku programowania kod źródłowy musi być skompilowany do kodu maszynowego konkretnej architektury procesora przed jego uruchomieniem?
A. PHP
B. PerlTwoja odpowiedź
C. Java
D. C++Poprawna odpowiedź
Niepoprawna odpowiedź. Wiele osób zakłada, że języki takie jak PHP, Perl czy Java działają podobnie do C++, jeśli chodzi o uruchamianie kodu, ale to tylko pozory. PHP i Perl są językami interpretowanymi – ich kod źródłowy jest analizowany i wykonywany 'w locie' przez interpreter, bez wcześniejszego tłumaczenia na natywny kod maszynowy procesora. To oznacza, że można szybko wdrażać zmiany, ale kosztem wydajności i czasem większego zużycia zasobów. Takie podejście jest popularne w aplikacjach webowych, gdzie szybkość wdrażania jest ważniejsza niż absolutna prędkość działania. Java wygląda na pierwszy rzut oka na język kompilowany, bo korzysta z kompilatora, ale w rzeczywistości kompiluje kod źródłowy do tzw. bytecode'u, który jest wykonywany przez maszynę wirtualną JVM. To sprawia, że programy w Javie są bardzo przenośne (mogą działać na różnych systemach operacyjnych), ale nie są bezpośrednio tłumaczone na instrukcje dla konkretnego modelu procesora. W C++ natomiast kompilacja to proces tłumaczenia kodu na czysto maszynowe instrukcje, takie jakie rozumie konkretny fizyczny procesor – to daje większą wydajność, ale i mniejszą przenośność (trzeba kompilować osobno dla każdej platformy). Moim zdaniem często mylimy kompilację do kodu bajtowego z kompilacją do kodu maszynowego, a to są dwa zupełnie różne podejścia. W profesjonalnych projektach wybór technologii zawsze zależy od potrzeb – jeżeli wymagana jest pełna wydajność i kontrola nad sprzętem, to stawia się na języki takie jak C++. W przypadku PHP, Perla czy Javy liczy się raczej łatwość wdrażania i przenośność. To rozróżnienie jest kluczowe dla zrozumienia, jak działa świat programowania na poziomie systemowym i aplikacji wysokopoziomowych.
Pytanie 13
Diagramem, który służy do śledzenia realizacji zadań przez członków zespołu projektowego, może być
A. Venna
B. GanttaPoprawna odpowiedź
C. związków encjiTwoja odpowiedź
D. aktywnosci UML
Niepoprawna odpowiedź. Wydaje się, że niektóre z tych diagramów brzmią technicznie znajomo, ale niestety nie są właściwym wyborem, jeśli chodzi o monitorowanie realizacji zadań przez członków zespołu projektowego. Diagram Venna, choć rzeczywiście przydatny do ukazywania części wspólnych i relacji między zbiorami, raczej nie nadaje się do śledzenia postępu prac czy rozkładu zadań w projekcie. To narzędzie typowo matematyczne, można go spotkać w analizie danych czy prezentowaniu wspólnych cech, ale nie w harmonogramowaniu projektów. Diagram związków encji kojarzy się mocno z bazami danych, bo służy do wizualizacji relacji między encjami w systemach informatycznych. Tego typu diagramy są świetne przy projektowaniu struktur danych, ale zupełnie nie pokazują kto, kiedy i co ma zrobić – czyli nie odpowiadają na potrzeby zarządzania zespołem projektowym. Z kolei diagram aktywności UML, używany do opisu przepływu pracy czy procesów w systemach informatycznych, pozwala zobrazować, jak dane czynności następują po sobie i jakie warunki muszą być spełnione, by przejść do kolejnych etapów. To jednak nadal nie jest narzędzie, które pozwala na efektywne śledzenie postępu zadań przypisanych konkretnym osobom oraz zarządzanie realizacją elementów projektu w czasie. Częstym błędem jest mylenie narzędzi do modelowania procesów z narzędziami do zarządzania projektem – to, że diagram coś dobrze pokazuje, nie znaczy jeszcze, że jest uniwersalny. Moim zdaniem kluczem jest tu rozumienie, że w zarządzaniu projektami liczy się nie tylko wizualizacja procesu, ale też kontrola czasu, odpowiedzialności i zależności między zadaniami, co właśnie zapewnia dobrze zrobiony diagram Gantta.
Pytanie 14Strzał
Która grupa typów zawiera wyłącznie typy złożone?
A.
class,struct,float
B.
char,struct,union
C.
class,struct,union
Twoja odpowiedź
D.
unsigned,struct,float
Poprawna odpowiedź. W tej odpowiedzi trafiłeś w sedno, bo class, struct oraz union to typowe przykłady typów złożonych w językach programowania takich jak C++ czy C. Każdy z nich służy do przechowywania bardziej skomplikowanych struktur danych niż zwykłe typy proste jak int czy float. Klasa (class) to podstawa programowania obiektowego. Pozwala łączyć dane i funkcje w jeden byt – obiekt. Z mojego doświadczenia korzystanie z klas daje ogromne możliwości, bo można ukrywać szczegóły implementacji czy stosować dziedziczenie – co jest nieocenione przy większych projektach. Struktura (struct) to taki trochę prostszy wariant klasy, szczególnie w C, gdzie nie obsługuje ona metod czy hermetyzacji, ale w C++ różnice się zacierają. Union natomiast pozwala na oszczędność pamięci – kilka pól dzieli ten sam obszar pamięci, czyli tylko jedno z nich jest aktywne w danej chwili. To się przydaje np. w programowaniu niskopoziomowym, obsłudze różnych protokołów czy pracy z rejestrami sprzętowymi. Według standardów ISO/IEC dla języka C++ (np. 14882:2017), właśnie te trzy typy należą bezdyskusyjnie do grupy złożonych, bo są zbudowane z innych typów i pozwalają lepiej modelować rzeczywistość. Warto pamiętać, że typy złożone są podstawą nowoczesnych technik projektowania oprogramowania. W praktyce, nawet w prostych aplikacjach, korzystanie z tych struktur podnosi czytelność i ułatwia przyszłą rozbudowę kodu.
Pytanie 15
Szablon MojaTablica oferuje funkcjonalność tablicy z indeksami oraz elementami różnych typów. W oparciu o pokazany kod, który wykorzystuje ten szablon do tworzenia tablicy asocjacyjnej, wskaż definicję, która posługuje się szablonem do zainicjowania tablicy, gdzie indeksami są liczby całkowite, a elementami są napisy?
Niepoprawna odpowiedź. Deklaracja int tab2[] = new MojaTablica(); jest nieprawidłowa, ponieważ int odnosi się do typów prostych, a nie do tablic asocjacyjnych. MojaTablica tab2 = MOjaTablica(); zawiera literówkę i nie inicjalizuje nowego obiektu. Int tab2 = new MojaTablica(); jest błędne, ponieważ tablica asocjacyjna nie może być przypisana do typu int – wymaga użycia typu zgodnego z definicją szablonu.
Pytanie 16
Klasa Mieszkaniec zawiera atrybuty: imie, nazwisko, ulica, nrDomu, rokUrodzenia. W tej klasie umieszczono opisane poniżej konstruktory (zapisano jedynie typy argumentów). Do tworzenia obiektu za pomocą konstruktora kopiującego wykorzystany będzie konstruktor określony w punkcie
A.
Mieszkaniec();
B.
Mieszkaniec(string,string,string,int,int);
Twoja odpowiedź
C.
Mieszkaniec(string,string);
D.
Mieszkaniec(Mieszkaniec&);
Poprawna odpowiedź
Niepoprawna odpowiedź. Zwykłe konstruktory bez parametrów to tak naprawdę nie to samo, co konstruktor kopiujący. One tylko inicjują nową instancję, a kopii to one nie robią. Konstruktory, które dostają typy proste, służą tylko do ustawiania początkowych wartości pól, a więc też nie kopiują nic. Metody, które inicjalizują, są do przypisywania wartości po stworzeniu obiektu, ale to też nie to samo co konstruktor kopiujący.
Pytanie 17Strzał
Jakie elementy zostaną wyświetlone w przeglądarce po wykonaniu kodu źródłowego stworzonego za pomocą dwóch funkcjonalnie równoważnych fragmentów? KOD W ANGULAR:
tags: string[] = ['tag1', 'tag2', 'tag3' ];// ...<p *ngFor="let tag of tags"> {{tag}} </p>
KOD W REACT.JS:
state = { tags: ['tag1', 'tag2', 'tag3'] };// ... /* w instrukcji return metody render */<React.Fragment>
{ this.state.tags.map(tag => <p key={tag}>{tag}</p>) }
</React.Fragment>
A. Trzy paragrafy, każdy odpowiadający kolejnemu elementowi tablicy tags.Poprawna odpowiedź
B. Jeden paragraf zawierający wszystkie elementy tablicy tags w kolejności.
C. Jeden paragraf z pierwszym elementem tablicy tags.Twoja odpowiedź
D. Trzy paragrafy, w każdym z nich tekst o treści: {tag}.
Niepoprawna odpowiedź. Generowanie jednego paragrafu zawierającego wszystkie elementy tablicy nie pozwala na elastyczne formatowanie i stylizację każdego elementu osobno. Taka implementacja jest rzadziej stosowana, ponieważ ogranicza kontrolę nad poszczególnymi elementami interfejsu. Wyświetlanie tylko pierwszego elementu tablicy jest błędem logicznym i pomija pozostałe dane, co prowadzi do niepełnego wyświetlenia informacji. Wygenerowanie trzech paragrafów z identyczną treścią '{tag}' sugeruje błędne odwołanie do zmiennej, co oznacza, że iteracja została przeprowadzona nieprawidłowo lub że niepoprawnie użyto zmiennej w szablonie.
Pytanie 18
Jaki jest wymagany sposób do realizacji algorytmu sortowania bąbelkowego na n-elementowej tablicy?
A. n-liczby warunków
B. dwie pętle funkcjonujące na co najmniej (n+1) elementach każda
C. jedna pętla operująca na 2n elementach oraz warunek
D. dwie pętle działające na najwyżej n-elementach każdaTwoja odpowiedź
Poprawna odpowiedź. Aby zaimplementować algorytm sortowania bąbelkowego, potrzebne są dwie pętle iteracyjne, które porównują i zamieniają miejscami elementy tablicy. Zewnętrzna pętla iteruje po całej tablicy, natomiast wewnętrzna pętla wykonuje kolejne porównania i przestawia elementy, jeśli są one w nieprawidłowej kolejności. Algorytm sortowania bąbelkowego charakteryzuje się prostotą, ale jego złożoność obliczeniowa wynosi O(n²), co czyni go mało efektywnym dla dużych zbiorów danych. Niemniej jednak, jest to jedno z pierwszych ćwiczeń programistycznych, które wprowadza do zagadnień algorytmicznych i uczy podstaw iteracji oraz manipulacji tablicami. Pomimo swojej niskiej wydajności, sortowanie bąbelkowe jest często wykorzystywane do celów edukacyjnych oraz w przypadkach, gdy prostota implementacji ma większe znaczenie niż szybkość działania.
Pytanie 19
W zestawieniu zaprezentowano doświadczenie zawodowe pracowników firmy IT. Do stworzenia aplikacji front-end powinien/powinna zostać wyznaczony/a
Pracownik
Znajomość technologii lub programów
Anna
Inkscape, Corel Draw
Krzysztof
Angular
Patryk
HTML, CSS
Ewa
Django, .NET
A. KrzysztofPoprawna odpowiedź
B. Anna
C. PatrykTwoja odpowiedź
D. Ewa
Niepoprawna odpowiedź. Anna zna programy graficzne jak Inkscape czy Corel Draw, które są spoko do tworzenia grafiki wektorowej, ale nie nadają się do budowy aplikacji front-end. Te narzędzia bardziej są w rękach grafików, którzy robią ilustracje i projekty wizualne, więc to nie do końca pasuje do front-endu, gdzie liczy się programowanie interakcji i logiki. Patryk ogarnia HTML i CSS, co jest podstawą do stawiania stron, ale niestety to nie wystarczy do budowy nowoczesnych aplikacji front-end. Musi znasz również frameworki JavaScript, takie jak Angular, React czy Vue.js, żeby aplikacja była interaktywna i by dało się z danymi lepiej zarządzać. Ewa ma umiejętności w Django i .NET, które są używane po stronie serwera. Django to framework w Pythonie, a .NET obsługuje różne języki, w tym C#. Te technologie są super do backendu, ale do front-endu już nie bardzo. Dlatego Ewa może być świetna w budowie serwerowej części aplikacji, ale nie w tworzeniu interfejsu użytkownika. Zrozumienie różnic między backendem a frontendem jest kluczowe, bo jeśli wybierzesz niewłaściwą osobę do zadania, mogą być kłopoty z integracją i wydajnością aplikacji. Dlatego ważne, żeby do front-endu był ktoś z odpowiednim doświadczeniem, tak jak Krzysztof, który zna Angulara.
Poprawna odpowiedź. W tym zadaniu mamy do czynienia z tablicą asocjacyjną, która w Pythonie nazywa się słownikiem. Słownik to taki fajny sposób na przechowywanie par klucz-wartość, co jest naprawdę przydatne. W naszym przypadku kluczami są symbole chemiczne, jak N czy O, a wartościami ich pełne nazwy, czyli Azot oraz Tlen. Dzięki tej strukturze można szybko sięgnąć po konkretne dane, co jest bardzo pomocne w różnych sytuacjach. Na przykład, można używać ich do przechowywania konfiguracji albo do prostych baz danych. Warto też dodać, że słowniki świetnie pasują do obiektów JSON, co jest ważne w tworzeniu aplikacji webowych. Dają nam dużą elastyczność i robią to w bardzo efektywny sposób, dlatego są jednym z kluczowych elementów Pythona. Ułatwiają pisanie kodu, który jest zarówno czytelny, jak i funkcjonalny.
Pytanie 21
Modyfikator dostępu, który znajduje się przed definicją metody Dodaj() w klasie Kalkulator, powoduje, że
protectedvoidDodaj() {}
A. jest ona dostępna zarówno wewnątrz klasy, jak i w klasach dziedziczących po klasie KalkulatorTwoja odpowiedź
B. nie jest ona dostępna w klasach, które dziedziczą po klasie Kalkulator
C. jest ona dostępna w programie głównym i może być wywoływana na rzecz instancji klasy Kalkulator
D. nie jest ona dostępna z poziomu klas zaprzyjaźnionych z klasą Kalkulator
Poprawna odpowiedź. Modyfikator dostępu protected jest kluczowym elementem programowania obiektowego, umożliwiającym kontrolę nad widocznością i dostępem do składników klasy. Gdy metoda jest oznaczona jako protected, jak w przypadku metody Dodaj() w klasie Kalkulator, oznacza to, że jest ona dostępna nie tylko w ramach tej klasy, ale również w dowolnych klasach, które dziedziczą po klasie Kalkulator. To podejście wspiera koncepcję dziedziczenia, umożliwiając klasom potomnym korzystanie z funkcjonalności klasy bazowej bez konieczności ponownego definiowania metod. Na przykład, jeśli stworzymy klasę DziecięcyKalkulator dziedziczącą po Kalkulator, metoda Dodaj() będzie dostępna w tej klasie potomnej. Takie rozwiązanie jest często stosowane w projektach, gdzie istnieje potrzeba rozszerzania funkcjonalności bazowych klas bez naruszania ich enkapsulacji. Dobre praktyki programistyczne sugerują stosowanie protected tam, gdzie chcemy umożliwić dziedziczenie oraz uniknąć nadmiernego udostępniania elementów klasy zewnętrznym użytkownikom. Dzięki temu kod staje się bardziej modularny i elastyczny, co jest istotne w dużych projektach programistycznych. Zrozumienie roli modyfikatorów dostępu, takich jak protected, jest kluczowe dla efektywnego projektowania i implementacji systemów obiektowych.
Pytanie 22
Jakie narzędzie najlepiej sprawdza się w przekształcaniu liczby szesnastkowej na binarną?
A. Program do edycji tekstu
B. Kalkulator programistyTwoja odpowiedź
C. Program do arkuszy kalkulacyjnych
D. Aplikacja internetowa
Poprawna odpowiedź. Kalkulator programisty jest najbardziej odpowiednim narzędziem do konwersji liczby szesnastkowej na binarną ze względu na swoje wyspecjalizowane funkcje matematyczne i programistyczne. Narzędzia te umożliwiają użytkownikom łatwe przekształcanie różnych systemów liczbowych, w tym konwersji z systemu szesnastkowego (hex) na system binarny. Kalkulatory programistyczne często zawierają dedykowane opcje dla konwersji liczbowej, co pozwala na szybkie i dokładne uzyskanie wyników bez potrzeby stosowania skomplikowanych algorytmów lub wzorów. Na przykład, aby przekształcić liczbę szesnastkową '1A' na binarną, użytkownik wprowadza '1A' do kalkulatora, a wynik '00011010' zostaje automatycznie wygenerowany. Dodatkowo, wiele kalkulatorów programistycznych jest zgodnych z międzynarodowymi standardami, co zapewnia ich wiarygodność w obliczeniach. Warto również zauważyć, że kalkulatory programistyczne mogą obsługiwać konwersje z różnych systemów liczbowych, co czyni je wszechstronnym narzędziem w pracy z danymi cyfrowymi i kodowaniem. Dzięki temu, kalkulator programisty stanowi idealne rozwiązanie dla programistów i inżynierów, którzy regularnie pracują z różnymi formatami danych.
Pytanie 23
Jakie oznaczenie posiada norma krajowa w Polsce?
A. ISOTwoja odpowiedź
B. PNPoprawna odpowiedź
C. EN
D. IEC
Niepoprawna odpowiedź. ISO to coś międzynarodowego, a nie krajowego. EN to jakieś standardy, które obowiązują w całej Unii Europejskiej. Jeszcze IEC, to międzynarodowe normy dotyczące elektrotechniki i nie są to normy, które znajdziesz w Polsce. Polska Norma, czyli PN, to coś, co mamy tylko w naszym kraju i odnosi się tylko do polskiego systemu normalizacyjnego.
Pytanie 24
Jakie znaczenie ma przystosowanie interfejsu użytkownika do różnych platform?
A. Pozwala na unifikację kodu niezależnie od używanej platformy
B. Gwarantuje optymalne korzystanie z aplikacji na każdym urządzeniuTwoja odpowiedź
C. Umożliwia skoncentrowanie się wyłącznie na funkcjonalności aplikacji
D. Usuwa konieczność testowania na różnych platformach
Poprawna odpowiedź. Dostosowanie interfejsu do różnych urządzeń to naprawdę ważna sprawa, żeby wszystko działało jak należy. Aplikacje, które dobrze się przystosowują do różnych ekranów czy systemów, dają lepsze doświadczenie użytkownikom. Użycie takich technik jak responsywny design czy elastyczne układy, jak flexbox czy grid, to super pomysł. Dzięki temu elementy interfejsu same się skalują, a aplikacja wygląda spójnie na telefonach, tabletach i komputerach. Nie ma nic gorszego niż chaotyczny interfejs na różnych urządzeniach, więc to naprawdę kluczowa kwestia.
Pytanie 25
Który z wymienionych wzorców projektowych jest najbardziej odpowiedni do uproszczenia interfejsu złożonego systemu?
A. Kompozyt (Composite)
B. Metoda szablonowa (Template method)
C. Fasada (Facade)Twoja odpowiedź
D. Singleton (Singleton)
Poprawna odpowiedź. Wzorzec projektowy Fasada (Facade) upraszcza interfejs do złożonego systemu poprzez dostarczenie jednolitego punktu dostępu do wielu podsystemów. Dzięki temu klienci mogą korzystać z funkcji systemu za pomocą prostego interfejsu, co zwiększa czytelność kodu i ułatwia jego utrzymanie. Fasada jest szczególnie przydatna w dużych aplikacjach, gdzie wiele modułów wymaga skomplikowanej konfiguracji lub współdziałania. Wprowadzenie fasady ukrywa złożoność wewnętrzną systemu, jednocześnie zapewniając dostęp do niezbędnych funkcjonalności. To rozwiązanie jest często stosowane w systemach z wieloma interfejsami API, w architekturze mikroserwisów oraz przy integracji zewnętrznych bibliotek.
Pytanie 26
Który z wymienionych poniżej wzorców projektowych można zakwalifikować jako wzorzec strukturalny?
A. Metoda szablonowa (Template method)
B. Fasada (Facade)Twoja odpowiedź
C. Fabryka abstrakcyjna (Abstract Factory)
D. Obserwator (Observer)
Poprawna odpowiedź. Fasada (Facade) to wzorzec projektowy, który jest przykładem wzorca strukturalnego. Umożliwia on tworzenie uproszczonego interfejsu dla bardziej złożonego systemu, integrując wiele podsystemów i dostarczając jednolity punkt dostępu. Strukturalne wzorce projektowe skupiają się na organizacji klas i obiektów, a Fasada doskonale wpisuje się w tę kategorię, redukując złożoność i zwiększając czytelność kodu. Wzorzec ten jest szeroko stosowany w architekturze aplikacji, gdzie występuje potrzeba uproszczenia dostępu do skomplikowanych bibliotek lub systemów wewnętrznych.
Pytanie 27
Jakie są różnice między konstruktorem a zwykłą metodą w klasie?
A. Konstruktor powinien zwracać jakąś wartość
B. Konstruktor zawsze nosi tę samą nazwę co klasa i nie zwraca wartościTwoja odpowiedź
C. Konstruktor można wywołać bez konieczności tworzenia obiektu
D. Konstruktor jest uruchamiany jedynie przez destruktor
Poprawna odpowiedź. Konstruktor różni się od zwykłych metod klasy tym, że nosi taką samą nazwę jak klasa i nie zwraca żadnej wartości, nawet `void`. Konstruktor jest wywoływany automatycznie podczas tworzenia obiektu i nie można go wywołać ręcznie jak zwykłą metodę. Jego zadaniem jest inicjalizacja pól obiektu i przygotowanie go do działania. Przykład w C++: `class Samochod { public: Samochod() { marka = "Ford"; } }`. W przeciwieństwie do innych metod konstruktor nie wymaga deklaracji typu zwracanego, co jest jedną z jego najbardziej charakterystycznych cech.
Pytanie 28
Który z poniższych składników NIE jest konieczny do stworzenia klasy w C++?
A. Deklaracja atrybutów klasy
B. Definicja destruktoraTwoja odpowiedź
C. Definicja funkcji członkowskich klasy
D. Zastosowanie słowa kluczowego class
Poprawna odpowiedź. Do utworzenia klasy w C++ nie jest wymagana definicja destruktora. Destruktor to specjalna metoda klasy, która jest wywoływana automatycznie w momencie zniszczenia obiektu, ale jego obecność jest opcjonalna. Klasy, które nie operują bezpośrednio na zasobach zewnętrznych, takich jak dynamiczna pamięć lub pliki, często nie potrzebują destruktora, ponieważ domyślny destruktor generowany przez kompilator jest wystarczający. Aby utworzyć klasę, wystarczy deklaracja pól i metod oraz użycie słowa kluczowego 'class'. To sprawia, że C++ pozwala na szybkie definiowanie prostych klas, które można później rozwijać w miarę potrzeby.
Pytanie 29
Jakie działania można podjąć, aby uniknąć pogorszenia wzroku podczas korzystania z komputera?
A. Używać filtrów przeciwodblaskowych na ekranieTwoja odpowiedź
B. Korzytać ze słuchawek tłumiących dźwięki
C. Zachować stałą temperaturę w biurze
D. Stosować ergonomiczne podkładki pod ręce
Poprawna odpowiedź. Stosowanie filtrów przeciwodblaskowych na monitorze to skuteczny sposób na zapobieganie pogorszeniu wzroku podczas pracy przy komputerze. Filtry te redukują odbicia światła, zmniejszając zmęczenie oczu i poprawiając komfort pracy. Długotrwała praca przy komputerze bez odpowiedniej ochrony może prowadzić do zespołu suchego oka, bólu głowy i problemów z widzeniem. Filtry przeciwodblaskowe to prosty, ale bardzo efektywny sposób na poprawę ergonomii stanowiska pracy. W połączeniu z odpowiednim ustawieniem monitora, regularnymi przerwami oraz ćwiczeniami wzrokowymi, pomagają one w utrzymaniu zdrowia oczu.
Pytanie 30
Co należy zrobić w sytuacji silnego krwawienia z rany?
A. Przepłukać ranę wodą utlenioną i zostawić do wyschnięcia
B. Założyć opatrunek uciskowy oraz unieść kończynę powyżej poziomu sercaTwoja odpowiedź
C. Nałożyć elastyczny bandaż bez ucisku
D. Poczekać, aż krwawienie ustanie samoistnie
Poprawna odpowiedź. Założenie opatrunku uciskowego i uniesienie kończyny powyżej poziomu serca to najskuteczniejszy sposób na zatrzymanie silnego krwotoku z rany. Opatrunek uciskowy powoduje mechaniczne zamknięcie naczyń krwionośnych, co spowalnia lub całkowicie zatrzymuje wypływ krwi. Podniesienie kończyny dodatkowo zmniejsza ciśnienie krwi w obszarze rany, co ogranicza krwawienie. Ważne jest, aby nie zdejmować opatrunku, nawet jeśli przesiąknie krwią – należy dołożyć kolejną warstwę materiału. W sytuacjach ekstremalnych, gdy opatrunek uciskowy nie zatrzymuje krwawienia, można zastosować opaskę uciskową (tzw. stazę), ale tylko w ostateczności, gdy inne metody zawiodą. Takie działania mogą zapobiec wstrząsowi krwotocznemu i uratować życie poszkodowanego.
Pytanie 31
Który z wymienionych składników wchodzi w skład podstawowego wyposażenia środowiska IDE?
A. Kompilator, edytor kodu, debuggerTwoja odpowiedź
B. Edytor tekstowy, przeglądarka internetowa, translator
C. Kompilator, serwer webowy, system kontroli wersji
D. Edytor graficzny, przeglądarka kodu, narzędzia analityczne
Poprawna odpowiedź. Kompilator, edytor kodu i debugger to podstawowe narzędzia, które stanowią fundament każdego środowiska IDE (Integrated Development Environment). Kompilator tłumaczy kod źródłowy na pliki wykonywalne, edytor kodu umożliwia tworzenie i modyfikowanie kodu, a debugger pomaga w analizowaniu i eliminowaniu błędów. Współdziałanie tych narzędzi pozwala programiście na pełny cykl tworzenia aplikacji – od pisania kodu, przez testowanie, aż po finalne wdrożenie. Dzięki integracji tych narzędzi w jednym środowisku, praca staje się bardziej efektywna i intuicyjna.
Pytanie 32
Jaki jest podstawowy cel przystosowania aplikacji do publikacji w sklepie mobilnym?
A. Dostosowanie kodu aplikacji w celu zwiększenia jej wydajności
B. Dostosowanie aplikacji do wymogów platformy oraz regulacji sklepuTwoja odpowiedź
C. Zmniejszenie rozmiaru aplikacji poniżej 10 MB
D. Zapewnienie, że aplikacja działa jedynie w trybie offline
Poprawna odpowiedź. Dostosowanie aplikacji do wymagań platformy i przepisów sklepu mobilnego (np. Google Play lub App Store) to kluczowy krok w procesie publikacji aplikacji. Sklepy mobilne wymagają, aby aplikacje spełniały określone standardy dotyczące bezpieczeństwa, dostępności, wydajności oraz zgodności z wytycznymi interfejsu użytkownika. Proces ten obejmuje testowanie aplikacji pod kątem stabilności, optymalizację grafik i ikon, a także dostosowanie opisów i metadanych aplikacji, co zwiększa jej widoczność i atrakcyjność dla użytkowników. Przestrzeganie wytycznych App Store lub Google Play jest niezbędne, aby aplikacja mogła zostać zatwierdzona i udostępniona do pobrania.
Pytanie 33
Co oznacza walidacja kodu programu?
A. Czynnością związaną z tworzeniem dokumentacji kodu
B. Czynnością weryfikującą poprawność i zgodność kodu z założeniamiTwoja odpowiedź
C. Czynnością polegającą na kompilowaniu kodu
D. Czynnością dotyczącą publikacji aplikacji w sklepie
Poprawna odpowiedź. Walidacja kodu programu to proces sprawdzania jego poprawności i zgodności z założeniami projektowymi oraz standardami programistycznymi. Celem walidacji jest wykrycie błędów logicznych, składniowych i zgodności kodu z wymaganiami aplikacji. Walidacja może obejmować analizę statyczną kodu (bez jego wykonywania) oraz testy jednostkowe i integracyjne, które sprawdzają funkcjonalność aplikacji. Dzięki walidacji programiści mogą uniknąć błędów na późniejszych etapach rozwoju projektu, co znacząco zwiększa niezawodność i stabilność aplikacji. Proces ten jest nieodzowny w metodykach Agile i Continuous Integration, gdzie regularne testowanie kodu stanowi podstawę dostarczania wysokiej jakości oprogramowania.
Pytanie 34
Która technologia służy do tworzenia responsywnych stron internetowych?
A. Media Queries w CSSPoprawna odpowiedź
B. WebSockets
C. REST APITwoja odpowiedź
D. Local Storage
Niepoprawna odpowiedź. WebSockets to technologia, która służy do nawiązywania trwałej komunikacji między klientem a serwerem w czasie rzeczywistym, co jest szczególnie użyteczne w aplikacjach wymagających natychmiastowej wymiany danych, takich jak czaty czy gry online. Choć WebSockets umożliwiają dynamiczną interakcję, nie mają zastosowania w kontekście responsywności stron internetowych, ponieważ nie dotyczą one renderowania i dostosowywania treści do różnych rozmiarów ekranów. REST API to z kolei architektura służąca do tworzenia interfejsów programistycznych, która pozwala aplikacjom na komunikację ze sobą, ale także nie wpływa na responsywność stron. REST API jest używane głównie do wymiany danych między serwerami a aplikacjami, a nie do stylizacji i układu elementów na stronie. Local Storage to technologia pozwalająca na przechowywanie danych w przeglądarkach, co może wspierać funkcjonalność aplikacji webowych, ale również nie ma bezpośredniego związku z tworzeniem responsywnych interfejsów. Typowym błędem w myśleniu o responsywności jest mylenie technologii służących do przetwarzania danych z tymi, które są odpowiedzialne za prezentację i układ na stronie. Kluczem do efektywnego projektowania responsywnego jest zrozumienie potrzeby dostosowywania stylów CSS w zależności od urządzenia, a nie jedynie komunikacja czy przechowywanie informacji.
Pytanie 35
Który z poniższych elementów HTML5 służy do rysowania grafiki?
A. <canvas>Twoja odpowiedź
B. <draw>
C. <graphic>
D. <svg>
Poprawna odpowiedź. Element HTML5 <canvas> jest kluczowym narzędziem do rysowania grafiki w przeglądarkach internetowych. Umożliwia programistom tworzenie dwuwymiarowych i trójwymiarowych grafik w sposób dynamiczny, wykorzystując JavaScript. Przykładem zastosowania <canvas> jest tworzenie gier, animacji, wizualizacji danych oraz interaktywnych wykresów. Dzięki API dla elementu canvas, programiści mają możliwość rysowania kształtów, linii, tekstu oraz obrazów, co otwiera szerokie możliwości w zakresie projektowania interfejsów użytkownika. Warto również zwrócić uwagę na to, że stosowanie <canvas> zgodnie z najlepszymi praktykami programistycznymi, takimi jak efektywne zarządzanie pamięcią i optymalizacja renderowania, pozwala na osiąganie płynnych animacji i wysokiej jakości grafik. Co więcej, <canvas> jest wspierany przez wszystkie nowoczesne przeglądarki, co zapewnia dużą zgodność i dostępność.
Pytanie 36
Co to jest CORS (Cross-Origin Resource Sharing)?
A. Mechanizm bezpieczeństwa, który określa, które domeny mogą uzyskiwać dostęp do zasobów na serwerzeTwoja odpowiedź
B. Protokół komunikacji między różnymi bazami danych
C. Metoda udostępniania API dla aplikacji mobilnych
D. Technika optymalizacji ładowania zasobów statycznych
Poprawna odpowiedź. CORS, czyli Cross-Origin Resource Sharing, to mechanizm bezpieczeństwa stosowany w aplikacjach internetowych, który reguluje, które zewnętrzne domeny mają prawo uzyskiwać dostęp do zasobów na serwerze. Jest to szczególnie istotne w kontekście aplikacji klienckich działających w przeglądarkach, gdzie zapytania do różnych źródeł (tzw. cross-origin requests) mogą prowadzić do problemów z bezpieczeństwem, takich jak ataki typu CSRF (Cross-Site Request Forgery) czy XSS (Cross-Site Scripting). Przykładowo, jeśli aplikacja internetowa hostowana na domenie A próbuje uzyskać dane z API na domenie B, serwer na domenie B może poprzez nagłówki CORS określić, czy i jakie żądania od domeny A będą honorowane. Przy odpowiedniej konfiguracji, serwer może zezwolić na dostęp tylko dla zaufanych źródeł, co zapobiega nieautoryzowanym operacjom. W praktyce, stosowanie CORS przyczynia się do stworzenia bezpieczniejszych aplikacji webowych, zgodnych z aktualnymi standardami bezpieczeństwa w sieci, takimi jak W3C i OWASP.
Pytanie 37
Co to jest Redux?
A. Biblioteka do zarządzania stanem aplikacji w JavaScriptTwoja odpowiedź
B. Framework do tworzenia aplikacji mobilnych
C. Narzędzie do optymalizacji wydajności aplikacji React
D. System kontroli wersji dla projektów JavaScript
Poprawna odpowiedź. Redux to biblioteka służąca do zarządzania stanem aplikacji w JavaScript, a szczególnie popularna w kontekście aplikacji opartych na bibliotece React. Umożliwia centralizację stanu, co sprawia, że zarządzanie nim staje się bardziej przewidywalne i łatwiejsze w utrzymaniu. W koncepcji Redux stan aplikacji jest przechowywany w jednym, niezmiennym obiekcie, co pozwala na ścisłe kontrolowanie jego zmian poprzez wysyłanie akcji. Użytkownicy mogą dzięki temu łatwo śledzić, co się dzieje w aplikacji. Przykładem zastosowania może być aplikacja do zarządzania zadaniami, w której użytkownik może dodawać, edytować lub usuwać zadania. Dzięki Redux, wszystkie zmiany w stanie są rejestrowane, a ich historia może być używana do debugowania czy implementacji funkcji cofania zmian. Dobrą praktyką w pracy z Redux jest stosowanie middleware, takiego jak redux-thunk, co pozwala na obsługę asynchronicznych akcji, a także wykorzystanie narzędzi jak Redux DevTools, które wspierają developerów w monitorowaniu stanu aplikacji.
Pytanie 38
Co zostanie wyświetlone po wykonaniu poniższego kodu?
Poprawna odpowiedź. Wynik działania podanego kodu to 'Hello, John!'. Dzieje się tak, ponieważ tworzony jest obiekt 'person' z konstruktora 'Person', który przypisuje wartość 'John' do właściwości 'name'. Metoda 'sayHello' zdefiniowana w prototypie klasy 'Person' wykorzystuje szablon literowy (template literal), aby zwrócić powitanie, wstawiając wartość 'name' obiektu. To podejście jest zgodne z dobrymi praktykami programowania w JavaScript, ponieważ wykorzystuje prototypy do dzielenia się metodami pomiędzy instancjami obiektów. W praktyce, takie rozwiązania pozwalają na oszczędność pamięci i zwiększają wydajność, gdyż wszystkie instancje korzystają z tej samej metody, a nie mają osobnych kopii. Przykładowo, jeśli chcielibyśmy dodać więcej osób, wystarczy utworzyć nowe instancje 'Person' bez konieczności powielania kodu metody 'sayHello'.
Pytanie 39
Jaki protokół komunikacyjny jest używany w aplikacjach IoT (Internet of Things)?
A. MQTTPoprawna odpowiedź
B. HTTPTwoja odpowiedź
C. FTP
D. SMTP
Niepoprawna odpowiedź. HTTP, FTP i SMTP to protokoły, które mają swoje zastosowania, jednak w kontekście IoT nie są optymalnym wyborem. HTTP (Hypertext Transfer Protocol) jest protokołem opartym na połączeniach, który jest szeroko stosowany w aplikacjach webowych do przesyłania dokumentów i zasobów. Jego charakterystyka, związana z dużym narzutem na dane i brakiem mechanizmów publikacji-subskrypcji, sprawia, że nie nadaje się do efektywnej komunikacji między dużą liczbą urządzeń IoT. FTP (File Transfer Protocol) służy głównie do przesyłania plików, co w kontekście IoT jest rzadko potrzebne, a jego złożoność oraz wymóg ciągłego połączenia czynią go nieodpowiednim do komunikacji w czasie rzeczywistym. SMTP (Simple Mail Transfer Protocol), z kolei, to protokół do wysyłania wiadomości e-mail, co również nie jest adekwatne dla urządzeń IoT, które często potrzebują szybkiej i niezawodnej wymiany danych. Typowym błędem myślowym jest założenie, że ponieważ te protokoły są powszechnie używane w innych kontekstach, mogą być równie skuteczne w IoT. W rzeczywistości, specyfika IoT wymaga odmiennych podejść, jak te, jakie oferuje MQTT, które są dostosowane do ograniczeń i wymagań tego dynamicznego środowiska.
Pytanie 40
Co oznacza termin 'polimorfizm' w programowaniu obiektowym?
A. Zdolność do przyjmowania wielu form przez obiektTwoja odpowiedź
B. Dziedziczenie metod z klasy bazowej
C. Ograniczenie do jednej formy dla obiektu
D. Ustanowienie tylko jednego typu dla klasy
Poprawna odpowiedź. Polimorfizm to jedno z fundamentalnych pojęć w programowaniu obiektowym, które pozwala na tworzenie elastycznych i skalowalnych aplikacji. Dzięki polimorfizmowi możemy pisać kod, który operuje na obiektach, nie znając ich dokładnego typu w momencie kompilacji. To bardzo przydatne, gdy mamy do czynienia z hierarchią klas, gdzie różne klasy dziedziczą po jednej bazowej. Praktycznym przykładem może być system, w którym mamy klasę bazową 'Zwierzę' i klasy pochodne, takie jak 'Pies' i 'Kot'. Dzięki polimorfizmowi możemy stworzyć funkcję, która przyjmuje parametr typu 'Zwierzę', a następnie wywołuje metodę, która jest specyficzna dla danej klasy pochodnej. To umożliwia nam pisanie bardziej ogólnego i mniej związanego z konkretnymi typami kodu. Polimorfizm pozwala również na wdrażanie wzorców projektowych, takich jak strategia czy fabryka, które zwiększają modularność i reużywalność kodu. Korzystanie z polimorfizmu jest zgodne z zasadami SOLID, szczególnie zasadą podstawienia Liskov, która mówi, że obiekty klasy bazowej mogą być zastępowane obiektami klasy pochodnej bez wpływu na poprawność działania programu.