Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 00:09
Zakończenie: 29 września 2026 00:15
Egzamin zdany!
Wynik: 22/40 punktów (55,0%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 21% podejść do kwalifikacji INF.04.
Porównanie z 23416 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprawa! Poprzednio 52,5%, teraz 55,0% (+2,5 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Który z wymienionych mechanizmów pozwala na monitorowanie stanu użytkownika w trakcie sesji w aplikacji internetowej?
A. HTTP Headers
B. CSS Selectors
C. HTML Forms
D. Sesje (Sessions)Twoja odpowiedź
Poprawna odpowiedź. Sesje (sessions) to mechanizm wykorzystywany w aplikacjach webowych do śledzenia stanu użytkownika podczas sesji przeglądania. Sesje umożliwiają przechowywanie danych użytkownika na serwerze przez określony czas i identyfikowanie go za pomocą unikalnego identyfikatora (session ID), który jest zwykle przechowywany w ciasteczkach. Mechanizm sesji pozwala na implementację logowania, koszyków zakupowych oraz innych funkcji, które wymagają zachowania stanu między żądaniami HTTP. Sesje są kluczowe dla aplikacji wymagających autoryzacji i autentykacji, ponieważ umożliwiają śledzenie działań użytkownika bez konieczności wielokrotnego logowania. Zastosowanie sesji w aplikacjach zwiększa bezpieczeństwo i poprawia komfort użytkowania, a także umożliwia personalizację treści w czasie rzeczywistym.
Pytanie 2
Jakie jest zadanie interpretera?
A. tłumaczenie kodu na kod maszynowy
B. wykonywanie skryptu krok po krokuTwoja odpowiedź
C. optymalizacja większej części kodu, aby przyspieszyć jego wykonanie
D. analiza składni całego programu przed jego uruchomieniem
Poprawna odpowiedź. Interpreter to takie narzędzie, które wykonuje kod linijka po linijce. Działa to tak, że odczytuje program napisany w języku wysokiego poziomu, weryfikuje co tam w nim siedzi i od razu realizuje polecenia, co sprawia, że można fajnie testować kod. Na przykład w Pythonie można łatwo sprawdzić różne fragmenty kodu, co jest mega pomocne przy pisaniu i poprawianiu oprogramowania. Wiesz, od kompilatora różni się tym, że kompilator przetwarza cały kod od razu, tworząc kod maszynowy, który później działa na komputerze. Dzięki temu interpreter jest bardziej elastyczny, można szybko przetestować nowe pomysły, ale z drugiej strony, czasami nie działa tak efektywnie jak skompilowane programy, bo każda linia kodu jest analizowana na bieżąco. Więc w przypadku dużych i wymagających aplikacji lepiej sprawdzają się kompilatory, ale interpreter to skarb, zwłaszcza w nauce i prototypowaniu.
Pytanie 3
Jakie z wymienionych czynności może zagrażać cyfrowej tożsamości?
A. Cykliczna zmiana haseł do kont
B. Aktywacja uwierzytelniania dwuskładnikowego
C. Tworzenie unikalnych oraz mocnych haseł
D. Klikanie w podejrzane linki w wiadomościach e-mailTwoja odpowiedź
Poprawna odpowiedź. Klikanie w podejrzane linki w wiadomościach e-mail to jedno z najczęstszych źródeł infekcji i naruszenia cyfrowej tożsamości. Cyberprzestępcy często wykorzystują phishing, czyli technikę polegającą na wysyłaniu fałszywych wiadomości, które wyglądają na autentyczne. Kliknięcie w link może prowadzić do zainstalowania złośliwego oprogramowania lub przekierowania na stronę wyłudzającą dane logowania. Aby uniknąć tego zagrożenia, zaleca się sprawdzanie adresu nadawcy, unikanie otwierania załączników z nieznanych źródeł i korzystanie z filtrów antyphishingowych.
Pytanie 4
W programowaniu obiektowym odpowiednikami zmiennych oraz funkcji w programowaniu strukturalnym są
A. pola i metodyTwoja odpowiedź
B. metody statyczne i abstrakcyjne
C. pola i kwalifikatory dostępu
D. hermetyzacja oraz dziedziczenie
Poprawna odpowiedź. Pola i metody to absolutna podstawa, jeśli chodzi o programowanie obiektowe. Właśnie one są najbliższym odpowiednikiem zmiennych i funkcji z podejścia strukturalnego. Moim zdaniem, gdy uczysz się OOP, warto od razu wyłapać tę analogię – pola (czyli inaczej: atrybuty, właściwości, fields) przechowują stan obiektu, a metody (czyli funkcje w klasie) definiują, co obiekt potrafi zrobić. Przykład z życia: klasa Samochód ma pole kolor, które opisuje jego cechę oraz metodę jedź(), która realizuje jakąś akcję. W praktyce programiści bardzo często modelują swoje klasy tak, aby pola były prywatne (zgodnie z zasadą hermetyzacji), a dostęp do nich zapewniały metody publiczne – tzw. gettery i settery. Standardy branżowe, np. JavaBeans w Javie czy konwencje C#, też polegają na tym, że pola odzwierciedlają dane, a metody operacje na tych danych. Z mojego doświadczenia wynika, że rozumienie tej relacji ułatwia zarówno pisanie czytelnego kodu, jak i jego dalsze rozwijanie. To właśnie dzięki rozdzieleniu na pola i metody klasy mogą odwzorowywać obiekty z realnego świata i ich zachowania, co jest głównym celem programowania obiektowego.
Pytanie 5
Jaki framework umożliwia tworzenie interaktywnych interfejsów użytkownika w języku TypeScript?
A. ASP.NET Core
B. jQuery
C. Django
D. AngularTwoja odpowiedź
Poprawna odpowiedź. Angular to popularny framework oparty na TypeScript, który umożliwia tworzenie dynamicznych i rozbudowanych interfejsów użytkownika. Jest rozwijany przez Google i używany do budowy aplikacji typu Single Page Applications (SPA), które cechują się płynnością działania i interaktywnością. Angular oferuje bogaty ekosystem narzędzi wspierających programistów, takich jak Angular CLI, który pozwala na szybkie generowanie komponentów, serwisów i modułów. Wsparcie dla TypeScript oznacza, że Angular pozwala na wykorzystywanie typów, interfejsów oraz zaawansowanych narzędzi do refaktoryzacji kodu, co przekłada się na większą czytelność i bezpieczeństwo aplikacji. Dzięki modularnej architekturze Angular wspiera tworzenie aplikacji, które są łatwe w utrzymaniu i skalowaniu. Jego dwukierunkowe wiązanie danych (two-way data binding) oraz możliwość dynamicznej aktualizacji widoków czynią go jednym z liderów na rynku frameworków frontendowych.
Pytanie 6
Zmienna o typie logicznym może mieć następujące wartości:
A. 0 oraz każda liczba całkowita
B. trzy dowolne liczby naturalne
C. true, falseTwoja odpowiedź
D. 1, -1
Poprawna odpowiedź. Typ logiczny (boolean) może przyjąć jedynie dwie wartości: true (prawda) i false (fałsz). Jest to fundamentalna zasada w programowaniu, ponieważ zmienne logiczne są podstawą operacji warunkowych, pętli oraz sterowania przepływem programu. W językach takich jak C++, Java, Python i wielu innych, wartości logiczne pozwalają na budowanie złożonych struktur decyzyjnych. Dzięki nim programista może precyzyjnie kontrolować, które fragmenty kodu zostaną wykonane, co jest kluczowe w implementacji algorytmów oraz walidacji danych.
Pytanie 7
Który z poniższych przykładów stanowi aplikację mobilną wykorzystującą bazę danych?
A. Aplikacja wyświetlająca lokalny czas
B. Aplikacja kalkulator
C. Aplikacja do robienia zdjęć
D. Aplikacja gromadząca listę kontaktów użytkownikaTwoja odpowiedź
Poprawna odpowiedź. Aplikacja przechowująca listę kontaktów użytkownika korzysta z bazy danych do przechowywania, odczytywania i zarządzania danymi. Tego typu aplikacje mobilne muszą efektywnie zarządzać dużą ilością danych i zapewniać ich szybki dostęp. Bazy danych, takie jak SQLite czy Firebase, są szeroko stosowane w aplikacjach mobilnych, umożliwiając przechowywanie kontaktów, wiadomości, notatek i innych informacji użytkownika. Dzięki bazom danych możliwe jest także synchronizowanie danych pomiędzy urządzeniami i przechowywanie ich w chmurze.
Pytanie 8
Jakie są kluczowe różnice pomiędzy strukturą (struct) a unią (union) w języku C?
A. Struktura wymaga więcej miejsca w pamięci niż unia
B. Unia umożliwia dynamiczne przypisywanie typów danych, struktura natomiast nie
C. Unia nie jest obsługiwana przez kompilatory współczesnych języków
D. Struktura przechowuje wiele wartości równocześnie, unia tylko jednąTwoja odpowiedź
Poprawna odpowiedź. Główna różnica między strukturą ('struct') a unią ('union') w języku C polega na sposobie przechowywania danych. Struktura przechowuje wszystkie pola jednocześnie, przydzielając każdemu z nich osobne miejsce w pamięci, natomiast unia używa wspólnej przestrzeni pamięci dla wszystkich swoich pól – w danym momencie można przechowywać tylko jedną wartość. Unia jest bardziej efektywna pod względem pamięci, ale mniej wszechstronna, ponieważ zmiana wartości jednego pola nadpisuje pozostałe. Struktury są powszechnie wykorzystywane w aplikacjach, gdzie konieczne jest przechowywanie wielu niezależnych danych, podczas gdy unie są używane do oszczędzania pamięci.
Pytanie 9
Jak zrealizować definiowanie własnego wyjątku w języku C++?
A. Wykorzystać blok try z pustym blokiem catch
B. Utworzyć klasę, która dziedziczy po std::exceptionTwoja odpowiedź
C. Skorzystać z domyślnej metody obsługi błędów
D. Automatycznie wywołać funkcję throw
Poprawna odpowiedź. Aby zdefiniować własny wyjątek w języku C++, należy stworzyć klasę dziedziczącą po standardowej klasie 'std::exception' lub jednej z jej pochodnych. Klasa ta może zawierać własne metody i pola, dostosowując obsługę błędów do specyficznych potrzeb aplikacji. Dziedziczenie z 'std::exception' umożliwia korzystanie z funkcji takich jak 'what()', która zwraca opis błędu. Dzięki temu programista może precyzyjnie określić typ i przyczynę wyjątku, co prowadzi do bardziej czytelnego i łatwiejszego w utrzymaniu kodu. Tworzenie własnych wyjątków jest szczególnie przydatne w dużych projektach, gdzie występuje potrzeba kategoryzacji i obsługi różnych typów błędów w zależności od ich źródła.
Pytanie 10
Jaki będzie wynik działania poniższego kodu JavaScript?
letx=5;lety='10';console.log(x+y);
A. 510Twoja odpowiedź
B. error
C. undefined
D. 15
Poprawna odpowiedź. Wynik działania podanego kodu to 510, co może być zaskakujące dla osób nieznających typów danych w JavaScript. W tym przypadku zmienna x jest liczbą całkowitą (5), a zmienna y jest łańcuchem tekstowym ('10'). Kiedy używamy operatora + w JavaScript, następuje tzw. "przesunięcie typów". Gdy jeden z operandów jest łańcuchem, to JavaScript konwertuje pozostałe typy na łańcuch, a następnie wykonuje konkatenację. W efekcie 5 konwertowane jest na '5', a wynik końcowy to '5' + '10', co daje '510'. To zachowanie jest zgodne z regułami języka JavaScript i jego dynamicznym typowaniem. Warto zwrócić uwagę, że taka konwersja może prowadzić do niezamierzonych wyników, dlatego ważne jest, aby zrozumieć, kiedy i jak działają operatory w JavaScript. Dla większej jasności, w sytuacjach, gdy chcemy dodać dwie liczby, lepiej jest upewnić się, że obie zmienne mają ten sam typ danych, np. przez użycie funkcji parseInt() lub parseFloat().
Pytanie 11
Jaką wartość przyjmie etykieta label po wykonaniu poniższego kodu, gdy zostanie on uruchomiony po naciśnięciu przycisku w aplikacji?
C. suma liczb parzystych z przedziału od 0 do 100Twoja odpowiedź
D. suma liczb z przedziału od 0 do 100
Poprawna odpowiedź. Kod, który został podany w pytaniu, wykorzystuje pętlę for do obliczenia sumy wszystkich liczb parzystych z przedziału od 0 do 100 włącznie. Zmienna tmp pełni tutaj rolę akumulatora, który z każdą iteracją powiększa swoją wartość o kolejną liczbę parzystą. Startujemy od zera, a dzięki i+=2 pętla przechodzi tylko przez liczby parzyste (0, 2, 4, ..., 100). To bardzo typowy sposób, żeby wyliczyć sumę konkretnego zbioru liczb – w tym przypadku parzystych z określonego zakresu. Moim zdaniem warto zauważyć, że takie podejście świetnie sprawdza się w prostych kalkulatorach, prostych analizach danych czy nawet w grach, gdzie czasem trzeba sumować tylko wybrane wartości. W praktyce, szczególnie w większych projektach, lepiej opakować takie operacje w osobne metody lub korzystać np. z funkcji agregujących LINQ w C#. Ale zasada jest ta sama – najpierw określamy, co konkretnie chcemy sumować (tutaj: liczby parzyste), a potem realizujemy to w pętli. Ten fragment kodu jest też niezłym przykładem, jak optymalnie można przechodzić przez dane, jeśli nie musimy analizować wszystkich możliwych wartości (tutaj: wystarczy co drugi krok). Takie sumowanie przydaje się w pracy z raportami, zestawieniami i w miejscach, gdzie liczy się wydajność przetwarzania danych.
Pytanie 12
Jaką funkcję spełniają atrybuty klasy w programowaniu obiektowym?
A. Zapisują wartości lokalne w funkcjach
B. Zawierają informacje opisujące stan obiektuPoprawna odpowiedź
C. Umożliwiają przeprowadzanie operacji na obiektachTwoja odpowiedź
D. Określają globalne stałe programu
Niepoprawna odpowiedź. Zmienne lokalne w metodach przechowują wartości tymczasowe i są usuwane po zakończeniu wykonywania metody, co odróżnia je od pól klasy, które istnieją tak długo, jak istnieje obiekt. Stałe globalne programu są dostępne z każdego miejsca w kodzie, ale nie są związane z konkretną instancją obiektu – ich wartość nie zmienia się dla różnych obiektów. Operacje wykonywane na obiektach są definiowane przez metody klasy, a nie przez pola – pola jedynie przechowują dane, natomiast metody określają zachowanie obiektów i umożliwiają interakcję z nimi.
Pytanie 13
Jakie są kluczowe korzyści z wykorzystania frameworków podczas programowania aplikacji desktopowych?
A. Redukują zapotrzebowanie na pamięć operacyjną aplikacji
B. Skracają czas tworzenia aplikacji dzięki gotowym komponentom i narzędziomTwoja odpowiedź
C. Ułatwiają kontrolę nad wersjami systemu operacyjnego
D. Gwarantują dostęp do niskopoziomowego kodu systemowego
Poprawna odpowiedź. Jedną z głównych zalet stosowania frameworków w programowaniu aplikacji desktopowych jest znaczne skrócenie czasu tworzenia oprogramowania dzięki gotowym komponentom i narzędziom. Frameworki dostarczają struktury, która standaryzuje rozwój aplikacji i minimalizuje konieczność pisania kodu od podstaw. Frameworki takie jak WPF, Qt czy Electron umożliwiają szybkie tworzenie interfejsów użytkownika, obsługę zdarzeń oraz integrację z bazami danych i API. Ponadto frameworki wspierają modularność i umożliwiają łatwe zarządzanie dużymi projektami, co przekłada się na lepszą organizację kodu i wyższą jakość oprogramowania.
Pytanie 14
Metoda przeszukiwania w uporządkowanych tablicach, która polega na podzieleniu tablicy na kilka części i wykonywaniu wyszukiwania liniowego tylko w tej części, gdzie może znajdować się poszukiwany element, w języku angielskim jest określana jako
A. Exponential search
B. Ternary search
C. Jump searchTwoja odpowiedź
D. Binary search
Poprawna odpowiedź. Jump search to faktycznie ta metoda, która polega na przeszukiwaniu uporządkowanej tablicy przez podział jej na bloki o określonej długości (zazwyczaj o rozmiarze pierwiastka kwadratowego z n, gdzie n to liczba elementów w tablicy). Najpierw skaczemy po tych blokach, żeby szybko ograniczyć obszar poszukiwań, a potem wykonujemy liniowe przeszukiwanie już tylko w wybranym przedziale. To sprawia, że jump search jest czymś pomiędzy wyszukiwaniem liniowym a binarnym – daje przyzwoity kompromis między prostotą a wydajnością, szczególnie gdy dostęp do pamięci jest kosztowny albo tablica jest zbyt duża, by od razu dzielić ją na pół jak w binary search. W praktyce jump search czasem się wykorzystuje tam, gdzie dane są przechowywane na przykład na dyskach magnetycznych czy SSD, a koszt losowego odczytu jest znacznie wyższy od odczytu sekwencyjnego. To jest też niezła opcja, gdy masz narzucone ograniczenia na algorytmy lub nie możesz sobie pozwolić na pełne binarne wyszukiwanie z różnych powodów technicznych. Warto też zauważyć, że jump search dobrze ilustruje ogólną ideę ograniczania przestrzeni poszukiwań bez konieczności przechodzenia przez wszystkie elementy – czyli bardzo praktyczne podejście, które daje się rozwinąć w innych algorytmach. Szczerze? Moim zdaniem, każdy, kto myśli o optymalizacji prostych operacji na dużych zbiorach danych, powinien przynajmniej raz przetestować jump search na własnych danych – efekty bywają zaskakująco dobre, zwłaszcza przy większych strukturach.
Pytanie 15
W jaki sposób można załadować tylko komponent z biblioteki React?
A. import React.Component from 'react'
B. import [ Component ] from 'react'
C. import { Component } from 'react'Poprawna odpowiedź
D. import Component from 'react'Twoja odpowiedź
Niepoprawna odpowiedź. Wielu osobom, zwłaszcza na początku przygody z Reactem, potrafią się pomylić sposoby importowania poszczególnych fragmentów tej biblioteki. Przykładowo, użycie import React.Component from 'react' jest składniowo niepoprawne w ES6 – nie istnieje możliwość importowania właściwości w ten sposób. To raczej coś, co można by zobaczyć w starszych rozwiązaniach lub błędnych tutorialach. Kolejna propozycja, czyli import [ Component ] from 'react', wygląda jakby ktoś próbował połączyć składnię tablicową z importem nazwanym, co zupełnie nie ma sensu w kontekście ECMAScript Modules. W rzeczywistości, w nawiasach kwadratowych importu się nie zapisuje – do importów nazwanych używamy nawiasów klamrowych, co jest jasno określone w dokumentacji. Z kolei import Component from 'react' to import domyślny, a 'react' nie eksportuje domyślnie samego Component – eksportuje natomiast cały obiekt React jako default. To jest bardzo częsty błąd: niektórzy myślą, że każdy element biblioteki można zaimportować domyślnie, ale akurat Component jest eksportem nazwanym. Moim zdaniem źródłem tych nieporozumień są niedokładne przykłady w sieci albo powierzchowna znajomość standardów ES6. Warto pamiętać, że składnia importów jest ściśle określona i każde odstępstwo kończy się błędem kompilacji albo nieprzewidywalnym działaniem aplikacji. Dobra praktyka to zawsze sprawdzać dokumentację konkretnej biblioteki, bo różne moduły mogą mieć różne rodzaje eksportów i nie każdy sposób importu będzie pasował do wszystkiego. W przypadku Reacta, jeśli zależy Ci tylko na Component, zawsze trzeba używać importu nazwanego w klamrach, bo taki jest oficjalny eksport tego kawałka z biblioteki.
Pytanie 16
Jakie narzędzie można wykorzystać do tworzenia aplikacji mobilnych typu cross-platform w C#?
A. środowisko Android StudioTwoja odpowiedź
B. platformę React Native
C. środowisko XCode
D. platformę XamarinPoprawna odpowiedź
Niepoprawna odpowiedź. XCode to zintegrowane środowisko programistyczne stworzone przez Apple, które służy głównie do tworzenia aplikacji na platformy iOS oraz macOS. Jego użycie ogranicza się do systemów operacyjnych Apple, co wyklucza możliwość tworzenia aplikacji cross-platform. W kontekście programowania w C#, XCode nie oferuje wsparcia ani funkcji, które umożliwiałyby rozwój aplikacji mobilnych na różne platformy. React Native jest frameworkiem stworzonym przez Facebook, który umożliwia tworzenie aplikacji mobilnych w JavaScript, a nie w C#. Choć React Native wspiera wiele platform, to jednak nie jest to technologia zgodna z C#, co czyni ją nieodpowiednią dla deweloperów preferujących ten język. Android Studio to z kolei oficjalne IDE dla systemu Android, oparte na Javie oraz Kotlinie, co również eliminuje możliwość wykorzystania C#. Tak więc, ani XCode, ani React Native, ani Android Studio nie są odpowiednie do tworzenia aplikacji mobilnych w języku C#, co czyni je niepoprawnymi odpowiedziami w kontekście tego pytania.
Pytanie 17
Jakie jest oznaczenie normy międzynarodowej?
A. ISOPoprawna odpowiedź
B. EN
C. CETwoja odpowiedź
D. PN
Niepoprawna odpowiedź. PN (Polska Norma) to krajowy odpowiednik norm, który dotyczy produktów i usług w Polsce – nie jest to oznaczenie międzynarodowe. EN (European Norm) to europejskie standardy, które są stosowane na poziomie Unii Europejskiej i nie mają statusu globalnego. Oznaczenie CE (Conformité Européenne) wskazuje, że produkt spełnia wymagania dyrektyw unijnych dotyczących bezpieczeństwa, zdrowia i ochrony środowiska, jednak nie jest to norma międzynarodowa, lecz certyfikat obowiązujący na terenie UE.
Pytanie 18
Użycie modyfikatora abstract w definicji metody w klasie wskazuje, że
A. trzeba zaimplementować tę metodę w tej klasieTwoja odpowiedź
B. klasa ta stanowi podstawę dla innych klasPoprawna odpowiedź
C. klasy pochodne nie mogą implementować tej metody
D. dziedziczenie po tej klasie jest niedozwolone
Niepoprawna odpowiedź. Niektóre z odpowiedzi mogą wydawać się na pierwszy rzut oka logiczne, ale wynikają raczej z nieprecyzyjnego rozumienia mechanizmów programowania obiektowego. Zacznijmy od tego, że użycie modyfikatora abstract w samej metodzie nigdy nie oznacza konieczności natychmiastowej implementacji tej metody w tej samej klasie – wręcz przeciwnie, to sygnał, że metoda nie ma jeszcze swojego kodu i zostanie dopiero zaimplementowana w klasie pochodnej. To właśnie klasy dziedziczące mają obowiązek dostarczyć konkretną wersję tej funkcji. Kolejna kwestia to dziedziczenie – modyfikator abstract w żadnym wypadku nie zabrania dziedziczenia po tej klasie, raczej wręcz przeciwnie, bo cała idea polega na tym, żeby posłużyć się taką klasą jako bazą do tworzenia wyspecjalizowanych klas pochodnych. Częstym błędem jest też zakładanie, że klasy pochodne nie mogą implementować tych metod – to zupełnie odwrotnie, bo właśnie po to te metody są abstrakcyjne, żeby wymusić ich nadpisanie. Zdarza się, że początkujący mylą pojęcia abstract i sealed/final (klasa zamknięta na dziedziczenie), co prowadzi do błędnych wniosków. Generalnie warto pamiętać, że modyfikator abstract jest narzędziem do budowania elastycznych, rozszerzalnych struktur kodu, gdzie część funkcjonalności jest celowo zostawiona do uzupełnienia przez potomków. To nie jest mechanizm ograniczający, tylko wręcz przeciwnie – otwierający drogę do projektowania uniwersalnych, przyszłościowych rozwiązań. Takie podejście jest szeroko stosowane w branży, np. w frameworkach czy bibliotekach, gdzie wielu developerów rozbudowuje istniejącą logikę o własną specyfikę działania.
Pytanie 19
Jaką funkcję pełnią mechanizmy ciasteczek w aplikacjach internetowych?
A. Do przechowywania informacji w bazie danych
B. Do generowania dynamicznych interfejsów dla użytkowników
C. Do zapisywania danych użytkownika w przeglądarceTwoja odpowiedź
D. Do zapisywania danych użytkownika na serwerze
Poprawna odpowiedź. Mechanizm ciasteczek (cookies) w aplikacjach webowych służy do przechowywania danych użytkownika bezpośrednio w przeglądarce. Ciasteczka mogą przechowywać różnego rodzaju informacje, takie jak preferencje językowe, identyfikatory sesji czy dane logowania, co pozwala na personalizację doświadczenia użytkownika oraz śledzenie jego aktywności na stronie. Dzięki ciasteczkom aplikacje webowe mogą zapamiętać użytkownika i dostosować treści do jego potrzeb przy kolejnych wizytach. Cookies są nieodłącznym elementem zarządzania stanem w aplikacjach stateless, takich jak te oparte na protokole HTTP. Mogą być one również wykorzystywane w systemach reklamowych i analitycznych do monitorowania zachowań użytkowników. Prawidłowe zarządzanie ciasteczkami i stosowanie odpowiednich polityk prywatności są kluczowe dla zgodności z przepisami RODO oraz regulacjami dotyczącymi ochrony danych osobowych.
Pytanie 20
Jaki będzie wynik działania poniższego kodu w języku C#?
intx=5;inty=10;Console.WriteLine($"Suma {x} i {y} wynosi {x + y}");
A. Suma 5 i 10 wynosi 15Poprawna odpowiedź
B. Error: niewłaściwa składniaTwoja odpowiedź
C. Suma x i y wynosi 15
D. Suma 5 i 10 wynosi x + y
Niepoprawna odpowiedź. W przypadku błędnych odpowiedzi warto zwrócić uwagę na kilka aspektów. Odpowiedź wskazująca, że wynik to 'Suma x i y wynosi 15', jest niepoprawna, ponieważ w sformatowanym ciągu tekstowym program odnosi się do wartości zmiennych, a nie do ich nazw. Wartości zmiennych są wykorzystywane w obliczeniach, a nie ich identyfikatory. Kiedy mówimy o 'Suma 5 i 10 wynosi x + y', także popełniamy błąd, ponieważ sformatowany ciąg nie wyświetli dosłownie 'x + y', lecz ich wartości. To wskazuje na nieporozumienie dotyczące interpolacji ciągów, która w C# dokonuje zamiany zmiennych na ich wartości i umieszcza je w tekście. Ostatnia propozycja, mówiąca o błędzie składni, jest także mylna, gdyż podany kod jest poprawny syntaktycznie i semantycznie. Typowe błędy często prowadzą do takich nieprawidłowych wniosków obejmują brak zrozumienia, jak działa interpolacja oraz nieznajomość podstawowych zasad programowania C#. Kluczowe jest zrozumienie, że używanie zmiennych w wyrażeniach tekstowych jest techniką, która pozwala programistom na bardziej dynamiczne i elastyczne tworzenie komunikatów, co jest nieocenione w kontekście tworzenia aplikacji interaktywnych.
Pytanie 21
W metodach klasy GoldCustomer dostępne są tylko pola
Niepoprawna odpowiedź. W tym pytaniu nietrudno pomylić się, bo różnice między public, protected i private czasem wydają się nieintuicyjne – szczególnie jak ktoś dopiero zaczyna przygodę z C#. Najczęstszy błąd to założenie, że wszystkie pola klasy bazowej są automatycznie dostępne w klasach pochodnych. Tak jednak nie jest. Publiczne pole (takie jak Name) będzie widoczne absolutnie wszędzie – także w GoldCustomer. Protected (Id) daje dostęp tylko klasie bazowej i pochodnym, co jest bardzo wygodne przy dziedziczeniu, bo pozwala korzystać z ważnych danych bez upubliczniania ich na zewnątrz. Natomiast private (Age) jest dostępne wyłącznie w ramach klasy, w której zostało zadeklarowane – żadna klasa pochodna nie może go bezpośrednio użyć. W praktyce programistycznej wiele osób myli protected z public, przez co zdarza się, że do protected próbują się dostać spoza klasy dziedziczącej – i wtedy pojawia się frustracja. Z kolei pole GoldPoints zostało zadeklarowane bezpośrednio w GoldCustomer i dzięki temu jest dostępne tylko w tej klasie – nawet inne klasy dziedziczące po GoldCustomer nie będą miały do niego dostępu. Jeśli chodzi o Age, wielu początkujących (i nie tylko!) zakłada, że dziedziczenie daje pełen dostęp do wszystkiego z klasy bazowej, ale to nieprawda – private jest całkowicie zamknięte. Z technicznego punktu widzenia, zrozumienie tej różnicy pozwala nie tylko lepiej projektować własne klasy, ale i unikać błędów, które potem trudno wyłapać, zwłaszcza w większych projektach. Tak więc, praktyka pokazuje, że najbezpieczniejsze jest świadome korzystanie z modyfikatorów dostępu – pomaga to zachować porządek i minimalizuje ryzyko przypadkowych błędów podczas rozwoju aplikacji.
Pytanie 22
Który wzorzec projektowy jest najlepszy do zarządzania tworzeniem obiektów?
A. Adapter
B. Observer
C. DecoratorTwoja odpowiedź
D. Factory MethodPoprawna odpowiedź
Niepoprawna odpowiedź. Wybór wzorców projektowych w kontekście zarządzania tworzeniem obiektów jest kluczowy, jednak nie wszystkie wzorce są odpowiednie dla tego celu. Wzorzec Observer, na przykład, jest zaprojektowany do zarządzania powiązaniami między obiektami, umożliwiając jednemu obiektowi informowanie innych o zmianach stanu. Jego zastosowanie w kontekście tworzenia obiektów jest nieadekwatne, ponieważ nie rozwiązuje problemu instancjonowania obiektów, a jedynie komunikacji między nimi. Kolejnym błędnym podejściem jest wzorzec Decorator, który ma na celu dynamiczne dodawanie funkcjonalności do obiektów. Choć może być użyty w kontekście modyfikacji obiektów, nie zajmuje się tworzeniem ich instancji, co czyni go nieodpowiednim w tej sytuacji. Wzorzec Adapter może być mylony z Factory Method, ponieważ również pozwala na współpracę różnych interfejsów, jednak jego główną rolą jest umożliwienie komunikacji pomiędzy niekompatybilnymi interfejsami. Adapter koncentruje się na przekształcaniu interfejsów, a nie na tworzeniu obiektów. W rezultacie, wybór niewłaściwego wzorca może prowadzić do nieefektywnego projektowania, co utrudnia rozwój i utrzymanie aplikacji. Warto zatem dokładnie rozróżniać role poszczególnych wzorców i stosować je w odpowiednich kontekstach, aby unikać typowych pułapek myślowych związanych z ich zastosowaniem.
Pytanie 23
Metodyka zwinna (ang. agile) opiera się na
A. przygotowaniu testów dla całego projektu, a następnie wprowadzaniu kolejnych jego fragmentów
B. zaplanowaniu całej aplikacji na początku projektu i jej tworzeniu na przemian z testowaniem
C. dekompozycji przedsięwzięcia na elementy, które są niezależnie projektowane, wytwarzane i testowane w krótkich iteracjachTwoja odpowiedź
D. podzieleniu projektu na kolejne etapy: planowanie, programowanie, testowanie, z ciągłym oszacowaniem ryzyka projektu
Poprawna odpowiedź. Metodyka zwinna (agile) polega na podziale projektu na mniejsze części (iteracje), które są projektowane, implementowane i testowane w krótkich cyklach. Takie podejście pozwala na szybkie reagowanie na zmieniające się wymagania klientów i wprowadzanie poprawek na bieżąco. Agile promuje bliską współpracę z klientem, co minimalizuje ryzyko nieporozumień i zwiększa szanse na stworzenie produktu spełniającego jego oczekiwania. Zamiast czekać na zakończenie całego projektu, poszczególne części aplikacji są dostarczane i testowane stopniowo, co skraca czas wdrożenia i umożliwia szybkie wykrycie błędów. Popularnymi frameworkami bazującymi na Agile są Scrum i Kanban, które organizują pracę zespołu w iteracyjne sprinty lub zadania wizualizowane na tablicach Kanban.
Pytanie 24
Podaj wspólną cechę wszystkich kontrolek umieszczonych w ramce
D. są w nich ustawione te same wartości domyślneTwoja odpowiedź
Niepoprawna odpowiedź. Odpowiadając na to pytanie, łatwo można się pomylić, bo często myślimy o widoczności lub kolorze tekstu jako o najbardziej oczywistych cechach wspólnych kontrolek. Jednak w tej sytuacji każda z niepoprawnych odpowiedzi opiera się na pewnym błędnym założeniu dotyczącym właściwości kontrolek w XAML lub podobnych technologiach UI. Jeśli chodzi o widoczność – tylko część kontrolek ma isVisible ustawione na „True” (np. Slider ma isVisible="False"), więc nie można powiedzieć, że wszystkie są widoczne. To dość częsta pułapka, bo można założyć, że skoro domyślnie elementy są wyświetlane, to tu też tak jest, a jednak nie tym razem. Jeśli patrzymy na kolor czcionki, to Label i Entry mają TextColor="Tan", ale Stepper i Slider już nie posiadają takiej właściwości w ogóle, więc nie da się tego uogólnić na wszystkie kontrolki. To pokazuje, że nie każdy element interfejsu ma wszystkie właściwości tekstowe, co jest zresztą typowe dla różnych typów kontrolek – Stepper czy Slider bardziej operują na wartościach liczbowych, a nie na tekście wyświetlanym użytkownikowi. No i wartości domyślne – tutaj ktoś mógłby się zasugerować, że magiczna „5” pojawia się w kilku miejscach (np. Label Text, Stepper Value, Slider Value, Entry Placeholder), ale te właściwości wcale nie są tożsame pod względem funkcji. Placeholder w Entry to sugestia dla użytkownika, Value w Stepper to aktualna liczba, a Text w Label to wyświetlana wartość – czyli zupełnie inne znaczenie i zastosowanie. To dość częsty błąd, że patrzymy tylko na liczbę, nie analizując, co ona właściwie oznacza w kontekście danej kontrolki. Ogólnie rzecz biorąc, w pracy z interfejsem zawsze warto czytać dokumentację i sprawdzać, które właściwości są dostępne dla jakiego typu kontrolki, i co dokładnie oznaczają w praktyce. Takie pomyłki zdarzają się nawet osobom doświadczonym, szczególnie jeśli pracują z wieloma technologiami naraz, bo każdy framework trochę inaczej podchodzi do nazw i znaczenia właściwości. Moim zdaniem, warto też pamiętać, że konsekwencja w stylowaniu mają ogromny wpływ na spójność i komfort użytkowania aplikacji.
Pytanie 25
Jakie jest zastosowanie iteratora w zbiorach?
A. Do zmiany rodzaju zbioru w trakcie działania aplikacjiTwoja odpowiedź
B. Do iterowania po elementach zbioruPoprawna odpowiedź
C. Do generowania kopii zbiorów
D. Do usuwania elementów ze zbioru
Niepoprawna odpowiedź. Tworzenie kopii kolekcji to operacja duplikacji danych i nie wymaga iteratorów. Usuwanie elementów z kolekcji może być realizowane przy pomocy iteratora, ale nie jest to jego główna funkcja. Zmiana typu kolekcji to operacja, która często wymaga konwersji lub transformacji, ale iterator nie służy do zmiany typów danych, a jedynie do iteracji po elementach kolekcji.
Pytanie 26
Które z poniższych pojęć nie jest związane z React.js?
A. Hooks
B. DirectivesPoprawna odpowiedź
C. JSXTwoja odpowiedź
D. Virtual DOM
Niepoprawna odpowiedź. Wybór pojęcia, które nie jest związane z React.js, jest bardziej złożony, niż może się wydawać na pierwszy rzut oka. JSX jest jedną z podstawowych cech React, umożliwiającą pisanie komponentów w sposób zbliżony do HTML-a. Pozwala to na łatwiejsze tworzenie interfejsów użytkownika poprzez integrację składni HTML z możliwościami JavaScriptu. Virtual DOM to kolejne kluczowe pojęcie w React, które przyczynia się do wydajności aplikacji. Dzięki Virtual DOM, React minimalizuje operacje na prawdziwym DOM-ie, co prowadzi do szybszego renderowania i lepszej reaktywności aplikacji. Z kolei Hooks są nowoczesnym podejściem do zarządzania stanem i efektami w komponentach funkcyjnych, co umożliwia tworzenie bardziej złożonych interakcji bez konieczności korzystania z komponentów klasowych. Każda z tych koncepcji jest ściśle związana z architekturą React i stanowi fundament w jego ekosystemie. Typowym błędem myślowym, który może prowadzić do niepoprawnych wniosków, jest mylenie frameworków oraz ich specyficznych terminologii. Często deweloperzy mogą założyć, że terminologia z jednego frameworka jest uniwersalna dla wszystkich, co jest błędnym podejściem. Zrozumienie specyfiki React i jego ekosystemu jest kluczowe dla efektywnego wykorzystania tego narzędzia w praktyce.
Pytanie 27
Aplikacje webowe stworzone z użyciem frameworka Angular lub biblioteki React, działające na standardowych portach, można uruchomić na lokalnym serwerze, wpisując w przeglądarkę
A. localhost:3000 (React) lub localhost:4200 (Angular)Twoja odpowiedź
B. localhost:5001 (React) lub localhost:8080 (Angular)
C. localhost:8000 (React) lub localhost:49887 (Angular)
D. localhost:8080 (React) lub localhost:8000 (Angular)
Poprawna odpowiedź. React domyślnie startuje na porcie 3000, a Angular na 4200 – to są takie standardy, które praktycznie wszyscy w branży znają i stosują. Kiedy zaczynasz nowy projekt w React, korzystając na przykład z create-react-app, serwer deweloperski po prostu nasłuchuje na http://localhost:3000. Analogicznie, jak generujesz projekt w Angular CLI i odpalasz ng serve, wtedy aplikacja wystartuje na http://localhost:4200. To są domyślne porty – nie musisz nic specjalnie ustawiać, wystarczy wpisać te adresy w przeglądarce. Z mojego doświadczenia, dobrze jest zapamiętać te ustawienia, bo praktycznie na każdym warsztacie czy bootcampie te adresy padają od ręki. Jeśli chodzi o praktykę, czasami port jest już zajęty i wtedy narzędzie zaproponuje inny, ale te wartości startowe to taka baza. Warto pamiętać, że zmiana portu wynika zazwyczaj z konfliktu, a nie z jakiejś specjalnej potrzeby. Dodatkowo, rozpoznanie tych portów pozwala szybciej debugować problemy z uruchomieniem aplikacji – jak coś nie wstaje na tych adresach, to od razu wiadomo, gdzie szukać. Ogólnie rzecz biorąc, korzystanie z tych domyślnych portów przyspiesza współpracę w zespole, bo każdy wie, gdzie szukać aplikacji, więc nie trzeba się rozpisywać w README, na jakim porcie coś działa. Moim zdaniem, to jeden z tych drobnych szczegółów, które składają się na dobre nawyki programistyczne.
Pytanie 28
Jakie zdarzenie jest wywoływane, gdy kliknięta zostaje myszą nieaktywna kontrolka lub okno?
A. validating
B. keyup
C. blur
D. focusTwoja odpowiedź
Poprawna odpowiedź. W momencie, kiedy klikamy na nieaktywną kontrolkę lub okno w aplikacji, wywoływane jest zdarzenie focus. To jest dość kluczowe w interakcji człowieka z interfejsem graficznym — focus decyduje, która kontrolka staje się „aktywnym” odbiorcą zdarzeń klawiatury oraz innych operacji wejścia. W praktyce, np. w aplikacjach webowych czy desktopowych, jeśli użytkownik kliknie w pole tekstowe, to właśnie focus oznacza, że to pole jest gotowe do przyjęcia tekstu. Co ciekawe, focus można też ustawiać programowo, np. za pomocą metody focus() w JavaScript, co jest często używane do poprawiania użyteczności formularzy (od razu ustawiamy kursor w pierwszym polu). Z mojego doświadczenia, dobrze jest zawsze przemyśleć, które elementy mogą i powinny otrzymywać focus, bo to wpływa na dostępność (ang. accessibility) aplikacji – osoby korzystające z klawiatury czy czytników ekranu są bardzo zależne od logiki focusowania. Branżowe standardy, szczególnie WCAG, mocno podkreślają, żeby nie blokować możliwości uzyskania focusa przez kluczowe kontrolki. Zdarzenie focus ma też kilka niuansów – na przykład nie bąbelkuje w DOM, co czasem zaskakuje początkujących. Moim zdaniem, zrozumienie roli focus w każdej aplikacji interaktywnej to taki absolutny fundament, bez którego łatwo pogubić się w późniejszych, bardziej złożonych interakcjach.
Pytanie 29
Jaką wartość zwróci poniższa funkcja dla argumentu n = 5?
Niepoprawna odpowiedź. Podczas analizy funkcji silnia(n) dla wartości n = 5, wiele osób może błędnie wnioskować o jej wyniku. Często zdarza się, że ludzie próbując obliczyć silnię, mylą się w kolejności mnożenia lub nie uwzględniają właściwego przeliczenia. Na przykład, odpowiedź 24 mogłaby wynikać z obliczenia silnia(4) zamiast silnia(5). To błędne myślenie opiera się na zrozumieniu, że silnia n to suma wszystkich poprzednich silni, co jest nieprawdziwe. Silnia to operacja mnożenia, nie sumowania, co jest kluczowe do poprawnego zrozumienia tej funkcji. Ponadto, odpowiedzi 60 i 5 również wynikają z niedokładności w obliczeniach lub mylnego zrozumienia, co oznacza silnia. Na przykład, 60 mogłoby powstać z błędnego pomnożenia, jak 5 * 12, a 5 wydaje się być po prostu nieprawidłowym zrozumieniem, że silnia(n) zwraca n samo w sobie. Dlatego ważne jest, aby pamiętać, że silnia to produkt wszystkich liczb naturalnych od 1 do n, a nie pojedyncza liczba. Dobrze jest również przetestować naszą wiedzę poprzez praktyczne przykłady i weryfikację z działającym kodem, co pozwala na uniknięcie tych typowych pułapek myślowych i lepsze zrozumienie zasadności obliczeń matematycznych w programowaniu.
Pytanie 30
Jakie są kluczowe etapy realizacji projektu programistycznego?
A. Analiza, implementacja, testowanie, aktualizacja
B. Planowanie, projektowanie, debugowanie, konserwacjaTwoja odpowiedź
C. Projektowanie, testowanie, aktualizacja, implementacja
D. Planowanie, analiza, implementacja, wdrożeniePoprawna odpowiedź
Niepoprawna odpowiedź. Wiele osób myśli, że wystarczy skupić się na kodzie czy testach i sukces przyjdzie sam, ale w praktyce kluczowe jest zachowanie właściwej sekwencji i kompletności działań. Często spotykam się z przekonaniem, że projektowanie albo debugowanie są najważniejszymi krokami, jednak bez wcześniejszego gruntownego planowania i analizy trudno mówić o efektywności czy przewidywalności rezultatów. Przykładowo, debugowanie to bardzo istotny element pracy programisty, ale samo w sobie nie stanowi etapu realizacji projektu – jest raczej czynnością wykonywaną w toku implementacji i testowania. Z kolei aktualizacja i konserwacja, choć ważne, zaliczają się już do utrzymania systemu po wdrożeniu, a nie do pierwotnego cyklu tworzenia oprogramowania. W niektórych odpowiedziach zabrakło chociażby analizy wymagań, co jest podstawowym etapem według standardów takich jak ISO/IEC/IEEE 12207 czy wytycznych PMBOK. Pominięcie wdrożenia lub zamiana jego kolejności z innym etapem, jak projektowanie albo testowanie, prowadzi do problemów z odpowiedzialnością za przekazanie produktu końcowego. Również połączenie implementacji z aktualizacją to pomieszanie faz projektowych z fazami utrzymania. Takie uproszczenia wynikają często z mylenia faz samego developmentu z późniejszymi procesami eksploatacji. W praktyce, żeby uniknąć błędów takich jak niedopracowana architektura czy chaos przy wdrożeniu, trzeba konsekwentnie stosować pełną sekwencję: planowanie, analiza, implementacja, a na końcu wdrożenie. To jest podejście zgodne i z klasycznym waterfall, i z nowszymi praktykami agile, gdzie nawet jeśli fazy się zazębiają, wciąż mają swoje miejsce. Z mojego doświadczenia, skracanie lub pomijanie tych etapów to prosta droga do kosztownych poprawek i niezadowolenia klienta, dlatego warto je znać i stosować świadomie.
Pytanie 31
Jakie jest przeznaczenie polecenia "git merge"?
A. Do usuwania zmian w repozytorium
B. Do łączenia zmian z różnych gałęziPoprawna odpowiedź
C. Do pobierania aktualizacji zdalnego repozytoriumTwoja odpowiedź
D. Do zakładania nowego repozytorium
Niepoprawna odpowiedź. Wiele osób na początku nauki Gita myli różne polecenia, bo brzmią podobnie albo wydają się robić coś bliskiego. "git merge" często bywa mylone z poleceniami typu "git pull" czy "git clone", które mają jednak zupełnie inne zastosowanie. Pobieranie aktualizacji ze zdalnego repozytorium to domena "git pull" – to polecenie automatycznie pobiera nowe commity i próbuje je od razu zintegrować z lokalną gałęzią, często zresztą używając w tle właśnie "merge". Ale samo "git merge" nie ściąga niczego z internetu, ono tylko łączy zmiany już obecne w lokalnych gałęziach. Z kolei tworzenie nowego repozytorium to zadanie "git init"; to zupełnie inny etap pracy, bo dotyczy rozpoczęcia projektu, a nie zarządzania jego rozwojem. Usuwanie zmian w repozytorium – tutaj najczęściej używa się "git reset" czy "git revert", zależnie od tego czy chcemy cofnąć zmiany lokalnie czy naprawić coś w historii. Merge natomiast nie służy do usuwania ani cofania, tylko do scalania zmian – to kluczowe, żeby nie pomylić tych narzędzi, bo można przez to nieźle namieszać w kodzie. Moim zdaniem, głównym błędem jest założenie, że wszystkie polecenia związane z aktualizacją kodu robią to samo, podczas gdy w Git każde z nich ma bardzo konkretne zadanie i konsekwencje. Dla dobrych praktyk w zespole ważne jest, żeby rozumieć subtelne różnice między tymi operacjami. Praktyka pokazuje, że błędne użycie "merge" – jak również zamiana go z "pull" albo "reset" – potrafi prowadzić do chaosu w historii projektu. Warto zatem dobrze opanować przeznaczenie każdego z poleceń przed rozpoczęciem pracy nad większym projektem.
Pytanie 32
Które z wymienionych atrybutów klasy mogą być dostępne wyłącznie w obrębie tej klasy oraz jej klas potomnych?
A. Public
B. Private
C. ProtectedTwoja odpowiedź
D. Static
Poprawna odpowiedź. Modyfikator `protected` pozwala na dostęp do pól i metod klasy w ramach tej samej klasy oraz w klasach dziedziczących. Jest to pośredni poziom dostępu między `private` i `public`. Pola `protected` są ukryte przed innymi klasami spoza hierarchii dziedziczenia, ale pozostają dostępne w klasach pochodnych. Dzięki temu dziedziczenie staje się bardziej elastyczne, umożliwiając klasom potomnym korzystanie z chronionych elementów klasy bazowej. Przykład w C++: `class Pojazd { protected: int predkosc; }`. Klasy dziedziczące po `Pojazd` mogą używać `predkosc`, ale obiekty nie mają bezpośredniego dostępu do tego pola.
Poprawna odpowiedź. Kod przedstawiony w pytaniu to klasyczny przykład wykorzystania komponentu Switch w Androidzie. Switch, jak sama nazwa wskazuje, służy do przełączania między dwoma stanami — najczęściej włącz/wyłącz, aktywne/nieaktywne. Z punktu widzenia interfejsów mobilnych, przełącznik bardzo często znajduje zastosowanie w ustawieniach aplikacji, np. do szybkiego włączania trybu ciemnego, aktywacji powiadomień czy zezwalania na lokalizację. Ten konkretny xml zawiera podstawowe atrybuty, jak android:id, layout_width, layout_height oraz background, czyli kolor tła, co od razu sugeruje, że nie jest to np. dropdown czy suwak. Co ciekawe, Switch różni się od CheckBoxa tym, że wizualnie lepiej komunikuje zmianę trybu (przesuwający się znacznik), co moim zdaniem zwiększa użyteczność, szczególnie jeśli użytkownik ma szybko zrozumieć, co ustawia. Standardy Material Design wręcz zalecają stosowanie Switch do kontrolowania pojedynczych ustawień, bo jest to bardziej czytelne niż inne widgety. Warto pamiętać, że Switch ma różne warianty i można go rozbudować o obsługę zdarzeń onCheckedChangeListener w kodzie Java albo Kotlin, przez co staje się bardzo elastyczny. Odpowiedź przełącznik jest więc zgodna ze wszystkimi cechami tej kontrolki i jej zastosowaniami w praktyce.
Pytanie 34
Jaką komendę w języku C++ używa się do wielokrotnego uruchamiania tego samego bloku kodu?
A.
while
Twoja odpowiedź
B.
break
C.
switch
D.
if
Poprawna odpowiedź. Instrukcja `while` w języku C++ i innych językach programowania pozwala na wielokrotne wykonanie tego samego fragmentu kodu, dopóki warunek logiczny jest spełniony. Przykład: `while (x < 10) { x++; }` będzie zwiększać zmienną `x` o 1, dopóki jej wartość nie osiągnie 10. Pętle `while` są przydatne, gdy liczba iteracji nie jest z góry znana i zależy od spełnienia określonego warunku w trakcie wykonywania programu.
Pytanie 35
Które narzędzie najlepiej nadaje się do analizy wydajności aplikacji JavaScript?
A. Webpack
B. npm
C. Chrome DevTools PerformanceTwoja odpowiedź
D. Babel
Poprawna odpowiedź. Chrome DevTools Performance to potężne narzędzie, które jest integralną częścią przeglądarki Google Chrome i służy do analizy wydajności aplikacji JavaScript. Dzięki niemu możemy monitorować czas ładowania, identyfikować wąskie gardła w kodzie oraz analizować, jak różne elementy strony wpływają na ogólną wydajność. Narzędzie to umożliwia nagrywanie sesji wydajności, co pozwala na szczegółowe zbadanie, jak różne operacje wpływają na czas odpowiedzi aplikacji. Przykładowo, możemy użyć DevTools do analizy, które skrypty zajmują najwięcej czasu lub które zadania blokują wątek główny, co jest kluczowe dla zapewnienia płynności interfejsu użytkownika. Dodatkowo, narzędzie to oferuje różne metryki, takie jak FPS (frames per second), co jest niezbędne do oceny płynności animacji. Warto również podkreślić, że DevTools jest zgodne z najlepszymi praktykami branżowymi, a jego umiejętne wykorzystanie może znacząco poprawić jakość aplikacji.
Pytanie 36
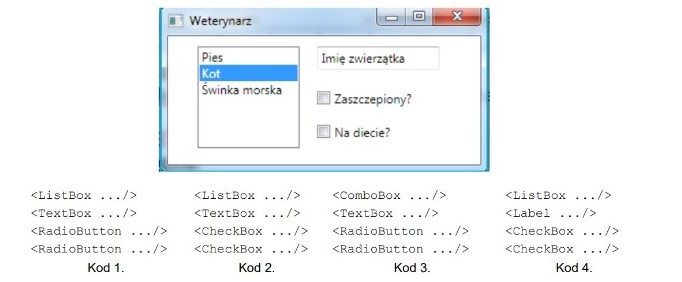
Wskaż uproszczoną wersję kodu XAML dla elementów w pokazanym oknie dialogowym?
Kod 2Poprawna odpowiedź
Kod 4
Kod 3Twoja odpowiedź
Kod 1
Niepoprawna odpowiedź. Różnorodność kontrolek XAML często prowadzi do nieporozumień, szczególnie gdy trzeba wybrać właściwe narzędzie do konkretnego zadania. W powyższym oknie dialogowym decyzja, czy użyć ListBox, ComboBox, RadioButton czy CheckBox, opiera się na tym, jak użytkownik powinien wchodzić w interakcję z danym elementem. Częstym błędem jest użycie ComboBoxa zamiast ListBoxa, podczas gdy użytkownik musi mieć wgląd w pełną listę dostępnych opcji i możliwość wyboru tylko jednej – ComboBox ukrywa opcje i wymaga dodatkowego kliknięcia, co w tym przypadku byłoby mniej wygodne. Równie częsty jest wybór RadioButtonów dla pytań o wiele odpowiedzi typu „tak/nie”, jednak RadioButtony służą do wyboru tylko jednej opcji z grupy wzajemnie wykluczających się odpowiedzi, a nie do niezależnych odpowiedzi, które można zaznaczyć równocześnie – tutaj lepiej sprawdzą się CheckBoxy, które umożliwiają wielokrotny wybór. Użycie Label zamiast TextBoxa do wprowadzania imienia zwierzaka mija się z celem, bo Label wyłącznie wyświetla tekst i nie pozwala użytkownikowi na edycję danych. W praktyce spotykam się z tym, że osoby uczące się XAML próbują uprościć kod przez zamianę kontrolek na inne podobne, jednak prowadzi to do złych doświadczeń użytkownika i łamie podstawowe zasady projektowania interfejsów, gdzie czytelność i intuicyjność są kluczowe. Trzeba zawsze brać pod uwagę funkcjonalność danej kontrolki i dopasowywać ją do oczekiwanego zachowania aplikacji, zgodnie z dobrymi praktykami i wytycznymi dla interfejsów użytkownika.
Pytanie 37
Co to jest lazy loading w kontekście ładowania obrazów na stronie?
A. Format przechowywania obrazów w pamięci podręcznej przeglądarki
B. Technika ładowania obrazów dopiero w momencie, gdy stają się widoczne dla użytkownikaTwoja odpowiedź
C. Metoda kompresji obrazów przed wysłaniem na serwer
D. Protokół transferu obrazów między serwerem a przeglądarką
Poprawna odpowiedź. Lazy loading to technika, która pozwala na ładowanie obrazów oraz innych zasobów dopiero w momencie, gdy stają się one widoczne dla użytkownika na ekranie. Dzięki temu oszczędzamy zasoby sieciowe i poprawiamy czas ładowania strony, co jest szczególnie istotne w kontekście optymalizacji SEO oraz doświadczenia użytkownika. Na przykład, w przypadku długiej strony internetowej z wieloma obrazami, lazy loading sprawia, że podczas przewijania strony obrazy nie są ładowane od razu, co zmniejsza obciążenie serwera i przyspiesza wczytywanie widocznych części strony. W praktyce można zastosować atrybuty takie jak "loading='lazy'" w znaczniku <img>, co jest zgodne z nowoczesnymi standardami HTML. Ponadto, wiele bibliotek i frameworków, jak np. Intersection Observer API, umożliwia zaawansowaną implementację lazy loadingu, co sprawia, że jest to obecnie powszechnie stosowana praktyka.
Pytanie 38
W przedstawionym filmie ukazano kreator interfejsu użytkownika, dla którego automatycznie powstaje
A. obsługa wciśniętego przyciskuTwoja odpowiedź
B. obsługa przycisku ekranu dotykowego
C. kod XMLPoprawna odpowiedź
D. kod Java
Niepoprawna odpowiedź. Często można się pomylić, sądząc, że narzędzia do projektowania interfejsów użytkownika generują od razu kod w takich językach jak Java czy implementują obsługę konkretnych zdarzeń, np. wciśnięcia przycisku. Z mojego doświadczenia wynika, że to jeden z najczęstszych błędów myślowych na początku nauki programowania. W praktyce, narzędzia typu drag&drop koncentrują się na warstwie prezentacyjnej – opisują, jak mają wyglądać poszczególne elementy, ale nie zajmują się logiką działania. Kod Java albo inny kod źródłowy odpowiedzialny za obsługę zdarzeń czy funkcjonalności aplikacji musi być dopisany ręcznie przez programistę. Automatyczne generowanie kodu logicznego przez edytory graficzne jest raczej niezalecane, bo prowadzi do trudnego w utrzymaniu kodu i sprawia, że aplikacja traci na przejrzystości. Jeśli chodzi o obsługę wciśnięcia przycisku czy przycisku ekranu dotykowego, to są to akcje, które definiuje się później w kodzie źródłowym – na przykład poprzez implementację listenerów w kodzie Java w Androidzie albo przez bindingi w innych frameworkach. Te narzędzia mają za zadanie generować opis struktury interfejsu, a nie jego zachowanie. Często spotyka się też przekonanie, że to właśnie kod Java stanowi podstawę aplikacji – oczywiście to prawda, ale nie w kontekście automatycznego generowania przez narzędzia graficzne; one skupiają się na XML, który jest dużo bardziej uniwersalny do takich celów. Moim zdaniem najlepszą praktyką jest wyraźne oddzielenie warstwy prezentacji (np. XML) od logiki biznesowej i ręcznego kodowania zdarzeń, bo to pozwala na wygodne rozwijanie i utrzymywanie aplikacji, szczególnie w większych zespołach.
Pytanie 39
Którą konwencję nazewnictwa najczęściej stosuje się w JavaScript?
A. PascalCase
B. kebab-case
C. snake_caseTwoja odpowiedź
D. camelCasePoprawna odpowiedź
Niepoprawna odpowiedź. Wybór konwencji nazewnictwa ma kluczowe znaczenie dla czytelności i utrzymania kodu, a błędne podejście do tego tematu może prowadzić do poważnych nieporozumień. Snake_case, który polega na oddzielaniu słów za pomocą podkreślników (np. `user_name`), jest popularny w językach takich jak Python, ale nie jest powszechnie akceptowany w JavaScript. Użycie tej konwencji w JavaScript może skutkować niekonsekwencjami w kodzie, zwłaszcza gdy współpracuje się z innymi programistami, którzy mogą oczekiwać stosowania camelCase jako standardu. Z kolei PascalCase, w którym każde słowo zaczyna się dużą literą, jest zazwyczaj używany w kontekście nazywania klas (np. `UserProfile`). Choć jest to przydatne, nie jest to konwencja dla zmiennych czy funkcji, co może prowadzić do niejasności, jeśli nie stosuje się jej zgodnie z ogólnie przyjętymi zasadami. Kebab-case, będący inną formą separacji słów przy pomocy myślników (np. `user-name`), jest najczęściej stosowany w nazwach URL i nie jest zgodny z konwencjami JavaScript. Dlatego stosowanie tych nieodpowiednich konwencji może prowadzić do trudności w utrzymaniu kodu, a także może wpływać na błędy w współpracy z innymi narzędziami i bibliotekami, które oczekują zgodności z camelCase.
Pytanie 40
Który z wymienionych etapów w procesie przetwarzania instrukcji przez procesor odbywa się jako pierwszy?
A. Realizacja instrukcji (Execution)
B. Rozkodowanie rozkazu (Decode)
C. Zapis wyników do pamięci (Write Back)Twoja odpowiedź
D. Pobranie rozkazu z pamięci (Fetch)Poprawna odpowiedź
Niepoprawna odpowiedź. Dekodowanie rozkazu, czyli Decode, jest drugim krokiem w całym cyklu wykonywania instrukcji. I nie można go zrobić, zanim procesor nie pobierze rozkazu z pamięci. W tej fazie procesor zaczyna analizować, co to jest za instrukcja, żeby wiedzieć, co ma zrobić. To znaczy, że identyfikuje, jakie operacje są potrzebne i co jest w składnikach, jak operandy. Gdyby dekodowanie miało być robione na początku, procesor nie miałby żadnych wskazówek, co ma dekodować, co zupełnie nie ma sensu. A potem jest jeszcze ten etap zapisu wyników do pamięci, czyli Write Back. Też nie może się zdarzyć przed pobraniem rozkazu, bo wymaga wykonania wcześniej instrukcji, wynikających z rozkazu. Ten etap jest ważny, bo tu wyniki operacji muszą być odpowiednio zapisane w pamięci lub rejestrach. W kontekście architektury komputerowej, to wszystko jest naprawdę istotne, bo bez pierwszego kroku, czyli pobrania rozkazu, reszta byłaby bez sensu.