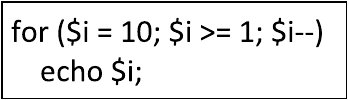Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 20 września 2026 19:04
Zakończenie: 20 września 2026 19:30
Egzamin zdany!
Wynik: 25/40 punktów (62,5%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 48% podejść do kwalifikacji INF.03.
Porównanie z 42305 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
W jakim formacie zostanie wyświetlona data po uruchomieniu poniższego kodu?
<?php
echodate('l, dS F Y');
?>
A. Monday, 10th July 17
B. Monday, 10 July 2017
C. Monday, 10th July 2017Poprawna odpowiedź
D. 10, Monday July 2017Twoja odpowiedź
Niepoprawna odpowiedź. Wybór niepoprawnej odpowiedzi wynika najprawdopodobniej z niezrozumienia, jak funkcja date() w PHP interpretuje jej argumenty. Wszystkie argumenty są literałami formatu, które są zastępowane ich odpowiednikami w oparciu o bieżącą datę i czas. Na przykład, 'l' jest zastępowane pełną nazwą dnia tygodnia, 'd' jest zastępowane dniem miesiąca z zerem wiodącym, 'S' dodaje angielski sufiks liczby porządkowej do dnia miesiąca, 'F' zwraca pełną nazwę miesiąca, a 'Y' zwraca pełny rok. Niezrozumienie lub pomylenie tych literałów formatu może prowadzić do nieprawidłowego formatowania daty. Ważne jest, aby dokładnie zrozumieć, jak każdy z tych literałów jest interpretowany przez funkcję date(), aby uniknąć błędów w wyświetlaniu daty. Pamiętaj, że różne systemy mogą wymagać różnych formatów daty, dlatego zrozumienie, jak manipulować formatem daty w PHP jest kluczowe dla efektywnego programowania.
Pytanie 2
Tabela psy ma pola imie, rasa, telefon_wlasciciela, rok_szczepienia. Która kwerenda zwróci telefony właścicieli psów szczepionych PRZED 2015?
Poprawna odpowiedź. Po SELECT wymienia się kolumny do POBRANIA, a w WHERE warunek wyboru wierszy. Chcemy telefony psów szczepionych przed 2015, więc bierzemy kolumnę telefon_wlasciciela i warunek rok_szczepienia<2015: SELECTtelefon_wlascicielaFROMpsyWHERErok_szczepienia<2015;. Dlatego ta kwerenda jest poprawna.
Pytanie 3
Który modyfikator dostępu daje dostęp do pola w obrębie klasy oraz w klasach dziedziczących (a nie z zewnątrz)?
A. chronionyPoprawna odpowiedź
B. opublikowanyTwoja odpowiedź
C. publiczny
D. prywatny
Niepoprawna odpowiedź. Pozostałe modyfikatory dają inny zakres dostępu lub nie istnieją. Publiczny (public) otwiera pole zewsząd - również dla kodu spoza klasy, więc jest za szeroki w stosunku do pytania. Prywatny (private) działa odwrotnie: zamyka dostęp wyłącznie w jednej klasie, tak że nie sięgną do pola nawet klasy dziedziczące. „Opublikowany” nie jest standardowym kwalifikatorem dostępu. Dostęp w klasie i klasach dziedziczących zapewnia modyfikator chroniony (protected), dlatego to on jest poprawny.
Pytanie 4
Na czym polega parkowanie domeny?
A. na utworzeniu strefy DNS domeny i wskazaniu serwerów nazwTwoja odpowiedź
B. na zmianie właściciela domeny (cesji)
C. na zakupie (rejestracji) nowej domeny
D. na dodaniu rekordu CNAME (aliasu) dla domeny
Poprawna odpowiedź. Parkowanie domeny to skonfigurowanie zarejestrowanej domeny po stronie DNS - utworzenie jej strefy i wskazanie serwerów nazw (nameserwerów) - zwykle bez uruchamiania pełnej, docelowej witryny. Często domena „zaparkowana” kieruje na stronę zastępczą lub jest po prostu przygotowana do późniejszego użycia. Dzięki temu domena działa w systemie DNS, choć nie hostuje jeszcze właściwego serwisu. Dlatego parkowanie polega na utworzeniu strefy DNS i wskazaniu serwerów nazw.
Pytanie 5
voidwypisz(intn) {for (inti = 1; i <= n; i++) {System.out.println("Wykonanie operacji po raz " + i);
}System.out.println("Wykonanie kolejnej operacji!");
}
Złożoność obliczeniowa prezentowanego kodu wynosi:
A. O(n²)Twoja odpowiedź
B. O(n)Poprawna odpowiedź
C. O(1)
D. O(n!)
Niepoprawna odpowiedź. Kod z zadania jest klasycznym przykładem na to, jak wygląda złożoność liniowa i gdzie łatwo się pomylić przy jej ocenie. Wiele osób, widząc pętlę, próbuje od razu dopasować jedną z „groźnie” wyglądających złożoności, jak n² czy n!, bo brzmią bardziej skomplikowanie. Tymczasem analiza powinna być spokojna i oparta na policzeniu, ile razy realnie wykonuje się dana instrukcja.
W zaprezentowanej funkcji mamy jedną pętlę for, która startuje od 1 i kończy na n, więc iteruje dokładnie n razy. W każdej iteracji wykonywane jest jedno wywołanie System.out.println z prostą konkatenacją tekstu i zmiennej i. To oznacza, że liczba tych wywołań rośnie liniowo wraz z n. Po pętli jest jeszcze jedno, pojedyncze wypisanie. Dodanie stałej liczby operacji (tu: +1) nie zmienia charakteru wzrostu – w notacji O() takie stałe są pomijane, bo dla dużych n nie mają znaczenia.
Złożoność O(n²) pojawiłaby się, gdyby wewnątrz tej pętli była kolejna pętla, zależna również od n, np. for (int j = 1; j <= n; j++). Wtedy liczba iteracji wyniosłaby n * n, czyli n². W tym kodzie tego nie ma, więc przypisywanie mu n² jest typowym przeszacowaniem związanym z automatycznym kojarzeniem „pętla = kwadrat”. To błąd myślowy: jedna pętla → O(n), dwie zagnieżdżone → często O(n²), ale trzeba to zawsze policzyć, a nie zgadywać.
Z kolei O(n!) opisuje algorytmy ekstremalnie kosztowne, jak pełne permutowanie elementów (np. brutalne generowanie wszystkich możliwych ustawień). W naszym przykładzie nie ma ani permutacji, ani rekurencji, ani eksplodującej liczby kombinacji. Jedynie proste przejście po kolejnych liczbach od 1 do n, więc factorial tutaj kompletnie nie pasuje.
O(1) oznaczałoby, że czas działania nie zależy w ogóle od n – na przykład pojedyncze wywołanie metody, prosta operacja arytmetyczna, odczyt elementu z tablicy po indeksie. Tutaj jednak im większe n, tym więcej razy wykonuje się pętla i tym dłużej program działa. To już wyklucza złożoność stałą.
Z mojego doświadczenia warto zawsze zadać sobie dwa pytania: ile razy wykona się pętla i czy wewnątrz niej nie ma kolejnych pętli lub wywołań kosztownych algorytmów. Taka spokojna analiza krok po kroku pozwala uniknąć mylenia złożoności liniowej z kwadratową, stałą czy nawet silnią.
Pytanie 6
W jakiej strukturze zapisywane są dane w relacyjnych bazach danych?
A. w kolejkach
B. w tabelachTwoja odpowiedź
C. w wektorach
D. w listach
Poprawna odpowiedź. W relacyjnych bazach danych dane przechowuje się w TABELACH - zbudowanych z wierszy (rekordów) i kolumn (atrybutów), powiązanych ze sobą przez klucze. To fundament modelu relacyjnego i języka SQL. Zapamiętaj: relacyjna baza = dane w powiązanych tabelach.
Pytanie 7
Program FileZilla może być użyty do
A. walidacji strony internetowej
B. zmiany domyślnych ustawień hostingu dla strony internetowejTwoja odpowiedź
C. publikacji strony internetowej na serwerzePoprawna odpowiedź
D. zarządzania bazami danych strony internetowej
Niepoprawna odpowiedź. Wybór odpowiedzi, która nie odnosi się do publikacji strony internetowej na serwerze, jest typowym błędem związanym z myleniem różnych funkcji i zastosowań technologii internetowych. Walidacja strony internetowej, choć ważna, odnosi się do sprawdzania poprawności kodu HTML oraz zgodności z standardami W3C, co nie ma bezpośredniego związku z przesyłaniem plików na serwer. Użytkownicy często zakładają, że weryfikacja poprawności ich kodu jest wystarczająca do publikacji, co jest nieścisłe, ponieważ nawet poprawny kod nie będzie dostępny online bez przesłania na serwer. Zmiana domyślnych ustawień hostingu również nie ma związku z funkcjonalnością FileZilla, ponieważ takie zmiany zazwyczaj dokonuje się w panelu zarządzania hostingiem, a nie przez klienta FTP. Ponadto zarządzanie bazami danych, które jest inną kluczową częścią rozwoju aplikacji webowych, wymaga użycia narzędzi takich jak PHPMyAdmin czy konsola SQL, a nie narzędzi do przesyłania plików. Zrozumienie tych różnic jest niezbędne dla efektywnego korzystania z technologii webowych i unikania typowych pułapek, które mogą prowadzić do błędnych wniosków oraz problemów w procesie publikacji stron internetowych.
Pytanie 8
W języku SQL dodanie nowej kolumny z nazwą miejscowości do istniejącej tabeli pracownicy umożliwia kwerenda
A. ALTER TABLE pracownicy ADD miejscowosc FLOAT(2);
B. ALTER TABLE pracownicy DROP COLUMN miejscowosc;
C. CREATE TABLE pracownicy ADD miejscowosc FLOAT(2);
D. ALTER TABLE pracownicy ADD miejscowosc VARCHAR(100);Twoja odpowiedź
Poprawna odpowiedź. Poprawna odpowiedź używa polecenia ALTER TABLE z klauzulą ADD i odpowiednim typem danych tekstowych: ALTER TABLE pracownicy ADD miejscowosc VARCHAR(100);. W SQL instrukcja ALTER TABLE służy właśnie do modyfikowania istniejącej tabeli: możemy dodawać kolumny, usuwać je, zmieniać typy, klucze itp. Skoro tabela pracownicy już istnieje, nie tworzymy jej od nowa, tylko ją rozszerzamy o nową kolumnę.
Sama składnia jest dość typowa: po nazwie tabeli podajemy słowo kluczowe ADD, potem nazwę nowej kolumny i jej typ danych. Dla nazwy miejscowości naturalny jest typ znakowy, najczęściej VARCHAR z rozsądną długością, np. 50, 80 czy 100 znaków. VARCHAR oznacza, że długość jest zmienna, czyli baza nie marnuje miejsca na puste znaki, gdy ktoś wpisze krótszą nazwę, np. „Łódź” czy „Rzeszów”. Moim zdaniem 100 znaków to bezpieczny, dość często spotykany limit w praktycznych projektach.
W realnych bazach (MySQL, PostgreSQL, SQL Server) bardzo podobnie dodaje się inne kolumny, np. numer telefonu czy kod pocztowy: ALTER TABLE pracownicy ADD telefon VARCHAR(20);. Dobrą praktyką jest też od razu przemyślenie, czy kolumna może być NULL, czy powinna mieć domyślną wartość. Przykładowo można napisać: ALTER TABLE pracownicy ADD miejscowosc VARCHAR(100) NOT NULL DEFAULT 'nieznana'; – to już trochę wyższy poziom projektowania, ale w większych systemach ma duże znaczenie.
Warto zapamiętać ogólny schemat: ALTER TABLE nazwa_tabeli ADD nazwa_kolumny typ;. To jedno z podstawowych poleceń DDL (Data Definition Language) i w administracji bazami danych jest używane bardzo często, gdy trzeba rozbudować istniejący schemat bez kasowania danych.
Pytanie 9
Jak nazywa się technologia, w której komunikacja z serwerem odbywa się bez przeładowania całej strony?
A. PHPTwoja odpowiedź
B. AJAXPoprawna odpowiedź
C. Ruby
D. Django
Niepoprawna odpowiedź. Pozostałe odpowiedzi to nie ta technika. Django to framework webowy w Pythonie, a Ruby to język programowania - służą do budowy aplikacji, a nie są samą metodą asynchronicznej wymiany. PHP działa po stronie serwera i samo z siebie nie aktualizuje strony bez przeładowania. Komunikację z serwerem bez przeładowania realizuje AJAX.
Pytanie 10
Jak w języku strukturalnym przechować dane 50 uczniów (imię, nazwisko, średnia)?
A. struktury 50 elementów o składowych tablicowych
B. klasy 50 elementów typu tablicowego
C. tablicy 50 elementów o składowych łańcuchowych
D. tablicy 50 elementów o składowych strukturalnychTwoja odpowiedź
Poprawna odpowiedź. Dane jednego ucznia (imię, nazwisko, średnia) to różne pola opisujące jeden obiekt - w języku strukturalnym grupuje je STRUKTURA. Aby przechować 50 uczniów, tworzy się tablicę 50 elementów, gdzie każdy element jest taką strukturą. Dlatego potrzebna jest tablica o składowych strukturalnych.
Pytanie 11
Jakie środowisko jest wymagane do uruchomienia systemu CMS Joomla! (domyślna konfiguracja)?
A. C++ i MySQL
B. Python i MySQL
C. Apache, PHP i MySQLTwoja odpowiedź
D. IIS, Perl i MySQL
Poprawna odpowiedź. Joomla! w domyślnej konfiguracji to aplikacja PHP korzystająca z bazy MySQL, uruchamiana na serwerze Apache - czyli klasyczny stos Apache + PHP + MySQL (LAMP/WAMP). Dlatego wymagane jest środowisko Apache, PHP i MySQL.
Pytanie 12
Który z poniższych znaczników jest częścią sekcji <head> dokumentu HTML?
A. <title>Twoja odpowiedź
B. <section>
C. <img>
D. <span>
Poprawna odpowiedź. Znacznik <title> jest fundamentalnym elementem sekcji <head> dokumentu HTML. Jego głównym zadaniem jest określenie tytułu strony, który jest wyświetlany na pasku tytułowym przeglądarki oraz w wynikach wyszukiwania. Dobrze skonstruowany tytuł powinien być zwięzły, ale jednocześnie informacyjny, aby skutecznie przyciągnąć uwagę użytkowników. Zgodnie z wytycznymi W3C, tytuł powinien mieć od 50 do 60 znaków, aby uniknąć obcinania w wynikach wyszukiwania. Przykładem dobrze sformułowanego tytułu może być: „Jak stworzyć responsywną stronę internetową - poradnik krok po kroku”. Ważne jest, aby tytuł był unikalny dla każdej podstrony w witrynie, co nie tylko poprawia SEO, ale również ułatwia użytkownikom nawigację. W kontekście standardów i dobrych praktyk, należy również unikać umieszczania w tytule zbędnych słów kluczowych, co może być uznane za spam przez wyszukiwarki. Dobrze zaprojektowany tytuł jest kluczem do efektywnego pozycjonowania i budowania marki w sieci.
Pytanie 13
Które z wyrażeń logicznych zapisanych w języku C sprawdza, czy zmienna o nazwie zm1 należy do przedziału (6, 203]?
A. (zm1 > 6) && (zm1 <= 203)Twoja odpowiedź
B. (zm1 > 6) && (zm1 != 203)
C. (zm1 > 6) || (zm1 <= 203)
D. (zm1 > 6) || (zm1 != 203)
Poprawna odpowiedź. Wyrażenie (zm1 > 6) && (zm1 <= 203) dokładnie opisuje przedział (6, 203]. Nawias okrągły przy 6 oznacza, że wartość 6 nie należy do przedziału, więc w C trzeba użyć operatora >, a nie >=. Nawias kwadratowy przy 203 oznacza, że 203 jest jeszcze dozwolone, dlatego używamy <=. Operator && oznacza logiczne „i”, czyli oba warunki muszą być spełnione jednocześnie: zmienna ma być większa od 6 oraz nie większa niż 203. Moim zdaniem to jeden z tych zapisów, które warto od razu kojarzyć z kontrolą zakresu danych, np. przy sprawdzaniu wieku, liczby punktów, rozmiaru pliku albo wartości wpisanej w formularzu. W języku C operatory porównania zwracają wartość logiczną w praktyce reprezentowaną jako 0 albo 1, a && dodatkowo działa z tzw. krótkim spięciem, czyli drugi warunek nie musi być sprawdzany, jeśli pierwszy jest fałszywy. Dobrą praktyką jest testowanie wartości granicznych: dla zm1 = 6 wynik ma być fałszem, dla 7 prawdą, dla 203 prawdą, a dla 204 fałszem. Taki sposób myślenia bardzo pomaga przy pisaniu warunków w instrukcjach if.
Pytanie 14
W przedstawionym filmie, aby połączyć tekst i wielokąt w jeden obiekt tak, aby operacja ta była odwracalna zastosowano funkcję
A. części wspólnej.
B. grupowania.Twoja odpowiedź
C. sumy.
D. wykluczenia.
Poprawna odpowiedź. Prawidłowo – w filmie została użyta funkcja grupowania. W grafice wektorowej, np. w programach typu Inkscape, CorelDRAW czy Illustrator, grupowanie służy właśnie do logicznego połączenia kilku obiektów w jeden „zestaw”, ale bez trwałego mieszania ich geometrii. To znaczy: tekst dalej pozostaje tekstem, wielokąt dalej jest wielokątem, tylko są traktowane jak jeden obiekt przy przesuwaniu, skalowaniu czy obracaniu. Dzięki temu operacja jest w pełni odwracalna – w każdej chwili możesz rozgrupować elementy i edytować każdy osobno. Moim zdaniem to jest podstawowa dobra praktyka w pracy z projektami, które mogą wymagać późniejszych poprawek: podpisy, etykiety, logotypy, schematy techniczne. Jeśli połączysz tekst z kształtem za pomocą operacji boolowskich (suma, część wspólna, wykluczenie), to tekst zwykle zamienia się na krzywe, przestaje być edytowalny jako tekst. To bywa potrzebne przy przygotowaniu do druku czy eksportu do formatu, który nie obsługuje fontów, ale nie wtedy, gdy zależy nam na łatwej edycji. Z mojego doświadczenia: przy projektowaniu interfejsów, ikon, prostych banerów na WWW czy grafik do multimediów, najrozsądniej jest najpierw grupować logicznie elementy (np. ikona + podpis), a dopiero na samym końcu, gdy projekt jest ostateczny, ewentualnie zamieniać tekst na krzywe. Grupowanie pozwala też szybko zaznaczać całe moduły projektu, wyrównywać je względem siebie, duplikować całe zestawy (np. kafelki menu, przyciski z opisami) bez ryzyka, że coś się rozjedzie. W grafice komputerowej to taka podstawowa „organizacja pracy” – mniej destrukcyjna niż różne operacje na kształtach i zdecydowanie bardziej elastyczna przy późniejszych zmianach.
Pytanie 15
Którego języka skryptowego użyć do aplikacji WWW zagnieżdżonych w HTML i uruchamianych po stronie SERWERA?
A. PHPTwoja odpowiedź
B. Perl
C. JavaScript
D. C#
Poprawna odpowiedź. PHP to skryptowy język serwerowy, który OSADZA SIĘ wprost w HTML (między <?php...?>) i wykonuje na SERWERZE - do przeglądarki trafia już gotowy HTML będący wynikiem działania kodu. Tak powstają strony dynamiczne: logowanie, sklepy, fora. Zapamiętaj: PHP liczy się na serwerze, a klient widzi tylko efekt.
Pytanie 16
Jaką wartość zwróci algorytm?
Z = 0
N = 1
dopóki Z < 3:
    N = N * 2 + 1
    Z = Z + 1
wypisz N
A. 5
B. 3
C. 7
D. 15Twoja odpowiedź
Poprawna odpowiedź. Algorytm wykonuje pętlę dopóki wartość Z jest mniejsza niż 3. Na początku Z jest równe 0, a N jest równe 1. W każdej iteracji pętli N jest mnożone przez 2, a następnie do wartości N dodawana jest 1. W tym przypadku, po pierwszej iteracji, N = 1 * 2 + 1 = 3 oraz Z = 1. W drugiej iteracji N = 3 * 2 + 1 = 7 oraz Z = 2. W ostatniej iteracji N = 7 * 2 + 1 = 15 oraz Z = 3. Pętla kończy się, gdy Z osiąga wartość równą 3. Zatem ostateczna wartość N, która jest wypisywana, wynosi 15. Taki rodzaj algorytmu jest przykładam pętli iteracyjnej, która jest często stosowana w programowaniu do wykonywania powtarzalnych operacji. Umożliwia to efektywne przetwarzanie danych oraz automatyzację zadań. W praktyce, takie podejście mogą wykorzystywać inżynierowie oprogramowania do obliczeń matematycznych czy przetwarzania dużych zbiorów danych.
Pytanie 17
Jakie będzie rezultatem działania poniższego kodu PHP?
Poprawna odpowiedź. Kod PHP zawiera kilka warunków logicznych w strukturze if-else. Przy początkowych wartościach zmiennych, $a i $c są równe true, natomiast $b i $d są false. Pierwszy warunek if sprawdza czy ($a && $b) || ($c && $d), co tłumaczy się na (true && false) || (true && false), co daje false || false, a w rezultacie false. Zatem warunek się nie spełnia i przechodzimy do kolejnego. W elseif mamy ($a && $b) || ($c || $d), co oznacza (true && false) || (true || false), co daje false || true, czyli true. Ten warunek się spełnia i wyświetla 'warunek2'. Kod przechodzi do następnego elseif tylko wtedy, gdy poprzednie warunki były false, co w tym przypadku nie ma miejsca. W praktyce, analizując kod PHP, ważne jest zrozumienie operatorów logicznych: && oznacza 'i', || oznacza 'lub', a ! oznacza negację. Prawidłowe stosowanie tych operatorów jest kluczowe w programowaniu warunkowym, pozwalając na kontrolę przepływu programu i podejmowanie decyzji w oparciu o złożone logiki. Użycie elseif pozwala na czytelne i klarowne rozgałęzienie kodu, co jest dobrą praktyką w pisaniu złożonych skryptów.
Pytanie 18
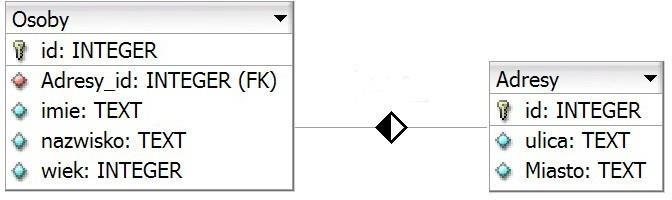
Tabele Osoby i Adresy są połączone relacją jeden do wielu. Które zapytanie SQL należy wykonać, aby korzystając z tej relacji, prawidłowo wyświetlić nazwiska oraz przyporządkowane im miasta?
A. SELECT nazwisko, Miasto FROM Osoby JOIN Adresy ON Osoby.Adresy_id = Adresy.id;Twoja odpowiedź
B. SELECT nazwisko, Miasto FROM Osoby, Adresy WHERE Osoby.id = Adresy.id;
C. SELECT nazwisko, Miasto FROM Osoby, Adresy;
D. SELECT nazwisko, Miasto FROM Osoby.Adresy_id = Adresy.id FROM Osoby, Adresy;
Poprawna odpowiedź. Poprawne zapytanie korzysta z jawnego złączenia tabel: SELECT nazwisko, Miasto FROM Osoby JOIN Adresy ON Osoby.Adresy_id = Adresy.id;. Kluczowe są tu dwie rzeczy: użycie słowa kluczowego JOIN oraz właściwy warunek ON, który łączy klucz obcy z kluczem głównym. W tabeli Osoby kolumna Adresy_id jest kluczem obcym (FK), który wskazuje na kolumnę id w tabeli Adresy. To dokładnie odzwierciedla relację jeden‑do‑wielu narysowaną na diagramie. Dzięki temu baza danych wie, które miasto przypisać do którego nazwiska. Takie podejście jest zgodne ze standardem SQL i dobrą praktyką w relacyjnych bazach danych. Jawne JOIN-y są czytelne, łatwe do modyfikacji (np. dodanie kolejnych tabel lub warunków filtrowania) i dobrze współpracują z optymalizatorem zapytań. W praktycznych projektach, np. w aplikacjach webowych, właśnie tak buduje się zapytania: łączymy tabelę użytkowników lub klientów z tabelą adresów, zamówień, faktur, logów itp. zawsze po kluczach głównych i obcych, a nie po przypadkowo dobranych kolumnach. Moim zdaniem warto od razu wyrabiać sobie nawyk pisania nazw tabel przy kolumnach, czyli Osoby.nazwisko, Adresy.Miasto – zmniejsza to ryzyko konfliktu nazw i poprawia czytelność kodu SQL. Gdyby w przyszłości w którejś tabeli pojawiła się druga kolumna o nazwie Miasto, zapytanie nadal byłoby jednoznaczne. W większych systemach, gdzie dochodzą dodatkowe warunki (WHERE, ORDER BY, GROUP BY), taka struktura zapytania z JOIN ON jest po prostu dużo łatwiejsza w utrzymaniu i debugowaniu. Warto też pamiętać, że relacja jeden‑do‑wielu oznacza, że jedna osoba może mieć wiele adresów albo jeden adres może być przypisany do wielu osób – dokładne powiązanie zależy od modelu, ale technika złączenia po kluczu obcym pozostaje taka sama.
Pytanie 19
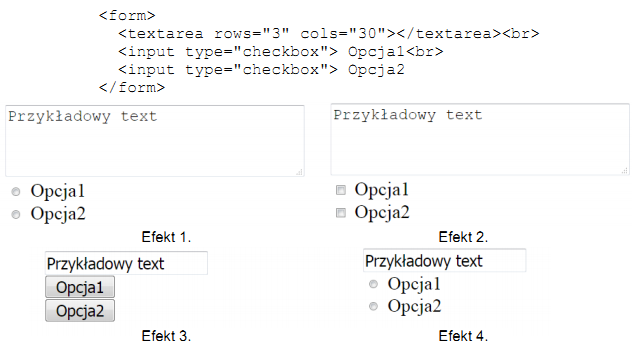
W kodzie HTML znajdziemy formularz. Jaki rezultat zostanie pokazany przez przeglądarkę, jeśli użytkownik wprowadził do pierwszego pola wartość "Przykładowy text"?
A. Efekt 2Twoja odpowiedź
B. Efekt 1
C. Efekt 4
D. Efekt 3
Poprawna odpowiedź. Efekt 2 jest prawidłowy, ponieważ odpowiada dokładnemu odwzorowaniu HTML. Kod zawiera element <textarea> oraz dwa pola typu checkbox. Przeglądarka wyświetla pole tekstowe o określonym rozmiarze, gdzie użytkownik może wpisać tekst. Checkboxy pozwalają na wybór opcji, niezależnych od siebie, co odróżnia je od radiobuttonów. Przykładowy text wpisany w pole <textarea> zostanie wyświetlony w miejscu tego pola, co jest dobrze widoczne na obrazie odpowiadającym efektowi 2. Warto pamiętać, że <textarea> stosuje się do dłuższych form tekstu, co jest standardem w projektowaniu formularzy. Użycie checkboxów jest zgodne z dobrymi praktykami, gdy użytkownik może zaznaczyć dowolną liczbę opcji. Jest to ważne, aby dostarczyć użytkownikowi intuicyjny interfejs do wprowadzania i wyboru danych. W HTML ważne jest, aby kod był semantyczny i zgodny z oczekiwaniami użytkowników, co ten przykład dobrze ilustruje. Formularze powinny być zawsze testowane pod kątem użyteczności i poprawności w różnych przeglądarkach.
Pytanie 20
Jaką maksymalną ilość znaczników <td> można zastosować w tabeli składającej się z trzech kolumn i trzech wierszy, w której nie ma złączeń komórek ani wiersza nagłówkowego?
A. 3
B. 9Twoja odpowiedź
C. 6
D. 12
Poprawna odpowiedź. Tabela o trzech kolumnach i trzech wierszach składa się z 9 komórek, co oznacza, że maksymalna liczba znaczników <td>, które można zastosować w takiej tabeli, wynosi 9. Każda komórka tabeli jest reprezentowana przez znacznik <td>, dlatego musisz pomnożyć liczbę kolumn (3) przez liczbę wierszy (3), co daje 3 * 3 = 9. To podejście odzwierciedla najlepsze praktyki w tworzeniu tabel HTML, które zakładają, że każda komórka powinna być jednoznacznie określona. Warto pamiętać, że unikanie złączeń komórek upraszcza strukturę tabeli, co ułatwia przetwarzanie przez różne systemy oraz poprawia dostępność strony. Przykład zastosowania to np. wyświetlanie danych o produktach w sklepie internetowym, gdzie każda informacja o produkcie, taka jak nazwa, cena i opis, znajduje się w osobnej komórce. Zgodnie z wytycznymi W3C, stosowanie semantycznych znaczników poprawia SEO i ułatwia nawigację.
Pytanie 21
Obiektem w bazie danych, który wykorzystywany jest do podsumowywania, prezentacji oraz drukowania danych, jest
A. zapytanie
B. formularz
C. raportPoprawna odpowiedź
D. zestawienieTwoja odpowiedź
Niepoprawna odpowiedź. Zapytanie, formularz i zestawienie, mimo że są istotnymi elementami baz danych, nie pełnią roli raportów. Zapytanie to instrukcja używana do pobierania danych z bazy danych, zazwyczaj w formie języka SQL. Jego celem jest wyciągniecie specyficznych informacji według określonych kryteriów, ale nie oferuje ono gotowego podsumowania czy wniosków. Można zrozumieć, dlaczego niektórzy mogą mylić zapytanie z raportem, gdyż oba elementy są używane do pracy z danymi, jednak zapytanie działa na poziomie surowych danych, a nie na poziomie ich prezentacji. Formularz natomiast jest interaktywnym narzędziem, które pozwala na wprowadzanie danych do bazy, a jego celem jest ułatwienie użytkownikowi wprowadzania i edytowania informacji. Formularze są kluczowe podczas zbierania danych, ale nie są projektowane w celu analizy ani podsumowywania danych. Zestawienie z kolei odnosi się do grupowania informacji w celu ich analizy, ale jak sama nazwa wskazuje, nie jest to forma raportu, który powinien zawierać gotowe podsumowania i wnioski. W celu uniknięcia nieporozumień warto zwrócić uwagę na różnice między tymi pojęciami, co pomoże lepiej zrozumieć ich zastosowania oraz funkcje w kontekście baz danych.
Pytanie 22
Którego znacznika użyć, aby umieścić na stronie animację Flash (.swf)?
A.
<img>
B.
<object>
Poprawna odpowiedź
C.
<audio>
D.
<video>
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe znaczniki obsługują inne media. <img> wstawia STATYCZNY obraz (np. PNG, JPG), bez interaktywności. <audio> odtwarza dźwięk, a <video> film w formatach HTML5 (MP4, WebM, Ogg) - żaden nie uruchamia pliku Flash. Plik .swf osadza <object>.
Pytanie 23
Rekordy do raportu mogą pochodzić z
A. zapytania INSERT INTOTwoja odpowiedź
B. makropolecenia
C. innego raportu
D. tabeliPoprawna odpowiedź
Niepoprawna odpowiedź. Wybór innego raportu jako źródła danych może wydawać się logiczny na pierwszy rzut oka, jednak w rzeczywistości, raporty są zazwyczaj wynikiem analizy danych już zgromadzonych w bazach danych, a nie bezpośrednim źródłem tych danych. Raport oparty na innym raporcie może prowadzić do niepotrzebnej złożoności oraz braku przejrzystości w dostępie do danych. Ponadto użycie makropolecenia jako źródła do generowania raportu jest niewłaściwe, ponieważ makropolecenia są narzędziami do automatyzacji zadań, a nie strukturami danych. W kontekście zapytania 'INSERT INTO', należy zauważyć, że jest to instrukcja służąca do dodawania nowych rekordów do tabeli, a nie do pobierania danych. Wybranie takiego podejścia mogłoby wprowadzić w błąd, ponieważ nie odzwierciedla rzeczywistego procesu raportowania, który wymaga analizy istniejących danych. Często błędy myślenia w tym kontekście wynikają z pomylenia celów automatyzacji z celami analizy danych. Poprawne zrozumienie roli tabel w bazach danych pozwala na wydajne raportowanie i podejmowanie decyzji na podstawie rzeczywistych i aktualnych informacji.
Pytanie 24
Które ograniczenie należy przypisać kolumnie, aby wpisywane do niej wartości nie mogły się powtarzać?
A.
UNIQUE
Twoja odpowiedź
B.
NOREPEAT
C.
NOTNULL
D.
SINGLE
Poprawna odpowiedź. Ograniczenie UNIQUE wymusza, że wartości w kolumnie nie mogą się powtarzać - baza odrzuci próbę wstawienia duplikatu. Stosuje się je np. do adresów e-mail, numerów PESEL czy loginów, gdzie każda wartość musi być niepowtarzalna, ale (w odróżnieniu od klucza głównego) kolumna może dopuszczać NULL. Definiuje się je przy kolumnie, np. emailVARCHAR(100)UNIQUE. Dlatego brak powtórzeń zapewnia UNIQUE.
Pytanie 25
Ile WARUNKÓW wystarczy, aby znaleźć największą z trzech liczb a, b, c?
A. jedna pętla
B. dwie tablice
C. pięć zmiennych
D. dwa warunkiTwoja odpowiedź
Poprawna odpowiedź. Aby wyłonić największą z trzech liczb a, b, c, wystarczą DWA porównania: najpierw wybierasz większą z dwóch (np. a i b), a potem porównujesz wynik z trzecią liczbą c. Te dwa warunki w pełni wyznaczają maksimum. Dlatego wystarczają dwa warunki.
Pytanie 26
Dana jest tabela firmy zawierająca następujące kolumny: nazwa, adres, NIP, obrot (obrót w ostatnim miesiącu), rozliczenie, status. Wykonanie kwerendy SQL SELECT sprawi, że zostaną wyświetlone
SELECTnazwa, NIPFROMfirmyWHEREobrot<4000;
A. wszystkie dane firm, które w ostatnim miesiącu miały obrót mniejszy niż 4000 zł.
B. jedynie nazwa oraz numer NIP firm, które w ostatnim miesiącu miały obrót mniejszy niż 4000 zł.Twoja odpowiedź
C. wszystkie dane firm, które w ostatnim miesiącu miały obrót co najmniej 4000 zł.
D. jedynie nazwa oraz numer NIP firm, które w ostatnim miesiącu miały obrót co najmniej 4000 zł.
Poprawna odpowiedź. Twoja odpowiedź jest poprawna. Przy wykonywaniu zapytań SQL często wybieramy nie wszystkie, a jedynie niektóre kolumny z tabeli. W tym przypadku, pytanie dotyczyło wybrania tylko nazwy i NIPu firm, które w ostatnim miesiącu miały obrót mniejszy niż 4000 zł. Do realizacji tego zadania użyliśmy kwerendy SELECT z określeniem kolumn oraz warunku w klauzuli WHERE. Jest to częsty scenariusz w praktyce, gdy potrzebujemy wyfiltrować dane według określonych kryteriów. Ważne jest zrozumienie, że instrukcja SELECT jest używana do wybrania jednej lub wielu kolumn, które chcemy zobaczyć w wynikach, a klauzula WHERE służy do definiowania warunków, które muszą spełniać dane wyświetlane w wynikach.
Pytanie 27
Który element blokowy HTML5 jest przeznaczony na nawigację witryny?
A.
nav
Twoja odpowiedź
B.
aside
C.
main
D.
header
Poprawna odpowiedź. Element semantyczny <nav> wydziela blok NAWIGACJI witryny - zwykle menu główne lub zestaw linków do najważniejszych podstron, np. <nav><ahref="/">Start</a><ahref="/kontakt">Kontakt</a></nav>. Semantyka jest ważna nie tylko porządkowo: czytniki ekranu i wyszukiwarki rozpoznają po <nav>, że to nawigacja. Zapamiętaj: „nav” jak nawigacja.
Pytanie 28
W PHP zmienna $_GET stanowi zmienną
A. predefiniowaną, służącą do przesyłania informacji do skryptów PHP przez adres URLPoprawna odpowiedź
B. zwykłą, utworzoną przez autora strony
C. utworzoną przez autora strony, przeznaczoną do przesyłania danych z formularza przez adres URL
D. predefiniowaną, wykorzystywaną do zbierania danych formularza po nagłówkach żądania HTTP (informacje z formularza nie są widoczne w URL)Twoja odpowiedź
Niepoprawna odpowiedź. Odpowiedzi, które wskazują na to, że zmienna $_GET jest zwykłą zmienną lub jest definiowana przez twórcę strony, są nieprawidłowe. $_GET jest superglobalną tablicą, co oznacza, że jej dostępność jest zapewniona w całym skrypcie bez potrzeby wcześniejszego deklarowania. Zrozumienie różnicy między zmiennymi predefiniowanymi a tymi zdefiniowanymi przez użytkownika jest kluczowe dla właściwego zarządzania danymi w PHP. Ponadto, odpowiedzi sugerujące, że $_GET służy do gromadzenia wartości formularza po nagłówkach zlecenia HTTP, mylą metodę GET z metodą POST. W przeciwieństwie do POST, dane przesyłane za pomocą GET są widoczne w adresie URL, co czyni je mniej bezpiecznymi dla wrażliwych danych. Mówiąc o formularzach, $_GET jest jedynie jedną z metod przesyłania danych, obok $_POST i $_REQUEST, z których każda ma swoje specyficzne zastosowania i ograniczenia. Generalnie, korzystanie z $_GET jest odpowiednie do przesyłania niewielkich ilości danych, takich jak parametry zapytań, ale należy być świadomym, że wykorzystywanie tej metody z danymi wrażliwymi jest ryzykowne i należy unikać tego podejścia w praktyce. Dbając o bezpieczeństwo aplikacji, warto zrozumieć te różnice i stosować się do dobrych praktyk dotyczących przetwarzania danych wejściowych.
Niepoprawna odpowiedź. Niestety, twoja odpowiedź nie była prawidłowa. Wybór innego przycisku niż Przycisk 2 sugeruje, że mogłeś nie do końca zrozumieć, jak działa selekcja i stylizacja elementów za pomocą CSS. Białe tło, odstęp wewnętrzny 10 pikseli, szerokość obramowania 2 piksele oraz przerywana dolna krawędź obramowania są elementami, które zostały ustawione w stylach CSS dla przycisku 2. Pozostałe przyciski miały inne cechy, które nie były zgodne z opisanym stylem CSS. Przy niewłaściwym wyborze przycisku lub innego elementu do stylizacji, strona może nie wyglądać zgodnie z zamierzeniem, co może negatywnie wpłynąć na doświadczenie użytkownika. Dlatego ważne jest, aby zrozumieć, jak działa selekcja i stylizacja CSS. Pamiętaj, że zrozumienie CSS to klucz do tworzenia atrakcyjnych i funkcjonalnych projektów webowych.
Pytanie 30
W stylu CSS ustalono obramowanie pojedyncze, które ma następujące kolory dla krawędzi:
border:solid1px;border-color:redbluegreenyellow;
A. górna – czerwona, lewa – niebieska, dolna – zielona, prawa – żółta
B. górna – czerwona, prawa – niebieska, dolna – zielona, lewa – żółtaTwoja odpowiedź
C. lewa – czerwona, dolna – niebieska, prawa – zielona, górna – żółta
D. prawa – czerwona, dolna – niebieska, lewa – zielona, górna – żółta
Poprawna odpowiedź. Definicja obramowania za pomocą stylu CSS z użyciem właściwości border-color pozwala na określenie kolorów każdej z krawędzi elementu w kolejności zgodnej ze wskazówkami zegara. Gdy podano cztery wartości jak w border-color: red blue green yellow; oznaczają one odpowiednio kolory krawędzi górnej prawej dolnej i lewej. Właściwość border: solid 1px; definiuje typ obramowania jako solidne i jego szerokość jako 1px. Warto zaznaczyć że podanie czterech wartości kolorów w border-color jest zgodne z zasadami CSS i umożliwia konfigurowanie wyglądu elementów w sposób szczegółowy i zindywidualizowany. Projektanci stron internetowych często używają tej techniki do tworzenia graficznych stylów które zwiększają czytelność i estetykę witryny. W praktyce wiedza o manipulacji stylem obramowania w CSS jest kluczowa dla tworzenia responsywnych i wizualnie atrakcyjnych interfejsów użytkownika. Takie podejście wspiera zachowanie spójności wizualnej co jest jedną z dobrych praktyk w projektowaniu front-endu.
Pytanie 31
W języku JavaScript trzeba zapisać warunek, który będzie prawdziwy, gdy zmienna a będzie jakąkolwiek liczbą naturalną dodatnią (bez 0) lub zmienna b przyjmie wartość z zamkniętego przedziału od 10 do 100. Wyrażenie logiczne w tym warunku ma formę
A. (a>0) && ((b>=10) || (b<=100))
B. (a>0) && ((b>=10) && (b<=100))
C. (a>0) || ((b>=10) || (b<=100))
D. (a>0) || ((b>=10) && (b<=100))Twoja odpowiedź
Poprawna odpowiedź. Warunek zapisany w języku JavaScript jako (a>0) || ((b>=10) && (b<=100)) jest poprawny, ponieważ spełnia wymagania dotyczące sprawdzenia, czy zmienna a jest liczbą naturalną dodatnią oraz czy zmienna b mieści się w przedziale od 10 do 100. Wyrażenie logiczne wykorzystuje operator || (alternatywa), który zwraca true, jeśli przynajmniej jeden z warunków jest spełniony. Warunek a>0 zapewnia, że zmienna a jest większa od zera, co jest zgodne z definicją liczb naturalnych dodatnich. Z kolei wyrażenie (b>=10) && (b<=100) sprawdza, czy zmienna b jest w zadanym przedziale, co jest zgodne z wymaganiami. Wartości graniczne 10 i 100 są uwzględnione dzięki operatorowi && (konjunkcja), który wymaga, aby oba warunki były prawdziwe, aby całe wyrażenie zwróciło true. W praktyce, takie podejście można wykorzystać w różnych kontekstach, np. walidacji danych wejściowych w formularzach internetowych, gdzie kluczowe jest zapewnienie, że użytkownik wprowadza poprawne wartości. Tego rodzaju wyrażenia logiczne są fundamentem programowania w JavaScript, umożliwiając tworzenie bardziej złożonych logik aplikacji. Zgodnie z dokumentacją ECMAScript, użycie operatorów logicznych jest standardowym sposobem na przetwarzanie warunków w programowaniu.
Pytanie 32
Rezultatem działania zamieszczonej pętli napisanej w języku PHP jest wypisanie następujących liczb
A. od 10 do 1Twoja odpowiedź
B. od 1 do 10
C. od 2 do 10
D. od 10 do 2
Poprawna odpowiedź. Pętla for w języku PHP przedstawiona w pytaniu zaczyna od wartości początkowej 10 dla zmiennej iteracyjnej $i. Warunek zakończenia pętli to $i >= 1, co oznacza że pętla będzie działać dopóki wartość $i jest większa lub równa 1. W każdym kroku iteracji następuje dekrementacja zmiennej $i o 1 dzięki operatorowi $i--. W praktyce oznacza to że pętla wypisuje wartości od 10 do 1 w kolejnych liniach. Dekrementacja w pętlach jest często stosowana, kiedy chcemy przechodzić przez elementy w odwrotnej kolejności, co jest przydatne w algorytmach sortowania bądź odwracania danych. Dzięki jasnemu określeniu warunków początkowych, końcowych oraz kroku iteracji pętla for jest jednym z bardziej przejrzystych i zrozumiałych narzędzi w programowaniu. Warto pamiętać o optymalizacji kodu i unikanie nadmiernych iteracji, co jest dobrym standardem w praktykach programistycznych, zwłaszcza w projektach o dużej skali. Pisząc bardziej złożone skrypty, należy pamiętać także o możliwości wystąpienia błędów związanych z nieskończonymi pętlami jeśli warunek zakończenia nie jest poprawnie zdefiniowany.
Pytanie 33
Co oznacza akronim ACID w kontekście transakcji bazodanowych?
A. atomic, consistent, isolated, durablePoprawna odpowiedź
B. atomic, comming, is, do
C. atomic, consistent, iss, dependableTwoja odpowiedź
D. atomic, constraint, isolated, dependable
Niepoprawna odpowiedź. Pozostałe rozwinięcia są błędne - zawierają zmyślone lub niepasujące słowa. Warianty z „comming”, „iss”, „do”, „dependable” czy „constraint” nie są oficjalnymi składnikami ACID. Prawidłowe cztery cechy transakcji to Atomicity, Consistency, Isolation i Durability (atomowość, spójność, izolacja, trwałość). Dlatego poprawne jest rozwinięcie atomic, consistent, isolated, durable, czyli trzecia odpowiedź.
Pytanie 34
Jakie będą skutki wykonania podanego zapytania w tabeli?
ALTER TABLE nazwa1 ADD nazwa2 DOUBLE NOT NULL;
A. zmiana wartości kolumny nazwa2 na DOUBLE
B. dodanie kolumny nazwa2 z wartością domyślną typu DOUBLETwoja odpowiedź
C. zmiana nazwy kolumny z nazwa1 na nazwa2
D. dodanie kolumny nazwa2 typu zmiennoprzecinkowegoPoprawna odpowiedź
Niepoprawna odpowiedź. Analiza błędnych odpowiedzi związanych z zapytaniem ALTER TABLE wymaga zrozumienia funkcji oraz ograniczeń tej komendy w SQL. Słowo kluczowe ADD wskazuje na intencję dodania nowego elementu do struktury tabeli co eliminuje możliwość zmiany istniejącej kolumny jak sugerują niektóre odpowiedzi. Typ DOUBLE jest używany do przechowywania danych zmiennoprzecinkowych lecz nie oznacza to że istniejąca kolumna może zmieniać się na ten typ poprzez użycie ADD co jest błędnym zrozumieniem funkcji SQL. Typowe błędy myślowe obejmują mylenie dodawania nowej kolumny ze zmianą istniejącej co można osiągnąć jedynie poprzez bezpośrednie użycie MODIFY w poleceniu ALTER TABLE. Również błędne jest założenie że dodawanie kolumny automatycznie ustali wartość domyślną co wymaga specjalnego określenia DEFAULT w zapytaniu aby wprowadzić takie ustawienie. Konsekwencją takiego błędnego rozumienia jest niepoprawna rozbudowa struktury danych co może prowadzić do problemów w aplikacjach wykorzystujących bazę danych. Prawidłowe rozumienie działania ALTER TABLE jest kluczowe w efektywnym zarządzaniu i rozwoju baz danych co zgodne jest z dobrymi praktykami w tej dziedzinie. Aby uniknąć tych błędów warto zapoznać się z dokumentacją i praktykami związanymi z obsługą SQL i wdrożyć systematyczne testowanie zmian strukturalnych przed ich implementacją w środowisku produkcyjnym co minimalizuje ryzyko błędów i ich wpływ na operacje biznesowe. Poprawne użycie ALTER TABLE wymaga także zaawansowanej znajomości typów danych i zasad spójności w bazach danych co jest istotnym elementem kompetencji każdego specjalisty IT zarządzającego danymi. W kontekście tego pytania ważne jest zrozumienie że kluczową operacją jest dodanie nowej kolumny a nie zmiana istniejącej struktury co wymaga innego podejścia i komend SQL.
Pytanie 35
Na czym polega zasada działania algorytmów zachłannych?
A. na odwoływaniu się funkcji do samej siebie
B. na dzieleniu problemu na mniejsze podproblemy
C. na przeszukiwaniu danych aż do znalezienia rozwiązania
D. na wybieraniu rozwiązania najkorzystniejszego na danym etapieTwoja odpowiedź
Poprawna odpowiedź. Algorytm zachłanny (greedy) buduje rozwiązanie krok po kroku, w każdym etapie wybierając opcję, która w danym momencie wydaje się najkorzystniejsza (lokalnie optymalna), bez cofania wcześniejszych decyzji. Jest prosty i szybki, a dla niektórych problemów daje rozwiązanie optymalne (np. wydawanie reszty pewnymi zestawami monet, algorytm Dijkstry, kod Huffmana). Bywa jednak, że lokalnie najlepszy wybór nie prowadzi do globalnie najlepszego wyniku. Dlatego zasada zachłanna to wybieranie najkorzystniejszej opcji na danym etapie.
Pytanie 36
Jak nazywa się proces przedstawienia, w formie właściwej dla danego środowiska, informacji zawartych w dokumencie elektronicznym?
A. renderowaniePoprawna odpowiedź
B. teksturowanieTwoja odpowiedź
C. mapowanie
D. rasteryzacja
Niepoprawna odpowiedź. Pozostałe pojęcia oznaczają inne operacje. Mapowanie to przyporządkowanie elementów jednego zbioru do drugiego (np. klawiszy do funkcji, danych do struktur) - nie tworzy obrazu dokumentu. Rasteryzacja to konkretna zamiana grafiki wektorowej na siatkę pikseli, czyli wycinek szerszego procesu, a nie samo przedstawienie dokumentu. Teksturowanie należy do grafiki 3D i polega na nakładaniu tekstur (obrazów) na powierzchnie modeli. Przekształcenie dokumentu w jego widoczną postać to renderowanie, dlatego ta odpowiedź jest poprawna.
Pytanie 37
Po wykonaniu poniższego kodu JavaScript, który operuje na wcześniej przygotowanej tablicy liczby, w zmiennej wynik znajduje się suma
var wynik = 0; for (i = 0; i < 100; i++) if (liczby[i] % 2 == 0) wynik += liczby[i];
A. dodatnich elementów tablicy
B. nieparzystych elementów tablicy
C. parzystych elementów tablicyTwoja odpowiedź
D. wszystkich elementów tablicy
Poprawna odpowiedź. Przedstawiony kod JavaScript oblicza sumę wszystkich parzystych elementów tablicy liczby. W języku JavaScript operator modulo (%) jest używany do obliczania reszty z dzielenia. W tym przypadku liczby[i] % 2 == 0 sprawdza, czy dany element tablicy liczby jest parzysty. Jeśli reszta z dzielenia przez 2 wynosi 0, oznacza to, że liczba jest parzysta. Dlatego każda parzysta liczba z tablicy jest dodawana do zmiennej wynik. Warto zauważyć, że pętla for przechodzi przez pierwsze 100 elementów tablicy, co sugeruje, że tablica liczby musi mieć co najmniej 100 elementów. Tego typu operacje są często wykorzystywane w praktycznych zastosowaniach, takich jak analiza danych, gdzie konieczne jest filtrowanie i przetwarzanie określonych wartości z dużych zbiorów danych. Dobre praktyki zalecają, aby zrozumieć zarówno składnię, jak i zastosowanie operacji warunkowych i pętli, co jest kluczowe w efektywnym programowaniu. Takie rozwiązania są fundamentem optymalnego przetwarzania danych, a ich zrozumienie umożliwia tworzenie bardziej złożonych algorytmów.
Pytanie 38
Polecenie MySQL:
ALTER TABLEksiazkiMODIFYtytulVARCHAR(100)NOT NULL;
Przedstawione polecenie MySQL ma za zadanie
A. zmienić nazwę kolumny w tabeli ksiazki
B. dodać do tabeli ksiazki kolumnę tytul
C. usunąć kolumnę tytul z tabeli ksiazki
D. zmienić typ kolumny tytul w tabeli ksiazkiTwoja odpowiedź
Poprawna odpowiedź. Polecenie ALTER TABLE w przedstawionym zapytaniu jest używane do modyfikacji struktury istniejącej tabeli w bazie danych MySQL. W szczególności, zapytanie zmienia typ kolumny 'tytul' w tabeli 'ksiazki' na VARCHAR(100) oraz ustawia ten typ jako NOT NULL, co oznacza, że ta kolumna nie może zawierać wartości NULL. Typ VARCHAR jest typem danych zmiennych o długości, co pozwala na przechowywanie ciągów znaków o zmiennej długości do 100 znaków. Zmiana typu kolumny może być przydatna w sytuacjach, gdy chcemy zmienić sposób przechowywania danych lub dostosować je do nowych wymagań aplikacji. Przykładem może być sytuacja, w której początkowo tytul był przechowywany jako tekst o stałej długości (np. CHAR), ale później zdecydowano, że lepszym rozwiązaniem będzie przechowywanie go jako VARCHAR dla oszczędności miejsca. W kontekście standardów SQL, modyfikacja kolumny zgodnie z definicją standardu SQL jest dopuszczalna, pod warunkiem, że nie narusza ona reguł dotyczących integralności danych i typów. Warto również pamiętać, że zmiana typu kolumny w bazie danych może wymagać migracji danych, co należy uwzględnić w planowaniu zmian.
Pytanie 39
Jakie jest zadanie funkcji przedstawionej w języku JavaScript?
 function fun1(a, b) {
    if (a % 2 != 0) a++;
    for (n = a; n <= b; n+=2)
        document.write(n);
}
A. zwrócenie wartości liczb parzystych od a do bTwoja odpowiedź
B. sprawdzenie, czy liczba a jest nieparzysta; w przypadku potwierdzenia, wypisanie jej
C. wypisanie wszystkich liczb z zakresu od a do b
D. wypisanie liczb parzystych z zakresu od a do bPoprawna odpowiedź
Niepoprawna odpowiedź. Odpowiedzi takie jak "wypisanie wszystkich liczb z przedziału od a do b" oraz "zwrócenie wartości parzystych liczb od a do b" ilustrują powszechne nieporozumienia dotyczące działania funkcji oraz jej logiki. Funkcja nie wypisuje wszystkich liczb z przedziału, ponieważ jej konstrukcja ogranicza wyniki do liczb parzystych. Odpowiedź ta nie uwzględnia kluczowego kroku w funkcji, polegającego na modyfikacji zmiennej a, co oznacza, że w przypadku nieparzystego a, pierwsza wypisana liczba będzie parzysta. Natomiast odpowiedź sugerująca, że funkcja zwraca wartości parzyste, jest również myląca, ponieważ funkcja nie zwraca wartości (nie używa return), a jedynie wypisuje je na stronie za pomocą document.write(). To może prowadzić do nieporozumień, zwłaszcza w kontekście oczekiwań dotyczących struktury danych. Typowym błędem myślowym jest zakładanie, że pętle for mogą generować wszystkie liczby w danym zakresie, gdy w rzeczywistości sposób ich inkrementacji (w tym przypadku o 2) determinuje, które wartości są ostatecznie wyświetlane. Przykładem na to jest sytuacja, gdy użytkownik nie dostrzega, że pętla zmienia krok zwiększenia i przez to nie uzyskuje pełnej sekwencji liczb. Warto zwrócić uwagę na konwencje programistyczne, takie jak zasady dotyczące wypisywania danych i używania zwrotów, co jest kluczowe dla tworzenia przejrzystego i efektywnego kodu.
Pytanie 40
W systemie baz danych zdefiniowano tabelę Mieszkancy, która zawiera dane. W celu usunięcia tej tabeli oraz jej zawartości, należy użyć polecenia
A. DELETE FROM Mieszkancy;Twoja odpowiedź
B. DROP TABLE Mieszkancy;Poprawna odpowiedź
C. TRUNCATE TABLE Mieszkancy;
D. ALTER TABLE Mieszkancy;
Niepoprawna odpowiedź. Wybór nieprawidłowych poleceń do usunięcia tabeli często wynika z niepełnego zrozumienia różnicy między różnymi instrukcjami SQL. Polecenie 'DELETE FROM Mieszkancy;' usuwa wszystkie rekordy z tabeli, ale sama tabela oraz jej struktura pozostają nienaruszone. To oznacza, że tabela nadal będzie istnieć w bazie danych, co może być mylące, gdy celem jest całkowite usunięcie obiektu. Z drugiej strony, 'ALTER TABLE Mieszkancy;' służy do zmiany struktury tabeli, takiej jak dodawanie kolumn czy zmiana typów danych, a nie do jej usuwania. Zastosowanie tego polecenia w kontekście usuwania tabeli wskazuje na niezrozumienie roli, jaką pełnią różne instrukcje w SQL. Ostatecznie, 'TRUNCATE TABLE Mieszkancy;' również może wydawać się odpowiednie, gdyż usuwa wszystkie wiersze z tabeli, ale pozostawia jej strukturę, co jest różne od całkowitego usunięcia tabeli. Kluczowym błędem jest mylenie operacji na danych z operacjami na strukturze obiektów w bazie danych. Zrozumienie tych różnic jest fundamentalne dla skutecznego zarządzania bazami danych oraz ich optymalizacji.