Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 6 września 2026 20:24
Zakończenie: 6 września 2026 20:26
Egzamin zdany!
Wynik: 8/10 punktów (80,0%)
Wymagane minimum: 5 punktów (50%)
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Złośliwe oprogramowanie stworzone w celu przyznania hakerom uprawnień administracyjnych do komputera ofiary bez jej świadomości, to
A. keylogger
B. rootkitTwoja odpowiedź
C. robak
D. wirus
Poprawna odpowiedź. Rootkit to specyficzny rodzaj złośliwego oprogramowania, który został stworzony właśnie po to, żeby uzyskać i utrzymać nieautoryzowane uprawnienia administracyjne na systemie ofiary, a jednocześnie pozostać jak najbardziej niezauważonym. W praktyce, rootkit pozwala atakującemu przejąć pełną kontrolę nad komputerem – może wtedy instalować inne szkodliwe programy, kraść dane czy omijać zabezpieczenia bez wiedzy użytkownika. Co ważne, rootkity są często wykorzystywane przez cyberprzestępców do tzw. eskalacji uprawnień, czyli podniesienia poziomu dostępu z konta zwykłego użytkownika do administratora (roota), co w świecie Linuksa i Unixa jest dość powszechną strategią. Moim zdaniem, to jeden z najtrudniejszych do wykrycia typów malware – potrafi modyfikować systemowe procesy, a nawet podszywać się pod pliki systemowe, co sprawia, że standardowe antywirusy często go nie wykrywają. W branży IT mówi się wręcz o konieczności korzystania z zaawansowanych narzędzi forensics, np. rootkit detectors i regularnym monitorowaniu integralności systemu, zgodnie z zaleceniami CIS Controls. Jeśli ktoś chce się dobrze zabezpieczyć, to naprawdę warto zwracać uwagę na nieoczywiste symptomy: podejrzane procesy, zmiany w kluczowych plikach systemowych czy dziwne aktywności sieciowe. Rootkit to prawdziwy koszmar administratorów i świetny „przykład z życia” na to, jak ważna jest segmentacja uprawnień i stosowanie zasady najmniejszych uprawnień.
Pytanie 2
Jakie jest zadanie interpretera?
A. wykonywanie skryptu krok po krokuPoprawna odpowiedź
B. analiza składni całego programu przed jego uruchomieniem
C. optymalizacja większej części kodu, aby przyspieszyć jego wykonanie
D. tłumaczenie kodu na kod maszynowyTwoja odpowiedź
Niepoprawna odpowiedź. Zobacz, dlaczego niektóre odpowiedzi były błędne w przypadku interpretera. Przede wszystkim, optymalizacja kodu nie jest jego głównym zadaniem. Choć można powiedzieć, że interpreter czasem poprawia wydajność, to nie o to tutaj chodzi. I pamiętaj, tłumaczenie kodu na kod maszynowy to zadanie kompilatora. Kompilatory biorą cały program i przetwarzają go przed uruchomieniem, a interpreter działa trochę inaczej – wykonuje kod krok po kroku. Dlatego nie tworzy oddzielnego pliku do uruchomienia. Co więcej, mówiąc o analizie składni, to jasne, że interpreter to robi, ale nie jest to jego główny cel. Chodzi o to, żeby wykonać kod od razu, a nie analizować wszystko przed. Te różnice są ważne i pokazują, jak bardzo się różnią kompilatory od interpreterów oraz gdzie każdy z nich ma swoje miejsce.
Pytanie 3
Który z poniższych formatów jest najczęściej używany do wymiany danych w aplikacjach webowych?
A. XML
B. YAML
C. JSONTwoja odpowiedź
D. CSV
Poprawna odpowiedź. JSON (JavaScript Object Notation) jest najczęściej używanym formatem wymiany danych w aplikacjach webowych ze względu na swoją prostotę, czytelność oraz łatwość w integracji z JavaScript. JSON jest lekki i pozwala na szybkie przetwarzanie danych, co czyni go idealnym wyborem w kontekście nowoczesnych aplikacji webowych, które często korzystają z technologii AJAX do komunikacji z serwerem. Przykładem zastosowania JSON może być przesyłanie danych z serwera do przeglądarki w aplikacjach SPA (Single Page Applications), gdzie asynchroniczne żądania wymagają formatu, który można łatwo zdeserializować na obiekt JavaScript. JSON wspiera zagnieżdżone struktury danych i kolekcje, co pozwala na modelowanie złożonych relacji między danymi. Ponadto, jego popularność doprowadziła do rozwoju wielu bibliotek i narzędzi, które ułatwiają pracę z tym formatem, takich jak `JSON.parse()` i `JSON.stringify()` w JavaScript. W związku z tym, JSON stał się de facto standardem dla wymiany danych w ekosystemie webowym, co potwierdzają również standardy takie jak REST, które często wykorzystują właśnie ten format do komunikacji z API.
Pytanie 4
Jakiego typu funkcja jest tworzona poza klasą, ale ma dostęp do jej prywatnych i chronionych elementów?
A. Funkcja zaprzyjaźnionaTwoja odpowiedź
B. Destruktor
C. Konstruktor
D. Metoda statyczna
Poprawna odpowiedź. Funkcja zaprzyjaźniona to specjalny typ funkcji, który jest deklarowany jako 'friend' w ciele klasy, co pozwala jej na dostęp do prywatnych i chronionych składowych tej klasy. Chociaż funkcja zaprzyjaźniona jest definiowana poza klasą, może operować na jej wewnętrznych danych, co czyni ją bardzo użytecznym narzędziem w programowaniu obiektowym. Tego rodzaju funkcje są często wykorzystywane w przypadkach, gdy konieczne jest współdziałanie dwóch klas lub funkcji narzędziowych, które muszą manipulować danymi wewnętrznymi klasy, ale nie powinny być jej metodami członkowskimi. Dzięki funkcjom zaprzyjaźnionym można zapewnić elastyczność w dostępie do danych przy jednoczesnym zachowaniu hermetyzacji klasy. Przykładem może być przeciążenie operatorów, np. operator +, który musi mieć dostęp do prywatnych składowych obu operandów.
Pytanie 5
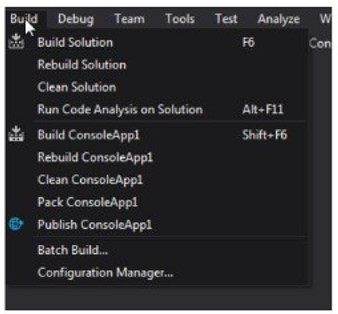
W środowisku do tworzenia aplikacji, gdzie przedstawiono menu, aby usunąć wszystkie pliki tymczasowe oraz wyniki projektu, należy wybrać opcję
A. Clean SolutionTwoja odpowiedź
B. Build Solution
C. Batch Build
D. Run Code Analysis on Solution
Poprawna odpowiedź. Opcja „Clean Solution” to dokładnie to, czego używa się w Visual Studio lub innych środowiskach IDE, gdy chce się pozbyć wszystkich plików tymczasowych oraz wyników kompilacji powiązanych z bieżącym projektem lub rozwiązaniem. To bardzo praktyczna funkcja – zwłaszcza wtedy, gdy mamy problemy ze zbudowaniem projektu po wprowadzeniu wielu zmian lub gdy różne konfiguracje builda zaczynają się mieszać. Clean Solution usuwa wszystkie foldery bin i obj, co pozwala rozpocząć proces kompilacji od zera, eliminując potencjalne konflikty wynikające ze starych plików. Moim zdaniem warto korzystać z tej opcji regularnie, szczególnie w większych projektach czy zespołach, gdzie często zmieniają się zależności. W branży IT, według dobrych praktyk, „czyszczenie” rozwiązania przed puszczeniem pełnego builda pomaga zredukować liczbę nieprzewidzianych błędów kompilacji. Dla mnie to trochę taki techniczny reset – zanim zaczniesz szukać błędów w kodzie, upewnij się, że budujesz wszystko na świeżo. Zresztą, w dokumentacji Microsoftu też znajdziesz zalecenia, by właśnie Clean Solution stosować do rozwiązywania problemów z nieaktualnymi artefaktami builda. Bez tej funkcji czasem trudno dojść, czemu kompilator się buntuje.
Pytanie 6
Która z wymienionych metod może pomóc w walce z uzależnieniem od internetu?
A. Zainstalowanie większej ilości aplikacji rozrywkowych
B. Zwiększenie czasu spędzanego na mediach społecznościowych
C. Używanie komputera jedynie w nocy
D. Wprowadzenie systematycznych przerw od używania urządzeń cyfrowychTwoja odpowiedź
Poprawna odpowiedź. Wprowadzenie systematycznych przerw od używania urządzeń cyfrowych to bardzo skuteczna metoda radzenia sobie z uzależnieniem od internetu. Rekomendują ją zarówno psychologowie, jak i specjaliści zajmujący się zdrowiem cyfrowym. W praktyce chodzi o to, żeby regularnie robić świadome przerwy od ekranu – na przykład ustawiając sobie limity czasowe, korzystając z aplikacji blokujących dostęp do określonych stron czy ustalając z góry pory dnia bez używania urządzeń elektronicznych. Takie działania mają mocno pozytywny wpływ na samodyscyplinę i pomagają odzyskać równowagę między życiem offline a online. Zresztą, nawet w poradnikach branżowych dla informatyków czy programistów można znaleźć zalecenia dotyczące odpoczynku od komputera, bo to poprawia koncentrację oraz ogólne samopoczucie. Moim zdaniem, warto przetestować różne sposoby tych przerw – czasem wystarczy wyjść na spacer, zrobić coś rękami albo po prostu porozmawiać z kimś na żywo. Regularność w tych czynnościach naprawdę robi różnicę. A co ciekawe, technika Pomodoro, znana z produktywności, świetnie sprawdza się także tutaj – 25 minut pracy, potem 5 minut przerwy bez żadnych ekranów. Z mojego doświadczenia, takie przerwy pomagają nie tylko ograniczyć korzystanie z internetu, ale też zadbać o swój wzrok i kręgosłup, co jest ważne zwłaszcza dla osób pracujących przy komputerze.
Pytanie 7
Wskaż rodzaj testów, które przeprowadza się podczas fazy tworzenia kodu źródłowego
A. testy wydajnościowe
B. testy jednostkoweTwoja odpowiedź
C. testy kompatybilności
D. testy wdrożeniowe
Poprawna odpowiedź. Testy jednostkowe to, moim zdaniem, absolutny fundament solidnego programowania. Są to niewielkie, automatyczne testy, które programista pisze zwykle równolegle z kodem albo nawet przed nim, jeśli stosuje się TDD (Test-Driven Development). Chodzi o to, żeby każda najmniejsza część programu – funkcja, metoda czy klasa – była dokładnie sprawdzona, czy zachowuje się zgodnie z założeniami już na etapie pisania kodu. W praktyce wygląda to tak: piszesz sobie funkcję, która np. liczy VAT, i od razu piszesz kilka testów, które sprawdzają, czy dla różnych wartości zwraca ona poprawne wyniki. Gdy coś się zmieni w kodzie, testy jednostkowe pozwalają od razu wychwycić, że coś zepsułeś (albo, oby nie, ktoś inny). Standardy branżowe, jak np. ISTQB czy wytyczne IEEE 829, bardzo mocno podkreślają wagę testów jednostkowych – bez nich zarządzanie jakością oprogramowania jest po prostu niemożliwe na dłuższą metę. W praktyce nawet proste projekty szybko bez nich zamieniają się w chaos. Co ciekawe, dobrze napisane testy jednostkowe ułatwiają refaktoryzację, bo masz pewność, że po zmianach wszystko działa jak należy. W mojej opinii, jeśli ktoś naprawdę poważnie myśli o pracy w branży IT, powinien umieć pisać testy jednostkowe z marszu.
Pytanie 8
Aby zdefiniować zmienną, która będzie działała jako licznik instancji danej klasy, należy wprowadzenie takiego zmiennej poprzedzić słowem kluczowym
A. virtual
B. staticTwoja odpowiedź
C. register
D. operator
Poprawna odpowiedź. Słowo kluczowe static jest absolutnie podstawą, jeśli chodzi o definiowanie zmiennych, które mają być współdzielone przez wszystkie instancje danej klasy. Gdy w klasie utworzysz zmienną statyczną, nie jest ona powiązana z żadnym konkretnym obiektem, tylko istnieje jedna taka zmienna dla całej klasy, niezależnie od liczby utworzonych obiektów. To niesamowicie przydatne, np. właśnie przy liczeniu instancji – wystarczy inkrementować taką zmienną w konstruktorze. W C++ czy Javie jest to standardowy sposób na śledzenie, ile obiektów danego typu zostało utworzonych. Z mojej perspektywy, korzystanie ze static to nie tylko wygoda, ale też sygnał dla innych programistów, że dana wartość jest globalna w kontekście klasy, a nie obiektu. Przykład praktyczny: jeżeli masz klasę Samochód i chcesz wiedzieć, ile samochodów zostało już utworzonych, to deklarujesz static int licznik; i za każdym razem, gdy konstruktor się odpala, robisz licznik++. Takie podejście jest bardzo czytelne i od razu wiadomo, o co chodzi. Warto też pamiętać, że static może być używany nie tylko do liczenia instancji, ale też do przechowywania różnych konfiguracji czy referencji do wspólnych zasobów. Zdecydowanie jest to jedna z lepszych praktyk, szczególnie kiedy program zaczyna rosnąć i zależy nam na porządku w kodzie.
Pytanie 9
Jak wygląda kod uzupełnienia do dwóch dla liczby -5 w formacie binarnym przy użyciu 8 bitów?
A. 00000101Twoja odpowiedź
B. 10000101
C. 11111101
D. 11111011Poprawna odpowiedź
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi, która przedstawia wartość 00000101, jest błędna, ponieważ jest to binarna reprezentacja liczby 5, a nie -5. Kod uzupełnieniowy do dwóch wymaga przedstawienia liczby ujemnej poprzez inwersję bitów i dodanie jedynki. Ta odpowiedź nie ma zastosowania przy obliczaniu liczb ujemnych, stąd jest niewłaściwa. Kolejna odpowiedź, 11111101, również jest nieprawidłowa. W przypadku tej liczby, zainwersowanie bitów liczby 5 dawałoby 11111010, a dodanie 1 do tej wartości prowadziłoby do 11111011, co wskazuje, że ta odpowiedź nie jest zgodna z zasadą uzupełnienia do dwóch. Ostatnia z niepoprawnych odpowiedzi, 10000101, jest również błędna, ponieważ nie odpowiada żadnej z reprezentacji liczby -5. Gdybyśmy spróbowali konwertować ją z powrotem na wartość dziesiętną, otrzymalibyśmy 133, co jest zdecydowanie niepoprawne. Warto zauważyć, że każda z tych niepoprawnych odpowiedzi wskazuje na brak zrozumienia zasad konwersji liczb ujemnych w systemie binarnym, co jest kluczowe w informatyce i programowaniu, a ich użycie w praktycznych aplikacjach mogłoby prowadzić do poważnych błędów w obliczeniach.
Pytanie 10
Jaką wartość zwróci funkcja napisana w języku C++, jeżeli jej argumentem wejściowym jest tablica stworzona w następujący sposób:
Poprawna odpowiedź. Rozwiązując takie zadania, warto nauczyć się dokładnie patrzeć na strukturę kodu. Funkcja fun1 przyjmuje tablicę intów i sumuje jej elementy. Tu pętla for przechodzi po wszystkich sześciu indeksach – od 0 do 5. Gdy podmienisz na liczby z zadania: 3, 4, 2, 4, 10 oraz 0 – po prostu dodajesz te wartości do siebie. Suma wychodzi 23. Czyli wynik funkcji to właśnie 23. To taki bardzo typowy przykład sumowania elementów tablicy – nie tylko na lekcjach, ale praktycznie wszędzie, np. jak liczysz sumę zamówień w sklepie internetowym albo punkty gracza w grze. Jeśli chodzi o dobre praktyki w C++, to warto wiedzieć, że lepiej przekazywać tablicę z dodatkowym parametrem długości, żeby nie robić magicznych liczb jak to '6' w pętli – można się wtedy łatwo pomylić przy zmianie rozmiaru. Moim zdaniem dobrze jest od razu przyswoić sobie nawyk wykorzystywania std::vector zamiast „gołych” tablic, bo są bezpieczniejsze i elastyczniejsze. To już taki krok w stronę kodu produkcyjnego. Ale podsumowując – jeśli widzisz tak napisany kod, to zawsze patrz, ile razy pętla się wykona i jakie są wartości w tablicy. Tylko tyle i aż tyle. W praktyce ta umiejętność przekłada się na szybkie debugowanie i pisanie niezawodnych programów.