Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 30 września 2026 11:37
Zakończenie: 30 września 2026 11:40
Egzamin niezdany
Wynik: 13/40 punktów (32,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 20% podejść do kwalifikacji INF.03.
Porównanie z 43896 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
W SQL klauzula DISTINCT w poleceniu SELECT zapewnia, że zwrócone wyniki
A. nie zawiera będą duplikatów.Poprawna odpowiedź
B. będą zgrupowane według wskazanego pola.Twoja odpowiedź
C. będą spełniały dany warunek.
D. będą uporządkowane.
Niepoprawna odpowiedź. Niepoprawność pierwszej odpowiedzi wynika z nieporozumienia dotyczącego funkcji DISTINCT. Klauzula ta nie ma na celu sortowania danych, a jedynie eliminację powtórzeń. Wyniki zapytania mogą być posortowane, ale jest to realizowane za pomocą osobnej klauzuli ORDER BY, a nie DISTINCT. Drugą odpowiedzią, która jest błędna, jest twierdzenie, że DISTINCT wymusza spełnienie określonego warunku. Klauzula DISTINCT nie jest używana do filtrowania danych na podstawie warunków; aby to osiągnąć, zwykle stosuje się klauzulę WHERE, która określa konkretne kryteria, jakie muszą być spełnione przez zwracane rekordy. Ostatnia błędna odpowiedź sugeruje, że wyniki będą pogrupowane według określonego pola, co jest mylące, ponieważ grupowanie osiąga się za pomocą klauzuli GROUP BY. Ta klauzula agreguje wiersze w grupy opierając się na wartościach w określonych kolumnach, a następnie umożliwia wykonywanie operacji agregujących, takich jak COUNT, SUM czy AVG, co jest zupełnie inną funkcjonalnością niż ta oferowana przez DISTINCT. W skrócie, klauzula DISTINCT koncentruje się na eliminacji duplikatów, podczas gdy sortowanie, warunki i grupowanie to odrębne aspekty zapytań SQL.
Pytanie 2
W systemie MySQL przyznanie roli o nazwie DBManager umożliwia użytkownikowi wykonywanie
A. nadzór nad serwerem
B. zakładanie użytkowników serwera oraz definiowanie ich hasełTwoja odpowiedź
C. wszystkie operacje na bazach danych serweraPoprawna odpowiedź
D. wszystkie operacje związane z bazami danych oraz użytkownikami serwera
Niepoprawna odpowiedź. Wybór odpowiedzi, która sugeruje, że rola DBManager przyznaje prawa do monitorowania serwera, tworzenia użytkowników serwera oraz wykonywania wszystkich operacji na bazach danych i użytkownikach, może prowadzić do mylnych wniosków na temat rzeczywistych możliwości tej roli. Monitorowanie serwera jako funkcja nie jest bezpośrednio związane z rolą DBManager. Chociaż monitorowanie jest istotnym aspektem zarządzania bazami danych, odpowiednie uprawnienia związane z tą funkcjonalnością są przyznawane innym rolom lub użytkownikom posiadającym konkretne przywileje, takie jak rola DBMonitor. Tworzenie użytkowników serwera i ustawianie im haseł również wykracza poza standardowe uprawnienia roli DBManager. Zwykle te czynności są przypisane administratorom systemu, którzy mają kontrolę nad bezpieczeństwem całego środowiska bazodanowego. Odpowiedzi sugerujące możliwość wykonywania wszelkich operacji na bazach danych i użytkownikach mogą sugerować, że rola DBManager obejmuje pełne uprawnienia administracyjne, co nie jest zgodne z praktykami bezpieczeństwa, które zalecają ograniczanie uprawnień w oparciu o zasadę najmniejszych uprawnień. Takie zrozumienie jest kluczowe, ponieważ przyznawanie zbyt szerokich uprawnień może prowadzić do luk w zabezpieczeniach i nadużyć, co narusza standardy zarządzania danymi i bezpieczeństwa w organizacjach. Dlatego ważne jest, aby dokładnie rozumieć zakres dostępnych ról i ich odpowiedzialności, aby zapewnić właściwe zarządzanie dostępem i bezpieczeństwem danych.
Pytanie 3
Jak system CMS realizuje oddzielenie treści serwisu od jego wyglądu?
A. treść ze statycznych plików HTML, a wygląd we Flashu
B. treść ze statycznych plików HTML, a wygląd ze szablonu
C. treść z bazy danych, a wygląd za pomocą atrybutów HTMLTwoja odpowiedź
D. treść generuje z bazy danych, a wygląd ze zdefiniowanego szablonuPoprawna odpowiedź
Niepoprawna odpowiedź. Istotą CMS jest rozdział treści (baza) i wyglądu (szablon). Warianty z treścią w statycznych plikach HTML przeczą dynamicznemu zarządzaniu treścią. Wygląd nie powstaje z atrybutów HTML ani we Flashu (technologia przestarzała), lecz z szablonu. CMS generuje treść z bazy danych, a wygląd ze zdefiniowanego szablonu.
Pytanie 4
Które z tabel będą poddane weryfikacji zgodnie z przedstawionym poleceniem?
CHECK TABLE pracownicy CHANGED;
A. Tabele, które zmieniły się w obecnej sesji
B. Tylko te tabele, które nie mogły być poprawnie zakończoneTwoja odpowiedź
C. Tabele, które uległy zmianie od ostatniej kontroli lub nie zostały poprawnie zamkniętePoprawna odpowiedź
D. Wyłącznie tabele odnoszące się do innych
Niepoprawna odpowiedź. Wybór odpowiedzi dotyczącej jedynie tabel, które nie zostały poprawnie zamknięte, nie uwzględnia pełnego zakresu zastosowania polecenia CHECK TABLE. To podejście ignoruje ważny aspekt, jakim jest monitorowanie wszelkich zmian, które miały miejsce od ostatniej inspekcji. Tabele mogą być zmieniane przez różne operacje, zarówno podczas aktualizacji, jak i w wyniku nieprawidłowego zakończenia sesji, co czyni istotnym ich kontrolowanie w szerszym ujęciu. Z kolei odpowiedź sugerująca, że tylko tabele referujące do innych powinny być sprawdzane, jest myląca, ponieważ takie ograniczenie do współzależności między tabelami nie odzwierciedla rzeczywistej natury problemów z integralnością danych. W praktyce, wszystkie tabele w bazie danych mogą wpływać na siebie nawzajem, a problemy w jednej tabeli mogą prowadzić do błędów w innych. Takie myślenie może prowadzić do zaniedbania, które naraża system na uszkodzenia, a nawet utratę danych. Właściwe podejście do zarządzania bazami danych powinno opierać się na całościowym przeglądzie stanu tabel, a nie na selektywnym podejściu, co może przyczynić się do nieefektywności i ryzyka utraty danych. Dlatego też skupienie się tylko na jednym aspekcie, takim jak niewłaściwe zamknięcie, jest niewystarczające dla zapewnienia integralności systemu.
Pytanie 5
Tabela ksiazki ma kolumny tytul, autor, cena (liczbowa). Która kwerenda zwróci TYLKO tytuły książek tańszych niż 50?
A.
SELECTksiazkiFROMtytulWHEREcena<'50 zł';
Twoja odpowiedź
B.
SELECT*FROMksiazkiWHEREcena<50;
C.
SELECTtytulFROMksiazkiWHEREcena>'50 zł';
D.
SELECTtytulFROMksiazkiWHEREcena<50;
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe zapytania nie spełniają warunków. SELECT* zwróciłby wszystkie kolumny, a nie same tytuły. Porównania z tekstem '50 zł' są błędne (cena jest liczbą), a > oznaczałoby książki DROŻSZE. SELECTksiazkiFROMtytul zamienia rolami tabelę i kolumnę. Poprawne jest SELECTtytulFROMksiazkiWHEREcena<50;.
Pytanie 6
Który zapis służy do zdefiniowania klucza obcego w MySQL?
A. dynamicznie zmienić treść strony HTML już w przeglądarcePoprawna odpowiedź
B. obsłużyć danych z formularzy
C. wygenerować dynamiczną treść strony
D. wykonać operacji na danych w bazieTwoja odpowiedź
Niepoprawna odpowiedź. Pozostałe rzeczy PHP wykonuje BEZ problemu, więc nie pasują do pytania „czego NIE da się”. Obsługa danych z formularzy ($_POST, $_GET), operacje na bazie danych i generowanie dynamicznej treści strony to typowe, codzienne zadania PHP. Poza jego zasięgiem jest tylko zmiana już wyświetlonej strony w przeglądarce - to robi JavaScript.
Pytanie 8
Jeden klient może mieć wiele zamówień, a każde zamówienie należy do jednego klienta. Jaka to relacja?
A.
1..1
Twoja odpowiedź
B.
n..n
C.
n..1
D.
1..n
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe oznaczenia nie pasują. 1..1 znaczyłoby, że klient ma tylko jedno zamówienie. n..1 to ta sama relacja zapisana odwrotnie (z punktu widzenia zamówień), ale w opisie punktem wyjścia jest klient, więc naturalnie 1..n. n..n pozwalałoby, by zamówienie należało do wielu klientów. Opisany przypadek to 1..n.
Pytanie 9
Funkcja agregująca MIN w języku SQL ma na celu określenie
A. wartości minimalnej z kolumny zwróconej przez kwerendęPoprawna odpowiedź
B. liczby wierszy zwróconych przez kwerendę
C. średniej wartości kolumny obserwowanej w wyniku zapytaniaTwoja odpowiedź
D. liczby znaków w rekordach zwróconych przez kwerendę
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi, mówiąca o liczbie wierszy zwróconych kwerendą, myli zastosowanie funkcji agregujących z podstawowymi operacjami na tabelach w SQL. Liczba wierszy w zbiorze wynikowym jest określana przez funkcję COUNT, a nie przez MIN. Kolejna odpowiedź, dotycząca liczby znaków w zwróconych rekordach, również jest myląca, ponieważ nie ma to związku z funkcją MIN. Funkcja MIN koncentruje się na wartościach kolumny, a nie na ich długości. Odpowiedź dotycząca średniej wartości kolumny myli MIN z funkcją AVG. To częsty błąd, ponieważ obie funkcje agregujące służą do analizy danych, ale każda z nich dostarcza innego rodzaju informacji. Ważne jest, aby jednocześnie rozumieć, że każda z funkcji agregujących ma swoje specyficzne zastosowanie i kontekst. Używanie funkcji MIN wiąże się z poszukiwaniem najniższej wartości w określonym zbiorze, a nie z obliczaniem statystyk takich jak liczba wierszy czy średnia arytmetyczna. Zrozumienie różnic pomiędzy tymi funkcjami jest kluczowe przy pracy z bazami danych, a także przy formułowaniu zapytań SQL, aby uzyskać konkretne i precyzyjne wyniki.
Pytanie 10
Który opis dotyczy metody POST przesyłania formularza?
A. można ją zapisać jako zakładkę w przeglądarce
B. jest zalecana przy przesyłaniu danych wrażliwych (hasło, numer karty)Twoja odpowiedź
C. dane są przesyłane w adresie URL, widoczne dla użytkownika
D. ma ograniczenie długości adresu do 255 znaków
Poprawna odpowiedź. Metoda POST przesyła dane w treści żądania (a nie w adresie URL), więc nie są one widoczne w pasku adresu - dlatego zaleca się ją dla danych wrażliwych, jak hasło czy numer karty. Dlatego POST jest zalecana przy danych wrażliwych.
Pytanie 11
W SQL przy użyciu kwerendy ALTER można
A. zlikwidować tabelę
B. stworzyć tabelę
C. dodać dane do tabeliTwoja odpowiedź
D. zmienić strukturę tabeliPoprawna odpowiedź
Niepoprawna odpowiedź. Kwerenda <i>ALTER</i> w SQL ma na celu modyfikację istniejących tabel, a nie ich usuwanie czy tworzenie nowych. Usunięcie tabeli realizowane jest za pomocą komendy <i>DROP</i>, która trwałego eliminuje tabelę z bazy danych, wraz z wszystkimi danymi, które zawiera. Tworzenie nowych tabel odbywa się za pomocą kwerendy <i>CREATE</i>, która definiuje nową strukturę i jest niezbędna, gdy potrzebujemy zacząć od zera lub wprowadzić nowe dane w zgodzie z innymi wymaganiami lub projektami. Natomiast wprowadzanie danych do tabeli zrealizowane jest przy pomocy komendy <i>INSERT</i>, która pozwala na dodawanie nowych rekordów do już istniejących tabel w bazie. Odpowiedzi te mogą prowadzić do mylnych wniosków, ponieważ nie uwzględniają konkretnej funkcjonalności kwerendy <i>ALTER</i</i>, co jest kluczowe dla zrozumienia relacyjnych baz danych. W praktyce, brak zrozumienia roli i zastosowania poszczególnych kwerend SQL może prowadzić do błędów w projektowaniu baz danych oraz ich administracji, co może skutkować utratą danych lub wydajności. Ważne jest zatem, aby jasno rozróżniać te komendy i ich zastosowania w kontekście zarządzania danymi w systemach bazodanowych.
Pytanie 12
Jakie sformułowanie najlepiej opisuje metodę POST do przesyłania formularzy?
A. Ma dodatkowe ograniczenia związane z długością adresu - maksimum 255 znaków
B. Jest zalecana, gdy przesyłane są dane poufne, na przykład hasło, numer telefonu lub numer karty kredytowejTwoja odpowiedź
C. Może być zarejestrowana jako zakładka w przeglądarce internetowej
D. Dane są przesyłane przez adres URL, co czyni je widocznymi dla użytkownika
Poprawna odpowiedź. Metoda POST jest jedną z podstawowych metod przesyłania danych w protokole HTTP, której głównym celem jest umożliwienie przesyłania dużych objętości danych, w tym informacji poufnych. Gdy używamy metody POST do wysyłania formularzy, dane nie są widoczne w adresie URL, co czyni tę metodę bardziej odpowiednią do przesyłania wrażliwych informacji, takich jak hasła, numery kart kredytowych czy dane osobowe. W przeciwieństwie do metody GET, która dodaje dane do adresu URL, metoda POST przesyła je w ciele zapytania, co ogranicza ryzyko przypadkowego ujawnienia informacji. Standardy bezpieczeństwa w branży webowej zalecają użycie metody POST do wszelkich operacji, które zmieniają stan serwera, jak dodawanie użytkowników, logowanie czy przesyłanie informacji finansowych. Przykładem może być formularz logowania, w którym dane użytkownika są przesyłane do serwera w sposób niewidoczny dla osób trzecich, co minimalizuje ryzyko przechwycenia tych informacji przez złośliwe oprogramowanie.
Pytanie 13
Co w bazach danych oznacza termin „atrybut”?
A. powiązanie dwóch lub więcej danych związkiem
B. nazwaną kolumnę tabeli opisującą określoną cechęTwoja odpowiedź
C. obiekt złożony z cech opisanych kolumnami
D. rekord tabeli z danymi jednego egzemplarza
Poprawna odpowiedź. W terminologii baz danych ATRYBUT to nazwana kolumna tabeli opisująca jedną określoną cechę encji - np. kolumna „nazwisko” w tabeli osób. Wiersz to pojedynczy egzemplarz, a atrybuty to jego cechy zapisane w kolumnach. Dlatego atrybut oznacza nazwaną kolumnę opisującą daną cechę.
Pytanie 14
W języku SQL polecenie INSERT INTO
A. aktualizuje rekordy określoną wartością.
B. dodaje pola do tabeli.Twoja odpowiedź
C. wprowadza dane do tabeli.Poprawna odpowiedź
D. dodaje tabelę.
Niepoprawna odpowiedź. W SQL bardzo łatwo pomylić polecenia, bo wszystkie wyglądają dość podobnie, ale każde ma swoje wyraźne zadanie. INSERT INTO jest komendą typowo do pracy na danych, nie na strukturze bazy. Jeżeli ktoś myśli, że tym poleceniem „dodaje tabelę”, to miesza dwa różne obszary: definicję struktury i operacje na rekordach. Tworzenie nowej tabeli wykonuje się za pomocą CREATE TABLE, gdzie określamy nazwy kolumn, typy danych, klucze główne itd. INSERT zakłada, że tabela już istnieje i jest gotowa na przyjmowanie rekordów.
Podobnie błędne jest kojarzenie INSERT z dodawaniem pól (kolumn) do tabeli. Modyfikacja struktury tabeli, czyli dokładanie nowych kolumn, zmiana typów, usuwanie kolumn, to domena polecenia ALTER TABLE. To jest tzw. DDL (Data Definition Language). Natomiast INSERT należy do DML (Data Manipulation Language), czyli tej części SQL, która operuje na danych: INSERT, UPDATE, DELETE, SELECT. Jeśli próbujemy INSERT-em „dodać pole”, to tak jakby śrubokrętem próbować wbijać gwóźdź – czasem coś się tam stanie, ale to w ogóle nie to narzędzie.
Częstym nieporozumieniem jest też mylenie INSERT i UPDATE. UPDATE służy do aktualizacji istniejących rekordów, czyli zmiany wartości w wierszach, które już są w tabeli. Wykorzystuje się przy tym klauzulę WHERE, żeby wskazać, które rekordy mają zostać zmodyfikowane. INSERT natomiast zawsze tworzy nowy wiersz. Jeśli ktoś uważa, że INSERT „aktualizuje rekordy określoną wartością”, to tak naprawdę opisuje działanie UPDATE. W praktyce prowadzi to do błędów typu duplikowanie danych zamiast ich poprawiania.
Moim zdaniem największy błąd myślowy polega na wrzucaniu wszystkiego, co „coś zmienia w bazie”, do jednego worka. Tymczasem w dobrze zaprojektowanym systemie bazodanowym wyraźnie rozdziela się operacje na schemacie (CREATE, ALTER, DROP) od operacji na danych (INSERT, UPDATE, DELETE). Zrozumienie tej różnicy jest kluczowe, żeby pisać poprawne i bezpieczne zapytania SQL. INSERT INTO zawsze oznacza: dodaj nowy rekord do istniejącej tabeli, z wartościami zgodnymi z jej strukturą i ograniczeniami.
Pytanie 15
Co utworzyć dla pól często wyszukiwanych lub sortowanych, aby przyspieszyć operacje na bazie?
A. klucz obcyTwoja odpowiedź
B. więzy integralności
C. osobną tabelę na te pola
D. indeksPoprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe elementy nie służą do przyspieszania wyszukiwania. Klucz obcy i więzy integralności pilnują SPÓJNOŚCI danych, a tworzenie osobnej tabeli na te pola nie przyspiesza zapytań. Operacje wyszukiwania i sortowania przyspiesza indeks.
Pytanie 16
Jaką rolę pełni kwerenda krzyżowa w bazie MS Access?
A. modyfikuje istniejące dane w tabeli
B. usuwa rekordy według kryteriów
C. prezentuje zliczone (podsumowane) wartości w układzie wierszy i kolumnTwoja odpowiedź
D. dołącza do tabeli rekordy z innej tabeli
Poprawna odpowiedź. Kwerenda krzyżowa (crosstab) w MS Access tworzy zestawienie przestawne: wartości z jednego pola stają się nagłówkami wierszy, z drugiego - nagłówkami kolumn, a na ich przecięciu pojawia się podsumowanie (np. suma lub liczba) z trzeciego pola. Dzięki temu duże dane można szybko streścić w czytelnej tabeli (np. sprzedaż wg miesiąca i produktu). To odpowiednik tabeli przestawnej z arkuszy kalkulacyjnych. Dlatego kwerenda krzyżowa prezentuje zliczone wartości w układzie wierszy i kolumn.
Pytanie 17
W języku SQL wykonano przedstawione poniżej polecenia GRANT. Kto będzie miał prawo do przeglądania danych oraz ich zmiany?
Niepoprawna odpowiedź. Analizując inne odpowiedzi, można zauważyć, że niektóre z nich nie spełniają podstawowych wymogów związanych z przydzielaniem uprawnień w bazach danych. Na przykład, stwierdzenie, że tylko Anna ma prawo do przeglądania i modyfikowania danych, jest błędne, ponieważ w przydzielonych jej uprawnieniach nie ma komendy SELECT, która jest niezbędna do przeglądania danych. Uprawnienia ALTER, CREATE i DROP, które otrzymała, dotyczą jedynie zmiany struktury bazy, a nie samego przeglądania danych, co jest kluczowe dla jej roli w systemie. Warto także zwrócić uwagę na odpowiedź mówiącą o Tomaszu i Annie. Tomasz rzeczywiście ma przydzielone uprawnienia do przeglądania i modyfikacji danych, jednak Anna nie ma uprawnienia SELECT, więc nie może przeglądać danych. Analogicznie, odpowiedź wskazująca na Tomasza i Adama również pomija fakt, że Anna nie ma dostępu do przeglądania danych, co czyni ją nieprawidłową. W kontekście przydzielania uprawnień, istotne jest zrozumienie, że dostęp do danych powinien być zgodny z rolą użytkownika oraz zadaniami, jakie ma do wykonania. Właściwe przydzielenie uprawnień jest fundamentalne w zapewnieniu bezpieczeństwa danych i ich integralności.
Pytanie 18
Jak nazywa się platforma wspierająca tworzenie oprogramowania w technologii .NET?
A. middleware
B. frameworkTwoja odpowiedź
C. eclipse
D. db2
Poprawna odpowiedź. Platforma wspierająca tworzenie oprogramowania, dostarczająca gotowy zestaw bibliotek i strukturę (jak .NET Framework), nazywa się framework. Dlatego tą platformą jest framework.
Pytanie 19
W języku SQL, w wyniku wykonania poniższego zapytania:
ALTER TABLEosobaDROP COLUMNgrupa;
A. zostanie dodana kolumna grupa
B. zostanie zmieniona nazwa tabeli na grupa
C. zostanie zmieniona nazwa kolumny na grupa
D. zostanie usunięta kolumna grupaTwoja odpowiedź
Poprawna odpowiedź. Zapytanie SQL 'ALTER TABLE osoba DROP COLUMN grupa;' jest komendą, która służy do usunięcia kolumny o nazwie 'grupa' z tabeli 'osoba'. Komenda ta wykorzystuje instrukcję ALTER TABLE, która jest standardową konstrukcją SQL używaną do modyfikacji struktury istniejącej tabeli. W kontekście baz danych, usunięcie kolumny może być nieodwracalne, co oznacza, że wszystkie dane zawarte w tej kolumnie zostaną trwale usunięte. Przykładem zastosowania tej komendy może być sytuacja, w której kolumna 'grupa' nie jest już potrzebna, na przykład, po zmianie wymagań aplikacji lub po analogicznym przekształceniu modelu danych. Zgodnie z normami SQL, aby uniknąć błędów, przed wykonaniem takiej operacji warto wykonać kopię zapasową bazy danych. Warto również pamiętać, że niektóre systemy zarządzania bazami danych mogą wymagać dodatkowych opcji, aby zrealizować tę operację, na przykład, jeśli kolumna jest kluczem obcym lub jest związana z innymi strukturami. Podsumowując, użycie tej komendy skutkuje trwałym usunięciem kolumny 'grupa' z tabeli 'osoba'.
Pytanie 20
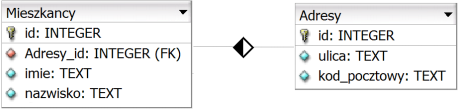
Jakie zapytanie należy zastosować, aby pokazać tylko imię, nazwisko oraz ulicę wszystkich mieszkańców?
Niepoprawna odpowiedź. Niepoprawne podejścia wynikają głównie z braku zastosowania właściwego połączenia między tabelami lub wyboru odpowiednich kolumn. Pierwszym błędem jest użycie SELECT * bez szczegółowego określenia, jakie kolumny są potrzebne. Taki zapis powoduje, że zwracane są wszystkie kolumny z obu tabel, co jest nieefektywne i niezgodne z najlepszymi praktykami, zakładającymi minimalizację przetwarzanych danych. Ponadto, wykorzystanie przecinka zamiast JOIN wprowadza niepotrzebny chaos i może prowadzić do błędów, zwłaszcza w złożonych zapytaniach, gdzie konieczne jest połączenie większej liczby tabel. Druga odpowiedź zawiera niepoprawne użycie ON, które nie jest zgodne z zasadami SQL, co powoduje błędne wyniki lub nawet awarie zapytań. Brak jest również specyfikacji kolumn, co prowadzi do zwrócenia zbyt dużej ilości danych. Dodatkowo, błędnie skonstruowane połączenie prowadzi do niepoprawnego mapowania wierszy, przez co zwracane dane nie odzwierciedlają rzeczywistych relacji między mieszkańcami a adresami. Dobre praktyki nakazują, aby zawsze używać JOIN z wyraźnym określeniem kluczy obcych i głównych, co zapewnia właściwe mapowanie wierszy i minimalizację błędów. Ważne jest również, aby każdorazowo testować zapytanie pod kątem wydajności i poprawności, a także dbać o czytelność i zrozumiałość kodu SQL, co jest kluczowe w kontekście zespołowego rozwoju oprogramowania.
Pytanie 21
SELECT AVGcena) FROM usługi; Celem użycia funkcji agregującej AVG w tym zapytaniu jest
A. zliczyć ilość dostępnych usług w tabeli
B. wyliczyć średnią arytmetyczną cen wszystkich usługTwoja odpowiedź
C. zsumować wartości kosztów wszystkich usług
D. określić najwyższą cenę usług
Poprawna odpowiedź. Odpowiedź "obliczyć średnią arytmetyczną cen wszystkich usług" jest poprawna, ponieważ funkcja AVG (average) w SQL jest zaprojektowana do obliczania średniej wartości z zestawu danych w danej kolumnie. W podanym zapytaniu, AVG(cena) ma na celu zsumowanie wartości w kolumnie 'cena' dla wszystkich wierszy w tabeli 'usługi' oraz podzielenie tej sumy przez liczbę wierszy, które zawierają dane. W praktyce, średnia arytmetyczna jest niezwykle użyteczna w analizie danych, ponieważ pozwala na uzyskanie jednego, reprezentatywnego wyniku, który może być pomocny w podejmowaniu decyzji biznesowych. Na przykład, firma usługowa może użyć tej informacji do oceny swojej polityki cenowej, porównując średnią cenę swoich usług do średnich cen konkurencji. Zgodnie z najlepszymi praktykami w branży, stosowanie funkcji agregujących takich jak AVG powinno być integralną częścią procesów analizy danych, szczególnie w kontekście raportowania i oceny efektywności operacyjnej.
Pytanie 22
$x = mysql_query('SELECT * FROM mieszkanci'); if (!$x) echo "??????????????????????????????"; W podanym kodzie PHP, w miejscu znaków zapytania powinien wyświetlić się komunikat:
A. Nieprawidłowa nazwa bazy danychTwoja odpowiedź
B. Błąd w trakcie przetwarzania zapytaniaPoprawna odpowiedź
C. Złe hasło do bazy danych
D. Zapytania zakończono sukcesem
Niepoprawna odpowiedź. Wybór niepoprawnej odpowiedzi na pytanie dotyczące komunikatu o błędzie może prowadzić do nieporozumień w kontekście działania kodu PHP. Odpowiedź wskazująca na 'Zapytania przetworzono pomyślnie' jest błędna, ponieważ jeśli mysql_query zwraca false, oznacza to, że zapytanie nie zostało wykonane poprawnie, a więc nie może być mowy o jego pomyślnym przetworzeniu. Jeżeli chodzi o 'Nieprawidłowa nazwa bazy', to również nie jest to prawidłowe stwierdzenie, ponieważ problem może wystąpić z innymi przyczynami, takimi jak błędna składnia zapytania. W przypadku, gdy nazwa bazy jest nieprawidłowa, zazwyczaj pojawia się inny rodzaj błędu. Wreszcie, 'Nieprawidłowe hasło do bazy danych' to kolejna niepoprawna odpowiedź; błąd autoryzacji związany z hasłem do bazy danych zazwyczaj skutkuje problemem z połączeniem, co nie jest bezpośrednio związane z zapytaniem SQL. Dlatego ważne jest, aby rozumieć, że problemy z połączeniem i błędy w zapytaniach SQL są różnymi kwestiami, które wymagają różnych podejść do diagnozowania oraz rozwiązywania.
Pytanie 23
Aby policzyć wszystkie wiersze w tabeli Koty, należy użyć zapytania:
A.
SELECTCOUNT(*)FROMKoty
Twoja odpowiedź
B.
SELECTCOUNT(ROWNUM)FROMKoty
C.
SELECTCOUNT(Koty)ASROWNUM
D.
SELECTROWNUM()FROMKoty
Poprawna odpowiedź. Liczbę wszystkich wierszy tabeli zwraca funkcja agregująca COUNT(*), użyta w zapytaniu SELECTCOUNT(*)FROMKoty. Gwiazdka oznacza „policz wszystkie wiersze”, niezależnie od wartości w kolumnach (także te z NULL). Dlatego poprawne jest SELECTCOUNT(*)FROMKoty.
Pytanie 24
W bazie danych samochodów pole kolor z tabeli samochody przyjmuje wartości kolorów jedynie ze słownika lakier. Aby połączyć tabele samochody i lakier relacją należy, zastosować kwerendę
A. ALTER TABLE samochody
   ADD FOREIGN KEY kolor REFERENCES lakier;

B. ALTER TABLE samochody
   ADD FOREIGN KEY (kolor) REFERENCES lakier(lakierId);

C. ALTER TABLE samochody
   ADD FOREIGN KEY barwa REFERENCES samochody.lakier;

D. ALTER TABLE lakier
   ADD FOREIGN KEY (barwa) REFERENCES samochody(kolor);
A.
C.
D.Twoja odpowiedź
B.Poprawna odpowiedź
Niepoprawna odpowiedź. Błędne odpowiedzi wynikają z niezrozumienia jak działa łączenie tabel w SQL lub z błędów w składni. W przypadku relacji między tabelami, klucz obcy w jednej tabeli odpowiada kluczowi głównemu w drugiej tabeli. Tymczasem, niektóre z błędnych odpowiedzi zawierają niewłaściwe odniesienia do kluczy głównych i obcych. Próby utworzenia klucza obcego bez odwołania do odpowiadającego mu klucza głównego, lub odwołanie się do nieistniejących pól w tabeli, skutkują błędami i niepoprawnym działaniem bazy danych. Błędy w składni SQL, takie jak niepoprawne użycie słów kluczowych czy polecenia utworzenia klucza obcego, mogą także prowadzić do nieprawidłowych wyników. Zrozumienie relacji między tabelami i prawidłowe stosowanie składni SQL są kluczowe dla efektywnej pracy z bazami danych.
Pytanie 25
Z bazy danych trzeba uzyskać zapytaniem SQL nazwiska pracowników, którzy sprawują funkcję kierownika, a ich wynagrodzenie mieści się w jednostronnie domkniętym przedziale (3000, 4000>. Która klauzula weryfikuje ten warunek?
A.
WHEREkierownik=trueORpensja>3000ORpensja<=4000
B.
WHEREkierownik=trueANDpensja=>3000ANDpensja<=4000
Twoja odpowiedź
C.
WHEREkierownik=trueANDpensja>3000ANDpensja<=4000
Poprawna odpowiedź
D.
WHEREkierownik=trueANDpensja=>3000ORpensja<4000
Niepoprawna odpowiedź. Nieprawidłowe odpowiedzi bazują na mylnych założeniach dotyczących operatorów logicznych oraz porównawczych w SQL. Przykładowo, w przypadku użycia klauzuli 'WHERE kierownik = true OR pensja > 3000 OR pensja <= 4000;' spełniony jest warunek dla każdej z trzech części, co prowadzi do zbyt szerokiego zakresu wyników. Operator OR zwraca wyniki, jeśli przynajmniej jeden z warunków jest prawdziwy, co w rezultacie może obejmować pracowników, którzy nie są kierownikami. Klauzula 'WHERE kierownik = true AND pensja => 3000 OR pensja < 4000;' również jest niepoprawna, gdyż składnia operatora => jest błędna (powinno być >=), a ponadto użycie OR sprawia, że wyniki mogą obejmować pracowników, którzy nie spełniają wymagań pensjowych. Kolejna nieadekwatna klauzula 'WHERE kierownik = true AND pensja => 3000 AND pensja < 4000;' również zawiera błąd w zapisie operatora porównania, co uniemożliwia poprawne wykonanie zapytania. Przyczyną tych błędów są często nieznajomość operatorów oraz niepoprawne rozumienie logiki zapytań SQL. W praktyce, zrozumienie różnicy pomiędzy AND a OR oraz prawidłowe stosowanie operatorów porównawczych jest kluczowe dla uzyskania oczekiwanych wyników w bazach danych. W kontekście profesjonalnego podejścia do SQL, ważne jest także, aby zapytania były nie tylko poprawne syntaktycznie, ale również semantycznie, co zapewnia ich efektywność i wiarygodność.
Pytanie 26
Tabela zwierzeta ma m.in. nazwa, gromada, dlugosc_zycia. Która kwerenda zwróci nazwy zwierząt żyjących min. 20 lat ORAZ będących ssakami?
Poprawna odpowiedź. Zadanie wymaga, by oba warunki zachodziły jednocześnie - długość życia min. 20 lat (dlugosc_zycia>=20) ORAZ przynależność do ssaków (gromada='ssak') - dlatego łączy je AND: SELECTnazwaFROMzwierzetaWHEREdlugosc_zycia>=20ANDgromada='ssak';. Dlatego ta kwerenda jest poprawna.
Pytanie 27
Które zapytanie wybierze z tabeli klient nazwiska zaczynające się na literę „Z” (o dowolnej długości)?
A.
SELECTnazwiskoFROMklientWHEREnazwiskoLIKE'Z%';
Poprawna odpowiedź
B.
SELECTnazwiskoFROMklientWHEREnazwisko='Z?';
C.
SELECTnazwiskoFROMklientWHEREnazwisko='Z_?';
Twoja odpowiedź
D.
SELECTnazwiskoFROMklientWHEREnazwiskoLIKE'Z_%';
Niepoprawna odpowiedź. Pozostałe zapytania nie zadziałają jak trzeba. Operator = porównuje DOSŁOWNIE, a 'Z?' i 'Z_?' nie są poprawnymi wzorcami SQL (znak ? nic tu nie znaczy). Wzorzec 'Z_%' zawiera _ - dokładnie jeden dowolny znak - więc wymagałby co najmniej dwóch liter i wykluczyłby samo „Z”. Pasuje tylko LIKE'Z%'.
Pytanie 28
Tworząc raport w systemie zarządzania relacyjnymi bazami danych, umożliwia się
A. analizę wybranych danychPoprawna odpowiedź
B. aktualizowanie danych w tabelachTwoja odpowiedź
C. usuwanie danych z tabel
D. dodawanie danych do tabel
Niepoprawna odpowiedź. Wykonywanie raportów w systemie obsługi relacyjnych baz danych nie polega na usuwaniu, dodawaniu ani aktualizowaniu danych. Usuwanie danych w tabelach jest operacją destrukcyjną, która trwale eliminuje informacje i nie sprzyja przechowywaniu ich do późniejszej analizy. Dodawanie danych to proces, który zwiększa objętość bazy danych, a nie koncentruje się na analizie już istniejących informacji. Z kolei aktualizacja danych polega na modyfikacji istniejących rekordów, co również nie ma bezpośredniego związku z tworzeniem raportów. Właściwe zrozumienie celu raportowania jest kluczowe dla efektywnego wykorzystania systemów bazodanowych. Często użytkownicy mylą procesy związane z utrzymywaniem baz danych z ich analizą. Dobrą praktyką jest oddzielanie operacji DML (Data Manipulation Language) od DQL (Data Query Language), które służy do analizy danych przy użyciu odpowiednich zapytań. Zastosowanie raportowania w systemach baz danych powinno być skupione na zrozumieniu i interpretacji danych, co pozwala na lepsze podejmowanie decyzji, zamiast na manipulacji danymi. Kluczowym aspektem jest umiejętność wyciągania wniosków z danych, które zostały już zgromadzone, a nie ich modyfikacja.
Pytanie 29
Poniższe zapytanie SQL ma na celu:
UPDATEUczenSETid_klasy=id_klasy+1;
A. zwiększyć o jeden wartość pola UczenTwoja odpowiedź
B. zwiększyć o jeden wartość kolumny id_klasy dla wszystkich wpisów w tabeli UczenPoprawna odpowiedź
C. ustawić wartość pola Uczen na 1
D. przypisać wartość kolumny id_klasy jako 1 dla wszystkich wpisów w tabeli Uczen
Niepoprawna odpowiedź. Wybierając błędne odpowiedzi, można wpaść w pułapki związane z interpretacją polecenia SQL. Na przykład, stwierdzenie, że polecenie zwiększa wartość pola Uczen, jest mylące, ponieważ nie odnosi się do konkretnej kolumny. W SQL każde polecenie musi być precyzyjne, a używanie ogólnych terminów prowadzi do nieporozumień. Mówiąc o "ustawieniu na 1 wartości pola Uczen", mylnie sugeruje się, że wszystkie dane są resetowane do jednej wartości, co jest całkowicie błędne w kontekście podanego polecenia. Kolejną nieprawidłową koncepcją jest pomysł, iż polecenie ustawia wartość kolumny na 1 dla wszystkich rekordów. W rzeczywistości, aktualizuje ono istniejące wartości, zwiększając je o jeden, a nie ustawia ich na stałą wartość. Takie nieprecyzyjne zrozumienie języka SQL może prowadzić do katastrofalnych skutków w praktycznych zastosowaniach baz danych, w tym do utraty danych lub niepoprawnych aktualizacji, co jest sprzeczne z dobrymi praktykami zarządzania danymi. Kluczowe jest zrozumienie, że każdy element w SQL odgrywa istotną rolę, a nieprecyzyjność prowadzi do błędów, które mogą być czasochłonne do naprawienia. Z tego powodu, w pracy z SQL, należy zwracać znaczną uwagę na szczegóły oraz logiczną strukturę zapytań.
Pytanie 30
Co oznacza termin „upload” danych?
A. pobieranie plików z serwera
B. opóźnienie w transmisji pliku
C. przesyłanie plików na serwerTwoja odpowiedź
D. trasę transferu pliku
Poprawna odpowiedź. Termin „upload” oznacza PRZESYŁANIE plików z komputera użytkownika NA serwer - np. wgranie zdjęcia czy plików witryny przez FTP. To kierunek „w górę”, do serwera. Dlatego upload to przesyłanie plików na serwer.
Pytanie 31
Aby w zapytaniu SQL połączyć dane z dwóch tabel powiązanych relacją, należy użyć słowa kluczowego:
A.
IN
B.
JOIN
Twoja odpowiedź
C.
UNION
D.
GROUPBY
Poprawna odpowiedź. Do łączenia danych z tabel powiązanych relacją służy JOIN. Złączenie dopasowuje wiersze z różnych tabel według wspólnego pola - najczęściej klucza głównego w jednej i klucza obcego w drugiej - i zwraca je jako jeden wynik. Pozwala to np. pokazać zamówienie razem z danymi klienta. Występuje w odmianach (INNER, LEFT, RIGHT), które decydują, które wiersze bez dopasowania zachować. To właśnie JOIN realizuje relacyjne połączenie tabel w zapytaniu.
Pytanie 32
Jakim systemem do zarządzania wersjami oprogramowania jest
A. Eclipse
B. FileZillaTwoja odpowiedź
C. GITPoprawna odpowiedź
D. TotalCommander
Niepoprawna odpowiedź. TotalCommander, Eclipse i FileZilla to popularne narzędzia, które służą do innych celów w procesie tworzenia oprogramowania, ale nie są systemami kontroli wersji. TotalCommander jest menedżerem plików, który ułatwia nawigację i zarządzanie plikami na komputerze, jednak nie oferuje funkcji śledzenia zmian w kodzie czy współpracy zespołowej. Eclipse to zintegrowane środowisko programistyczne (IDE), które wspiera rozwój aplikacji, ale nie pełni roli systemu kontroli wersji, chociaż może korzystać z różnych systemów kontroli wersji za pomocą odpowiednich wtyczek. FileZilla to klient FTP, który umożliwia przesyłanie plików na serwery, co również nie ma związku z kontrolą wersji. Często mylnie przyjmuje się, że narzędzia związane z zarządzaniem plikami czy programowaniem mogą zastępować systemy kontroli wersji, co jest błędnym podejściem. Systemy kontroli wersji, takie jak GIT, są zaprojektowane z myślą o zarządzaniu zmianami w kodzie źródłowym, co jest kluczowe w nowoczesnym procesie wytwarzania oprogramowania. Ignorowanie tej specyfikacji i nieodróżnianie narzędzi do zarządzania plikami od systemów kontroli wersji może prowadzić do problemów w organizacji pracy zespołu oraz utraty wydajności w projektach.
Pytanie 33
Który obiekt bazy danych służy głównie do drukowania lub wyświetlania zestawień danych?
A. raportPoprawna odpowiedź
B. moduł
C. makroTwoja odpowiedź
D. formularz
Niepoprawna odpowiedź. Pozostałe obiekty służą do czego innego. Formularz to interfejs do WPROWADZANIA danych. Makro automatyzuje czynności (np. otwarcie formularza). Moduł zawiera kod (np. w VBA). Do drukowania i wyświetlania zestawień przeznaczony jest raport.
Pytanie 34
W bazie danych produkt znajdują się artykuły wyprodukowane po 2000 roku, zawierające pola nazwa oraz rok_produkcji. Klauzula SQL wyświetli zestawienie artykułów wyprodukowanych
SELECT * FROM `produkt` WHERE SUBSTR(rok_produkcji, 3, 2) = 17;
A. po roku 2017Twoja odpowiedź
B. w latach innych niż 2017
C. w roku 2017Poprawna odpowiedź
D. przed rokiem 2017
Niepoprawna odpowiedź. To zapytanie SQL, które rozkminiamy, korzysta z funkcji SUBSTR, żeby wyrwać kawałek roku z kolumny rok_produkcji i porównać go z 17. Jasno z tego wynika, że wyciągamy dwie ostatnie cyfry, co odpowiada rokowi 2017. Dlatego odpowiedzi mówiące o innych latach są mylące. Jeśli ktoś myśli, że filtrujemy coś przed 2017, to się myli, bo zapytanie dotyczy końcówki roku, a nie pełnego roku. Są też błędne założenia, że to zapytanie pokazuje lata inne niż 2017. Dlatego warto pamiętać, że SUBSTR jasno mówi, że wybieramy lata kończące się na 17. A jeśli ktoś myśli o latach po 2017, to też jest w błędzie, bo zapytanie nie bierze pod uwagę pełnych lat, a tylko końce. Często ludzie źle interpretują takie zapytania, bo nie uwzględniają funkcji tekstowych, które zmieniają sposób filtrowania danych. Zrozumienie tych niuansów w SQL jest ważne dla przetwarzania i analizy danych. Te błędy mogą się brać z braku dokładnej analizy i zrozumienia użytych funkcji, co zdarza się często nowym użytkownikom SQL. Dobrze jest po prostu testować zapytanie i robić przeglądy kodu w zespole, co wspiera lepsze zrozumienie i użycie zapytań w praktyce.
Pytanie 35
Które z poniższych poleceń pozwala na dodanie kolumny zadanie_kompletne do tabeli zadania?
A.
ALTERTABLEzadaniaADDCOLUMNzadanie_kompletneint
Poprawna odpowiedź
B.
CREATEINDEXzadaniaADDCOLUMNzadanie_kompletneint
Twoja odpowiedź
C.
ADDCOLUMNzadanie_kompletneWITHzadania
D.
INSERTINTOzadaniaVALUESzadanie_kompletne
Niepoprawna odpowiedź. Wszystkie trzy pozostałe odpowiedzi są nieprawidłowe w kontekście dodawania nowej kolumny do tabeli. Pierwsze z zaproponowanych poleceń, które sugeruje utworzenie indeksu, jest niepoprawne, ponieważ CREATE INDEX służy do tworzenia indeksów, które poprawiają wydajność zapytań, a nie do modyfikacji struktury tabeli. Indeks może być pomocny w optymalizacji wyszukiwania danych w tabeli, jednak nie ma związku z dodawaniem nowych kolumn. Drugie polecenie, INSERT INTO, jest przeznaczone do dodawania nowych rekordów do istniejącej tabeli, a nie do modyfikacji jej struktury. To polecenie umożliwia dodawanie danych do kolumn, które już istnieją, ale nie może być użyte do dodawania nowych kolumn. Ostatnia nieprawidłowa odpowiedź dotycząca 'ADD COLUMN zadanie_kompletne WITH zadania' jest również błędna, ponieważ nie jest to poprawna składnia SQL. Nie ma polecenia 'WITH' w kontekście dodawania kolumn do tabeli; zamiast tego powinno być używane polecenie ALTER TABLE. W rezultacie, niezrozumienie celu każdego z tych poleceń może prowadzić do błędnych prób modyfikacji struktury bazy danych, co w praktyce może skutkować utratą danych lub rozczarowującymi wynikami operacji.
Pytanie 36
W języku PHPnie ma możliwości
A. zmienianie dynamiczne treści strony HTML w przeglądarcePoprawna odpowiedź
B. obróbka informacji przechowywanych w bazie danych
C. przetwarzanie danych z formularzy
D. tworzenie dynamicznej zawartości strony internetowejTwoja odpowiedź
Niepoprawna odpowiedź. Pomimo powszechnej wiedzy o zastosowaniach PHP, istnieje pewne nieporozumienie dotyczące jego funkcji w kontekście dynamicznych zmian na stronach internetowych. PHP jest używane do przetwarzania danych po stronie serwera, co oznacza, że jego zadaniem jest generowanie treści, które są następnie wysyłane do przeglądarki użytkownika. Pierwsza z niepoprawnych odpowiedzi sugeruje, że PHP może przetwarzać dane zgromadzone w bazie danych, co jest prawdą, jednak nie odnosi się do sedna pytania. PHP efektywnie współpracuje z bazami danych za pomocą zapytań SQL, ale to, co jest zwracane, to statyczny kod HTML. W kontekście generowania dynamicznej zawartości strony, PHP może być użyte do stworzenia HTML, ale nie do jego późniejszej modyfikacji w przeglądarce. Odpowiedź dotycząca generowania dynamicznej zawartości nie uwzględnia, że zmiany te są wynikiem działania PHP przed wysłaniem danych do klienta. Kolejna odpowiedź, sugerująca, że PHP może bezpośrednio zmieniać HTML w przeglądarkach, myli funkcjonalności języka. Nowoczesne aplikacje webowe często wykorzystują JavaScript do interakcji z użytkownikiem po załadowaniu strony, co pozwala na dynamiczne zmiany bez konieczności ponownego ładowania strony. Również przetwarzanie danych formularzy jest zadaniem, które PHP wykonuje, ale dotyczy to głównie zbierania i przesyłania danych do serwera, a nie modyfikacji treści na stronie po jej załadowaniu. Podsumowując, kluczowym aspektem jest zrozumienie, że PHP jest językiem po stronie serwera, a wszelkie dynamiczne interakcje w przeglądarkach powinny być zarządzane za pomocą technologii klienckich, takich jak JavaScript, co jest zgodne z aktualnymi standardami tworzenia aplikacji webowych.
Pytanie 37
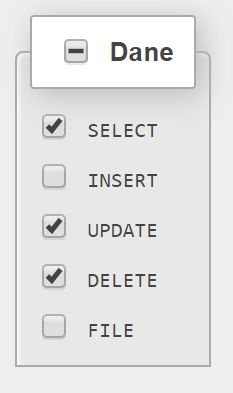
Z ilustracji można odczytać, że użytkownik bazy danych posiada uprawnienia do:
A. dodawania, aktualizacji i usuwania danych.Twoja odpowiedź
B. wyświetlania, aktualizacji i usuwania danych.Poprawna odpowiedź
C. wyświetlania, dodawania i usuwania danych.
D. wyświetlania, dodawania i aktualizacji danych.
Niepoprawna odpowiedź. Na ilustracji pokazano panel nadawania uprawnień do operacji na danych w bazie. Każda z widocznych opcji odpowiada konkretnemu typowi polecenia SQL: SELECT to odczyt danych, INSERT to wstawianie nowych rekordów, UPDATE to modyfikacja istniejących wierszy, a DELETE to ich usuwanie. Typowym błędem jest mechaniczne kojarzenie „pracy na danych” tylko z dodawaniem i usuwaniem, bez zwrócenia uwagi na to, które pola są naprawdę zaznaczone. Na obrazku INSERT nie jest zaznaczony, więc użytkownik nie może dodawać nowych rekordów. Jeśli ktoś wybrał odpowiedź zawierającą „dodawanie danych”, to prawdopodobnie założył, że skoro użytkownik ma prawo zmieniać i kasować dane, to na pewno może też je dodawać. W praktyce w administracji bazą to tak nie działa – każde z tych uprawnień jest rozdzielone i może być nadawane osobno. Innym typowym nieporozumieniem jest mylenie UPDATE z INSERT. UPDATE nie tworzy nowych wierszy, tylko zmienia pola w rekordach, które już istnieją. To ważne rozróżnienie, bo w wielu systemach biznesowych pracownik ma prawo poprawić dane klienta (UPDATE), ale nie może dodawać nowych klientów (INSERT). Podobnie DELETE, czyli usuwanie danych, często jest ograniczane, bo kasowanie rekordów bywa nieodwracalne albo wymaga dodatkowych procedur. Jeśli odpowiedź sugeruje, że użytkownik może dodawać dane, to stoi to w sprzeczności z tym, co realnie widać na ilustracji – brak zaznaczenia przy INSERT jasno mówi, że wstawianie nowych rekordów jest zablokowane. Warto wyrabiać sobie nawyk dokładnego czytania takiego interfejsu: sprawdzić każdy checkbox i od razu przełożyć go na konkretne operacje SQL. W codziennej pracy z bazami danych poprawne rozumienie różnicy między SELECT, INSERT, UPDATE i DELETE jest absolutną podstawą bezpiecznego projektowania uprawnień i unikania przypadkowych modyfikacji danych.
Pytanie 38
W bazie danych znajduje się tabela uczniowie, która ma kolumny: imie, nazwisko i klasa. Jakie polecenie SQL należy użyć, aby uzyskać imiona oraz nazwiska uczniów, których nazwiska zaczynają się na literę M?
Poprawna odpowiedź. Poprawne polecenie SQL to 'SELECT nazwisko, imie FROM uczniowie WHERE nazwisko LIKE 'M%';'. Operator LIKE jest kluczowym elementem języka SQL, który pozwala na wyszukiwanie danych zgodnych z określonym wzorem, gdzie '%' oznacza dowolny ciąg znaków. Użycie tego operatora jest zgodne z najlepszymi praktykami w zakresie wyszukiwania danych w relacyjnych bazach danych, umożliwiając elastyczne filtrowanie wyników. W kontekście tego zapytania, operator LIKE skutecznie identyfikuje wszystkie nazwiska, które zaczynają się na literę 'M', co jest szczególnie przydatne w sytuacjach wymagających poszukiwania danych spełniających określone kryteria. Przykładem zastosowania tego zapytania może być generowanie raportów dla nauczycieli, którzy chcą zobaczyć listę uczniów w określonej klasie. Dodatkowo, warto pamiętać, że w przypadku wielu baz danych, operator LIKE jest również wrażliwy na wielkość liter, dlatego warto dostosować zapytanie w zależności od kontekstu, w jakim pracujemy.
Pytanie 39
W zamieszczonym kodzie PHP, który łączy się z serwerem bazy danych, jakie działania powinny być umieszczone w instrukcji warunkowej w miejscu trzech kropek?
$db = mysqli_connect("localhost","root","qwerty","baza1"); if ( !$db ) { ... }
A. Informacja o udanym połączeniu z bazą
B. Zamknięcie połączenia z bazą danychTwoja odpowiedź
C. Zarządzanie błędem połączeniaPoprawna odpowiedź
D. Przetwarzanie danych otrzymanych z bazy
Niepoprawna odpowiedź. Wykonywanie operacji na źle zestawionym połączeniu z bazą danych mogłoby prowadzić do nieprzewidywalnych zachowań aplikacji. Próba obsługi danych pobranych z bazy kiedy połączenie nie zostało nawiązane jest błędnym podejściem. Bez prawidłowego połączenia nie można pobrać danych dlatego nie ma sensu implementowanie takiej logiki w tym miejscu kodu. Podobnie komunikat o pomyślnym połączeniu nie znajduje uzasadnienia w konstrukcji warunku sprawdzającego nieudane połączenie. Jeśli warunek jest spełniony oznacza to że połączenie się nie powiodło i należy podjąć kroki w celu obsługi tego błędu a nie informować o sukcesie. Zamknięcie połączenia z bazą danych jest czynnością wykonywaną na końcu pracy z bazą a nie na początku co również czyni tę odpowiedź niepoprawną w kontekście błędnego nawiązywania połączenia. Dobre praktyki programistyczne wskazują na potrzebę właściwego zarządzania połączeniami do bazy danych co obejmuje ich otwieranie dopiero gdy są potrzebne i zamykanie gdy nie są już używane. Koncepcje błędnego umiejscowienia tych operacji w logice aplikacji mogą prowadzić do nieskuteczności i obniżenia wydajności aplikacji co podkreśla wagę poprawnego zrozumienia procesu nawiązywania połączeń z bazą danych.
Pytanie 40
Aby utworzyć tabelę w relacyjnej bazie danych, należy zastosować polecenie SQL CREATETABLE:
A.
NEWTABLE
B.
CREATETABLE
Twoja odpowiedź
C.
PLUSTABLE
D.
ADDTABLE
Poprawna odpowiedź. Tabelę tworzy instrukcja CREATETABLE, należąca do języka definiowania danych (DDL) w SQL. Definiujesz w niej nazwę tabeli oraz listę kolumn wraz z ich typami danych, a opcjonalnie dodajesz ograniczenia, takie jak klucz główny czy NOTNULL. Najprostsza składnia to CREATETABLEnazwa(kolumnatyp);, na przykład CREATETABLEpracownicy(idINTPRIMARYKEY,nazwiskoVARCHAR(50));. Polecenie jest częścią standardu SQL, więc działa w większości systemów bazodanowych (MySQL, PostgreSQL, SQLite, SQL Server) i to właśnie ono buduje strukturę, do której później wstawiasz dane.