Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 21 września 2026 10:08
Zakończenie: 21 września 2026 10:18
Egzamin zdany!
Wynik: 20/40 punktów (50,0%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 18% podejść do kwalifikacji INF.04.
Porównanie z 23130 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
W jakiej topologii sieciowe wszystkie urządzenia są bezpośrednio powiązane z każdym innym?
A. Topologia siatkiTwoja odpowiedź
B. Topologia pierścienia
C. Topologia gwiazdy
D. Topologia magistrali
Poprawna odpowiedź. Topologia siatki to jedna z najbardziej wydajnych i wszechstronnych struktur sieciowych, w której każde urządzenie (węzeł) jest połączone bezpośrednio z każdym innym węzłem. Tego typu topologia zapewnia wysoką dostępność i odporność na awarie, ponieważ awaria jednego połączenia nie wpływa na komunikację pozostałych węzłów. W praktyce ma to zastosowanie w dużych, zaawansowanych sieciach komputerowych, takich jak sieci miejskie (MAN) czy sieci szerokopasmowe. Istnieją dwie główne formy topologii siatki: siatka pełna, gdzie każde urządzenie ma bezpośrednie połączenia z wszystkimi innymi, oraz siatka częściowa, gdzie nie wszystkie węzły są ze sobą bezpośrednio połączone, ale komunikacja jest możliwa przez inne węzły. Topologia siatki, z uwagi na swoje zalety, jest często wykorzystywana w standardach sieciowych, takich jak Ethernet, oraz w systemach rozproszonych, gdzie kluczowe są niezawodność i efektywność przesyłania danych. Dodatkowo, w kontekście Internetu rzeczy (IoT), topologia siatki umożliwia efektywne zarządzanie dużą liczbą urządzeń, co jest kluczowe w inteligentnych miastach i automatyzacji domowej.
Pytanie 2
Który z objawów może sugerować zawał serca?
A. Intensywny ból w klatce piersiowej promieniujący do lewej rękiTwoja odpowiedź
B. Gorączka oraz dreszcze
C. Ból brzucha po spożyciu posiłku
D. Spadek nastroju
Poprawna odpowiedź. Silny ból w klatce piersiowej promieniujący do lewej ręki to klasyczny objaw zawału serca (ostrego zespołu wieńcowego). Ból ten często pojawia się nagle, jest intensywny, gniotący lub piekący i może towarzyszyć mu duszność, zawroty głowy, zimne poty i nudności. Zawał serca wynika z zablokowania jednej z tętnic wieńcowych, co prowadzi do niedokrwienia mięśnia sercowego. Szybka reakcja i wezwanie pomocy medycznej mogą uratować życie i zminimalizować uszkodzenia serca. Każda minuta jest kluczowa – nie należy czekać na ustąpienie objawów, lecz natychmiast zadzwonić na numer alarmowy 112 lub udać się do najbliższego szpitala.
Pytanie 3
Przedstawiony na filmie kod napisany w języku C++ nie kompiluje się. Co należy zmienić w tym kodzie, aby proces kompilacji wykonał się bez błędów?
A. naprawić błąd w funkcji sprawdz, który polega na braku nawiasów {} w pętli for
B. dodać deklarację funkcji sprawdz przed funkcją mainPoprawna odpowiedź
C. zadeklarować zmienną sprawdz przed jej wykorzystaniem w linii 11Twoja odpowiedź
D. poprawnie zapisać warunek w instrukcji if w linii 11, np. sprawdz(x)==true
Niepoprawna odpowiedź. Wielu początkujących programistów skupia się na szczegółach składniowych lub drobiazgach logicznych, kiedy pojawia się błąd kompilacji w C++. Jednak często przyczyną jest coś bardzo podstawowego, jak brak deklaracji funkcji przed jej użyciem. Jeśli chodzi o zapis warunku w instrukcji 'if', to kompilator nie zgłasza błędu, gdy używamy wyrażenia typu 'if (sprawdz(x))' – to całkowicie poprawna składnia, a dopisywanie '==true' jest redundantne i nie wnosi niczego nowego. Bardzo często widzę, że ktoś skupia się na tym, żeby warunek koniecznie porównywać do true, ale tak naprawdę to kwestia stylu, nie poprawności. Pozostawienie nawiasów klamrowych w pętli for jest oczywiście dobrą praktyką, ale ich brak nie zawsze generuje błąd kompilacji, jeśli pętla ma tylko jedną instrukcję. Kompilator C++ potrafi to rozpoznać i nie zgłasza błędu – sprowadza się to bardziej do czytelności i unikania błędów logicznych niż do samej poprawności kompilacji. Odpowiedź dotycząca deklarowania zmiennej 'sprawdz' to już nieporozumienie – 'sprawdz' to funkcja, a nie zmienna, więc nie deklarujemy jej w ten sposób. Ten błąd pokazuje, jak łatwo pomylić pojęcia w językach programowania, zwłaszcza jeśli dopiero zaczynamy przygodę z kodowaniem. Główna zasada, którą warto tu zapamiętać, to: każda funkcja używana przed jej zdefiniowaniem musi być zadeklarowana – to właśnie tego brakuje w typowym przykładzie z pytania. Bez deklaracji kompilator nie wie, jaką sygnaturę ma funkcja, a to skutkuje błędem już na poziomie kompilacji. Z mojego doświadczenia wynika, że takie drobne rzeczy potrafią skutecznie utrudnić życie, dlatego warto czytać komunikaty kompilatora i znać podstawowe zasady działania języka C++.
Pytanie 4
Co to jest JWT (JSON Web Token)?
A. Format kompresji danych JavaScript i HTML w aplikacjach webowych
B. Protokół transferu plików JSON między serwerami
C. Biblioteka JavaScript do manipulacji danymi JSON
D. Otwarty standard do bezpiecznego przekazywania danych w formacie JSONTwoja odpowiedź
Poprawna odpowiedź. JWT (JSON Web Token) to otwarty standard, który pozwala na bezpieczne przesyłanie danych między stronami jako obiekt JSON. Token ten składa się z trzech części: nagłówka (header), ładunku (payload) oraz podpisu (signature). Nagłówek określa typ tokenu i używany algorytm szyfrowania, ładunek zawiera dane, które chcemy przekazać, a podpis zapewnia integralność i autentyczność danych. JWT jest powszechnie wykorzystywany w autoryzacji i wymianie informacji między serwerem a klientem, na przykład w aplikacjach webowych, gdzie po zalogowaniu użytkownik otrzymuje token, który może być użyty do uzyskania dostępu do chronionych zasobów. Dzięki temu mechanizmowi, serwer nie musi przechowywać sesji, co zwiększa jego wydajność. Ważnym aspektem JWT jest jego bezstanowość oraz możliwość łatwego skalowania aplikacji, co czyni go popularnym rozwiązaniem w architekturze mikroserwisów. Dobrą praktyką jest stosowanie JWT w połączeniu z HTTPS, aby zapewnić dodatkową warstwę bezpieczeństwa przy przesyłaniu tokenów.
Pytanie 5
Jakie jest podstawowe działanie w ochronie miejsca zdarzenia?
A. Zagwarantowanie odpowiedniego oświetlenia
B. Usunięcie niebezpiecznych przedmiotów z otoczeniaTwoja odpowiedź
C. Zagwarantowanie stabilności ciała rannego
D. Zastosowanie sterylnych materiałów opatrunkowych
Poprawna odpowiedź. Z mojego doświadczenia, usunięcie niebezpiecznych rzeczy z miejsca, gdzie doszło do wypadku, to naprawdę kluczowa sprawa. Dzięki temu zmniejszamy szanse na dodatkowe obrażenia i możemy lepiej pomóc poszkodowanemu, nie narażając siebie na ryzyko. Na przykład, warto odsunąć ostre narzędzia, wyłączyć działające maszyny czy podnieść ciężkie przedmioty, które mogłyby kogoś zranić. Takie działania są istotne w każdej sytuacji, czy to wypadek na drodze, czy w pracy.
Pytanie 6
Jakie oprogramowanie służy jako przykład programu do komunikacji audio-wideo?
A. Google Drive
B. Notion
C. Microsoft TeamsTwoja odpowiedź
D. Slack
Poprawna odpowiedź. Microsoft Teams to naprawdę fajne narzędzie do komunikacji. Łączy w sobie czat, wideo i audio, więc wszystko masz w jednym miejscu. Zostało stworzone przez Microsoft, żeby ułatwić współpracę w zespołach. To idealne, gdy trzeba prowadzić spotkania online z kilkoma osobami. Myślę, że to super rozwiązanie dla firm, które pracują zdalnie. Dzięki WebRTC jakość transmisji audio i wideo jest naprawdę wysoka. Można w nim organizować spotkania, webinary, a nawet stworzyć przestrzeń dla zespołów projektowych, gdzie można dzielić się plikami i prowadzić dyskusje. A jak jeszcze połączysz go z innymi aplikacjami Microsoft 365, jak OneNote czy SharePoint, to masz pełny zestaw do zarządzania projektami. Dobrze też, że Microsoft Teams dba o ochronę danych osobowych, więc jest bezpieczny dla różnych organizacji.
Pytanie 7
Co oznacza operator '===' w JavaScript?
A. Porównanie wartości i typówTwoja odpowiedź
B. Przypisanie wartości
C. Porównanie wartości
D. Konkatenacja stringów
Poprawna odpowiedź. Operator '===' w JavaScript jest używany do porównania wartości oraz ich typów. To znaczy, że aby dwa elementy uznano za równe, muszą mieć zarówno tę samą wartość, jak i ten sam typ. Przykładowo, porównanie liczby 5 i stringa '5' zwróci false, ponieważ różnią się typem. Używanie '===' jest zalecane w dobrych praktykach programistycznych, ponieważ eliminuje niejednoznaczności związane z równością luźną (operator '=='), która może prowadzić do nieprzewidywalnych wyników. Na przykład, '5' == 5 zwróci true, co może być mylące. Dlatego w sytuacjach, gdzie zależy nam na ścisłym porównaniu, powinno się zawsze stosować '===' dla jasności kodu i uniknięcia błędów. W kontekście profesjonalnego programowania, korzystanie z '===' zapewnia lepszą kontrolę typów danych, co jest kluczowe w większych projektach, gdzie błędy typów mogą prowadzić do poważnych problemów z debugowaniem i utrzymywaniem kodu.
Pytanie 8
Jaki rodzaj testów można scharakteryzować przedstawionym opisem?
Nazwa
Opis
Czynności
Po teście
Formularz osobowy
Sprawdzenie odpowiedzi formularza na błędy użytkownika
1. czy wpisano wszystkie wymagane pola? 2. czy e-mail zawiera znak @? 3. czy nr telefonu zawiera cyfry, zgodnie ze wzorcem? 4. czy jest zgoda na przetwarzanie danych?
Usunąć z bazy danych wpisane podczas testowania osoby
A. testy wydajnościowe
B. testy zgodnościTwoja odpowiedź
C. testy funkcjonalnePoprawna odpowiedź
D. testy jednostkowe
Niepoprawna odpowiedź. Wiele osób myli tu pojęcia i sądzi, że sprawdzanie formularza pod kątem walidacji danych to np. testy jednostkowe albo wydajnościowe. Moim zdaniem to typowy błąd wynikający z mylenia poziomów testowania albo niezrozumienia celów tych testów. Testy wydajnościowe koncentrują się na tym, ile system „wytrzyma” – chodzi o liczbę użytkowników, czas odpowiedzi czy zużycie zasobów, a nie o to, czy pola są dobrze sprawdzane. Testy jednostkowe z kolei dotyczą poszczególnych fragmentów kodu, takich jak pojedyncze funkcje czy metody – ich zadaniem jest wyłapywanie błędów logicznych w kodzie, ale nie sprawdzają one całościowego działania funkcji biznesowej z perspektywy użytkownika. Testy zgodności są czymś innym – mają na celu zweryfikowanie, czy system spełnia wymagania formalne, normy prawne albo branżowe standardy (np. czy spełnia RODO, WCAG itp.), a nie typowe błędy użytkownika. W praktyce, jeśli ktoś wskazuje na któryś z tych rodzajów testów w kontekście walidacji formularza, to pewnie wynika to z niejasnego rozróżniania, co jest funkcjonalnością, a co technicznym aspektem systemu. Warto pamiętać, że testy funkcjonalne zawsze dotyczą sprawdzenia, czy konkretny fragment oprogramowania robi dokładnie to, czego oczekuje użytkownik – nie mniej, nie więcej. To najbardziej „namacalne” z testów, bo pozwalają sprawdzić realne scenariusze użycia, często takie, które znajdą się później w rękach klientów. I to właśnie dlatego są kluczowe przy testowaniu formularzy czy innych elementów interfejsu.
Pytanie 9
W przedstawionej ramce znajduje się fragment opisu metody compile języka Java wykorzystywanej w kontekście wyrażeń regularnych. Który symbol powinien być użyty, aby znaleźć dopasowanie na końcu tekstu?
Metacharacter
Description
|
Find a match for any one of the patterns separated by | as in: cat|dog|fish
.
Find just one instance of any character
^
Finds a match as the beginning of a string as in: ^Hello
$
Finds a match at the end of the string as in: World$
\d
Find a digit
\s
Find a whitespace character
\b
Find a match at the beginning of a word like this: \bWORD, or at the end of a word like this: WORD\b
\uxxxx
Find the Unicode character specified by the hexadecimal number xxxx
Źródło https://www.w3schools.com/java/java_regex.asp dostęp 20.08.2020
A. |
B. ^
C. .Twoja odpowiedź
D. $Poprawna odpowiedź
Niepoprawna odpowiedź. Zastosowanie różnych metaznaków w wyrażeniach regularnych jest kluczowe dla poprawnego przetwarzania tekstu. Znak ^ jest używany do dopasowania wzorca na początku ciągu znaków, co oznacza, że jest przeciwny do znaku dolara używanego na końcu. Jest przydatny w sytuacjach, gdy chcemy upewnić się, że ciąg znaków zaczyna się od określonego wzorca, co nie odpowiada założeniom pytania dotyczącego końca tekstu. Metaznak kropki . w wyrażeniach regularnych reprezentuje dowolny pojedynczy znak. Użycie go do dopasowania końca ciągu byłoby nieprawidłowe, ponieważ dopasowuje on jedynie jeden dowolny znak, bez względu na jego pozycję w tekście. Z kolei znak pionowej kreski | jest operatorem alternatywy, który umożliwia dopasowanie jednego z kilku podanych wzorców. Jest to przydatne, gdy istnieje wiele możliwych dopasowań, ale nie spełnia zadania, jeśli chcemy dokładnie określić pozycję końcową wzorca. Typowymi błędami jest mylenie tych metaznaków z ich funkcjami, co prowadzi do niepoprawnego zrozumienia struktury wyrażenia regularnego. Zrozumienie ich poprawnego użycia jest kluczowe w kontekście przetwarzania danych i walidacji tekstu, gdzie precyzyjne dopasowanie wzorców jest niezbędne, aby zapewnić integralność i dokładność przetwarzanych informacji. Aby uniknąć błędów, konieczne jest głębokie zrozumienie, jak każdy z tych metaznaków wpływa na wyniki wyrażeń regularnych oraz ich zastosowanie w praktycznych scenariuszach programistycznych. Dlatego ważne jest, aby dokładnie przeanalizować wymagania zadania i wybrać odpowiedni metaznak zgodny z oczekiwanym rezultatem końcowym.
Pytanie 10
Która z metod zarządzania projektami stawia na przejrzystość oraz wizualizację bieżących zadań?
A. WaterfallTwoja odpowiedź
B. Scrum
C. Agile
D. KanbanPoprawna odpowiedź
Niepoprawna odpowiedź. Scrum to metoda iteracyjna, która koncentruje się na sprintach i dostarczaniu działającego produktu w krótkich cyklach, ale nie skupia się na wizualizacji pracy na poziomie takim jak Kanban. Agile to ogólna filozofia zarządzania projektami, która obejmuje różne metodyki (w tym Scrum i Kanban), ale nie koncentruje się wyłącznie na wizualizacji. Waterfall to model sekwencyjny, gdzie prace realizowane są etapami, a transparentność nie jest kluczowym elementem tego podejścia, ponieważ każda faza musi zostać zakończona przed rozpoczęciem kolejnej.
Pytanie 11
Na jakim etapie cyklu życia projektu tworzony jest szczegółowy opis wymagań funkcjonalnych oraz niefunkcjonalnych?
A. Wdrożenie
B. AnalizaPoprawna odpowiedź
C. WeryfikacjaTwoja odpowiedź
D. Planowanie
Niepoprawna odpowiedź. Często spotykam się z przekonaniem, że szczegółowy opis wymagań powstaje dopiero na etapie wdrożenia, weryfikacji czy planowania. Takie podejście prowadzi jednak do poważnych problemów w projektach IT. Jeśli wychodzimy z założenia, że podczas wdrożenia będziemy zbierać wymagania, to praktycznie ryzykujemy totalnym chaosem – na tym etapie powinno się już tylko realizować to, co wcześniej uzgodniono, a nie ustalać, co właściwie ma powstać. Weryfikacja natomiast dotyczy testowania i sprawdzania, czy efekt końcowy spełnia wymagania, ale testować można tylko to, co zostało jasno zdefiniowane wcześniej. Często popełnianym błędem jest też mylenie planowania z analizą – owszem, w planowaniu określa się harmonogram, kosztorys i podział zadań, ale bez rzetelnej analizy nie wiadomo, co de facto planować. Niestety, wielu początkujących myśli, że szczegóły funkcjonalne i niefunkcjonalne wymyśla się na bieżąco, co jest prostą drogą do konfliktów z klientem i niekończących się poprawek. Standardy branżowe, takie jak PMBOK czy Agile, jasno opisują, że analiza wymagań to fundament każdego projektu. Przełożenie tego na praktykę jest proste: najpierw dokładnie rozkładamy temat na czynniki pierwsze, a dopiero potem przechodzimy do planowania, implementacji i testów. Takie podejście naprawdę ratuje skórę w poważniejszych przedsięwzięciach.
Pytanie 12
Który z wymienionych składników charakteryzuje się typowym wystąpieniem w diagramie Gantta?
A. Model relacji pomiędzy tabelami w bazie danych
B. Oś czasu oraz przedziały czasowe dla zadańPoprawna odpowiedź
C. Wykaz błędów w projekcieTwoja odpowiedź
D. Wykaz użytkowników w systemie
Niepoprawna odpowiedź. Lista błędów w projekcie to część dokumentacji jakościowej, ale nie jest elementem diagramu Gantta. Model relacji między tabelami w bazie danych (ERD) przedstawia zależności między danymi, ale nie odnosi się do zarządzania harmonogramem zadań. Lista użytkowników w systemie to element dokumentacji operacyjnej, a nie narzędzie do wizualizacji czasu trwania i postępu prac w projekcie.
Pytanie 13
Co będzie wynikiem wykonania poniższego kodu w języku C#?
Niepoprawna odpowiedź. Wynikiem wykonania kodu nie jest 'HELLO WORLD', a przyczyna tego nieporozumienia tkwi w sposobie przetwarzania tekstu. Warto zauważyć, że kod nie wykonuje prostej konwersji wszystkich liter na wielkie, jak sugeruje ta odpowiedź. Zamiast tego, każda pierwsza litera każdego słowa jest zmieniana na wielką, a pozostałe litery pozostają w oryginalnym stanie, co w przypadku 'hello world' daje wyrażenie 'Hello World'. To zrozumienie jest kluczowe w programowaniu, ponieważ często błędnie zakładamy, że transformacje na tekstach działają w sposób jednorodny. Inną niepoprawną odpowiedzią jest 'helloworld', która również pomija konwersję pierwszych liter na wielkie, co jest kluczowym aspektem działania kodu. Warto rozważyć, że przy pracy z tekstami w C# istotne są szczegóły, takie jak wielkość liter, a dobre praktyki programistyczne wymagają zrozumienia, jak funkcje manipulujące tekstem działają. Niepoprawne odpowiedzi często wynikają z niezrozumienia schematu, jakim jest łączenie, a nie tylko konwersji liter. Użytkownicy powinni zawsze testować swoje założenia poprzez praktyczne próby w kodowaniu, aby unikać takich nieporozumień.
Pytanie 14
Który wzorzec projektowy jest najlepszy do zarządzania tworzeniem obiektów?
A. Observer
B. Decorator
C. Adapter
D. Factory MethodTwoja odpowiedź
Poprawna odpowiedź. Wzorzec projektowy Factory Method jest kluczowym rozwiązaniem w kontekście zarządzania tworzeniem obiektów. Jego głównym celem jest oddzielenie procesu tworzenia obiektów od ich używania, co zwiększa elastyczność i łatwość w rozszerzaniu aplikacji. Factory Method pozwala na definiowanie interfejsu do tworzenia obiektów, ale pozostawia decyzję o tym, które klasy instancjonować, pod kontrolą podklas. Dzięki temu można łatwo wprowadzać nowe typy obiektów bez modyfikowania kodu klienckiego. Przykładem zastosowania tego wzorca może być system zarządzania dokumentami, gdzie różne typy dokumentów (np. PDF, DOCX) są tworzone przez różne fabryki, ale użycie tych obiektów odbywa się w jednolity sposób. W praktyce stosowanie wzorca Factory Method wspiera zasady SOLID, w szczególności zasadę otwartego-zamkniętego, co sprzyja utrzymywaniu i rozwijaniu systemu zgodnie z najlepszymi praktykami inżynierii oprogramowania.
Pytanie 15
Które z wymienionych oznaczeń wskazuje na liniową złożoność algorytmu?
A. O(n²)
B. O(log n)
C. O(n)Twoja odpowiedź
D. O(1)
Poprawna odpowiedź. Złożoność O(n) oznacza liniową zależność czasu wykonania algorytmu od rozmiaru danych wejściowych. Oznacza to, że dla każdego dodatkowego elementu algorytm wykonuje jedną dodatkową operację. Algorytmy liniowe są jednymi z najczęściej stosowanych w praktyce, ponieważ oferują dobrą równowagę między szybkością a złożonością implementacji. Przykłady algorytmów o złożoności O(n) to przeszukiwanie liniowe (Linear Search), sumowanie elementów tablicy oraz niektóre algorytmy sortowania, takie jak Counting Sort dla określonych warunków. Liniowa złożoność czyni te algorytmy bardzo efektywnymi przy przetwarzaniu dużych zbiorów danych.
Pytanie 16
Jakie znaczenie ma przystosowanie interfejsu użytkownika do różnych platform?
A. Umożliwia skoncentrowanie się wyłącznie na funkcjonalności aplikacji
B. Gwarantuje optymalne korzystanie z aplikacji na każdym urządzeniuTwoja odpowiedź
C. Pozwala na unifikację kodu niezależnie od używanej platformy
D. Usuwa konieczność testowania na różnych platformach
Poprawna odpowiedź. Dostosowanie interfejsu do różnych urządzeń to naprawdę ważna sprawa, żeby wszystko działało jak należy. Aplikacje, które dobrze się przystosowują do różnych ekranów czy systemów, dają lepsze doświadczenie użytkownikom. Użycie takich technik jak responsywny design czy elastyczne układy, jak flexbox czy grid, to super pomysł. Dzięki temu elementy interfejsu same się skalują, a aplikacja wygląda spójnie na telefonach, tabletach i komputerach. Nie ma nic gorszego niż chaotyczny interfejs na różnych urządzeniach, więc to naprawdę kluczowa kwestia.
Pytanie 17
Metoda przeszukiwania w uporządkowanych tablicach, która polega na podzieleniu tablicy na kilka części i wykonywaniu wyszukiwania liniowego tylko w tej części, gdzie może znajdować się poszukiwany element, w języku angielskim jest określana jako
A. Binary search
B. Exponential search
C. Jump searchTwoja odpowiedź
D. Ternary search
Poprawna odpowiedź. Jump search to faktycznie ta metoda, która polega na przeszukiwaniu uporządkowanej tablicy przez podział jej na bloki o określonej długości (zazwyczaj o rozmiarze pierwiastka kwadratowego z n, gdzie n to liczba elementów w tablicy). Najpierw skaczemy po tych blokach, żeby szybko ograniczyć obszar poszukiwań, a potem wykonujemy liniowe przeszukiwanie już tylko w wybranym przedziale. To sprawia, że jump search jest czymś pomiędzy wyszukiwaniem liniowym a binarnym – daje przyzwoity kompromis między prostotą a wydajnością, szczególnie gdy dostęp do pamięci jest kosztowny albo tablica jest zbyt duża, by od razu dzielić ją na pół jak w binary search. W praktyce jump search czasem się wykorzystuje tam, gdzie dane są przechowywane na przykład na dyskach magnetycznych czy SSD, a koszt losowego odczytu jest znacznie wyższy od odczytu sekwencyjnego. To jest też niezła opcja, gdy masz narzucone ograniczenia na algorytmy lub nie możesz sobie pozwolić na pełne binarne wyszukiwanie z różnych powodów technicznych. Warto też zauważyć, że jump search dobrze ilustruje ogólną ideę ograniczania przestrzeni poszukiwań bez konieczności przechodzenia przez wszystkie elementy – czyli bardzo praktyczne podejście, które daje się rozwinąć w innych algorytmach. Szczerze? Moim zdaniem, każdy, kto myśli o optymalizacji prostych operacji na dużych zbiorach danych, powinien przynajmniej raz przetestować jump search na własnych danych – efekty bywają zaskakująco dobre, zwłaszcza przy większych strukturach.
Pytanie 18
W przypadku przedstawionych kodów źródłowych, które są funkcjonalnie równoważne, wartość, która zostanie zapisana w zmiennej b po wykonaniu operacji, to
Python:
C++ / C# / Java:
x = 5.96; b = int(x);
double x = 5.96; int b = (int)x;
A. 6
B. 596Twoja odpowiedź
C. 5.96
D. 5Poprawna odpowiedź
Niepoprawna odpowiedź. Różnice między językami programowania w obszarze typów danych mogą czasem wprowadzać w błąd. W Twoim przypadku, patrząc na liczbę 5.96, można by pomyśleć, że różne języki zaokrąglają liczby zmiennoprzecinkowe różnie. Ale w praktyce, w większości języków, jak Python czy C++, konwersja liczby zmiennoprzecinkowej na całkowitą poprzez rzutowanie lub funkcję int() po prostu odcina część dziesiętną. Wartość w zmiennej b staje się 5, nawet jeśli 5.96 wygląda bardziej jak 6. Często ludzie mylą rzutowanie z funkcjami zaokrąglającymi, które działają na innej zasadzie. Żeby zaokrąglić do najbliższej liczby całkowitej użyj funkcji takich jak round() w Pythonie czy Math.round() w Javie. Rozumienie tych różnic jest istotne, żeby później nie mieć problemów z błędami logicznymi, zwłaszcza przy arytmetyce, gdzie precyzja ma znaczenie. Dobrze jest używać rzutowania tylko wtedy, kiedy utrata precyzji nie jest problemem, bo w niektórych zastosowaniach, na przykład w finansach, wybór między rzutowaniem a zaokrąglaniem może naprawdę zmienić wynik.
Pytanie 19
Co to jest algorytm QuickSort?
A. Wydajny algorytm sortowania oparty na strategii 'dziel i zwyciężaj'Twoja odpowiedź
B. Metoda kompresji danych bez strat
C. Algorytm wyszukiwania binarnego w posortowanej tablicy
D. Technika przeszukiwania grafu wszerz
Poprawna odpowiedź. Algorytm QuickSort to jeden z najbardziej popularnych i efektywnych algorytmów sortowania, który opiera się na strategii 'dziel i zwyciężaj'. W praktyce działa w ten sposób, że wybiera element zwany pivotem (osią) i dzieli zbiór na dwie części: jeden z elementami mniejszymi od pivota, a drugi z elementami większymi. Następnie rekurencyjnie sortuje te podzbiory. QuickSort jest niezwykle szybki i wydajny, zwłaszcza dla dużych zbiorów danych, a jego średnia złożoność czasowa wynosi O(n log n). Używa się go w wielu aplikacjach, gdzie istotne jest szybkie przetwarzanie danych, takich jak sortowanie list w aplikacjach webowych czy organizacja danych w bazach. Warto jednak pamiętać, że w najgorszym przypadku, gdy pivot jest źle wybierany, złożoność może wynosić O(n^2), co występuje na przykład w przypadku już posortowanej tablicy. W kontekście praktycznym, dobre praktyki obejmują dobór odpowiedniej metody wyboru pivota, co może znacznie poprawić wydajność algorytmu.
Pytanie 20
Co zostanie wyświetlone po wykonaniu poniższego kodu w języku Python?
Poprawna odpowiedź. W kodzie Python, który analizujemy, użyto funkcji map i filter, które są często stosowane w programowaniu funkcyjnym. W pierwszej części, funkcja filter filtruje elementy z listy 'data', zwracając tylko te, które są liczbami parzystymi. W tym przypadku, z listy [1, 2, 3, 4, 5] zostaną wybrane liczby 2 i 4. Następnie, funkcja map mnoży te liczby przez 2. Dla liczby 2 otrzymujemy 4, a dla liczby 4 – 8. Dlatego wynik końcowy to lista [4, 8]. W praktyce, znajomość takich konstrukcji pozwala na efektywne przetwarzanie danych i implementację bardziej złożonych algorytmów w codziennych zastosowaniach programistycznych. Korzystając z filtracji i mapowania można na przykład szybko przetwarzać dane wejściowe w aplikacjach webowych lub analizować duże zestawy danych. Ważne jest, aby pamiętać, że te techniki są bardzo przydatne w kontekście pracy z danymi i powinny być uzupełnione o umiejętność czytania i rozumienia kodu, co jest kluczowe w praktyce programistycznej.
Pytanie 21
Złośliwe oprogramowanie stworzone w celu przyznania hakerom uprawnień administracyjnych do komputera ofiary bez jej świadomości, to
A. robak
B. keylogger
C. rootkitTwoja odpowiedź
D. wirus
Poprawna odpowiedź. Rootkit to specyficzny rodzaj złośliwego oprogramowania, który został stworzony właśnie po to, żeby uzyskać i utrzymać nieautoryzowane uprawnienia administracyjne na systemie ofiary, a jednocześnie pozostać jak najbardziej niezauważonym. W praktyce, rootkit pozwala atakującemu przejąć pełną kontrolę nad komputerem – może wtedy instalować inne szkodliwe programy, kraść dane czy omijać zabezpieczenia bez wiedzy użytkownika. Co ważne, rootkity są często wykorzystywane przez cyberprzestępców do tzw. eskalacji uprawnień, czyli podniesienia poziomu dostępu z konta zwykłego użytkownika do administratora (roota), co w świecie Linuksa i Unixa jest dość powszechną strategią. Moim zdaniem, to jeden z najtrudniejszych do wykrycia typów malware – potrafi modyfikować systemowe procesy, a nawet podszywać się pod pliki systemowe, co sprawia, że standardowe antywirusy często go nie wykrywają. W branży IT mówi się wręcz o konieczności korzystania z zaawansowanych narzędzi forensics, np. rootkit detectors i regularnym monitorowaniu integralności systemu, zgodnie z zaleceniami CIS Controls. Jeśli ktoś chce się dobrze zabezpieczyć, to naprawdę warto zwracać uwagę na nieoczywiste symptomy: podejrzane procesy, zmiany w kluczowych plikach systemowych czy dziwne aktywności sieciowe. Rootkit to prawdziwy koszmar administratorów i świetny „przykład z życia” na to, jak ważna jest segmentacja uprawnień i stosowanie zasady najmniejszych uprawnień.
Pytanie 22
Co to jest dependency injection w programowaniu?
A. Technika, w której obiekt otrzymuje inne obiekty, od których zależyTwoja odpowiedź
B. Metoda projektowania interfejsu użytkownika
C. Metoda optymalizacji zapytań do bazy danych
D. Proces kompilacji kodu źródłowego do kodu maszynowego
Poprawna odpowiedź. Dependency injection (DI) to technika programowania, która polega na dostarczaniu obiektom ich zależności z zewnątrz, zamiast tworzenia ich samodzielnie wewnątrz klasy. Dzięki temu kod staje się bardziej modularny, łatwiejszy do testowania i utrzymania. Przykładem zastosowania DI jest framework Spring w języku Java, który umożliwia zarządzanie zależnościami za pomocą kontenerów IoC (Inversion of Control). Korzyści płynące z używania DI obejmują zwiększenie elastyczności oraz ułatwienie wprowadzania zmian w kodzie, ponieważ zmiany w jednej klasie nie wymagają modyfikacji innych. DI wspiera zasady SOLID, szczególnie zasadę odwrócenia zależności (Dependency Inversion Principle), co prowadzi do bardziej przejrzystego i zrozumiałego kodu. W praktyce, implementacja DI może odbywać się za pomocą konstruktorów, setterów lub interfejsów, co daje programiście wybór w doborze najodpowiedniejszej metody dla danego projektu.
Pytanie 23
Jakie są różnice między dialogiem modalnym a niemodalnym?
A. Dialog modalny umożliwia interakcję z innymi oknami aplikacji, a dialog niemodalny tego nie pozwala
B. Dialog modalny jest ograniczony wyłącznie do aplikacji konsolowych
C. Dialog modalny działa w tle, podczas gdy dialog niemodalny jest zawsze wyświetlany na pierwszym planie
D. Dialog modalny wymaga zamknięcia, aby powrócić do głównego okna aplikacji, natomiast dialog niemodalny tego nie wymagaTwoja odpowiedź
Poprawna odpowiedź. Dialog modalny to okno dialogowe, które wymaga interakcji użytkownika przed powrotem do głównego okna aplikacji. Tego rodzaju okna są często wykorzystywane do wyświetlania komunikatów, potwierdzeń lub formularzy wymagających danych wejściowych. Modalność zapewnia, że użytkownik nie może przejść do innej części aplikacji bez uprzedniego zamknięcia okna dialogowego. To rozwiązanie pomaga w wymuszeniu ważnych akcji, takich jak potwierdzenie usunięcia pliku lub zatwierdzenie płatności. Dialog niemodalny natomiast pozwala na interakcję z resztą aplikacji nawet wtedy, gdy okno dialogowe jest otwarte, co sprawdza się w mniej krytycznych sytuacjach, np. podczas wyświetlania dodatkowych opcji.
Pytanie 24
Który operator w języku C++ jest używany do uzyskiwania adresu zmiennej?
A. >
B. &Poprawna odpowiedź
C. deleteTwoja odpowiedź
D. *
Niepoprawna odpowiedź. W tym pytaniu łatwo pomylić kilka operatorów, bo w C++ symbole są krótkie i zależą od kontekstu. Symbol * bardzo często pojawia się obok wskaźników, więc uczniowie czasem zakładają, że to on pobiera adres zmiennej. Tak naprawdę * w deklaracji, na przykład int* p, oznacza zmienną wskaźnikową, a w wyrażeniu, na przykład *p, wykonuje dereferencję, czyli przejście z adresu do wartości przechowywanej pod tym adresem. To odwrotny kierunek niż pobieranie adresu. Z mojego doświadczenia ten błąd bierze się z uczenia się składni na pamięć, bez rysowania sobie relacji: zmienna, jej adres i wskaźnik. Operator > jest operatorem porównania, zwraca wynik logiczny, np. x > 5, i nie ma nic wspólnego z adresem pamięci. Może być też elementem składni szablonów, ale nadal nie służy do pobierania adresu. Słowo kluczowe delete zwalnia pamięć zaalokowaną przez new, więc dotyczy zarządzania czasem życia obiektu, a nie uzyskiwania adresu. Dobra praktyka w nowoczesnym C++ mówi, żeby rzadziej używać ręcznego new i delete, a częściej std::unique_ptr, std::shared_ptr albo zwykłych obiektów automatycznych. Adres zmiennej pobieramy operatorem &, pamiętając, że ten sam znak w innym kontekście może oznaczać referencję albo bitowy AND, więc zawsze trzeba patrzeć na całe wyrażenie, nie tylko na pojedynczy symbol.
Pytanie 25
Wartość liczby 1AF, zapisana w systemie szesnastkowym, po przeliczeniu na system dziesiętny wynosi
A. 431Poprawna odpowiedź
B. 6890
C. 257
D. 26Twoja odpowiedź
Niepoprawna odpowiedź. No, tutaj coś poszło nie tak. Wartość 6890 to chyba wynik jakiegoś błędnego przeliczenia, bo z potęgami szesnastkowymi coś się nie zgadza. Jeśli chodzi o 26, to pewnie źle poskładałeś te cyfry w liczbie szesnastkowej. A 257 to w ogóle nie to, co powinno wyjść, bo brakuje tam jakiejś cyfry w tej liczbie szesnastkowej.
Pytanie 26
Które z poniższych pojęć nie jest związane z React.js?
A. JSX
B. Hooks
C. DirectivesTwoja odpowiedź
D. Virtual DOM
Poprawna odpowiedź. Directives to pojęcie związane głównie z frameworkiem Angular, a nie z React.js. W kontekście Angular, dyrektywy są używane do rozszerzania HTML-a o nowe funkcje, co pozwala na bezpośrednią manipulację DOM-em i tworzenie niestandardowych znaczników. React.js natomiast korzysta z zupełnie innej filozofii, w której komponenty są podstawowym budulcem aplikacji. W React.js używamy JSX, co jest syntaktycznym rozszerzeniem JavaScriptu, pozwalającym na pisanie kodu w sposób przypominający HTML. Dodatkowo, React korzysta z Virtual DOM, co zwiększa wydajność poprzez minimalizację operacji na prawdziwym DOM-ie. React wprowadził także mechanizm Hooks, który pozwala na użycie stanu i efektów ubocznych w komponentach funkcyjnych, co jest istotne w nowoczesnym podejściu do tworzenia aplikacji. Zrozumienie różnic pomiędzy tymi podejściami jest kluczowe dla efektywnego korzystania z odpowiednich narzędzi w zależności od wymagań projektu.
Pytanie 27
Która z wymienionych cech dotyczy klasy statycznej?
A. Może zawierać wyłącznie statyczne pola i metodyPoprawna odpowiedź
B. Nie może zawierać ani zmiennych, ani metod
C. Może być dziedziczona przez klasy potomne
D. Jest automatycznie usuwana po zakończeniu działania programuTwoja odpowiedź
Niepoprawna odpowiedź. Klasa, która nie może zawierać zmiennych ani metod, jest w rzeczywistości pusta i nie spełnia żadnych praktycznych funkcji. Dziedziczenie klas statycznych jest niemożliwe, ponieważ nie można ich instancjonować, co eliminuje potrzebę dziedziczenia. Klasy, które są automatycznie usuwane po zakończeniu programu, to standardowe klasy, a nie klasy statyczne – proces usuwania obiektów leży w gestii destruktorów i mechanizmu garbage collection.
Pytanie 28
Jaki będzie wynik działania poniższego kodu w języku C#?
intx=5;inty=10;Console.WriteLine($"Suma {x} i {y} wynosi {x + y}");
A. Suma x i y wynosi 15Twoja odpowiedź
B. Suma 5 i 10 wynosi 15Poprawna odpowiedź
C. Suma 5 i 10 wynosi x + y
D. Error: niewłaściwa składnia
Niepoprawna odpowiedź. W przypadku błędnych odpowiedzi warto zwrócić uwagę na kilka aspektów. Odpowiedź wskazująca, że wynik to 'Suma x i y wynosi 15', jest niepoprawna, ponieważ w sformatowanym ciągu tekstowym program odnosi się do wartości zmiennych, a nie do ich nazw. Wartości zmiennych są wykorzystywane w obliczeniach, a nie ich identyfikatory. Kiedy mówimy o 'Suma 5 i 10 wynosi x + y', także popełniamy błąd, ponieważ sformatowany ciąg nie wyświetli dosłownie 'x + y', lecz ich wartości. To wskazuje na nieporozumienie dotyczące interpolacji ciągów, która w C# dokonuje zamiany zmiennych na ich wartości i umieszcza je w tekście. Ostatnia propozycja, mówiąca o błędzie składni, jest także mylna, gdyż podany kod jest poprawny syntaktycznie i semantycznie. Typowe błędy często prowadzą do takich nieprawidłowych wniosków obejmują brak zrozumienia, jak działa interpolacja oraz nieznajomość podstawowych zasad programowania C#. Kluczowe jest zrozumienie, że używanie zmiennych w wyrażeniach tekstowych jest techniką, która pozwala programistom na bardziej dynamiczne i elastyczne tworzenie komunikatów, co jest nieocenione w kontekście tworzenia aplikacji interaktywnych.
Pytanie 29
Który z wymienionych elementów może stanowić część menu w aplikacji desktopowej?
A. CheckBox
B. ScrollBar
C. Canvas
D. MenuItemTwoja odpowiedź
Poprawna odpowiedź. MenuItem to podstawowy komponent, który stanowi część systemu menu w aplikacjach desktopowych. Jest to element, który pojawia się w rozwijanym menu i pozwala na wykonywanie określonych akcji, takich jak otwieranie plików, zapisywanie danych czy wywoływanie funkcji aplikacji. MenuItem jest szeroko stosowany w aplikacjach Windows w połączeniu z WPF i WinForms. Tworzenie strukturalnego menu, które ułatwia nawigację po aplikacji, jest kluczowe dla zapewnienia dobrej użyteczności i intuicyjności oprogramowania.
Pytanie 30
Który z języków programowania jest powszechnie wykorzystywany do tworzenia aplikacji na komputery stacjonarne?
A. C++Twoja odpowiedź
B. PHP
C. HTML
D. JavaScript
Poprawna odpowiedź. C++ jest jednym z najczęściej wykorzystywanych języków programowania do tworzenia aplikacji desktopowych. Jego wysoka wydajność, niskopoziomowy dostęp do pamięci i możliwość zarządzania zasobami sprawiają, że jest idealnym wyborem do tworzenia aplikacji wymagających dużej mocy obliczeniowej, takich jak gry, oprogramowanie do obróbki grafiki czy aplikacje systemowe. Frameworki takie jak Qt i biblioteki standardowe C++ (STL) umożliwiają budowanie zarówno prostych, jak i zaawansowanych aplikacji z bogatym interfejsem użytkownika. C++ jest wykorzystywany na szeroką skalę w przemyśle, co czyni go jednym z kluczowych języków w ekosystemie programistycznym.
Pytanie 31
Jednym z elementów, które mają zostać zaimplementowane w aplikacji, jest możliwość cofnięcia ostatnich działań do 20 operacji wstecz (undo). Struktura danych, która jest odpowiednia do tego celu i pozwala na dostęp tylko do ostatnio dodanego elementu, to:
A. tablica
B. drzewoTwoja odpowiedź
C. kolejka
D. stosPoprawna odpowiedź
Niepoprawna odpowiedź. Kolejka to struktura danych działająca na zasadzie FIFO (First In, First Out), co oznacza, że pierwszy dodany element jest pierwszym, który zostaje usunięty. Tego rodzaju organizacja danych nie nadaje się do implementacji funkcji cofania, ponieważ nie umożliwia łatwego dostępu do ostatnich operacji. W kontekście aplikacji umożliwiającej cofnięcie działań, kolejka nie zaspokaja potrzeb użytkownika, gdyż nie pozwala na usunięcie najnowszej operacji. Drzewo, jako bardziej złożona struktura, jest używane głównie do organizacji danych w hierarchicznej formie. Chociaż drzewa mogą być skuteczne w wyszukiwaniu i porządkowaniu danych, nie są odpowiednie do realizacji funkcji cofania ostatnich operacji, ponieważ nie oferują prostego dostępu do ostatnio dodanych elementów. Wreszcie, tablica jest statyczną strukturą danych, która przechowuje elementy w sekwencyjnej kolejności. Mimo że można by używać tablicy do przechowywania operacji, ich ograniczenia dotyczące rozmiaru i elastyczności sprawiają, że są mniej efektywne w porównaniu do stosu w kontekście cofania operacji. W związku z tym, ani kolejka, ani drzewo, ani tablica nie są odpowiednimi wyborami dla funkcjonalności cofania w aplikacji, co czyni stos jedynym logicznym rozwiązaniem.
Pytanie 32
Co oznacza skrót CDN w kontekście aplikacji webowych?
A. Cross Domain Navigation - metoda nawigacji między domenami w aplikacjach webowych
B. Content Definition Notation - notacja do definiowania treści w aplikacjachTwoja odpowiedź
C. Compressed Data Node - węzeł kompresji danych w architekturze mikrousług
D. Content Delivery Network - sieć rozproszona geograficznie, służąca do dostarczania treściPoprawna odpowiedź
Niepoprawna odpowiedź. W kontekście aplikacji webowych błędne skróty i pojęcia często prowadzą do nieporozumień dotyczących architektury i technologii. Cross Domain Navigation, chociaż istotne w kontekście bezpieczeństwa i wymiany danych między różnymi domenami, nie jest związane z dostarczaniem treści. Metoda ta dotyczy głównie sposobów nawigacji w aplikacjach, które mogą wymagać zarządzania różnymi politykami CORS (Cross-Origin Resource Sharing), ale nie definiuje sposobów optymalizacji dostarczania treści. Compressed Data Node to termin, który sugeruje węzeł odpowiedzialny za kompresję danych w architekturze mikrousług, ale nie wiąże się z geograficznie rozproszonym dostarczaniem treści, co jest kluczowym aspektem działania CDN. Content Definition Notation to z kolei nieznany termin w literaturze dotyczącej technologii webowej, nie mający powszechnie uznawanej definicji w branży. Błędem myślowym byłoby utożsamianie tych terminów z sieciami dostarczania treści, ponieważ każde z nich ma swoją specyfikę i zastosowanie. W kontekście aplikacji internetowych kluczowe jest zrozumienie, że CDN ma na celu poprawę szybkości i efektywności dostarczania treści, co jest niezrównanie bardziej złożonym i istotnym zagadnieniem niż tylko nawigacja czy kompresja danych. Praktyki związane z sieciami CDN są dobrze udokumentowane i należy je stosować zgodnie z najlepszymi standardami branżowymi, aby zapewnić wysoką jakość usług dla użytkowników.
Pytanie 33
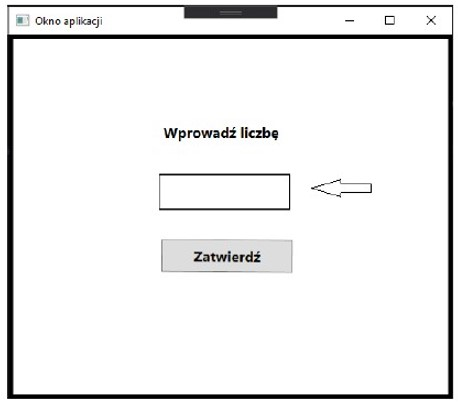
Z jakiego obiektu można skorzystać, aby stworzyć kontrolkę wskazaną strzałką na ilustracji?
A. Windows - dla biblioteki WPF; JFrame - dla biblioteki SwingTwoja odpowiedź
B. Text - dla biblioteki WPF; JText - dla biblioteki Swing
C. TextBox - dla biblioteki WPF; JTextField - dla biblioteki SwingPoprawna odpowiedź
D. Box - dla biblioteki WPF; JField - dla biblioteki Swing
Niepoprawna odpowiedź. W tej sytuacji łatwo się pomylić, bo nazewnictwo w różnych frameworkach bywa mylące i czasem wydaje się, że coś powinno się nazywać inaczej. Na przykład, Windows albo JFrame to nie są komponenty służące bezpośrednio do wprowadzania tekstu – Windows w WPF czy JFrame w Swingu to kontenery, czyli miejsca, gdzie umieszczasz różne kontrolki, a nie pole do wprowadzania tekstu. Bardzo częsty błąd początkujących to mylenie kontenera z komponentem – niby oba pojawiają się na ekranie, ale spełniają zupełnie inne role. Z kolei Text w WPF to po prostu właściwość przechowująca wartość tekstową, nie jest to oddzielna kontrolka, a JText w Swingu… cóż, taki komponent w ogóle nie istnieje, więc to trochę strzał w ciemno. Box i JField także nie są standardowymi kontrolkami wejściowymi – Box w WPF nie odnosi się do żadnej kontrolki tekstowej, a JField to nie jest nazwa wykorzystywana w Swingu. To pokazuje, jak ważne jest czytanie dokumentacji i praktykowanie na konkretnych przykładach, bo bardzo łatwo stworzyć sobie błędny obraz struktury frameworka. Najlepiej zapamiętać, że jeśli chodzi o pole tekstowe w WPF, zawsze będzie to TextBox, a w Swingu JTextField – są to podstawowe, powszechnie używane i dobrze udokumentowane klasy. Inne nazwy mogą prowadzić do niepotrzebnych komplikacji i błędnej logiki w aplikacji.
Pytanie 34
Co to jest JWT (JSON Web Token)?
A. Protokół do przesyłania danych JSON przez sieć
B. Kompaktowy format do bezpiecznego przekazywania informacji między stronami jako obiekt JSONPoprawna odpowiedź
C. Format zapisu danych w bazach NoSQL
D. Biblioteka JavaScript do manipulacji danymi JSONTwoja odpowiedź
Niepoprawna odpowiedź. Wszystkie błędne odpowiedzi opierają się na nieporozumieniach związanych z zastosowaniem i definicją JWT. Nie jest to protokół do przesyłania danych JSON przez sieć, ponieważ JWT to nie protokół, a format tokena, który jest wykorzystywany do bezpiecznego przesyłania danych pomiędzy stronami. JWT nie jest również formatem zapisu danych w bazach NoSQL; zamiast tego jest to sposób kodowania informacji w formacie JSON, który może być używany w różnych kontekstach, w tym w bazach danych, ale nie jest z nimi bezpośrednio związany. Co więcej, JWT nie jest biblioteką JavaScript ani żadnym narzędziem do manipulacji danymi JSON. To jest zrozumiałe, że często można się pomylić w zrozumieniu kontekstu, w którym używane jest JWT, ale istotą jego funkcjonalności jest przede wszystkim zapewnienie bezpiecznego przesyłania informacji. W praktyce, błędne rozumienie użycia JWT może prowadzić do problemów z bezpieczeństwem aplikacji, gdyż nieprawidłowo zaimplementowane rozwiązania mogą narażać dane użytkowników na nieautoryzowany dostęp. Przy stosowaniu JWT konieczne jest także zrozumienie, jak zabezpieczyć je przed atakami, na przykład przez odpowiednie ustawienie czasu ważności tokena i stosowanie algorytmów szyfrowania, co jest zgodne z najwyższymi standardami bezpieczeństwa w branży IT.
Pytanie 35
Jakie jest podstawowe zadanie wykorzystania frameworka Node.js w aplikacjach internetowych?
A. Weryfikacja API
B. Budowanie aplikacji mobilnych
C. Zarządzanie aplikacjami serwerowymi i realizacja przetwarzania asynchronicznegoTwoja odpowiedź
D. Kreowanie graficznego interfejsu użytkownika
Poprawna odpowiedź. Node.js to w zasadzie takie środowisko, które pozwala na uruchamianie JavaScriptu na serwerze. Dzięki temu można budować różne aplikacje serwerowe i radzić sobie z asynchronicznym przetwarzaniem. Fajnie, że Node.js może obsługiwać wiele połączeń jednocześnie, co sprawia, że nadaje się do aplikacji, które mają dużo użytkowników, jak czaty czy różne API. Jest to dość wydajne rozwiązanie dzięki architekturze opartej na zdarzeniach, więc nie zajmuje za dużo zasobów. Co ciekawe, używając Node.js, można pisać kod zarówno na serwerze, jak i na kliencie, co jest naprawdę dużą oszczędnością czasu.
Pytanie 36
Jaką strukturę danych obrazuje zamieszczony kod w języku C#?
int[,]array=newint[3,3];
A. tablicę dwuwymiarowąPoprawna odpowiedź
B. tablicę jednowymiarowąTwoja odpowiedź
C. listę
D. stos
Niepoprawna odpowiedź. Kod z pytania przedstawia strukturę, która bywa mylona z innymi, ale ma bardzo konkretne cechy. Jeśli ktoś pomylił ją z tablicą jednowymiarową, pewnie sugerował się tylko fragmentem 'int[]', ale obecność przecinka w deklaracji (int[,]) jednoznacznie wskazuje na dwa wymiary. Tablica jednowymiarowa pozwala na dostęp przez jeden indeks – coś jak lista wartości pod rząd, na przykład numery od 0 do n. Stos to zupełnie inna struktura, która w języku C# zwykle jest reprezentowana przez klasę Stack<T> i działa na zasadzie LIFO (Last In, First Out), czyli elementy wyjmuje się w odwróconej kolejności do tego, jak je wstawiasz. W kodzie nie ma żadnej logiki związanej ze stosami ani nie jest używana żadna taka klasa. Lista natomiast, często używana w C# jako List<T>, to dynamiczna kolekcja jednowymiarowa, pozwalająca na łatwe dodawanie i usuwanie elementów, ale też nie pozwala na odwoływanie się do elementów przez dwa indeksy. Z mojego doświadczenia, wiele osób utożsamia tablice dwuwymiarowe z listami, bo mają podobne operacje dostępu, jednak technicznie to zupełnie różne obiekty – tablica dwuwymiarowa ma stały rozmiar i dostęp O(1) do każdego elementu przez dwa indeksy. Błędne odpowiedzi często wynikają z nieuważnego przeczytania składni lub braku rozróżnienia pomiędzy różnymi strukturami danych na poziomie języka. Warto nauczyć się zauważać różnice w deklaracji i przeznaczeniu tych struktur, bo ma to spore znaczenie przy projektowaniu algorytmów i wydajności aplikacji. W praktyce, wybór pomiędzy tablicą jednowymiarową, dwuwymiarową, stosem czy listą zależy od konkretnego problemu i sposobu, w jaki musisz przechowywać oraz przetwarzać dane. Poprawne zrozumienie tych różnic oszczędza sporo frustracji na dalszych etapach nauki programowania, szczególnie przy pracy z bardziej zaawansowanymi strukturami i algorytmami.
Pytanie 37
Które z poniżej wymienionych afirmacji najtrafniej charakteryzuje proces interpretacji kodu?
A. Analiza struktury kodu przed tłumaczeniem
B. Tworzenie pliku wykonywalnego
C. Tłumaczenie kodu źródłowego na język maszynowy w czasie rzeczywistymPoprawna odpowiedź
D. Generowanie bibliotek dynamicznych dla programuTwoja odpowiedź
Niepoprawna odpowiedź. Generowanie pliku wykonywalnego to proces związany z kompilacją, a nie interpretacją. Kompilator przekształca cały kod źródłowy na kod maszynowy przed uruchomieniem programu, co odróżnia go od interpretacji. Analiza struktury kodu przed tłumaczeniem odnosi się do statycznej analizy kodu, a nie jego wykonywania. Tworzenie bibliotek dynamicznych to etap łączenia (linkowania), który następuje po kompilacji lub interpretacji, ale nie jest częścią samej interpretacji kodu źródłowego.
Pytanie 38
W zamieszczonej ramce znajdują się notatki testera dotyczące przeprowadzanych testów aplikacji. Jakiego typu testy planuje przeprowadzić tester?
zmierzyć czas zalogowania się użytkownika
ustalić domyślną liczbę produktów na stronie, dla której renderowanie jest akceptowalne czasowo
czy wizualizacja danych na mapie przebiega bez opóźnień?
czy czas logowania wzrasta znacznie przy logowaniu 10 użytkowników, 100, 1000?
jaka minimalna prędkość pobierania jest wymagana, aby aplikacja była zaakceptowana przez klienta?
A. BezpieczeństwaTwoja odpowiedź
B. Interfejsu
C. Jednostkowe
D. WydajnościowePoprawna odpowiedź
Niepoprawna odpowiedź. Testy jednostkowe, choć niezwykle ważne, koncentrują się na weryfikacji małych fragmentów kodu, zwykle pojedynczych funkcji lub metod. Mają one na celu upewnienie się, że każdy komponent działa zgodnie z oczekiwaniami. W kontekście pytania, które odnosi się do mierzenia czasu logowania i wydajności pod obciążeniem, testy jednostkowe nie są odpowiednie, ponieważ nie sprawdzają, jak system radzi sobie z różnym obciążeniem. Testy interfejsu koncentrują się na sprawdzaniu, czy użytkownik może wchodzić w interakcje z systemem w sposób intuicyjny i bezbłędny. Nie dotyczą jednak aspektów wydajnościowych, takich jak czas renderowania czy czas logowania przy dużym obciążeniu. Z kolei testy bezpieczeństwa są niezbędne do identyfikacji luk w systemie, które mogłyby być wykorzystane przez atakujących. Skupiają się na takich aspektach jak kontrola dostępu, ochrona danych i odporność na ataki typu DDoS. W pytaniu jednak nie ma odniesienia do kwestii bezpieczeństwa, takich jak czy system jest odporny na eskalację uprawnień czy ataki typu SQL Injection. Często błędnie myśli się, że wystarczy sprawdzić podstawowe funkcje aplikacji, ignorując, jak zachowuje się ona pod obciążeniem, co jest krytycznym aspektem jej rzeczywistej użyteczności w środowisku produkcyjnym. Aby zapewnić pełną jakość aplikacji, konieczne jest przeprowadzanie wszystkich typów testów odpowiednio do ich celu, ale w kontekście pytania tylko testy wydajnościowe bezpośrednio odnoszą się do przedstawionych zagadnień związanych z czasem odpowiedzi i obciążeniem systemowym.
Pytanie 39
Jaki numer telefonu należy wybrać, aby skontaktować się z pogotowiem ratunkowym w Polsce?
A. 113
B. 112Poprawna odpowiedź
C. 997
D. 998Twoja odpowiedź
Niepoprawna odpowiedź. Wiele osób wciąż kojarzy numery alarmowe z czasów, gdy każda służba miała swój własny, trzycyfrowy numer. To zrozumiałe, bo przez długie lata pogotowie ratunkowe w Polsce wzywało się pod 999, policję pod 997, a straż pożarną pod 998. Jednak dzisiaj standardy się zmieniły – od kilku lat obowiązuje unijny numer 112 jako podstawowy numer alarmowy, także w Polsce. Co ciekawe, większość ludzi myli 997 czy 998, sądząc, że można przez nie zgłaszać wszystkie nagłe przypadki, tymczasem te numery ewoluowały i są coraz rzadziej używane, a ich obsługa bywa przekierowywana na 112, żeby usprawnić cały system reagowania. Odpowiedź 113 jest z kolei zupełnie nietrafiona – nie istnieje w Polsce taki numer alarmowy, a pod tym numerem można było czasem uzyskać informacje o numerach telefonów, ale na pewno nie pomoc w nagłym przypadku. Typowym błędem myślowym jest kierowanie się przyzwyczajeniem albo nieaktualną informacją – dawniej te numery funkcjonowały osobno, dziś system zintegrowano, żeby było szybciej i bardziej efektywnie. Numer 112 to obecnie obowiązujący europejski standard, co wynika nie tylko z przepisów krajowych, ale i unijnych dyrektyw dotyczących bezpieczeństwa. Operatorzy 112 przeszli specjalistyczne szkolenia i są przygotowani, żeby obsłużyć każde zgłoszenie, niezależnie od rodzaju zagrożenia czy sytuacji. Co więcej, 112 działa nawet wtedy, gdy nie wiemy, która służba powinna zareagować – wystarczy opisać sytuację, a operator pokieruje zgłoszenie tam, gdzie trzeba. Moim zdaniem to ogromna wygoda i zabezpieczenie na wypadek stresujących sytuacji, kiedy trudno się zdecydować, który numer wybrać. Błędne odpowiedzi wynikają najczęściej z przyzwyczajeń lub braku aktualnej wiedzy o systemie alarmowym – dlatego warto sobie utrwalić, że jeden numer, 112, rozwiązuje wszystko w awaryjnej sytuacji.
Pytanie 40
Metoda tworzenia algorytmu polegająca na dzieleniu go na dwa lub więcej mniejszych podproblemów, aż do momentu, gdy ich rozwiązanie stanie się proste, jest techniką
A. najkrótszej ścieżki
B. komiwojażera
C. heurystyczną
D. dziel i zwyciężajTwoja odpowiedź
Poprawna odpowiedź. Strategia znana jako 'dziel i zwyciężaj' to sposób, w jaki można podejść do rozwiązywania problemów w algorytmice. Chodzi o to, żeby rozdzielić większy problem na mniejsze kawałki, które są już łatwiejsze do ogarnięcia. Robimy to, aż każdy z tych kawałków da się rozwiązać bez większego trudu. Jak już mamy rozwiązania tych mniejszych problemów, to je łączymy, żeby uzyskać odpowiedź na nasz pierwotny problem. Przykłady? No to mamy algorytm sortowania szybkiego (Quicksort) oraz Mergesort, które świetnie sobie radzą z porządkowaniem danych, dzieląc je na mniejsze części. Jak patrzy się na to z perspektywy analizy algorytmów, to ta strategia często prowadzi do lepszej złożoności obliczeniowej, co sprawia, że jest naprawdę przydatna w praktyce, zwłaszcza w informatyce. W książce Cormena i innych, 'Introduction to Algorithms', można znaleźć sporo informacji na temat tych metod i ich zastosowań, co czyni je naprawdę istotnymi w obszarze programowania i analizy danych.