Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 17 września 2026 10:46
Zakończenie: 17 września 2026 11:09
Egzamin niezdany
Wynik: 11/40 punktów (27,5%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 16% podejść do kwalifikacji INF.03.
Porównanie z 42020 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
W języku HTML, aby stworzyć pole do wprowadzania hasła, w którym wpisywany tekst będzie ukrywany (zastępowany kropkami), należy zastosować znacznik
A. <input type="password" />Poprawna odpowiedź
B. <form="password" type="password" />
C. <input name="password" />Twoja odpowiedź
D. <form input type="password" />
Niepoprawna odpowiedź. W przypadku odpowiedzi <input name="password" /> brakuje kluczowego atrybutu 'type', co uniemożliwia prawidłowe zdefiniowanie pola do wprowadzania hasła. Standard HTML wymaga, aby każdy input miał określony typ, aby przeglądarka wiedziała, jak ma obsługiwać dane wejściowe. Użycie tylko 'name' bez 'type' sprawia, że przeglądarka interpretuje to pole jako standardowe pole tekstowe, co nie maskuje wprowadzanych danych i naraża hasło na nieautoryzowany dostęp. W przypadku zastosowania <form="password" type="password" /> oraz <form input type="password" /> zawężamy logikę do niewłaściwego użycia znaczników formularzy. 'form' jest elementem kontenerowym dla grupy inputów, a jego atrybuty powinny odnosić się do dodatkowych informacji, ale nie pozwalają na umieszczenie inputa wewnątrz samego formularza w taki sposób. Te błędne konstrukcje mogą prowadzić do nieczytelności kodu i problemów z interpretacją przez przeglądarki, co jest szczególnie niekorzystne w kontekście dostępności i użyteczności. Warto przy projektowaniu formularzy przestrzegać standardów HTML oraz praktyk takich jak semantyczne użycie elementów, aby poprawić zarówno SEO, jak i UX.
Pytanie 2
W systemie baz danych hurtowni utworzono tabelę sprzedaz z polami: id, kontrahent, grupa_cenowa, obrot. Jakie polecenie należy zastosować, aby znaleźć jedynie kontrahentów z drugiej grupy cenowej, których obrót przekracza 4000zł?
A. SELECT kontrahent FROM sprzedaz WHERE grupa_cenowa = 2 AND obrot > 4000Twoja odpowiedź
B. SELECT sprzedaz FROM kontrahent WHERE grupa_cenowa = 2 AND obrot > 4000
C. SELECT sprzedaz FROM kontrahent WHERE obrot > 4000
D. SELECT kontrahent FROM sprzedaz WHERE grupa_cenowa = 2 OR obrot > 4000
Poprawna odpowiedź. Poprawna odpowiedź to 'SELECT kontrahent FROM sprzedaz WHERE grupa_cenowa = 2 AND obrot > 4000;'. To polecenie SQL precyzyjnie spełnia wymagania postawione w pytaniu, ponieważ korzysta z operatora AND do jednoczesnego filtrowania kontrahentów w drugiej grupie cenowej oraz tych, których obrót przekracza 4000 zł. W praktyce, takie zapytanie jest niezwykle użyteczne w analizie danych w hurtowniach, umożliwiając wyodrębnienie tylko tych kontrahentów, którzy spełniają oba warunki, co jest kluczowe w procesach selekcji kontrahentów do dalszych działań marketingowych czy analizy rentowności. Warto zauważyć, że dobrym nawykiem jest dokładne określenie, które pola chcemy wyświetlić, a w tym przypadku 'kontrahent' wskazuje na konkretne dane, które są istotne dla analizy. Dodatkowo, stosowanie odpowiednich warunków w zapytaniach SQL jest zgodne z najlepszymi praktykami w zakresie optymalizacji wydajności bazy danych, ponieważ pozwala na minimalizację ilości przetwarzanych danych oraz zwiększa przejrzystość wyników.
Pytanie 3
W przedstawionym filmie, aby połączyć tekst i wielokąt w jeden obiekt tak, aby operacja ta była odwracalna zastosowano funkcję
A. grupowania.Poprawna odpowiedź
B. sumy.Twoja odpowiedź
C. części wspólnej.
D. wykluczenia.
Niepoprawna odpowiedź. W tym zadaniu łatwo się pomylić, bo w grafice wektorowej mamy kilka różnych funkcji, które na pierwszy rzut oka wyglądają podobnie: łączą obiekty w coś, co zachowuje się jak jeden element. Jednak ich działanie „pod maską” jest zupełnie inne. Funkcje typu suma, wykluczenie czy część wspólna to klasyczne operacje boolowskie na kształtach. One zmieniają geometrię obiektów, czyli tworzą nową ścieżkę wynikową na podstawie przecięcia lub połączenia istniejących. W praktyce oznacza to, że jeśli zastosujesz sumę na tekście i wielokącie, program najczęściej zamieni tekst na krzywe i połączy wszystko w jedną ścieżkę. Efekt wizualny może być fajny, ale edytowalność tekstu przepada. Nie możesz już po prostu zmienić czcionki czy liter, bo to nie jest tekst, tylko zestaw węzłów. Podobnie z wykluczeniem: ta operacja tworzy „dziurę” jednego obiektu w drugim. Używa się jej np. do wycinania napisu z tła lub tworzenia maski. To jest typowy trik przy projektach logotypów albo efektach dekoracyjnych. Ale z punktu widzenia pytania – to działanie jest destrukcyjne dla tekstu, bo znowu zamienia go na kształt i łączy z wielokątem w sposób nieodwracalny (poza cofnięciem operacji). Część wspólna działa jeszcze ostrzej: zostawia tylko obszar, w którym obiekty się nakładają. Reszta jest tracona. To też jest operacja geometryczna, a nie organizacyjna. Typowy błąd myślowy polega na założeniu, że „skoro po operacji mam jeden obiekt, to znaczy, że to jest to samo co grupowanie”. Niestety nie. Grupowanie nie modyfikuje kształtów, tylko tworzy kontener logiczny – tak jakbyś w folderze trzymał kilka plików. Możesz je potem rozgrupować i wszystko wraca do stanu sprzed grupowania. Operacje suma, wykluczenie, część wspólna są destrukcyjne względem oryginalnych obiektów, bo generują nową ścieżkę zamiast starych. W kontekście dobrych praktyk w grafice komputerowej i multimediach przyjmuje się, że dopóki chcesz zachować pełną edytowalność (szczególnie tekstów), używasz grupowania, warstw i wyrównywania, a dopiero na późnym etapie projektu stosujesz operacje boolowskie, i to świadomie, wiedząc, że cofasz się już tylko historią edycji. Dlatego w pytaniu, gdzie mowa jest wprost o połączeniu tekstu i wielokąta w jeden obiekt w sposób odwracalny, jedyną sensowną odpowiedzią jest funkcja grupowania, a nie suma, wykluczenie czy część wspólna.
Pytanie 4
W PHP tablice asocjacyjne to struktury, w których
A. elementy tablicy są zawsze numerowane od zera
B. indeks może być dowolnym ciągiem znakówPoprawna odpowiedź
C. w każdej pozycji tablicy znajduje się inna tablicaTwoja odpowiedź
D. są co najmniej dwa wymiary
Niepoprawna odpowiedź. W przypadku niepoprawnych odpowiedzi, warto zwrócić uwagę na podstawowe koncepcje dotyczące tablic asocjacyjnych. Gdybyśmy uznali, że tablica asocjacyjna musi mieć przynajmniej dwa wymiary, byłoby to niezgodne z definicją, ponieważ tablice asocjacyjne w PHP mogą być jednowymiarowe. W rzeczywistości, tablica asocjacyjna to po prostu kolekcja par klucz-wartość, gdzie klucz może być unikalnym napisem, a wartość może być dowolnym typem danych. Odpowiedź sugerująca, że w każdej komórce tablicy przechowywana jest inna tablica, również jest myląca, ponieważ tablice asocjacyjne mogą przechowywać różne typy danych, a nie tylko inne tablice. Dlatego każde przechowywane dane mogą być różnorodne, co czyni je elastycznym narzędziem. Z kolei stwierdzenie, że elementy tablicy są zawsze indeksowane od liczby równej 0, odnosi się do standardowych tablic numerowanych w PHP, a nie tablic asocjacyjnych, gdzie klucze mogą przybierać różne wartości, a nie tylko liczby. Te nieporozumienia mogą prowadzić do nieefektywnego użycia tablic asocjacyjnych, co w praktyce skutkuje trudnościami w zarządzaniu danymi i ich dostępem. Aby efektywnie korzystać z tablic asocjacyjnych, kluczowe jest zrozumienie ich podstawowych właściwości oraz różnic w porównaniu do tablic numerowanych.
Pytanie 5
Jaką wartość zwróci funkcja
empty($a);
w języku PHP, gdy zmienna
$a
będzie miała wartość liczbową równą 0?
A. TRUETwoja odpowiedź
B. 0
C. NULL
D. FALSE
Poprawna odpowiedź. Funkcja empty() w PHP służy do sprawdzania, czy zmienna jest pusta. Zmienna uznawana jest za pustą, jeśli nie istnieje, ma wartość NULL, jest równoważna FALSE, jest pustym ciągiem (''), jest pustą tablicą lub ma wartość 0. W przypadku zmiennej $a, która ma wartość liczbową równą 0, funkcja empty($a) zwróci TRUE, co oznacza, że zmienna jest uznawana za pustą. Kluczowym aspektem jest zrozumienie, że w PHP wartość 0 jest interpretowana jako fałszywa w kontekście logicznym, a tym samym spełnia kryteria funkcji empty(). Praktyczne zastosowanie tej funkcji można zauważyć w wielu aspektach programowania: na przykład podczas walidacji danych wejściowych w formularzach, gdzie chcemy upewnić się, że użytkownik nie pozostawił pustych pól. Dobrą praktyką jest użycie empty() zamiast bezpośrednich porównań, ponieważ jest bardziej odporna na różne typy danych oraz zrozumiała w kontekście semantycznym, co poprawia czytelność kodu.
Pytanie 6
Dzięki któremu mechanizmowi możliwe jest dostosowanie wyglądu strony do konkretnego użytkownika i jego identyfikacja w serwisie?
A. połączenia z bazą
B. cookie (ciasteczek)Poprawna odpowiedź
C. formularzyTwoja odpowiedź
D. obiektów DOM
Niepoprawna odpowiedź. Pytanie dotyczy rozpoznania konkretnego użytkownika między wizytami. Obiekty DOM to reprezentacja struktury strony, połączenie z bazą dotyczy danych na serwerze, a formularze tylko zbierają dane wejściowe - żadne z nich samo nie zapamiętuje tożsamości. Robią to cookie (ciasteczka).
Pytanie 7
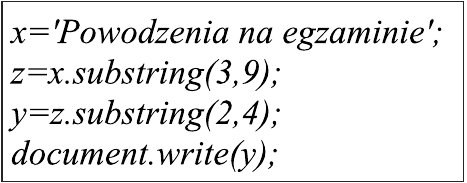
Poniżej zamieszczony fragment skryptu w JavaScript zwróci
A. zePoprawna odpowiedź
B. wodzeniaTwoja odpowiedź
C. wo
D. owodzeni
Niepoprawna odpowiedź. Patrząc na ten skrypt JavaScript, który działa na łańcuchach i wypisuje różne fragmenty tekstu, można się natknąć na pewne nieporozumienia związane z metodą substring. Z doświadczenia, wiem, że początkujący programiści czasem mylą się w odczytywaniu indeksów w tej metodzie. W skrócie, substring wyciąga dwa argumenty: początkowy i końcowy, ale działa tak, że bierze znaki od początkowego do przed końcowym. Więc gdy mamy substring(3,9) na 'Powodzenia na egzaminie', to zwraca 'odzeni'. Potem, jak wywołasz z.substring(2,4) na 'odzeni', to dostajesz 'ze'. Często błędnie myśli się, że substring bierze znaki do końca, co prowadzi do pomyłek. I jest jeszcze różnica między substring a substr, co też jest dość mylące. W kontekście tego egzaminu, ważne jest, aby rozumieć te drobne szczegóły i używać metod w odpowiednich sytuacjach. Z mojego doświadczenia, to klucz do efektywnej pracy z tekstem w skryptach webowych.
Pytanie 8
Aby osiągnąć efekt przedstawiony na ilustracji, w kodzie HTML należy zastosować znacznik skrótu <abbr> z atrybutem
A. titlePoprawna odpowiedź
B. dfnTwoja odpowiedź
C. alt
D. name
Niepoprawna odpowiedź. Znacznik <abbr> w HTML pełni rolę semantyczną, pomagając w oznaczaniu skrótów i akronimów. Atrybut alt jest stosowany w znacznikach <img> do opisywania obrazów, co jest istotne dla dostępności i SEO, ale nie ma związku ze znacznikami tekstowymi jak <abbr>. Alt informuje o treści obrazu, co jest kluczowe dla użytkowników niewidzących, lecz nie pełni funkcji rozwijania skrótów tekstowych. Atrybut dfn służy do definiowania terminów w tekście, zazwyczaj używany w połączeniu ze znacznikiem <dfn>, a nie <abbr>. Chociaż dfn dostarcza definicji, nie jest używany do rozwijania skrótów. Atrybut name nie jest związany z rozwijaniem tekstu ani z <abbr>. Jest on stosowany głównie w formularzach HTML do identyfikacji elementów, takich jak <input>, umożliwiając ich rozróżnienie. Mylenie tych atrybutów wynika często z braku zrozumienia ich specyficznych zastosowań w kontekście HTML i dostępności. Właściwe używanie atrybutów to klucz do tworzenia semantycznie poprawnych i dostępnych stron internetowych.
Pytanie 9
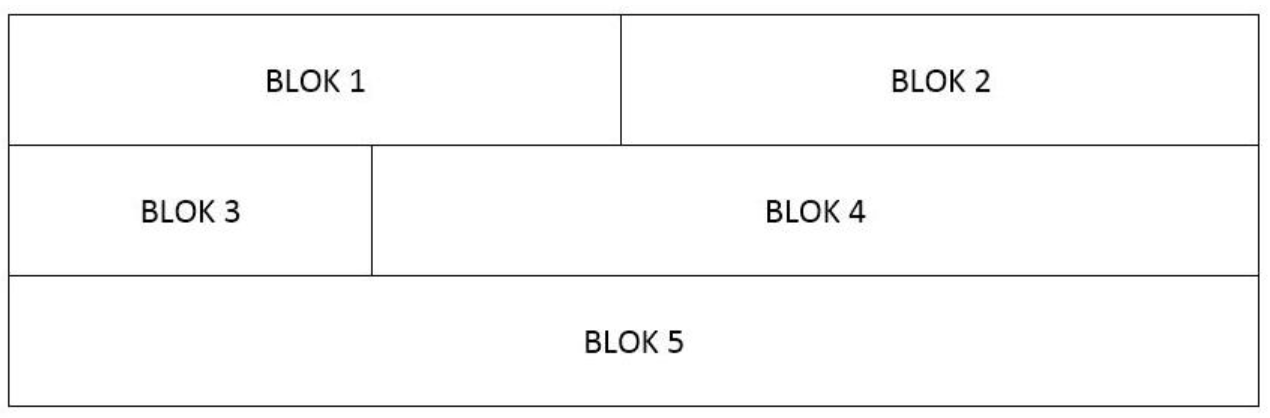
Na obrazie przedstawiono projekt układu bloków witryny internetowej. Zakładając, że bloki są realizowane za pomocą znaczników sekcji, ich formatowanie w CSS, oprócz ustawionych szerokości dla bloków: 1, 2, 3, 4 (blok 5 nie ma ustawionej szerokości), powinno zawierać właściwość
A. float: left dla wszystkich bloków.Twoja odpowiedź
B. clear: both dla bloku 5 oraz float: left jedynie dla 1 i 2 bloku.
C. clear: both dla wszystkich bloków.
D. clear: both dla bloku 5 oraz float: left dla pozostałych bloków.Poprawna odpowiedź
Niepoprawna odpowiedź. Twoja odpowiedź nie jest poprawna, ale nie przejmuj się, błąd może wynikać z niepełnego zrozumienia zastosowania właściwości 'float' i 'clear' w CSS. Zastosowanie 'float: left' dla wszystkich bloków nie jest dobrym pomysłem, ponieważ spowoduje to, że wszystkie bloki będą się starały zmieścić w jednym rzędzie, co jest niezgodne z założonym układem. Podobnie, dodawanie 'clear: both' do wszystkich bloków też nie jest poprawne, ponieważ spowoduje to, że wszystkie bloki będą wyświetlane jeden pod drugim, zamiast obok siebie. Właściwość 'clear' powinna być stosowana do bloków, które chcemy wyświetlić poniżej innych bloków, natomiast 'float: left' powinien być stosowany do bloków, które chcemy wyświetlić obok siebie. Pamiętaj, że zrozumienie tych właściwości i umiejętność ich stosowania jest kluczowe dla tworzenia efektywnych i atrakcyjnych layoutów stron internetowych.
Pytanie 10
Jakie zadanie ma funkcja PHP o nazwie mysql_select_db()?
A. wyznaczyć tabelę, z której będą pozyskiwane dane
B. nawiązać połączenie między bazą danych a serwerem SQL
C. wyznaczyć bazę, z której będą pozyskiwane danePoprawna odpowiedź
D. uzyskać dane z bazy danych na podstawie zapytaniaTwoja odpowiedź
Niepoprawna odpowiedź. Tutaj mamy parę pomyłek związanych z funkcją <span>mysql_select_db()</span>. Po pierwsze, mylisz ją z tym, jak łączymy bazę danych z serwerem SQL. W rzeczywistości, połączenie robi się przez <span>mysql_connect()</span>, a <span>mysql_select_db()</span> ma za zadanie pokazać, która z baz, które już mamy, ma być użyta. Kolejna sprawa to błędne zrozumienie, jak wyciągamy dane z bazy. Robimy to za pomocą funkcji jak <span>mysql_query()</span>, więc wybór bazy danych i ściąganie danych to dwa różne etapy. Mylenie bazy danych z tabelą też wprowadza w błąd, bo baza to tak naprawdę pojemnik dla tabel, a nie jedna konkretna tabela. Moim zdaniem, zrozumienie tej hierarchii jest kluczowe, żeby dobrze działać z bazami. Te nieporozumienia mogą skutkować poważnymi kłopotami, jak złe zapytania czy problemy z dostępem do danych. Lepiej wcześniej przejrzeć dokumentację i standardy SQL, bo one jasno tłumaczą różnice między połączeniem z serwerem, wyborem bazy danych a kwerendami.
Pytanie 11
Które z poniższych stwierdzeń odnosi się prawidłowo do grafiki rastrowej?
A. Grafika rastrowa nie jest zapisana w formacie WMF (ang. Windows Metafile Format - format metaplików w Windows)
B. W trakcie procesu skalowania, jakość obrazu nie ulega zmianie
C. Jest to forma przedstawienia obrazu za pomocą siatki pikseli, które są odpowiednio kolorowane w układzie pionowo-poziomym na monitorze, drukarce lub innym urządzeniu wyjściowymTwoja odpowiedź
D. Obraz zapisywany jest w postaci figur geometrycznych zorganizowanych w układzie współrzędnych
Poprawna odpowiedź. Grafika rastrowa to technika reprezentacji obrazów, w której obraz składa się z siatki pikseli. Każdy piksel ma przypisany kolor, co pozwala na precyzyjne odwzorowanie detali i kolorystyki. Taki sposób przedstawienia obrazu znajduje zastosowanie w grafice komputerowej, fotografii cyfrowej oraz w druku. W praktyce, obrazy rastrowe są powszechnie wykorzystywane w programach graficznych, takich jak Adobe Photoshop czy GIMP, gdzie edytuje się poszczególne piksele. Publikacje internetowe, jak także różnorodne formy marketingu wizualnego, opierają się na grafice rastrowej, ponieważ umożliwia ona tworzenie złożonych i bogatych w szczegóły obrazów. Ważnym aspektem grafiki rastrowej jest rozdzielczość, która określa ilość pikseli w obrazie; im wyższa rozdzielczość, tym większa jakość. Wydruki, które zyskują na jakości dzięki zastosowaniu technologii rastrowej, są zgodne z najlepszymi praktykami odnośnie do standardów drukarskich, co umożliwia osiągnięcie wysokiej jakości wydruków. Zrozumienie grafiki rastrowej jest kluczowe dla każdego, kto interesuje się tworzeniem i edytowaniem obrazów w kontekście cyfrowym.
Pytanie 12
Jaką wartość przyjmie zmienna $a po wykonaniu poniższej sekwencji poleceń w języku PHP?
$a=1;$a++;$a+=10;--$a;
A. 11Twoja odpowiedź
B. 1
C. 10
D. 12
Poprawna odpowiedź. Gratulacje, Twoja odpowiedź jest prawidłowa. Instrukcje wykonane w kodzie PHP prowadzą do osiągnięcia wartości 11 przez zmienną 'a'. Proces ten jest realizowany w czterech krokach. Najpierw zmienna 'a' jest inicjowana wartością 1. Następnie wartość ta jest zwiększana o 1, co daje nam 2. Do tej wartości dodawane jest 10, co daje nam łącznie 12. Na końcu, wartość ta jest zmniejszana o 1, co daje nam ostateczną wartość 11. Warto przypomnieć, że w języku programowania PHP, tak jak w większości języków, operacje są wykonywane od lewej do prawej. To jest ważne do zapamiętania, gdy mamy do czynienia z bardziej skomplikowanymi sekwencjami operacji.
Pytanie 13
Które wyrażenie logiczne należy zastosować w języku JavaScript, aby wykonać operacje tylko dla dowolnych liczb ujemnych z przedziału jednostronnie domkniętego <-200, -100)?
A. (liczba -100)
B. (liczba >= -200) && (liczba < -100)Twoja odpowiedź
C. (liczba >= -200) || (liczba > -100)
D. (liczba <= -200) && (liczba < -100)
Poprawna odpowiedź. Poprawne wyrażenie to (liczba >= -200) && (liczba < -100), bo dokładnie odwzorowuje zapis matematyczny przedziału jednostronnie domkniętego <-200, -100). W matematyce nawias kwadratowy oznacza, że granica jest włączona do przedziału, a nawias okrągły – że granica jest wyłączona. Czyli chcemy wszystkie liczby większe lub równe -200, ale jednocześnie mniejsze niż -100. W JavaScript przekłada się to właśnie na dwa porównania połączone operatorem logicznym AND, czyli &&. Warunek liczba >= -200 pilnuje dolnej granicy, a liczba < -100 pilnuje górnej, która jest otwarta. Jeśli którakolwiek z tych części będzie fałszywa, całe wyrażenie zwróci false, co jest dokładnie tym, czego oczekujemy przy opisie takiego przedziału. W praktyce taki zapis pojawia się bardzo często, np. przy walidacji danych wejściowych, filtrowaniu wyników, ustawianiu zakresów sliderów w interfejsie użytkownika albo przy sprawdzaniu warunków w grach (np. pozycja x obiektu ma być w jakimś zakresie). Przykład w JS: if (liczba >= -200 && liczba < -100) { // wykonaj kod tylko dla liczb z tego zakresu } Moim zdaniem warto od razu wyrobić sobie nawyk zapisywania zakresów w postaci dwóch prostych porównań połączonych &&, bo to jest czytelne dla innych programistów i zgodne z powszechną praktyką w branży. W wielu językach (nie tylko JavaScript, ale też C, Java, PHP) taki schemat warunków jest standardem. Trzeba też pamiętać, że w JS nie ma osobnego operatora „przedziału”, więc zawsze rozbijamy to właśnie na takie składowe porównania logiczne.
Pytanie 14
W języku JavaScript rezultat wykonania polecenia
zmienna1 -= 1;
będzie tożsamy z wynikiem polecenia
A. zmienna1++;
B. zmienna1 === zmienna1 - 1;
C. zmienna1 = zmienna1 - 0;
D. zmienna1--;Twoja odpowiedź
Poprawna odpowiedź. Odpowiedź zmienna1--; jest poprawna, ponieważ jest to skrócona forma wyrażenia zmienna1 -= 1;. Oba wyrażenia mają ten sam efekt, który polega na zmniejszeniu wartości zmiennej zmienna1 o 1. W języku JavaScript operator '--' jest operatorem dekrementacji, który zmienia wartość zmiennej o jeden w dół. Użycie tego operatora jest zgodne z dobrymi praktykami kodowania, gdyż zwiększa czytelność kodu, czyniąc intencje programisty bardziej jasnymi. Użycie dekrementacji jest powszechne w sytuacjach, gdzie iterujemy przez kolekcje z użyciem pętli, co ogranicza potrzebę stosowania bardziej skomplikowanych instrukcji. Na przykład, w przypadku pętli for, zamiast pisać for(let i = n; i > 0; i -= 1), można zastosować for(let i = n; i > 0; i--), co jest bardziej zwięzłe i zrozumiałe. W kontekście standardów kodowania, preferowanym podejściem jest używanie operatorów, które maksymalizują przejrzystość i minimalizują możliwość popełnienia błędów.
Pytanie 15
Jak nazywa się model prostej bazy, w której wszystkie dane są w JEDNEJ tabeli?
A. relacyjnym
B. jednorodnymPoprawna odpowiedź
C. sieciowymTwoja odpowiedź
D. hierarchicznym
Niepoprawna odpowiedź. Pozostałe modele są bardziej złożone. Relacyjny opiera się na wielu powiązanych tabelach, hierarchiczny na strukturze drzewa, a sieciowy na grafie powiązań. Dane w jednej tabeli to model jednorodny.
Pytanie 16
Co stanie się po wykonaniu
ALTERTABLEosobaDROPCOLUMNgrupa;
?
A. nazwa tabeli zmieni się na grupa
B. nazwa kolumny zmieni się na grupaTwoja odpowiedź
C. kolumna grupa zostanie USUNIĘTAPoprawna odpowiedź
D. kolumna grupa zostanie dodana
Niepoprawna odpowiedź. Pozostałe interpretacje są błędne. DROPCOLUMN oznacza usunięcie, a nie zmianę nazwy tabeli czy kolumny - do tego służyłoby RENAME. Kolumna nie zostaje też dodana, bo to robi ADDCOLUMN. Po wykonaniu polecenia kolumna grupa znika z tabeli.
Pytanie 17
Którego znacznika użyć, aby zgrupować elementy w jeden BLOK?
A.
<div>
Twoja odpowiedź
B.
<param>
C.
<span>
D.
<p>
Poprawna odpowiedź. Znacznik <div> to blokowy pojemnik bez własnego znaczenia, służący do grupowania innych elementów w jeden BLOK (sekcję), który potem łatwo stylować lub pozycjonować. Dlatego do grupowania w blok służy <div>.
Pytanie 18
Który zapis poprawnie ustawia w CSS niebieski kolor tekstu?
A.
font-color:blue;
B.
text-color:blue;
C.
color:(blue);
D.
color:blue;
Twoja odpowiedź
Poprawna odpowiedź. Kolor tekstu w CSS ustawia właściwość color. Wartość można podać jako nazwę (blue), zapis szesnastkowy (#0000ff) lub funkcję (rgb(0,0,255)). Poprawny zapis to więc color:blue;. Dlatego to ta deklaracja ustawia niebieski kolor tekstu.
Pytanie 19
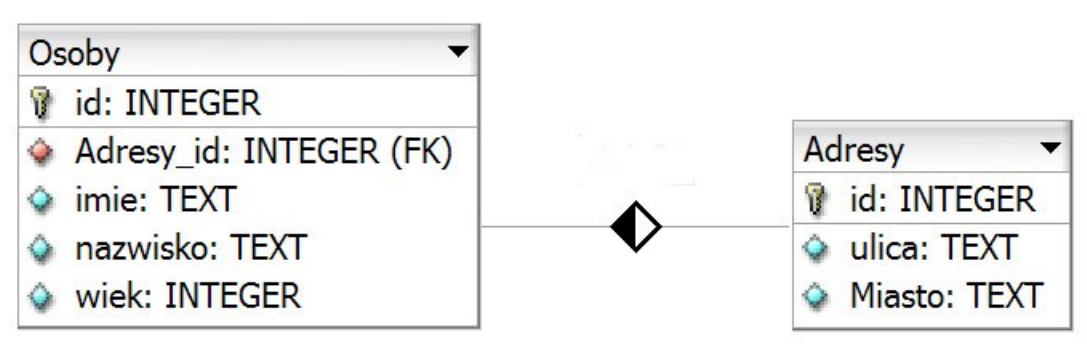
Tabele Osoby i Adresy są połączone relacją jeden do wielu. Jakie zapytanie SQL należy zapisać, aby korzystając z tej relacji, prawidłowo wyświetlić nazwiska oraz przyporządkowane im miasta?
A. SELECT nazwisko, Miasto FROM Osoby, Adresy;
B. SELECT nazwisko, Miasto FROM Osoby.Adresy_id = Adresy.id FROM Osoby, Adresy;Twoja odpowiedź
C. SELECT nazwisko, Miasto FROM Osoby JOIN Adresy ON Osoby.Adresy_id = Adresy.id;Poprawna odpowiedź
D. SELECT nazwisko, Miasto FROM Osoby, Adresy WHERE Osoby.id = Adresy.id;
Niepoprawna odpowiedź. Błędne odpowiedzi pokazują typowe nieporozumienia związane ze składnią i logiką SQL. Niektóre z nich opierają się na błędnym założeniu, że po prostu wymienienie tabel w instrukcji FROM automatycznie połączy te tabele - to nie jest prawda, ponieważ wymaga to jasno określonego warunku połączenia. Inne błądne odpowiedzi sugerują, że można po prostu porównać wartości kolumny 'id' w obu tabelach, aby je połączyć. To jest błędne, ponieważ nie uwzględnia to faktu, że relacja między tabelami jest określona przez klucz obcy, który może nie mieć takiej samej nazwy ani wartości jak klucz główny. Wreszcie, niektóre błędne odpowiedzi mylą składnię zapytania, umieszczając warunek łączenia w niewłaściwym miejscu lub pomijając niezbędne słowo kluczowe JOIN. To pokazuje, jak ważne jest dokładne zrozumienie składni SQL i jej reguł.
Pytanie 20
Która funkcja SQL zwraca DŁUGOŚĆ (liczbę znaków) tekstu?
A.
LEN
Poprawna odpowiedź
B.
UPPER
Twoja odpowiedź
C.
NOW
D.
YEAR
Niepoprawna odpowiedź. Pozostałe funkcje robią co innego. YEAR wyciąga ROK z daty, NOW zwraca bieżącą datę i czas, a UPPER zamienia litery na wielkie. Liczbę znaków tekstu zwraca LEN/LENGTH.
Pytanie 21
Z którego z pól klasy
class Dane{public$a;private$b;protected$c;}
będzie można uzyskać dostęp z zewnątrz przy użyciu obiektu stworzonego jako instancja tej klasy?
A. Do wszystkich pól.Twoja odpowiedź
B. Do pola $a.Poprawna odpowiedź
C. Do pola $b.
D. Do pola $c.
Niepoprawna odpowiedź. Odpowiedzi wskazujące na dostęp do wszystkich pól, pola $b oraz pola $c są wynikiem nieporozumienia dotyczącego zasad działania modyfikatorów dostępu w programowaniu obiektowym. Modyfikator public oznacza, że pole jest dostępne z każdego miejsca w kodzie, co jest prawdziwe tylko w przypadku pola $a. Natomiast pole $b, będące prywatnym, jest dostępne wyłącznie wewnątrz klasy Dane, co uniemożliwia dostęp z zewnątrz, co często prowadzi do błędnych wniosków, że wszystkie pola powinny być dostępne. W przypadku pola $c, które jest chronione, dostęp do niego mają tylko samodzielne instancje klasy oraz klasy pochodne, co również nie pozwala na dostęp z zewnątrz. W praktyce, wiele osób, które uczą się programowania obiektowego, może mylić te dwa poziomy dostępu i w konsekwencji przyjmować, że pola chronione mogą być używane w podobny sposób jak publiczne. Z tego powodu ważne jest zrozumienie podstawowych zasad modyfikatorów dostępu oraz ich wpływu na bezpieczeństwo i organizację kodu, co jest kluczowe w dobrych praktykach programowania.
Pytanie 22
Do czego służy w PHP funkcja trim()?
A. do podawania długości tekstu
B. do usuwania białych (lub podanych) znaków z obu końców tekstuPoprawna odpowiedź
C. do skracania tekstu o podaną liczbę znaków
D. do wyświetlania części wspólnej dwóch tekstówTwoja odpowiedź
Niepoprawna odpowiedź. Pozostałe opisy dotyczą innych funkcji. Długość tekstu zwraca strlen(), a wycinanie fragmentu - substr(). trim() nie „skraca o liczbę znaków” ani nie szuka części wspólnej - usuwa białe (lub podane) znaki z obu końców tekstu.
Pytanie 23
Analizując poniższy kod HTML, jak w przeglądarce zachowa się blok B względem bloku A?
<div>A</div><divstyle="margin-top: 20px">B</div>
A. zostanie ustawiony dolny margines bloku B
B. blok A zostanie przesunięty w lewo o 20 px
C. bloki A i B będą nachodzić na siebieTwoja odpowiedź
D. blok B będzie oddalony od bloku A o 20 pxPoprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe odpowiedzi błędnie odczytują działanie margin-top. To margines GÓRNY, więc odstęp powstaje nad elementem, a nie pod nim. Jest to margines pionowy, więc nie przesuwa bloku w lewo (do tego służyłby margin-left). Margines tworzy wolną przestrzeń, a nie nakładanie - nic na siebie nie nachodzi. Ustawiony nad blokiem B margin-top:20px odsuwa go od bloku A o 20 px.
Pytanie 24
body{ background-image: url"rysunek.gif"); background-repeat: repeat-y; } W przedstawionej definicji stylu CSS, powtarzanie dotyczy
A. rysunku osadzonego znacznikiem img
B. rysunku umieszczonego w tle strony w poziomieTwoja odpowiedź
C. tła każdego znacznika akapitu
D. rysunku znajdującego się w tle strony w pioniePoprawna odpowiedź
Niepoprawna odpowiedź. W kontekście pytania, nie wszystkie odpowiedzi są zgodne z zasadami CSS. Powtarzanie tła nie dotyczy tła każdego ze znaczników akapitu, ponieważ właściwość 'background-image' odnosi się do stylu całego elementu, w tym przypadku ciała strony ('body'), a nie poszczególnych akapitów. Rysunek umieszczony znacznikiem img nie ma związku z właściwościami tła, ponieważ ten znacznik wyświetla obraz w treści dokumentu, a nie jako tło dla elementu. Właściwość 'background-repeat' odnosi się wyłącznie do obrazów tła, a nie do obrazów wstawionych za pomocą znaczników HTML. Dodatkowo, rysunek umieszczony w tle strony w poziomie również nie jest poprawny, ponieważ 'repeat-y' wskazuje na powtarzanie w kierunku pionowym, co oznacza, że obrazek będzie powielany wzdłuż osi Y, a nie X. Zrozumienie tych różnic jest kluczowe dla efektywnego korzystania z CSS i tworzenia responsywnych, estetycznych stron internetowych.
Pytanie 25
Aby pobrać dane (rekordy) z tabeli w bazie danych, należy użyć polecenia:
A.
CREATE
B.
INSERT
Twoja odpowiedź
C.
GRANT
D.
SELECT
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe polecenia operują na bazie, ale żadne nie odczytuje danych. INSERT działa odwrotnie do odczytu - dodaje do tabeli nowe wiersze. CREATE należy do języka DDL i tworzy obiekty, takie jak tabele czy bazy danych, a nie zwraca rekordów. GRANT dotyczy uprawnień: przydziela użytkownikom prawa dostępu, więc z pobieraniem danych nie ma nic wspólnego. Odczyt rekordów z tabeli realizuje polecenie SELECT, dlatego to ono jest poprawne.
Pytanie 26
Grafika, która ma być pokazana na stronie, powinna mieć transparentne tło. Podaj format pliku graficznego, w którym należy go zapisać.
A. JPEG
B. BMP
C. PNGTwoja odpowiedź
D. CDR
Poprawna odpowiedź. Format PNG (Portable Network Graphics) jest idealnym rozwiązaniem dla obrazów z przezroczystym tłem, ponieważ obsługuje kanał alpha, który umożliwia definiowanie przezroczystości poszczególnych pikseli. Dzięki temu, gdy obraz PNG jest umieszczany na różnym tle, zachowuje naturalny wygląd i nie wymaga dodatkowego dostosowywania, co jest szczególnie ważne w projektach graficznych, które wymagają elastyczności w prezentacji. Przykładowe zastosowania PNG obejmują ikony, logo oraz wszelkie grafiki, które muszą być nałożone na inne elementy wizualne bez widocznych krawędzi czy tła. W branży grafiki komputerowej oraz web designu, PNG stał się standardem dla materiałów wymagających wysokiej jakości obrazu z zachowaniem przezroczystości. Dobrą praktyką jest również stosowanie PNG w przypadku grafik, które zawierają tekst, ponieważ format ten nie wprowadza strat jakości, co może mieć miejsce w przypadku innych formatów kompresji. Warto również zaznaczyć, że PNG nie traci jakości przy wielokrotnym zapisywaniu, co czyni go preferowanym wyborem tam, gdzie jakość jest kluczowa.
Pytanie 27
Wskaż poprawną definicję stylu CSS dla przycisku typu submit o właściwościach: czarny kolor tła, brak obramowania, marginesy wewnętrzne 5 px.
input[type=submit] {
  background-color: #000000;
  border: none;
  padding: 5px;
}                         A.

input[type=submit] {
  background-color: #ffffff;
  border: none;
  padding: 5px;
}                         B.

input=submit {
  background-color: #000000;
  border: none;
  margin: 5px;
}                         C.

input=submit {
  background-color: #000000;
  border: 0px;
  margin: 5px;
}                         D.
A. A.Twoja odpowiedź
B. B.
C. C.
D. D.
Poprawna odpowiedź. Dobrze! Wybrałeś prawidłową odpowiedź. Odpowiedź A jest poprawna, ponieważ to styl CSS dla przycisku typu submit spełnia wszystkie podane wymagania. Wygląda to mniej więcej tak: 'input[type='submit'] { background-color: black; border: none; padding: 5px; }'. 'input[type='submit']' to selektor, który wskazuje elementy wejściowe o typie 'submit'. Następnie, wewnątrz nawiasów klamrowych, mamy trzy deklaracje. 'background-color: black;' określa, że przycisk ma czarne tło. 'border: none;' usuwa wszelkie obramowanie. 'padding: 5px;' ustawia marginesy wewnętrzne na 5 pikseli. Pisanie czystego i efektywnego kodu CSS jest kluczową umiejętnością dla każdego doświadczonego dewelopera front-endu. Dobrze napisane style CSS mogą znacznie poprawić wydajność strony internetowej i ułatwić jej utrzymanie.
Pytanie 28
Prawidłowy, zgodny ze standardem języka XHTML, zapis samozamykającego się znacznika odpowiadającego za łamanie linii ma postać
A. <br>
B. </br/>
C. <br/>Twoja odpowiedź
D. </ br>
Poprawna odpowiedź. W XHTML zapis <br/> jest poprawny, ponieważ XHTML opiera się na składni XML, a w XML każdy element musi być domknięty. Znacznik br odpowiada za wymuszenie przejścia do nowej linii, ale nie ma osobnej treści między znacznikiem otwierającym i zamykającym. Dlatego traktuje się go jako element pusty, czyli samozamykający się. W praktyce oznacza to, że zamiast pisać osobny znacznik otwierający i zamykający, stosuje się formę <br/>. Spotkasz też zapis <br />, ze spacją przed ukośnikiem; on również jest często używany i zgodny z zasadami XHTML, a dawniej bywał polecany ze względu na kompatybilność ze starszymi przeglądarkami. Moim zdaniem warto zapamiętać prostą zasadę: w XHTML nie zostawiamy pustych znaczników otwartych tak jak czasem w HTML. Przykładowo podobnie zapisuje się inne puste elementy, np. <img/> albo <hr/>, oczywiście z odpowiednimi atrybutami tam, gdzie są potrzebne. To ważne przy walidacji dokumentu, bo walidator XHTML jest bardziej rygorystyczny niż zwykły parser HTML.
Pytanie 29
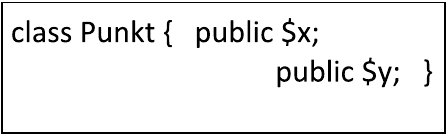
Jaką formę ma instrukcja w języku PHP, która tworzy obiekt pkt w klasy Punkt zdefiniowanej w klasie?
A. pkt Punkt;
B. Punkt() pkt;Twoja odpowiedź
C. pkt Punkt();
D. pkt= new Punkt();Poprawna odpowiedź
Niepoprawna odpowiedź. W języku PHP każda z podanych niepoprawnych opcji wynika z niewłaściwego zrozumienia konstrukcji obiektowej. Pierwszy błąd polega na próbie inicjalizacji obiektu przy użyciu składni pkt Punkt;, która jest niepoprawna, gdyż nie wykorzystuje słowa kluczowego new obowiązkowego podczas tworzenia instancji klasy. Taka składnia przypomina deklarację zmiennych typów prostych, co nie znajduje zastosowania w kontekście obiektowym. Innym powszechnym nieporozumieniem jest myślenie, że pkt Punkt(); jest poprawne, co sugeruje funkcję, jednakże PHP wymaga jawnego użycia new. Kolejna błędna koncepcja to Punkt() pkt;, która zdaje się używać składni funkcji z przypisaniem, co również jest niezgodne z semantyką PHP dla obiektów. Tego typu błędy często wynikają z prób zastosowania logiki innych języków programowania lub z niewłaściwej interpretacji składni PHP. Zrozumienie różnicy między deklaracją zmiennej a tworzeniem obiektu jest kluczowe dla efektywnego programowania obiektowego. Aby uniknąć takich błędów, warto zwrócić uwagę na dokumentację i praktykować pisanie kodu zgodnie z konwencjami przyjętymi w PHP, co nie tylko zwiększa czytelność kodu, ale także ułatwia późniejsze jego modyfikacje oraz integrację z większymi systemami. Poprawne zrozumienie konstrukcji obiektowej jest fundamentalne dla każdego programisty PHP, szczególnie w kontekście tworzenia aplikacji skalowalnych i łatwych do zarządzania.
Pytanie 30
W języku HTML stworzono odnośnik z symbolem #. Co się wydarzy po kliknięciu na podany link?
<a href="#dane">
A. Uruchomi się skrypt o nazwie dane
B. Zostanie użyty względny adres URL o nazwie daneTwoja odpowiedź
C. Strona przewinie się do elementu z id o nazwie danePoprawna odpowiedź
D. Otworzy się nowa karta przeglądarki zatytułowana dane
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi sugeruje, że po kliknięciu w odsyłacz zostanie wywołany skrypt o nazwie 'dane'. To podejście jest nieprawidłowe, ponieważ odsyłacz w HTML ze znakiem # nie wywołuje żadnych skryptów. Hiperłącza z # są używane wyłącznie do nawigacji po stronie i nie mają związku z uruchamianiem skryptów. Druga odpowiedź wskazuje, że otworzy się osobna karta przeglądarki o nazwie 'dane', co również jest błędne. Hiperłącza zaczynające się od # nie prowadzą do nowych kart ani okien; zamiast tego zmieniają lokalizację w bieżącej karcie przeglądarki. Kolejna z niepoprawnych koncepcji sugeruje, że zostanie wybrany adres względny URL o nazwie 'dane'. Jednakże wykorzystanie # odnosi się do lokalizacji na tej samej stronie, a nie do adresów względnych. Warto zrozumieć, że adresy względne są używane do nawigacji pomiędzy różnymi stronami, a nie do lokalizacji na tej samej stronie. Typowym błędem myślowym w takich przypadkach jest mylenie funkcji hiperłączy z różnymi innymi mechanizmami, takimi jak skrypty, nowe karty czy adresy względne. Zrozumienie tych różnic jest kluczowe dla skutecznego projektowania stron internetowych oraz optymalizacji ich nawigacji.
Pytanie 31
Model, w którym wszystkie dane są zapisane w jednej tabeli, określa się mianem
A. hierarchicznymTwoja odpowiedź
B. sieciowym
C. jednorodnymPoprawna odpowiedź
D. relacyjnym
Niepoprawna odpowiedź. Modele sieciowe i hierarchiczne są zupełnie inne od modelu jednorodnego, bo wprowadzają więcej złożoności w to, jak dane są trzymane. Na przykład model sieciowy pozwala tworzyć różne powiązania jak w grafie, co daje większą elastyczność, ale już dla prostych aplikacji to może być przesada. Z kolei model hierarchiczny z tą swoją drzewiastą strukturą też potrafi namieszać, bo trudniej wtedy zarządzać informacjami. Żeby dobrze zrozumieć, jak to wszystko działa, trzeba pojąć hierarchię i jak ze sobą te dane grają, co czasami bywa problematyczne, jak relacje się zmieniają. Moim zdaniem, w modelu relacyjnym, gdzie dane są w różnych tabelach połączonych kluczami, zyskujemy więcej elastyczności, ale też zwiększa się złożoność. Dlatego często można się zagubić w tych wszystkich możliwościach, a model jednorodny zazwyczaj jest najlepszy tylko tam, gdzie nic skomplikowanego nie trzeba. Większość systemów bazodanowych korzysta jednak z modelu relacyjnego, bo to zgodne ze standardami SQL, co ułatwia życie na dłuższą metę.
Pytanie 32
W bazie danych znajduje się tabela artykuły z kolumnami: nazwa, typ, producent, cena. Jakie polecenie należy użyć, aby wyświetlić wszystkie nazwy artykułów tylko o typie pralka, których cena mieści się w przedziale od 1000 PLN do 1500 PLN?
A. SELECT nazwa FROM artykuły WHERE typ='pralka' OR cena BETWEEN 1000 AND 1500
B. SELECT nazwa FROM artykuły WHERE typ='pralka' OR cena BETWEEN 1000 OR 1500Twoja odpowiedź
C. SELECT nazwa FROM artykuły WHERE typ='pralka' AND cena BETWEEN 1000 AND 1500Poprawna odpowiedź
D. SELECT nazwa FROM artykuły WHERE typ='pralka' AND cena FROM 1000 TO 1500
Niepoprawna odpowiedź. Pierwsza błędna odpowiedź ma problem z zapisem SQL, bo używa frazy 'cena FROM 1000 TO 1500', co się nie trzyma zasad. Operator 'FROM' nie może być tu użyty, powinno być BETWEEN. Druga odpowiedź korzysta z operatora OR, co sprawia, że można dostać wyniki, które są typu pralka, ale cena może być spoza tego przedziału. To nie jest to, czego szukamy i może zwrócić za dużo wyników. Co do trzeciej odpowiedzi, mimo użycia operatora BETWEEN, to też jest nie tak, bo znów jest OR, co powoduje, że wyciągniesz niechciane wyniki. Kiedy używasz AND i OR w złych miejscach, możesz uzyskać niejasne wyniki i zamącić logikę zapytania. Dlatego ważne jest, żeby trzymać się odpowiednich operatorów, w tej konkretnej sytuacji potrzebujesz AND dla obu warunków.
Pytanie 33
Aby sprawdzić, czy kod JavaScript działa poprawnie, należy skorzystać z:
A. kompilatora C++
B. konsoli w przeglądarce internetowejPoprawna odpowiedź
C. interpretera PHPTwoja odpowiedź
D. interpretera PERL
Niepoprawna odpowiedź. Sednem tego pytania jest to, gdzie w ogóle uruchamia się JavaScript. Interpreter PHP obsługuje kod wykonywany na serwerze, zanim strona trafi do użytkownika - JavaScriptu nie zna i go nie wykona. Kompilator C++ należy do zupełnie innego, kompilowanego języka i służy do budowania programów natywnych, a nie skryptów strony. Interpreter Perla to kolejny osobny język skryptowy, często używany na serwerze, lecz również niezwiązany z JS. JavaScript żyje w przeglądarce, dlatego do jego testowania używa się konsoli w narzędziach deweloperskich - pokazuje ona wynik działania kodu i wszystkie błędy.
Pytanie 34
W skrypcie JavaScript użyto metody DOM getElementsByClassName('akapit'). Ta metoda odniesie się do akapitu
A. <p>akapit</p>
B. <p id="akapit">akapit2</p>
C. <p href="/akapit">akapit3</p>Twoja odpowiedź
D. <p class="akapit">akapit4</p>Poprawna odpowiedź
Niepoprawna odpowiedź. Selekcja elementów DOM na podstawie ich klas jest kluczowym aspektem w pracy z JavaScript, jednak nie wszystkie odpowiedzi w tym teście są poprawnie skonstruowane. Odpowiedzi takie jak <p>akapit</p>, <p id="akapit">akapit2</p> oraz <p href="/akapit">akapit3</p> mają istotne braki w kontekście wykorzystania metody getElementsByClassName. Element <p>akapit</p> nie ma przypisanej klasy, co uniemożliwia jego selekcję przez tę metodę. Ważne jest, aby pamiętać, że getElementsByClassName wymaga, aby elementy miały przypisaną klasę, a nie aby były zdefiniowane przez inne atrybuty. Z kolei <p id="akapit">akapit2</p> posiada identyfikator, a nie klasę, co również nie umożliwia jego odnalezienia przez tę metodę. Identyfikatory są unikalne w kontekście dokumentu HTML i są bardziej odpowiednie do selekcji z wykorzystaniem metody getElementById. Ostatnia odpowiedź <p href="/akapit">akapit3</p> jest niewłaściwa, ponieważ atrybut href nie jest przypisany do elementów typu p, co jest technicznie błędne. Tego rodzaju błędy mogą wynikać z nieporozumień dotyczących struktury DOM i atrybutów HTML, co jest kluczowe do efektywnego programowania w JavaScript. Właściwe rozumienie różnic między klasami, identyfikatorami i innymi atrybutami jest fundamentalne dla skutecznego zarządzania elementami w kodzie skryptowym.
Pytanie 35
Co oznacza integralność referencyjna w relacyjnych bazach danych?
A. każdemu kluczowi głównemu odpowiada dokładnie jeden klucz obcy
B. klucz obcy musi równać się kluczowi głównemu powiązanej tabeli albo być NULLPoprawna odpowiedź
C. klucz główny i obcy nie mogą być pusteTwoja odpowiedź
D. klucz główny i obcy nie zawierają wartości NULL
Niepoprawna odpowiedź. Pozostałe opisy są nieprecyzyjne. Klucz obcy MOŻE być pusty, więc warunki „nie mogą być puste / bez NULL” są błędne. Jednemu kluczowi głównemu może odpowiadać WIELE kluczy obcych (relacja 1..n), nie „dokładnie jeden”. Integralność referencyjna to: klucz obcy wskazuje istniejący klucz główny albo jest NULL.
Pytanie 36
Zgodnie z zasadami ACID, które odnoszą się do realizacji transakcji, wymóg trwałości (ang. durability) oznacza, że
A. transakcja może w pewnych okolicznościach być podzielona na dwa niezależne etapy
B. w trakcie wykonywania transakcji dane mogą być zmieniane przez inne transakcjeTwoja odpowiedź
C. dane zatwierdzone przez transakcję powinny być dostępne niezależnie od wydarzeń, które nastąpią po jej zakończeniuPoprawna odpowiedź
D. w przypadku naruszenia spójności bazy danych transakcja usuwa tabele z kluczami obcymi
Niepoprawna odpowiedź. Wybranie odpowiedzi, że w przypadku naruszenia spójności bazy danych transakcja usuwa tabele z kluczami obcymi, nie jest zbyt mądre. Usuwanie tabel mogłoby naprawdę zaszkodzić strukturze danych i doprowadzić do poważnych problemów. Spójność baz danych to jeden z elementów ACID, ale to nie znaczy, że w razie kłopotów można po prostu rzucać się na tabele. W kontekście trwałości (durability) warto unikać działań, które mogą skutkować utratą danych. Zauważyłem też, że druga opcja sugeruje, że dane mogą być zmieniane przez inne transakcje w trakcie trwania jednej. To jest naruszenie zasady izolacji, która mówi, że każda transakcja powinna działać niezależnie. Zmiany równocześnie mogą prowadzić do chaosu, a zasady ACID starają się temu zapobiegać. Co do podziału transakcji na dwa etapy, to też jest niezgodne z zasadami ACID, zwłaszcza w kontekście trwałości i izolacji. Takie coś może tylko skomplikować sprawę i doprowadzić do niespójności. Dlatego, żeby dobrze zarządzać transakcjami w bazach danych, trzeba naprawdę zrozumieć zasady ACID i wdrażać strategie, które pomogą unikać błędów i zapewnić porządek.
Pytanie 37
Aby utworzyć relację wiele do wielu pomiędzy tabelami A i B, należy
A. wiele wpisów z tabeli A zduplikuje się w tabeli BTwoja odpowiedź
B. tabelę A połączyć z tabelą B przez utworzenie kluczy obcych
C. tabela A będzie miała identyczne pola jak tabela B
D. wprowadzić trzecią tabelę zawierającą klucze obce do tabel A i BPoprawna odpowiedź
Niepoprawna odpowiedź. Twierdzenie, że wystarczy połączyć tabelę A z tabelą B za pomocą zdefiniowania kluczy obcych, jest błędne, ponieważ taka operacja tworzy jedynie relację jeden do wielu, a nie wiele do wielu. W przypadku relacji jeden do wielu jedna tabela (np. tabela A) może być połączona z wieloma rekordami w drugiej tabeli (np. tabela B), ale nie odwrotnie. Co więcej, zduplikowanie wielu rekordów z tabeli A w tabeli B prowadziłoby do powstania redundancji i nieefektywnego zarządzania danymi, co jest sprzeczne z zasadami normalizacji baz danych. Wreszcie, posiadanie tabeli A z takimi samymi polami co tabela B jest nieadekwatne i niezgodne z ideą relacji wiele do wielu. Tego typu rozwiązanie prowadziłoby do chaosu w strukturze bazy danych oraz utrudniałoby jakiekolwiek operacje na zbiorach danych. Aby zrealizować relację wiele do wielu, należy zawsze wprowadzić osobną tabelę, która będzie w stanie efektywnie łączyć obie oryginalne tabele, umożliwiając ich prawidłowe powiązanie i zarządzanie danymi.
Pytanie 38
Aby sprawdzić poprawność składni kodu CSS, można skorzystać z:
A. konsolidatora
B. optymalizatoraTwoja odpowiedź
C. walidatoraPoprawna odpowiedź
D. debuggera
Niepoprawna odpowiedź. Pozostałe narzędzia dotyczą innych zadań. Debugger służy do krokowego śledzenia działania programu i podglądu zmiennych - CSS jednak niczego nie „wykonuje”, więc nie ma tu czego debugować. Konsolidator (linker) łączy skompilowane moduły w gotowy program, co z arkuszami stylów nie ma związku. Optymalizator może zmniejszyć i uprościć kod (np. minifikacja), ale jego celem jest wydajność, a nie wykrywanie błędów składni. Poprawność CSS sprawdza walidator, dlatego to on jest poprawną odpowiedzią.
Pytanie 39
Co umożliwia polecenie BACKUPLOG w MS SQL Server?
A. wykonanie pełnej kopii bazy
B. zalogowanie się do kopii zapasowejTwoja odpowiedź
C. kopię zapasową dziennika transakcjiPoprawna odpowiedź
D. odczyt komunikatów z tworzenia kopii
Niepoprawna odpowiedź. Pozostałe opisy nie pasują do tego polecenia. Pełną kopię całej bazy robi BACKUPDATABASE, a nie BACKUPLOG. „Zalogowanie się do kopii” czy „odczyt komunikatów” to nie są operacje tworzenia backupu. BACKUPLOG dotyczy konkretnie dziennika transakcji.
Pytanie 40
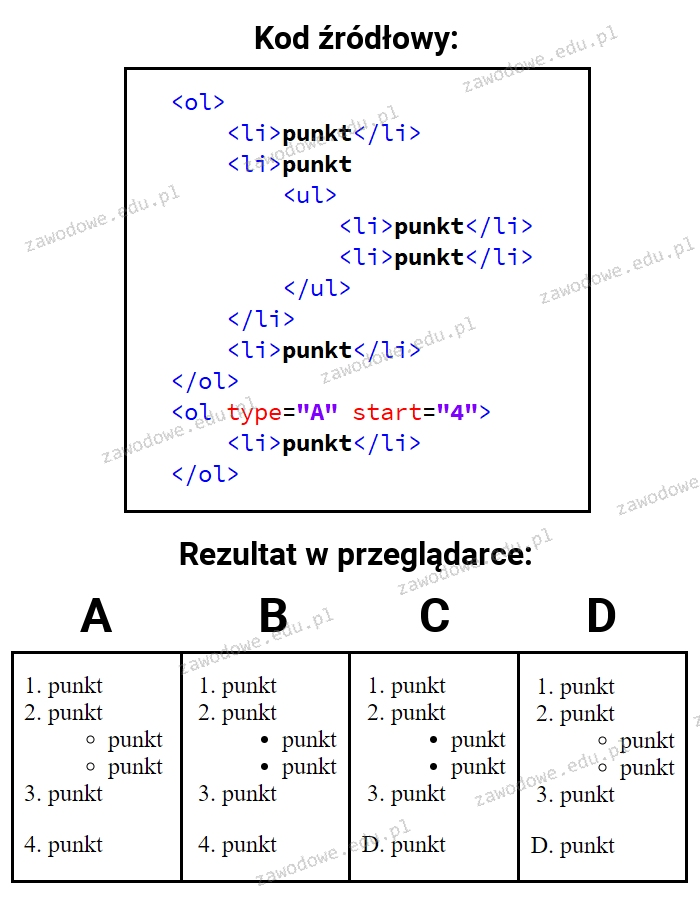
Jaki wynik pojawi się po wykonaniu zaprezentowanego kodu HTML?
A. Odpowiedź B
B. Odpowiedź A
C. Odpowiedź CTwoja odpowiedź
D. Odpowiedź DPoprawna odpowiedź
Niepoprawna odpowiedź. W analizie kodu HTML istotne jest zrozumienie struktury zagnieżdżonych list. Błędne odpowiedzi wynikają z niedokładnej interpretacji hierarchii i stylizacji list. Listy uporządkowane oznaczone tagiem ol oraz nieuporządkowane ul są podstawą do strukturalizacji informacji w HTML. Częsty błąd polega na nieuwzględnieniu, jak przeglądarki interpretują zagnieżdżone listy. Element ol z atrybutami type i start zmienia styl numeracji. Wersje z atrybutem type=A zmieniają numerację na literową, a start=4 decyduje o punkcie startowym. Pominięcie tego aspektu prowadzi do błędnych wniosków. Dobre praktyki obejmują klarowność struktury HTML poprzez właściwe użycie tagów i atrybutów, co jest kluczowe dla dostępności i użyteczności stron. Przy projektowaniu, warto pamiętać o spójności formatowania i zgodności z semantyką HTML, co poprawia doświadczenia użytkowników i wydajność SEO. Właściwe zrozumienie i zastosowanie atrybutów list ułatwia zarządzanie złożonymi strukturami na stronach internetowych.