Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 17 września 2026 01:48
Zakończenie: 17 września 2026 01:57
Egzamin niezdany
Wynik: 9/40 punktów (22,5%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 15% podejść do kwalifikacji INF.03.
Porównanie z 42305 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
GRANT CREATE, ALTER ON sklep.* TO adam; Zakładając, że użytkownik adam nie dysponował wcześniej żadnymi uprawnieniami, to polecenie SQL przyzna mu prawa jedynie do
A. tworzenia oraz modyfikacji struktury wszystkich tabel w bazie sklepPoprawna odpowiedź
B. tworzenia oraz modyfikacji struktury w tabeli sklep
C. wstawiania oraz modyfikacji danych we wszystkich tabelach bazy sklep
D. wstawiania oraz modyfikacji danych w tabeli sklepTwoja odpowiedź
Niepoprawna odpowiedź. Odpowiedzi, które sugerują, że użytkownik adam ma ograniczone prawa tylko do konkretnej tabeli lub tylko do wstawiania i zmiany danych, wynikają z mylnego zrozumienia mechanizmu przyznawania uprawnień w SQL. W kontekście opisanego polecenia, przyznawanie praw na poziomie tabeli (sklep.*) oznacza, że wszystkie tabele w bazie danych sklep są objęte tymi uprawnieniami. W praktyce, wstawianie oraz modyfikacja danych (DML) są różnymi operacjami od tworzenia i zmiany struktury tabel (DDL). Przyznanie uprawnień CREATE i ALTER jednoznacznie wskazuje na możliwość edytowania struktury bazy, a nie tylko na manipulację danymi. Wiele osób, które mogą mylić te dwa aspekty, może zakładać, że nadanie praw do konkretnej tabeli ogranicza się do operacji na danych, co jest mylnym podejściem. Mylne jest również ograniczanie praw do jednej tabeli, gdyż polecenie dotyczy wszystkich tabel w bazie. W związku z tym, aby poprawnie zarządzać uprawnieniami w bazie danych, należy zrozumieć różnice między uprawnieniami DDL i DML oraz ich zastosowanie w kontekście całej bazy danych, nie tylko pojedynczej tabeli.
Pytanie 2
W języku C do reprezentowania liczb zmiennoprzecinkowych używa się typu:
A.
int
Twoja odpowiedź
B.
bool
C.
double
Poprawna odpowiedź
D.
char
Niepoprawna odpowiedź. Pozostałe typy nie nadają się do liczb z częścią ułamkową. char przechowuje pojedynczy znak (a niskopoziomowo małą liczbę całkowitą), więc nie odwzoruje wartości typu 3.14. int trzyma wyłącznie liczby całkowite - przypisanie ułamka spowodowałoby odcięcie części po przecinku. bool przechowuje tylko wartość logiczną (prawda/fałsz), czyli zupełnie inny rodzaj danych. Liczby zmiennoprzecinkowe reprezentuje double (lub float), dlatego to on jest poprawny.
Pytanie 3
Mamy tabelę firm, która zawiera takie kolumny jak: nazwa, adres, NIP, obrot (obrót w ostatnim miesiącu), rozliczenie, status. Wykonanie zapytania SQL SELECT spowoduje wyświetlenie
SELECT nazwa, NIP FROM firmy WHERE obrot < 4000;
A. wszystkie informacje o firmach, które w minionym miesiącu osiągnęły obrót poniżej 4000 zł
B. wszystkie dane o firmach, które w ostatnim miesiącu miały obrót na poziomie co najmniej 4000 zł
C. tylko nazwę i numer NIP przedsiębiorstw, które w poprzednim miesiącu miały obrót wynoszący przynajmniej 4000 złTwoja odpowiedź
D. tylko nazwę i numer NIP przedsiębiorstw, które w ostatnim miesiącu miały obrót mniejszy niż 4000 złPoprawna odpowiedź
Niepoprawna odpowiedź. W przypadku rozważania niewłaściwych odpowiedzi należy zwrócić uwagę na błędne interpretacje warunków kwerendy SQL i ich wpływ na wynik selekcji Niepoprawne odpowiedzi mogą wynikać z niepełnego zrozumienia struktury zapytań SQL i sposobu działania klauzul SELECT oraz WHERE Jednym z częstych błędów jest założenie że kwerenda zwraca wszystkie dane tabeli gdy faktycznie pobiera jedynie określone kolumny jak w przypadku wybierania tylko nazwy i NIPu Błąd ten może prowadzić do nadmiernego zużycia zasobów bazy danych oraz generować niepotrzebne informacje które utrudnią analizę Kolejny błąd to niewłaściwa interpretacja warunku WHERE który w tym przypadku filtruje rekordy według wartości w kolumnie obrot Zamiast skupić się na wyodrębnieniu tych z obrotem mniejszym niż 4000 można błędnie przyjąć że dotyczy to tylko tych z określoną minimalną wartością co skutkuje wyjściem poza zamierzone kryteria analityczne Wprowadzenie takich błędów może wynikać z braku dokładności w lekturze zapytań lub nieznajomości podstawowych zasad dotyczących pracy z bazami danych Efektywne wykorzystanie SQL wymaga zrozumienia nie tylko składni ale również kontekstu biznesowego w jakim dane operacje są wykonywane co pozwala na prawidłową interpretację wyników i ich praktyczne zastosowanie w różnych analiza
Pytanie 4
Wskaż poprawną definicję stylu CSS dla przycisku typu submit o właściwościach: czarny kolor tła, brak obramowania, marginesy wewnętrzne 5 px.
input[type=submit] {
  background-color: #000000;
  border: none;
  padding: 5px;
}                         A.

input[type=submit] {
  background-color: #ffffff;
  border: none;
  padding: 5px;
}                         B.

input=submit {
  background-color: #000000;
  border: none;
  margin: 5px;
}                         C.

input=submit {
  background-color: #000000;
  border: 0px;
  margin: 5px;
}                         D.
A. D.Twoja odpowiedź
B. C.
C. B.
D. A.Poprawna odpowiedź
Niepoprawna odpowiedź. Wybrana przez Ciebie odpowiedź nie jest prawidłowa, ale nie martw się, ważne jest, żeby zrozumieć dlaczego. CSS to kaskadowe arkusze stylów, które umożliwiają określenie stylu strony internetowej. Kluczowym aspektem CSS jest składnia, która obejmuje selektor, właściwość i wartość. W przypadku przycisku typu 'submit', selektorem jest 'input[type='submit']'. Właściwością jest 'background-color', 'border' lub 'padding', a wartością jest 'black', 'none' lub '5px' odpowiednio. Niepoprawne odpowiedzi nie spełniają wszystkich lub niektórych z tych wymagań. Mogą one ignorować wymagany czarny kolor tła, brak obramowania, marginesy wewnętrzne 5 px lub wszystkie te elementy. Inne błędne odpowiedzi mogą zawierać nieprawidłowe selektory, właściwości lub wartości. Pamiętaj, że praktyka prowadzi do mistrzostwa, więc nie zniechęcaj się, jeśli nie udało ci się tego dostrzec za pierwszym razem.
Pytanie 5
Tworząc tabelę produkty, dla pola „cena” (kwota z groszami) najlepszy typ danych to:
A.
ENUM
B.
INTEGER(11)
Twoja odpowiedź
C.
TINYTEXT
D.
DECIMAL(10,2)
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe typy nie nadają się do dokładnej kwoty. ENUM pozwala wybrać jedną z wcześniej zdefiniowanych wartości tekstowych - nie służy do liczb ani cen. INTEGER przechowuje wyłącznie liczby całkowite, więc nie zapisze groszy (części po przecinku). TINYTEXT to typ tekstowy - kwota zapisana jako tekst utrudniałaby obliczenia i sortowanie po wartości. Dokładną cenę z groszami przechowuje DECIMAL(10,2), dlatego ta odpowiedź jest poprawna.
Pytanie 6
Czym jest relacja w bazach danych?
A. logicznym połączeniem tabelTwoja odpowiedź
B. połączeniem dwóch pól w obrębie jednej tabeli
C. kluczem głównym w relacji tabel
D. algebraicznym połączeniem tabel
Poprawna odpowiedź. Relacja w bazach danych to logiczne połączenie tabel, które umożliwia organizację i zarządzanie danymi w sposób umożliwiający ich efektywne przetwarzanie. W kontekście baz danych relacyjnych, relacje tworzone są na podstawie kluczy, które pozwalają na łączenie danych z różnych tabel. Na przykład, w bazie danych e-commerce, tabela 'Klienci' może być połączona z tabelą 'Zamówienia' przez klucz klienta. Dzięki temu, gdy zapytamy o zamówienia konkretnego klienta, silnik bazy danych może wykonać zapytanie łączące te obie tabele, dostarczając spójny zestaw danych. Taki model relacyjny oparty jest na teorii zbiorów i algebrze relacyjnej, co pozwala na skomplikowane operacje, takie jak łączenie, filtrowanie i agregowanie danych. W praktyce, relacje w bazach danych są kluczowe dla zapewnienia integralności danych, eliminacji redundancji oraz zwiększenia wydajności operacji na danych. Standardy takie jak SQL oparte są na tych koncepcjach, co czyni je fundamentalnymi w programowaniu baz danych.
Pytanie 7
Cechy przedstawione w tabeli dotyczą?
Strony ustalają dążenie do konkretnego wyniku
Ważny jest efekt pracy, a nie sposób jej realizacji
Zleceniodawca przekazuje za wykonawcę zaliczkę na podatek dochodowy
A. umowy o pracęTwoja odpowiedź
B. umowy agencyjnej
C. umowy o dziełoPoprawna odpowiedź
D. umowy zlecenia
Niepoprawna odpowiedź. Umowa o pracę różni się od umowy o dzieło w kilku kluczowych aspektach. Przede wszystkim, umowa o pracę koncentruje się na procesie wykonywania pracy, a nie tylko na jej rezultacie. Pracownik w ramach umowy o pracę podlega określonym przepisom dotyczącym czasu pracy, urlopów i innych świadczeń pracowniczych, co nie ma miejsca w umowie o dzieło. Z kolei umowa zlecenia także skupia się bardziej na wykonywaniu usług niż na osiąganiu konkretnego rezultatu, co oznacza, że zleceniobiorca powinien wykonać powierzone zadanie z należytą starannością, ale niekoniecznie osiągnąć określony efekt końcowy. Umowa agencyjna jest jeszcze innym typem kontraktu, w którym agent działa na rzecz zleceniodawcy, ale niekoniecznie musi dostarczać konkretny produkt lub usługę końcową. Typowym błędem jest mylenie tych umów z uwagi na podobieństwa w formalnościach czy obowiązkach podatkowych, jednak kluczowe jest zrozumienie różnic w zakresie oczekiwań co do efektu pracy i sposobu jej rozliczania.
Pytanie 8
Którą instrukcję pętli stosuje się do wykonania określonej (znanej z góry) liczby powtórzeń?
A.
switch
Twoja odpowiedź
B.
foreach
C.
if
D.
for
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe instrukcje nie realizują pętli o zadanej liczbie powtórzeń. switch wybiera jedną z gałęzi w zależności od wartości wyrażenia i wykonuje się raz, a nie wielokrotnie. foreach jest pętlą, ale przechodzi po kolejnych elementach tablicy - liczba obrotów zależy od jej rozmiaru, a nie od podanej liczby. if to instrukcja warunkowa, która tylko sprawdza warunek i nie powtarza kodu. Powtórzenie kodu znaną z góry liczbę razy zapewnia for z licznikiem, dlatego to ona jest poprawna.
Pytanie 9
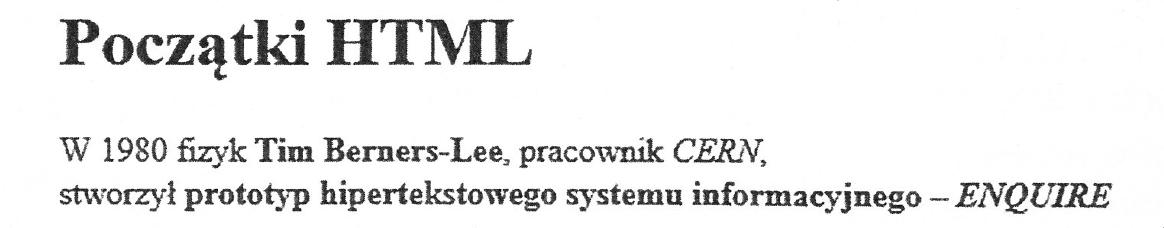
Strona internetowa została napisana w języku XHTML. Który z poniższych kodów przedstawia implementację zamieszczonego fragmentu strony, przy założeniu, że nie zdefiniowano żadnych stylów CSS?
A. <b>Początki HTML</b><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<hr /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>
B. <h1>Początki HTML</h1><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<i>prototyp hipertekstowego systemu informacyjnego - <b>ENQUIRE</b></i></p>Twoja odpowiedź
C. <b>Początki HTML</b><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>
D. <h1>Początki HTML</h1><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>Poprawna odpowiedź
Niepoprawna odpowiedź. Wybory, które nie używają <h1> do tytułu, nie oddają poprawnej struktury semantycznej wymaganej w XHTML. Oznaczenie nagłówka jako <b> jest niewłaściwe, ponieważ <b> jest znacznikiem stylizującym tekst jako pogrubiony, ale nie semantycznie nie mówi, że jest to nagłówek. XHTML, będąc bardziej restrykcyjną wersją HTML, wymaga ścisłego trzymania się hierarchii nagłówków, co pomaga w czytelności dokumentu przez oprogramowanie wspomagające i wyszukiwarki. Użycie <hr /> w odpowiedzi trzeciej jako linia pozioma jest semantycznie mylące, gdyż nie oddziela to części tekstu, a jedynie wizualnie dzieli fragmenty, co w XHTML, gdzie semantyka jest kluczowa, nie jest zalecane. Strona zapisana w XHTML powinna używać tagów zgodnie z ich przeznaczeniem, co poprawia dostępność i zrozumienie kodu. Dodatkowo, nieprawidłowo ustrukturyzowane znaczniki mogą prowadzić do problemów z parsowaniem przez przeglądarki, co jest niepożądane w profesjonalnym tworzeniu stron internetowych. Dlatego odpowiednia semantyka i poprawna struktura są kluczowe w projektowaniu stron zgodnych z XHTML.
Pytanie 10
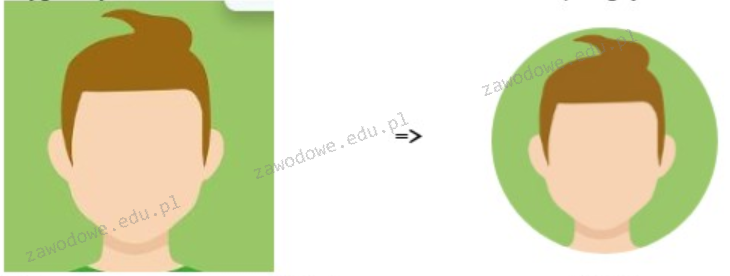
Wskaż styl CSS za pomocą, którego uzyskano przedstawiony efekt
Styl 1.
img {
  width: 100px;
  border-radius: 10%;
}
Styl 2.
img {
  width: 100px;
  border-radius: 50px;
}
Styl 3.
img {
  width: 100px;
  border: 50% green;
}
Styl 4.
img {
  width: 100px;
  shape: circle;
}
A. Styl 4.Twoja odpowiedź
B. Styl 1.
C. Styl 3.
D. Styl 2.Poprawna odpowiedź
Niepoprawna odpowiedź. Niestety, wybrałeś niepoprawną odpowiedź. Poprawną odpowiedzią jest 'Styl 2.', który wykorzystuje właściwość CSS border-radius z wartością 50px do zaokrąglania rogów obrazka. Zobaczmy, dlaczego pozostałe style są niepoprawne. 'Styl 1.' ma za małą wartość zaokrąglenia, co nie daje oczekiwanego efektu. Właściwość border-radius musi mieć odpowiednią wartość, aby uzyskać pożądane zaokrąglenie. 'Styl 3.' zawiera niepoprawną wartość, a mianowicie kolor. Kolor nie jest właściwą wartością dla border-radius, co pokazuje, jak ważne jest zrozumienie, jakie wartości są akceptowane dla różnych właściwości CSS. 'Styl 4.' używa właściwości shape, która nie istnieje w CSS. To jest błąd typowy dla osób, które nie są jeszcze pewne, które właściwości są dostępne w CSS. Jest to jasnym przykładem, dlaczego nauka i praktyka CSS są tak ważne do tworzenia atrakcyjnych i funkcjonalnych stron internetowych.
Pytanie 11
Aby zwiększyć wydajność operacji na bazie danych, należy dla pól, które są często wyszukiwane lub sortowane
A. utworzyć indeksPoprawna odpowiedź
B. dodać więzy integralności
C. dodać klucz obcyTwoja odpowiedź
D. stworzyć osobną tabelę przechowującą tylko te pola
Niepoprawna odpowiedź. Praca nad dobrą wydajnością baz danych wymaga, żeby zrozumieć, że różne metody optymalizacji mają swoje cele, a działają w różny sposób. Jak dodasz klucz obcy do tabeli, to nie przyspieszysz wyszukiwania czy sortowania danych. Ten klucz ma inne zadanie, na przykład dba o to, żeby każdy rekord w tabeli 'Zamówienia' odnosił się do klienta w tabeli 'Klienci'. To jest ważne, ale nie zwiększy szybkości operacji. Wprowadzenie różnych reguł, jak unikalność czy not null, też nie przyspieszy wyszukiwania, lecz chroni dane przed błędami. Czasami lepiej jest stworzyć osobną tabelę, ale to może skomplikować strukturę bazy danych i wprowadzić więcej kłopotów przy zarządzaniu, zwłaszcza z relacjami między tabelami. Źle przeprowadzona optymalizacja bazy danych może prowadzić do tego, że system będzie wolniejszy przez nadmiarowość. Dlatego ważne jest, żeby dobrze rozumieć różnice między technikami i jak je stosować, żeby osiągnąć najlepsze wyniki w wydajności bazy danych.
Pytanie 12
Funkcja pg_connect w języku PHP służy do nawiązania połączenia z bazą danych
A. MS ACCESS
B. mySQLTwoja odpowiedź
C. PostgreSQLPoprawna odpowiedź
D. MS SQL
Niepoprawna odpowiedź. Wszystkie inne odpowiedzi dotyczą baz danych, które nie są obsługiwane przez funkcję pg_connect. Użycie MS SQL, MS ACCESS lub mySQL w kontekście pg_connect wprowadza w błąd, ponieważ każda z tych technologii ma swoje własne metody połączenia. MS SQL, na przykład, jest systemem zarządzania bazą danych stworzonym przez Microsoft i do połączeń z tą bazą używa się funkcji syb_connect lub PDO w zależności od preferencji programisty. MS ACCESS, z kolei, jest bazą danych, która często jest wykorzystywana w mniejszych aplikacjach i wymaga innych podejść do połączeń, często przy użyciu ODBC lub DAO. MySQL, popularna baza danych open source, używa funkcji mysqli_connect lub PDO_MySQL. Typowe błędy myślowe prowadzące do nieprawidłowych odpowiedzi często wynikają z nieznajomości specyfiki i architektury różnych systemów baz danych oraz błędnego utożsamiania ich z funkcjami PHP. Każde z tych rozwiązań ma swoje unikalne cechy i różnice, które są istotne dla projektowania aplikacji oraz ich późniejszego rozwoju.
Pytanie 13
W przedstawionym stylu CSS w ramce zdefiniowano klasę uzytkownik. Tekst na stronie będzie wyświetlany czcionką w kolorze niebieskim dla
p.uzytkownik { color: blue; }
A. wyłącznie znaczników tekstowych takich jak <p>, <h1>
B. wszystkich akapitówTwoja odpowiedź
C. dowolnych znaczników w sekcji <body>, które mają przypisaną klasę uzytkownik
D. akapitów, którym przypisano klasę uzytkownikPoprawna odpowiedź
Niepoprawna odpowiedź. Zrozumienie, dlaczego niektóre odpowiedzi są niepoprawne, wymaga wiedzy o podstawach stylowania CSS. Odpowiedzi błędne mogą wynikać z nieprawidłowego rozumienia, jak działają selektory w CSS. CSS pozwala na precyzyjne określenie, które elementy HTML będą podlegały określonemu stylowi, dzięki użyciu selektorów. W przedstawionym przykładzie p.uzytkownik jest selektorem specyficznym, który oznacza wszystkie elementy <p> (paragrafy) z klasą uzytkownik. Selekcje te nie dotyczą wszystkich paragrafów, a jedynie tych z określoną klasą. Błędne przekonanie, że styl dotyczy wszystkich paragrafów, wynika z pominięcia faktu, że klasa jest specyfikatorem. Podobnie, twierdzenie, że dowolne znaczniki w sekcji <body> z klasą uzytkownik zostaną sformatowane, ignoruje fakt, że selektor dotyczy konkretnie paragrafów. Kluczową kwestią jest rozróżnienie między selektorami tagów, klas, ID i ich kombinacjami. Właściwe zrozumienie tych zasad pozwala na efektywne i precyzyjne stosowanie reguł CSS, co jest fundamentem tworzenia spójnych i estetycznych interfejsów użytkownika.
Pytanie 14
Prawa CREATE, ALTER, DROP nadane w GRANT dotyczą:
A. przyznawania uprawnień innym
B. pobierania danych z bazy
C. pracy ze STRUKTURĄ bazyTwoja odpowiedź
D. pracy z danymi
Poprawna odpowiedź. Polecenia CREATE, ALTER i DROP należą do języka DEFINICJI danych (DDL) - tworzą, zmieniają i usuwają OBIEKTY bazy (tabele, widoki). Nadanie tych praw w GRANT pozwala więc ingerować w STRUKTURĘ bazy, a nie w same dane. Zapamiętaj: CREATE/ALTER/DROP kształtują „szkielet” bazy.
Pytanie 15
Jaką operację trzeba wykonać podczas edytowania zdjęcia w programie graficznym, aby zamienić białe tło na przezroczystość?
A. Skadrować obrazTwoja odpowiedź
B. Dodać kanał alfaPoprawna odpowiedź
C. Zmienić saturację obrazu
D. Maksymalnie zmniejszyć jasność
Niepoprawna odpowiedź. Wybór odpowiedzi, która nie dotyczy dodania kanału alfa, prowadzi do fundamentalnych nieporozumień w zakresie obróbki obrazów w edytorach graficznych. Skadrowanie obrazu może pomóc w wyeliminowaniu niepożądanych elementów, jednak nie rozwiązuje problemu białego tła. Skadrowanie polega na przycinaniu obrazu do określonego obszaru, co oznacza, że wciąż zostanie zachowane białe tło, które nie jest usuwane, a jedynie ograniczane w widoczności. Zmiana saturacji obrazu odnosi się do intensywności kolorów, co również nie ma wpływu na przezroczystość tła - biały kolor pozostanie obecny, ale może stać się mniej intensywny. Modyfikacja jasności obrazu, w tym maksymalne jej zmniejszenie, skutkuje jedynie przyciemnieniem całego obrazu, a biały kolor zmienia się w szarość lub czernie, ale nie prowadzi do uzyskania przezroczystości. W praktyce, zrozumienie, że przezroczystość wymaga specyficznej manipulacji kanałem alfa, jest kluczowe dla skutecznej edycji grafiki. Często występuje błąd myślowy polegający na myleniu różnych operacji edycyjnych z efektem końcowym, dlatego ważne jest zdobycie wiedzy na temat podstawowych pojęć związanych z formatowaniem obrazów oraz ich właściwościami w kontekście obróbki graficznej.
Pytanie 16
Którą instrukcją można zastąpić pętlę for?
A.
while
Poprawna odpowiedź
B.
case
C.
switch
D.
continue
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe konstrukcje nie są pętlami. case to etykieta wewnątrz switch, switch wybiera wariant, a continue tylko przeskakuje do następnej iteracji wewnątrz pętli. Pętlę for zastępuje while.
Pytanie 17
Elementem odpowiadającym imieniu Agata w zaprezentowanej tablicy JavaScript jest:
var Imiona = new Array('Anna','Joanna','Monika','Agata');
A. Imiona['Agata'];
B. Imiona[Agata];
C. Imiona[3];Poprawna odpowiedź
D. Imiona[4];Twoja odpowiedź
Niepoprawna odpowiedź. Wybór Imiona[4] jest błędny, ponieważ jak wcześniej wspomniano, tablice w JavaScript są indeksowane od zera i tablica Imiona ma cztery elementy, co oznacza, że najwyższy indeks dostępny w tym przypadku to 3. Próba uzyskania dostępu do elementu o indeksie 4 zwróci undefined, co jest powszechnym źródłem błędów podczas programowania. Kolejna nieprawidłowa odpowiedź, Imiona[Agata], również nie jest poprawna, gdyż nie możemy używać wartości zmiennych (takich jak 'Agata') jako indeksów w tablicach bez wcześniejszej deklaracji. W JavaScript zmienne muszą być zdefiniowane, aby można było ich użyć. Imiona['Agata'] to kolejny przykład błędnego podejścia. Chociaż JavaScript pozwala na uzyskiwanie dostępu do właściwości obiektów za pomocą notacji z kropką lub bracket notation, w przypadku tablic nie można używać nazw elementów, które nie są ich indeksami. Tego rodzaju błędy są często wynikiem niepełnego zrozumienia różnicy między tablicami a obiektami w JavaScript. Zrozumienie tych różnic oraz praktykowanie poprawnego indeksowania tablic jest kluczowe dla każdego programisty, aby uniknąć trudności w kodowaniu oraz zapewnić, że aplikacje działają zgodnie z zamierzeniem.
Pytanie 18
Na czym polega zasada działania algorytmów zachłannych?
A. na przeszukiwaniu danych aż do znalezienia rozwiązania
B. na dzieleniu problemu na mniejsze podproblemy
C. na wybieraniu rozwiązania najkorzystniejszego na danym etapieTwoja odpowiedź
D. na odwoływaniu się funkcji do samej siebie
Poprawna odpowiedź. Algorytm zachłanny (greedy) buduje rozwiązanie krok po kroku, w każdym etapie wybierając opcję, która w danym momencie wydaje się najkorzystniejsza (lokalnie optymalna), bez cofania wcześniejszych decyzji. Jest prosty i szybki, a dla niektórych problemów daje rozwiązanie optymalne (np. wydawanie reszty pewnymi zestawami monet, algorytm Dijkstry, kod Huffmana). Bywa jednak, że lokalnie najlepszy wybór nie prowadzi do globalnie najlepszego wyniku. Dlatego zasada zachłanna to wybieranie najkorzystniejszej opcji na danym etapie.
Pytanie 19
Jaką wartość uzyska zmienna x po wykonaniu poniższego kodu PHP?
mysqli_query($db, "DELETE FROM produkty WHERE status < 0");$x = mysqli_affected_rows($db);
A. Liczbę wierszy, które zostały dodane do tabeli produkty.
B. Liczbę wierszy w tabeli produkty, dla których pole status przekracza zero.
C. Liczbę wierszy przetworzonych przez zapytanie DELETE FROM.Twoja odpowiedź
D. Liczbę wierszy, które znajdują się w bazie danych.
Poprawna odpowiedź. Poprawna odpowiedź dotyczy liczby wierszy przetworzonych przez zapytanie DELETE FROM w bazie danych. Funkcja mysqli_affected_rows($db) zwraca liczbę wierszy, które zostały zmodyfikowane przez ostatnie wykonane zapytanie na danym połączeniu z bazą danych. W przypadku zapytania DELETE, zwróci ona liczbę wierszy, które zostały usunięte w wyniku działania tego zapytania. W kontekście dobrych praktyk, zawsze warto sprawdzać, jakie operacje zostały wykonane na bazie danych, aby zrozumieć wpływ zapytań na dane. Na przykład, w aplikacjach e-commerce, przed usunięciem produktów, można wykorzystać tę informację do potwierdzenia, że usunięcie danych nie wpływa negatywnie na inne elementy systemu. Użycie tej funkcji pozwala na efektywne zarządzanie danymi oraz na utrzymanie spójności w bazie danych, co jest kluczowe w kontekście bezpieczeństwa i integralności danych.
Pytanie 20
Źródłem danych dla raportu może być
A. inny raportTwoja odpowiedź
B. makropolecenie
C. tabelaPoprawna odpowiedź
D. zapytanie INSERT INTO
Niepoprawna odpowiedź. Inny raport, chociaż może zawierać dane, nie jest źródłem danych w sensie strukturalnym, lecz raczej wynikiem przetwarzania informacji zawartych w tabelach. Raporty są generowane na podstawie danych zgromadzonych w tabelach, a nie bezpośrednio z innych raportów, co ogranicza ich użyteczność jako źródła danych. Makropolecenie, będące zbiorem instrukcji do automatyzacji procesów, również nie stanowi źródła danych, lecz narzędzie do przetwarzania lub manipulacji danymi, które znajdują się w tabelach. Użycie makropolecenia może prowadzić do generowania raportów, jednak sama jego struktura nie zawiera danych, które mają być raportowane. Zapytanie INSERT INTO jest instrukcją SQL używaną do dodawania danych do tabeli, ale nie jest źródłem danych w kontekście raportowania. To polecenie umożliwia wprowadzenie nowych rekordów do tabeli, a więc odgrywa rolę w aktualizacji danych, a nie w ich źródłowym dostarczaniu. Każda z tych opcji nie spełnia wymogu bycia źródłem danych w kontekście tworzenia raportu, co czyni je niewłaściwymi odpowiedziami.
Pytanie 21
W posiadanej tabeli zwanej przedmioty, która zawiera kolumny ocena oraz uczenID, aby wyliczyć średnią ocen dla ucznia z ID równym 7, należy użyć zapytania
A. AVG SELECT ocena FROM przedmioty WHERE uczenID = 7Twoja odpowiedź
B. SELECT COUNT(ocena) FROM przedmioty WHERE uczenID = 7
C. SELECT AVG(ocena) FROM przedmioty WHERE uczenID = 7Poprawna odpowiedź
D. COUNT SELECT ocena FROM przedmioty WHERE uczenID = 7
Niepoprawna odpowiedź. Wybór innych opcji jest niepoprawny z kilku powodów. Odpowiedź, która zawiera 'AVG SELECT ocena FROM przedmioty WHERE uczenID = 7;' jest błędna, ponieważ nieprawidłowo formułuje składnię SQL. W SQL kolejność słów w zapytaniach jest kluczowa, a funkcje agregujące, takie jak AVG, muszą być używane po słowie SELECT. Z kolei wybór 'COUNT SELECT ocena FROM przedmioty WHERE uczenID = 7;' również jest błędny, ponieważ 'COUNT' jest funkcją, która zlicza ilość wierszy spełniających określone warunki, a nie średnią, co nie odpowiada zadaniu. Warto zauważyć, że mylenie funkcji agregujących, takich jak AVG i COUNT, to powszechny błąd, który wynika z niepełnego zrozumienia ich funkcji. W przypadku zapytania 'SELECT COUNT(ocena) FROM przedmioty WHERE uczenID = 7;' z kolei, chociaż składnia jest poprawna, zapytanie to zlicza liczbę ocen, a nie ich średnią, co nie spełnia wymagań pytania. To podejście nie tylko wprowadza w błąd, ale także może prowadzić do nieprawidłowych analiz danych. Kluczowe jest zrozumienie, że różne funkcje agregujące mają różne zastosowania i nie można ich stosować zamiennie. Użytkownicy pracujący z bazami danych powinni szczególnie zwracać uwagę na typy danych, jakie są przechowywane w ich tabelach oraz na odpowiednią składnię SQL, aby uzyskać zamierzony efekt.
Pytanie 22
W języku PHP zapis $b++ jest równoważny zapisowi
A. $b = $b + 1Poprawna odpowiedź
B. $b == $b + $b
C. $b = $b + $b
D. $b == $bTwoja odpowiedź
Niepoprawna odpowiedź. Operator $b++ w PHP bywa mylony z różnymi innymi operacjami na zmiennych, głównie dlatego, że wygląda niepozornie, a pod spodem robi konkretną arytmetykę. Kluczowe jest to, że ++ oznacza zawsze inkrementację, czyli zwiększenie wartości liczbowej dokładnie o 1. Nie ma tu ani porównania, ani mnożenia, ani dodawania wartości do samej siebie w sensie podwajania. Jeśli ktoś patrzy na zapis $b == $b i kojarzy go z jakąś równoważnością, to trzeba jasno powiedzieć: podwójny znak równości w PHP jest operatorem porównania, a nie przypisania. Taka instrukcja sprawdza tylko, czy dwie wartości są równe logicznie, i zwraca true albo false. Nie zmienia ona w ogóle zawartości zmiennej b. W kodzie typu $b == $b + $b zachodzi więc tylko porównanie, które zwykle będzie fałszywe, bo jedna strona jest dwa razy większa od drugiej, ale sama zmienna b pozostaje bez zmian. To jest typowy błąd początkujących: mylenie = (przypisanie) z == (porównanie). Drugi obszar nieporozumień to dodawanie zmiennej do samej siebie. Zapis $b = $b + $b oznacza podwojenie wartości, czyli matematycznie 2 * b. To zupełnie coś innego niż $b++, które robi b = b + 1. W algorytmach, gdzie liczymy np. liczbę elementów, iterację po tablicy, licznik odwiedzin, użycie podwojenia zamiast inkrementacji kompletnie rozwala logikę programu. Z mojego doświadczenia wynika, że wiele takich pomyłek bierze się z pośpiechu i braku nawyku dokładnego czytania operatorów. W dobrych praktykach programistycznych zaleca się używanie operatorów skróconych, takich jak ++, --, +=, ale tylko wtedy, gdy dokładnie rozumiemy, co one robią. Warto też pamiętać, że w PHP semantyka operatorów porównania i przypisania jest jasno zdefiniowana w dokumentacji, a trzymanie się tych standardów pozwala uniknąć subtelnych błędów logicznych. Dlatego przy każdym tego typu pytaniu warto na spokojnie przeanalizować, czy wynik ma zmieniać wartość zmiennej, czy tylko ją sprawdzać, oraz o ile ma się ta wartość zmienić: o 1, czy może ma być podwojona lub pomnożona przez coś innego.
Pytanie 23
W języku SQL używanym przez bazę danych MySQL atrybut UNIQUE w poleceniu CREATE TABLE
A. uniemożliwia wprowadzenie wartości NULLTwoja odpowiedź
B. jest stosowany jedynie w przypadku kolumn liczbowych
C. jest używany, jeżeli wartości w danej kolumnie nie mogą się powtarzaćPoprawna odpowiedź
D. wymusza niepowtarzalne nazwy kolumn tabeli
Niepoprawna odpowiedź. W pierwszej niepoprawnej odpowiedzi wspomniano o wymogu unikatowości nazw pól tabeli. To stwierdzenie jest błędne, ponieważ atrybut UNIQUE nie dotyczy nazw kolumn, lecz wartości przechowywanych w tych kolumnach. W SQL możemy mieć wiele kolumn w tabeli o tej samej nazwie, o ile są one częścią różnych tabel. Zatem, atrybut UNIQUE nie ma wpływu na nazywanie kolumn, a jego głównym celem jest zapewnienie unikalności danych. Kolejną nieprawidłową informacją jest stwierdzenie, że atrybut UNIQUE blokuje możliwość wpisania wartości NULL. W rzeczywistości, w MySQL atrybut UNIQUE pozwala na wprowadzenie wartości NULL, ponieważ wartość NULL jest traktowana jako brak danych, co oznacza, że różne rekordy mogą mieć NULL jako wartość w kolumnie oznaczonej przez UNIQUE. Wreszcie, twierdzenie, że atrybut UNIQUE jest stosowany tylko w przypadku pól liczbowych, jest również fałszywe. Atrybut UNIQUE można zastosować do dowolnego typu danych, w tym tekstowych, datowych czy liczbowych. W praktyce, atrybut ten może być używany w różnych kontekstach, aby zapewnić unikalność danych w każdej kolumnie, niezależnie od ich typów.
Pytanie 24
Podczas zapisywania hasła użytkownika w serwisie internetowym (np. w bankowości online), w celu zabezpieczenia go przed ujawnieniem, zazwyczaj stosuje się funkcję
A. mieszających
B. kluczaTwoja odpowiedź
C. abstrakcyjnych
D. cyklometrycznych
Poprawna odpowiedź. Zastosowanie klucza do zabezpieczenia haseł użytkowników jest kluczowym elementem w praktykach zarządzania bezpieczeństwem informacji. Klucz, często w połączeniu z techniką haszowania, umożliwia stworzenie bezpiecznego mechanizmu przechowywania haseł. Gdy użytkownik tworzy hasło, używa się funkcji haszującej, która przyjmuje hasło oraz unikalny klucz i generuje z nich wynikowy hash. Taki hash jest następnie przechowywany w bazie danych zamiast samego hasła. Aby zweryfikować, czy hasło podane przez użytkownika jest poprawne, system ponownie haszuje wprowadzone hasło z tym samym kluczem i porównuje wynik z tym przechowywanym w bazie. Dzięki temu, nawet w przypadku wycieku danych, napastnik nie uzyskuje dostępu do rzeczywistych haseł. Dobre praktyki branżowe, takie jak stosowanie soli (random salt) oraz iteracyjnych algorytmów haszujących (np. PBKDF2, bcrypt), dodatkowo wzmacniają proces bezpieczeństwa haseł, czyniąc je bardziej odpornymi na ataki typu brute-force.
Pytanie 25
Na podstawie jakiego parametru oraz z ilu tabel będą zwrócone wiersze w wyniku podanego zapytania?
SELECT * FROM producent, hurtownia, sklep, serwis WHERE producent.nr_id = hurtownia.nr_id AND producent.wyrob_id = serwis.wyrob_id AND hurtownia.nr_id = sklep.nr_id AND sklep.nr_id = serwis.nr_id AND producent.nr_id = 1;
A. Na podstawie parametru nr_id dla wszystkich tabelPoprawna odpowiedź
B. Na podstawie parametru nr_id tylko dla trzech tabelTwoja odpowiedź
C. Na podstawie parametru wyrob_id tylko dla trzech tabel
D. Na podstawie parametru wyrob_id tylko dla trzech tabel
Niepoprawna odpowiedź. Analizując błędne odpowiedzi można zauważyć że kluczowym aspektem w tym pytaniu jest zrozumienie zastosowania parametrów w klauzuli WHERE Odpowiedzi sugerujące selekcję według parametru wyrob_id są nieprawidłowe ponieważ w klauzuli WHERE dominującą rolę odgrywa parametr nr_id choć występuje tam także warunek dotyczący wyrob_id to jednak główną funkcją jest połączenie tabel według nr_id Jest to typowy błąd wynikający z nieuwzględnienia hierarchii oraz sposobu połączenia tabel w relacyjnych bazach danych Ponadto niektóre odpowiedzi ograniczają się wyłącznie do trzech tabel co również jest błędne ponieważ zapytanie obejmuje wszystkie cztery wymienione tabele producent hurtownia sklep i serwis Koncentracja na jednej lub dwóch tabelach często bierze się z pominięcia kluczowych związków logicznych między tabelami jak w przypadku odpowiedzi które ograniczają scope do mniejszej liczby tabel niż rzeczywiście obejmuje zapytanie Kluczową umiejętnością jest zrozumienie jak różne parametry mogą wpływać na wybór danych zwłaszcza w kontekście tworzenia złożonych zapytań SQL gdzie przemyślane zastosowanie klauzul jest niezbędne do efektywnego zarządzania danymi i unikania niepoprawnych interpretacji wyników Właściwe zrozumienie jak parametry takie jak nr_id czy wyrob_id funkcjonują w zapytaniach pozwala na ich poprawne i skuteczne zastosowanie co jest kluczowe w profesjonalnym podejściu do pracy z bazami danych
Pytanie 26
Aby wykonać kopię zapasową bazy danych w MySQL, jakie polecenie należy zastosować?
A. mysqlslapTwoja odpowiedź
B. mysqldumpPoprawna odpowiedź
C. mysqlreplicate
D. mysqlcheck
Niepoprawna odpowiedź. Wybór polecenia mysqlslap jako metody do tworzenia kopii zapasowych bazy danych jest nieuzasadniony, ponieważ funkcjonalność tego narzędzia jest całkowicie inna. Mysqlslap jest narzędziem do testowania wydajności MySQL, które symuluje obciążenie bazy danych i umożliwia ocenę jej reakcji na różne zapytania. Zamiast służyć do backupu, jest wykorzystywane do analizy i optymalizacji wydajności systemu, co może prowadzić do błędnych wniosków o jego zastosowaniu w kontekście bezpieczeństwa danych. Podobnie, mysqlcheck jest narzędziem używanym do sprawdzania i naprawy tabel w bazach danych MySQL, co oznacza, że nie ma on zastosowania w kontekście tworzenia kopii zapasowych. Jego główną rolą jest diagnostyka i konserwacja bazy danych, a nie zarządzanie danymi. Z kolei mysqlreplicate, jak sama nazwa wskazuje, odnosi się do replikacji bazy danych, co jest zupełnie inną procedurą, mającą na celu zapewnienie wysokiej dostępności i skalowalności poprzez tworzenie duplikatów danych na różnych serwerach. Typowym błędem jest mylenie narzędzi do zarządzania danymi z narzędziami do ich zabezpieczania. Aby skutecznie zarządzać bazą danych, konieczne jest zrozumienie różnicy między tymi funkcjami oraz właściwe dobieranie narzędzi do konkretnych zadań, co jest kluczowe dla zapewnienia spójności i bezpieczeństwa danych.
Pytanie 27
W którym przypadku plik graficzny należy zapisać w formacie GIF?
A. gdy trzeba zapisać obraz lub prostą animacjęPoprawna odpowiedź
B. gdy potrzebny jest zapis bez kompresjiTwoja odpowiedź
C. gdy jest to grafika wektorowa
D. gdy jest to obraz stereoskopowy (3D)
Niepoprawna odpowiedź. GIF to format rastrowy ze stratną dla kolorów paletą, więc nie służy do grafiki wektorowej ani obrazów stereoskopowych (3D). Nie jest też formatem „bez kompresji”. GIF wybiera się do zapisu obrazu lub prostej animacji.
Pytanie 28
Jak nazywa się proces dążący do osiągnięcia przez stronę jak najwyższych pozycji w wynikach wyszukiwarek?
A. responsywność
B. optymalizacja wydajności
C. walidacja HTMLTwoja odpowiedź
D. pozycjonowaniePoprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe pojęcia dotyczą innych aspektów strony. Walidacja HTML sprawdza poprawność kodu. Optymalizacja wydajności przyspiesza ładowanie. Responsywność to dopasowanie do różnych ekranów. Choć pośrednio pomagają SEO, samym dążeniem do wysokich pozycji w wyszukiwarce jest pozycjonowanie.
Pytanie 29
Pole tabeli „czyWypozyczona” może przyjmować tylko wartości true lub false. Który typ danych jest dla niego najlepszy?
A.
VARCHAR(5)
B.
CHAR
C.
DOUBLE
Twoja odpowiedź
D.
BOOLEAN
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe typy są nieadekwatne do dwustanowej flagi. CHAR przechowuje znaki o stałej długości - użyty do „T”/„N” działałby, ale jest mniej czytelny i nie ogranicza wartości do dwóch stanów. DOUBLE to typ liczbowy zmiennoprzecinkowy, przeznaczony do liczb rzeczywistych, więc do prawda/fałsz zupełnie nie pasuje. VARCHAR(5) trzyma tekst (np. „true”) - zajmuje więcej miejsca i dopuszcza dowolne, także błędne, wpisy. Dwie wartości logiczne najlepiej odda BOOLEAN, dlatego ta odpowiedź jest poprawna.
Pytanie 30
Z jakim problemem wiąże się poziom izolacji transakcji Repeatable Read (powtarzalny odczyt)?
A. z utratą aktualizacji
B. z odczytami widmowymi (phantom reads)Twoja odpowiedź
C. z brudnymi odczytami
D. z niepowtarzalnymi odczytami
Poprawna odpowiedź. Poziom izolacji Repeatable Read gwarantuje, że te same wiersze odczytane w transakcji nie zmienią się - ale wciąż dopuszcza ODCZYTY WIDMOWE (phantom reads): gdy inna transakcja DODA nowe wiersze pasujące do warunku, powtórne zapytanie może zwrócić ich więcej. Zapamiętaj: Repeatable Read blokuje zmiany istniejących wierszy, lecz nie pojawianie się nowych (widm).
Pytanie 31
W SQL klauzula DISTINCT w poleceniu SELECT zapewnia, że zwrócone wyniki
A. będą zgrupowane według wskazanego pola.Twoja odpowiedź
B. będą spełniały dany warunek.
C. nie zawiera będą duplikatów.Poprawna odpowiedź
D. będą uporządkowane.
Niepoprawna odpowiedź. Niepoprawność pierwszej odpowiedzi wynika z nieporozumienia dotyczącego funkcji DISTINCT. Klauzula ta nie ma na celu sortowania danych, a jedynie eliminację powtórzeń. Wyniki zapytania mogą być posortowane, ale jest to realizowane za pomocą osobnej klauzuli ORDER BY, a nie DISTINCT. Drugą odpowiedzią, która jest błędna, jest twierdzenie, że DISTINCT wymusza spełnienie określonego warunku. Klauzula DISTINCT nie jest używana do filtrowania danych na podstawie warunków; aby to osiągnąć, zwykle stosuje się klauzulę WHERE, która określa konkretne kryteria, jakie muszą być spełnione przez zwracane rekordy. Ostatnia błędna odpowiedź sugeruje, że wyniki będą pogrupowane według określonego pola, co jest mylące, ponieważ grupowanie osiąga się za pomocą klauzuli GROUP BY. Ta klauzula agreguje wiersze w grupy opierając się na wartościach w określonych kolumnach, a następnie umożliwia wykonywanie operacji agregujących, takich jak COUNT, SUM czy AVG, co jest zupełnie inną funkcjonalnością niż ta oferowana przez DISTINCT. W skrócie, klauzula DISTINCT koncentruje się na eliminacji duplikatów, podczas gdy sortowanie, warunki i grupowanie to odrębne aspekty zapytań SQL.
Pytanie 32
Jakie ustawienia dotyczące czcionki będą miały zastosowanie w przypadku kodu CSS?
*{font-family:Tahoma;color:Teal;}
A. znaczników z klasą przypisaną jako *.Twoja odpowiedź
B. wszystkiego kodu HTML, niezależnie od kolejnych ustawień CSS.
C. wszystkiego kodu HTML, jako domyślne formatowanie dla wszystkich elementów strony.Poprawna odpowiedź
D. znaczników o identyfikatorze równym *.
Niepoprawna odpowiedź. Nieprawidłowe odpowiedzi wskazują na nieporozumienie dotyczące działania selektorów w CSS oraz hierarchii stylów. Przykłady wskazujące na znaczenie id lub klas w kontekście selektora * są mylące, gdyż id i klasy są w CSS bardziej specyficznymi selektorami, które służą do stylizowania konkretnej grupy elementów, podczas gdy selektor uniwersalny działa na wszystkie elementy. Argumentowanie, że formatowanie dotyczy elementów o id równym * jest błędne, ponieważ id nie może być równy znaku *, a jego zastosowanie ogranicza się do unikalnych identyfikatorów. Podobnie, przypisanie klasy równą * jest niemożliwe do zrealizowania w praktyce. Odpowiedź sugerująca, że styl dotyczy całego kodu HTML w kontekście specyficznych ustawień CSS jest również myląca, ponieważ nie uwzględnia faktu, że późniejsze reguły CSS mogą nadpisywać wcześniejsze style. W praktyce oznacza to, że jeśli na elementach zastosowane zostaną bardziej szczegółowe selektory, mogą one zmienić wygląd tych elementów, co obala tezę o domyślnym formatowaniu. Takie podejście nie uwzględnia także koncepcji kaskadowości stylów, która jest kluczowym elementem funkcjonowania CSS, gdzie kolejność i specyficzność selektorów odgrywają kluczową rolę w aplikowaniu stylów. W efekcie, zrozumienie działania selektorów i ich hierarchii jest niezbędne dla efektywnego wykorzystania CSS w projektowaniu stron internetowych.
Pytanie 33
Zgodnie z zasadami ACID dotyczącymi transakcji, wymóg izolacji (ang. isolation) wskazuje, że
A. po zrealizowaniu transakcji system baz danych będzie w stanie spójnościTwoja odpowiedź
B. pod określonymi warunkami dane modyfikowane przez transakcję mogą zostać anulowane
C. jeśli dwie transakcje są wykonywane równolegle, to zazwyczaj nie zauważają wprowadzanych przez siebie zmianPoprawna odpowiedź
D. gdy wystąpi konflikt z inną transakcją, obie mogą modyfikować te same dane równocześnie
Niepoprawna odpowiedź. Po pierwsze, odpowiedź, która sugeruje, że po wykonaniu transakcji system bazy danych będzie spójny, nie odnosi się bezpośrednio do aspektu izolacji. Spójność to w rzeczywistości inne z wymaganych stanów ACID, które koncentruje się na tym, że wszystkie transakcje muszą zapewnić, że system przechodzi z jednego stanu spójnego do innego. Izolacja działa w zupełnie innym kontekście. Kolejna odpowiedź wskazująca na konflikt modyfikacji danych przez różne transakcje sugeruje sytuację, która w rzeczywistości powinna być unika, a nie opisana jako cecha izolacji. Izolacja ma na celu zapobieganie takim konfliktom, a nie ich akceptację. Dodatkowo, odpowiedź mówiąca o wycofywaniu danych pod pewnymi warunkami odnosi się do działania mechanizmu rollback, który jest związany z innym aspektem transakcji – atomowością. Atomowość dotyczy tego, czy cała transakcja zostanie pomyślnie zakończona, czy też w razie problemów zostanie wycofana, ale nie bezpośrednio do izolacji. Powszechny błąd myślowy polega na myleniu tych pojęć i ich wzajemnych interakcji. Właściwe zrozumienie izolacji jako ochrony przed widocznością zmian między transakcjami współbieżnymi jest kluczowe dla projektowania poprawnych i odpornych na błędy systemów baz danych.
Pytanie 34
Które zapytanie SQL zwróci wszystkie kolumny z tabeli produkty?
A.
FETCH*FROMprodukty;
B.
SELECTproduktyFROM*;
C.
GET*FROMprodukty;
Twoja odpowiedź
D.
SELECT*FROMprodukty;
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe zapisy nie są poprawnym SQL. SELECTproduktyFROM* odwraca składnię - po FROM powinna stać tabela, a nie gwiazdka. FETCH i GET nie są poleceniami pobierającymi dane (do odczytu służy SELECT). Wszystkie kolumny zwraca SELECT*FROMprodukty;.
Pytanie 35
Które stwierdzenie dotyczące klucza głównego (podstawowego) jest prawdziwe?
A. może przyjmować wyłącznie wartości liczbowe
B. składa się tylko z jednego pola
C. dla danych osobowych może to być pole nazwisko
D. jest unikalny w obrębie tabeliTwoja odpowiedź
Poprawna odpowiedź. Klucz główny musi być UNIKALNY w obrębie tabeli - jego wartości nie mogą się powtarzać, bo jednoznacznie identyfikują każdy wiersz. Dlatego prawdziwe jest, że klucz główny jest unikalny w obrębie tabeli.
Pytanie 36
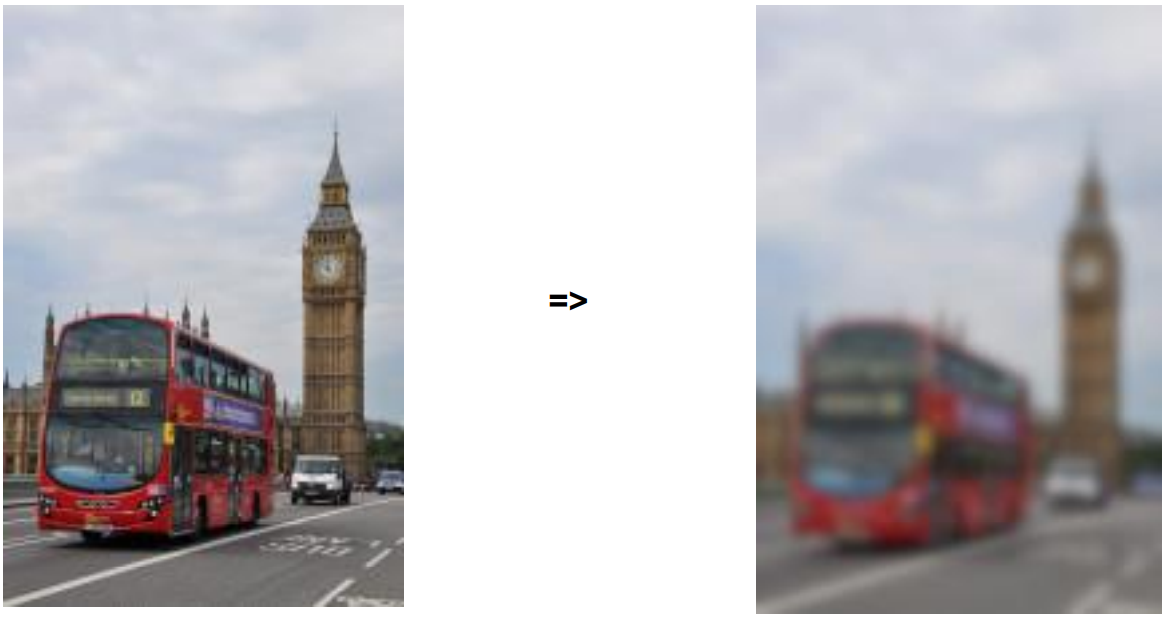
Przedstawiona transformacja obrazu, w edytorze grafiki rastrowej, została wykonana przy pomocy filtru
A. redukcja szumu.
B. rozmycia Gaussa.Poprawna odpowiedź
C. szum HSV.
D. błysk gradientowy.Twoja odpowiedź
Niepoprawna odpowiedź. Niestety, twoja odpowiedź nie jest prawidłowa. Rozmycie Gaussa to efekt ciągłego i jednolitego rozmycia, które jest widoczne na przedstawionym obrazie. Filtry, takie jak 'redukcja szumu', są używane do usuwania zakłóceń z obrazu, a nie do jego rozmycia. 'Szum HSV' nie jest standardową nazwą filtru w edycji grafiki, a 'błysk gradientowy' jest związany z efektami światła i kolorów, a nie z rozmyciem. Rozumienie różnych filtrów i technik przetwarzania obrazów jest kluczowe w edycji grafiki rastrowej. Powszechnym błędem jest mylenie efektów filtrów ze sobą lub niezrozumienie ich prawidłowego zastosowania. Przy dalszym studiowaniu tego tematu, zwróć uwagę na specyfikę każdego z filtrów i efektów, jakie one generują. To pomoże Ci dokonać prawidłowego wyboru podczas edycji obrazów oraz zrozumieć, jakie są konsekwencje zastosowania każdego z nich.
Pytanie 37
Który zapis definiuje w języku C++ komentarz jednoliniowy?
A.
//
Poprawna odpowiedź
B.
/*
C.
<
D.
#
Twoja odpowiedź
Niepoprawna odpowiedź./* otwiera komentarz BLOKOWY (zamykany */). # rozpoczyna dyrektywę preprocesora (np. #include), nie komentarz. < to operator porównania. Komentarz do końca linii daje //.
Pytanie 38
Efekt przedstawiony w filmie powinien być zdefiniowany w selektorze
A. tr:active { background-color: Pink; }
B. tr { background-color: Pink; }
C. td, th { background-color: Pink; }
D. tr:hover { background-color: Pink; }Twoja odpowiedź
Poprawna odpowiedź. Poprawny selektor to tr:hover { background-color: Pink; }, bo dokładnie opisuje sytuację pokazaną na filmie: efekt pojawia się dopiero po najechaniu kursorem na cały wiersz tabeli. Pseudo-klasa :hover w CSS służy właśnie do definiowania stylów w momencie, gdy użytkownik „najeżdża” myszką na dany element. Jeśli więc chcemy, żeby podświetlał się cały rząd tabeli, logiczne i zgodne z dobrymi praktykami jest przypięcie efektu do znacznika tr, a nie do pojedynczych komórek.
W praktyce taki zapis stosuje się bardzo często w interfejsach webowych: w panelach administracyjnych, listach zamówień, tabelach z uczniami, produktami, logami systemowymi itd. Dzięki temu użytkownik łatwiej śledzi, który wiersz właśnie ogląda. To niby detal, ale z punktu widzenia UX robi sporą różnicę. Z mojego doświadczenia to jeden z tych prostych trików CSS, które od razu poprawiają „odczuwalną” jakość strony.
Ważne jest też to, że :hover jest częścią standardu CSS (opisane m.in. w specyfikacji CSS Selectors Level 3/4) i działa w praktycznie wszystkich współczesnych przeglądarkach. Nie trzeba do tego żadnego JavaScriptu, żadnych skomplikowanych skryptów – czysty CSS. Dobrą praktyką jest również używanie bardziej stonowanych kolorów niż Pink w prawdziwych projektach, np. #f5f5f5 albo lekki odcień niebieskiego, tak żeby kontrast był czytelny i nie męczył wzroku. Warto też pamiętać, że podobny mechanizm możesz zastosować na innych elementach: np. a:hover dla linków, button:hover dla przycisków czy nawet div:hover dla całych kafelków w layoutach. Kluczowe jest to, żeby pseudo-klasa :hover była przypięta dokładnie do tego elementu, który ma reagować na interakcję użytkownika.
Pytanie 39
Który z opisów komentarza odzwierciedla działanie funkcji zdefiniowanej w języku PHP
A. /* Funkcja zwraca niższą wartość spośród dwóch podanych, w przypadku równości zwraca wartość $a */
B. /* Funkcja zwraca niższą wartość spośród dwóch podanych, w przypadku równości zwraca -1 */Twoja odpowiedź
C. /* Funkcja zwraca wyższą wartość spośród dwóch podanych, w przypadku równości zwraca -1 */Poprawna odpowiedź
D. /* Funkcja zwraca wyższą wartość spośród dwóch podanych, w przypadku równości zwraca wartość $a */
Niepoprawna odpowiedź. Wszystkie pozostałe odpowiedzi nie oddają właściwego zachowania funkcji `fun1`. Przede wszystkim, twierdzenie, że funkcja zwraca wartość niższą z dwóch podanych, jest błędne. Funkcja została zaprojektowana w taki sposób, aby zwracać wartość wyższą, a nie niższą, co jest kluczowe dla zrozumienia jej działania. Stwierdzenie, że funkcja zwraca wartość -1 w przypadku równości, jest prawdziwe, jednak nieimplikuje ono, że zwraca wartość niższą, co wprowadza w błąd. Ponadto, odpowiedzi sugerujące, że w przypadku równości funkcja zwraca wartość `$a`, są również mylące - w rzeczywistości zwraca tylko -1, co wyraźnie wskazuje na brak różnicy. Tego typu nieporozumienia mogą wynikać z braku zrozumienia logiki warunkowej w programowaniu, gdzie zastosowane instrukcje `if` i `elseif` determinują, która wartość zostanie zwrócona. W programowaniu należy zawsze analizować wyniki funkcji oraz upewnić się, że dokumentacja odpowiada rzeczywistemu działaniu kodu. Dobre praktyki obejmują również testowanie funkcji oraz jasne komunikowanie jej działania w komentarzach, aby uniknąć takich nieporozumień w przyszłości.
Pytanie 40
Który parametr obrazu zmieni się po zmianie wartości NASYCENIA (saturacji)?
A. kolejność wyświetlania pikseli
B. intensywność (żywość) barwTwoja odpowiedź
C. przezroczystość
D. ostrość krawędzi
Poprawna odpowiedź. Nasycenie (saturacja) określa INTENSYWNOŚĆ i czystość barw. Przy nasyceniu bliskim zera kolory bledną aż do skali szarości, a przy wysokim stają się soczyste i żywe - to typowy suwak w GIMP-ie czy Photoshopie, gdy zdjęcie ma wyglądać „mocniej” lub „spokojniej”. Sama jasność i barwa (odcień) pozostają, zmienia się tylko siła kolorów. Zapamiętaj: saturacja steruje żywością barw.