Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 28 września 2026 01:35
Zakończenie: 28 września 2026 01:35
Egzamin niezdany
Wynik: 0/40 punktów (0,0%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 0% podejść do kwalifikacji INF.03.
Porównanie z 43340 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
ALTER TABLEksiazkiMODIFYtytulVARCHAR(100)NOT NULL;
A. zmienić nazwę kolumny w tabeli ksiazki
B. dodać kolumnę tytul do tabeli ksiazki
C. usunąć kolumnę tytul z tabeli ksiazki
D. zmienić typ kolumny tytul w tabeli ksiazkiPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie 'ALTER TABLE ksiazki MODIFY tytul VARCHAR(100) NOT NULL;' służy do zmiany typu danych lub ograniczeń kolumny w istniejącej tabeli. W tym przypadku modyfikujemy kolumnę 'tytul' w tabeli 'ksiazki', zmieniając jej typ danych na VARCHAR(100) oraz ustawiając ograniczenie NOT NULL. Polecenie MODIFY jest używane w SQL do zmiany struktury kolumny, takiej jak typ danych, długość, czy też dodawanie ograniczeń. Praktyczne zastosowanie tego polecenia można znaleźć w sytuacjach, gdy oryginalna definicja kolumny jest niewystarczająca, np. zwiększenie długości pola tekstowego, aby pomieścić dłuższe wartości. Dobre praktyki przy modyfikacji kolumn obejmują dokładne zrozumienie zmian, które wprowadzasz, oraz testowanie ich w środowisku deweloperskim przed wdrożeniem na żywo. Ważne jest także rozważenie wpływu na istniejące dane oraz wydajność zapytań. Zmiana typu kolumny na VARCHAR z określoną długością jest szczególnie przydatna, gdy chcemy zminimalizować wykorzystanie pamięci w bazie danych.
Pytanie 2
Które z poniższych zdań poprawnie opisuje utworzoną tabelę?
CREATE TABLEdane(kolumnaINTEGER(3));
A. Tabela zawiera jedną kolumnę, która przechowuje trzyelementowe tablice
B. Tabela o nazwie dane składa się z trzech kolumn typu całkowitego
C. Kolumny tabeli dane są nazwane: kolumna1, kolumna2, kolumna3
D. Tabela o nazwie dane ma jedną kolumnę typu całkowitegoPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Instrukcja CREATE TABLE w podanym przykładzie tworzy tabelę o nazwie `dane` z jedną, jedyną kolumną o nazwie `kolumna` i typie `INTEGER(3)`. Kluczowe są tu dwie rzeczy: po pierwsze, nazwa tabeli (`dane`), po drugie, lista kolumn w nawiasie. W tej liście jest tylko jedna pozycja: nazwa kolumny i jej typ danych. W SQL każda definicja kolumny to osobny wpis, oddzielany przecinkiem. Skoro nie ma przecinka, to znaczy, że jest dokładnie jedna kolumna. Zapis `INTEGER(3)` nie oznacza trzech kolumn ani tablicy, tylko typ liczbowy całkowity z określoną „szerokością wyświetlania” (w MySQL) lub po prostu liczbę całkowitą – w wielu silnikach baz danych nawias jest wręcz ignorowany. W praktyce tę kolumnę możemy potem używać np. do przechowywania wieku, liczby sztuk towaru, numeru poziomu uprawnień itp. Przykładowo: `INSERT INTO dane (kolumna) VALUES (5);` wstawi rekord z wartością 5 w tej jednej kolumnie. Z mojego doświadczenia warto przy projektowaniu tabel zawsze jasno nazywać kolumny, tak żeby z samej nazwy wynikało, co przechowują, np. `wiek`, `ilosc_sztuk`, a nie ogólne `kolumna`. Dobrą praktyką jest też od razu dodanie klucza głównego, np. `id INT AUTO_INCREMENT PRIMARY KEY`, ale w tym zadaniu skupiamy się tylko na liczbie kolumn i ich typie. To pytanie dobrze pokazuje, że w SQL struktura tabeli wynika z liczby pozycji w nawiasie, a nie z liczby w nawiasie przy typie danych.
Pytanie 3
Jakie są określenia typowych komend języka SQL, które dotyczą przeprowadzania operacji na danych SQL DML (np.: dodawanie danych do bazy, usuwanie, modyfikowanie danych)?
A.
DENY,GRANT,REVOKE
B.
DELETE,INSERT,UPDATE
Poprawna odpowiedź
C.
ALTER,CREATE,DROP
D.
SELECT,SELECTINTO
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź DELETE, INSERT, UPDATE jest prawidłowa, ponieważ te polecenia stanowią podstawowe instrukcje języka SQL DML (Data Manipulation Language), które są wykorzystywane do manipulacji danymi w bazie danych. DELETE służy do usuwania rekordów z tabel, co jest niezbędne w sytuacjach, gdy dane są już nieaktualne lub niepotrzebne. INSERT umożliwia dodawanie nowych rekordów, co jest kluczowe w procesie wprowadzania danych, na przykład dodawania nowych klientów do bazy danych. Z kolei UPDATE pozwala na modyfikację już istniejących danych, co jest istotne w przypadku zmiany informacji, takich jak aktualizacja adresu klienta. W praktyce te operacje są niezwykle ważne dla utrzymania spójności i aktualności danych w systemach zarządzania bazami danych. Warto również zauważyć, że stosowanie tych poleceń zgodnie z dobrymi praktykami, takimi jak transakcje, pozwala na zabezpieczenie integralności danych oraz umożliwia łatwe wycofywanie zmian w przypadku błędów.
Pytanie 4
Uprawnienia obiektowe przyznawane użytkownikom serwera bazy danych mogą umożliwiać lub ograniczać
A. przechodzić uprawnienia
B. wykonywać polecenia, takie jak tworzenie kopii zapasowej
C. realizować operacje na bazie, takie jak wstawianie lub modyfikowanie danychPoprawna odpowiedź
D. zmieniać role i konta użytkowników
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Uprawnienia obiektowe w kontekście baz danych pozwalają na kontrolowanie dostępu do różnych zasobów, takich jak tabele, widoki czy procedury składowane. Odpowiedź dotycząca wykonywania operacji na bazie, takich jak wstawianie czy modyfikowanie danych, jest prawidłowa, ponieważ uprawnienia te bezpośrednio wpływają na możliwości użytkownika w zakresie manipulacji danymi. Przykładowo, jeśli użytkownik posiada uprawnienie do INSERT, może dodawać nowe rekordy do tabeli, natomiast uprawnienie UPDATE pozwala na zmianę istniejących danych. Takie zarządzanie uprawnieniami jest kluczowe w kontekście bezpieczeństwa danych oraz zapewnienia integralności systemu, ponieważ pozwala na ograniczenie dostępu tylko do tych operacji, które są niezbędne dla danego użytkownika. W praktyce administratorzy baz danych stosują zasady minimalnych uprawnień, przyznając użytkownikom tylko te uprawnienia, które są niezbędne do wykonywania ich pracy, co jest zgodne z najlepszymi praktykami w zakresie zarządzania bezpieczeństwem baz danych.
Pytanie 5
Możliwość utworzenia konta użytkownika jan z hasłem janPass można osiągnąć przy pomocy polecenia
A. CREATE USER 'jan'@'%localhost' IDENTIFIED VIA mysql_native_password USING 'janPass';
B. CREATE USER 'jan'@'localhost' IDENTIFIED BY 'janPass';Poprawna odpowiedź
C. CREATE USER 'jan'@'localhost';
D. CREATE USER 'jan'@'localhost' PASSWORD EXPIRE;
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź ta jest poprawna, ponieważ prawidłowo wykorzystuje składnię polecenia SQL do tworzenia użytkownika w bazie danych MySQL. Polecenie 'CREATE USER 'jan'@'localhost' IDENTIFIED BY 'janPass';' tworzy nowego użytkownika o nazwie 'jan' z hasłem 'janPass', które jest wymagane do autoryzacji. Użycie 'IDENTIFIED BY' jest zgodne z najlepszymi praktykami w zakresie bezpieczeństwa, ponieważ pozwala na bezpośrednie zdefiniowanie hasła w momencie tworzenia konta użytkownika. W praktyce, stworzenie użytkownika z odpowiednim hasłem jest kluczowym krokiem w zarządzaniu bazą danych, zwłaszcza w kontekście bezpieczeństwa danych. Umożliwia to ograniczenie dostępu do zasobów bazy danych tylko do autoryzowanych użytkowników. Dodatkowo, w codziennej pracy należy regularnie aktualizować hasła użytkowników oraz stosować złożone hasła, aby zwiększyć poziom bezpieczeństwa. Warto również zaznaczyć, że w nowoczesnych wersjach MySQL możliwe jest użycie dodatkowych opcji, takich jak 'REQUIRE SSL', dla podniesienia poziomu zabezpieczeń przy nawiązywaniu połączeń.
Pytanie 6
Jaką cechę pola w tabeli należy ustalić, aby pole mogło przyjmować wyłącznie dane składające się z cyfr?
Ogólne
Rozmiar pola
255
Format
Maska wprowadzania
Tytuł
Wartość domyślna
Reguła spr. poprawności
Tekst reguły spr. poprawności
Wymagane
Nie
Zerowa dł. dozwolona
Tak
Indeksowane
Nie
Kompresja Unicode
Tak
Tryb IME
Bez formantu
Tryb zdania edytora IME
Brak
Tagi inteligentne
A. Regułę sprawdzania poprawności
B. Tagi inteligentne
C. Maskę wprowadzaniaPoprawna odpowiedź
D. Wartość domyślną
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Maska wprowadzania to coś, co bardzo ułatwia życie, zwłaszcza w systemach baz danych i aplikacjach. Dzięki niej możemy dokładnie określić, jakie znaki mogą być wpisywane w dane pole, co jest szczególnie przydatne, gdy potrzebujemy tylko cyfr. Wyobraź sobie, że musisz wpisać numer telefonu – to właśnie wtedy maska pokazuje, że możesz wpisać tylko cyfry i może nawet dodać myślniki dla lepszej estetyki. To dobry sposób na ograniczenie błędów, bo nikt nie będzie miał okna do wpisania literek, których nie powinno być. W praktyce, jeżeli projektujesz coś jak formularze online, to maseczki wprowadzania są bardzo fajne, bo zabezpieczają dane przed wprowadzeniem czegokolwiek, co nie pasuje. Możesz je łatwo zaimplementować w językach programowania jak C# czy JavaScript przy pomocy wyrażeń regularnych albo gotowych komponentów UI. Dobrze zaprojektowane maski wprowadzania pomagają też utrzymać porządek w bazach danych i zgodność z wymaganiami, które mamy na myśli.
Pytanie 7
Jak nazywa się niepotrzebne POWIELANIE tych samych danych w wielu miejscach bazy?
A. spójnością danych
B. normalizacją
C. redundancją (nadmiarowością)Poprawna odpowiedź
D. integralnością referencyjną
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Niepotrzebne POWIELANIE tych samych danych w wielu miejscach bazy to redundancja (nadmiarowość). Jest niepożądana: zajmuje miejsce i grozi niespójnością (zmiana w jednym miejscu, a w innym nie). Ogranicza ją normalizacja. Zapamiętaj: redundancja = ta sama informacja zapisana po wielokroć.
Pytanie 8
Które narzędzie wiersza poleceń służy do OGÓLNEGO administrowania serwerem MySQL (np. status serwera, tworzenie bazy, zmiana hasła)?
A.
mysqladmin
Poprawna odpowiedź
B.
truncate
C.
mysqlcheck
D.
mysqldump
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Narzędzie mysqladmin służy do ogólnego administrowania serwerem MySQL z wiersza poleceń - sprawdzenia statusu, utworzenia lub usunięcia bazy, zmiany hasła czy zatrzymania serwera. Dlatego to mysqladmin.
Pytanie 9
W zamieszczonym kodzie PHP, który łączy się z serwerem bazy danych, jakie działania powinny być umieszczone w instrukcji warunkowej w miejscu trzech kropek?
$db = mysqli_connect("localhost","root","qwerty","baza1"); if ( !$db ) { ... }
A. Zamknięcie połączenia z bazą danych
B. Zarządzanie błędem połączeniaPoprawna odpowiedź
C. Informacja o udanym połączeniu z bazą
D. Przetwarzanie danych otrzymanych z bazy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W przypadku nawiązywania połączenia z bazą danych kluczowym aspektem jest sprawdzenie czy połączenie zostało nawiązane pomyślnie. W PHP funkcja mysqli_connect() zwraca false w przypadku nieudanego połączenia dlatego pierwszym krokiem po jej użyciu powinno być sprawdzenie czy połączenie zostało zainicjowane poprawnie. W sytuacji gdy połączenie nie powiedzie się należy wykonać odpowiednie czynności obsługi błędu. Najczęściej stosowaną praktyką jest wyświetlenie użytkownikowi komunikatu o błędzie oraz zapisanie szczegółów błędu do logów systemowych co umożliwia późniejszą diagnostykę problemu. Można to zrealizować za pomocą funkcji mysqli_connect_error() która zwraca szczegóły błędu połączenia. Obsługa błędów na tym etapie jest zgodna z dobrymi praktykami programistycznymi i pomaga zapobiegać sytuacjom w których aplikacja działałaby w sposób nieprzewidywalny lub nieefektywny. Prawidłowe zarządzanie błędami połączenia jest niezbędne do tworzenia stabilnych i bezpiecznych aplikacji internetowych. Ponadto pozwala na wczesne wykrycie problemów konfiguracyjnych takich jak nieprawidłowe dane logowania czy brak dostępu do serwera bazy danych.
Pytanie 10
Tabela samochody zawiera dane przedstawione poniżej:
id
klasa_id
marka
model
rocznik
1
1
ford
ka
2017
2
2
seat
toledo
2016
3
3
opel
zafira
2018
4
2
fiat
500X
2018
5
3
opel
insignia
2017
Wydając zamieszczone zapytanie SQL, jakie dane zostaną zwrócone:
SELECT model FROM samochody WHERE rocznik > 2017 AND marka = "opel";
A. zafiraPoprawna odpowiedź
B. opel zafira; opel insignia
C. zafira; insignia
D. opel zafira
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Poprawna odpowiedź to 'zafira', ponieważ zapytanie SQL odnosi się do modelu samochodu marki 'opel', którego rocznik jest większy niż 2017. Z analizy danych w tabeli wynika, że tylko model 'opel zafira' (z rocznika 2018) spełnia te warunki. Odpowiedzi 'opel zafira', 'zafira; insignia', 'opel zafira; opel insignia' zawierają dodatkowe informacje, które nie są zgodne z wymaganiami zapytania. Dobrym przykładem zastosowania takiej analizy jest filtrowanie danych w bazach danych, co jest kluczowym procesem w zarządzaniu informacjami. Efektywne posługiwanie się zapytaniami SQL to umiejętność istotna w pracy każdego analityka danych, programisty, czy specjalisty w zakresie baz danych, ponieważ pozwala na wyciąganie precyzyjnych informacji zgodnych z wymaganiami biznesowymi.
Pytanie 11
Ustalenie klucza obcego jest konieczne do skonstruowania
A. klucza podstawowego
B. transakcji
C. relacji 1..1
D. relacji 1..nPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Klucz obcy jest kluczowym elementem w modelowaniu relacji w bazach danych, szczególnie w kontekście relacji 1..n. Definiuje on powiązania pomiędzy dwiema tabelami, gdzie jedna tabela (tabela główna) może mieć wiele powiązanych rekordów w drugiej tabeli (tabela szczegółowa). Na przykład, w bazie danych dotyczącej studentów i ich zapisów na przedmioty, tabela studentów może mieć klucz obcy odnoszący się do tabeli przedmiotów. Dzięki temu, dla każdego studenta można przechowywać wiele zapisów na różne przedmioty, co jest istotne w kontekście analizy danych. Z perspektywy standardów, takie podejście jest zgodne z zasadami normalizacji, które mają na celu eliminację redundancji danych oraz zapewnienie integralności referencyjnej. Dobre praktyki w projektowaniu baz danych sugerują stosowanie kluczy obcych do zarządzania relacjami pomiędzy danymi, co ułatwia ich późniejsze przetwarzanie i analizy.
Pytanie 12
W podanym kodzie PHP, w miejscu kropek należy umieścić odpowiednią instrukcję
$zapytanie = mysqli_query($db, "SELECT imie, nazwisko FROM uzytkownik"); while ($wiersz = ...................) echo "$wiersz[0] $wiersz[1]";
A. mysqli_query($zapytanie)
B. mysqli_free_result($zapytanie)
C. mysqli_fetch_array($zapytanie)Poprawna odpowiedź
D. mysqli_num_fields($zapytanie)
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja mysqli_fetch_array($zapytanie) jest używana do pobierania wyników zapytania SQL w formie tablicy asocjacyjnej lub indeksowanej. W kontekście podanego kodu, po wykonaniu zapytania SELECT do bazy danych, wyniki są zwracane jako zasób, który musi być przetworzony. Mysqli_fetch_array pozwala na iteracyjne przetwarzanie każdego wiersza z zestawu wyników, co umożliwia dostęp do poszczególnych wartości pól za pomocą indeksów lub kluczy. Jest to przydatne w sytuacjach, gdzie dane muszą być wyświetlane lub przetwarzane w pętli, jak w przykładowym kodzie. Tablica zwracana przez mysqli_fetch_array może zawierać pola zarówno z indeksami numerycznymi, jak i nazwami kolumn, co daje elastyczność w dostępie do danych. Zgodnie z dobrymi praktykami programistycznymi, zawsze należy sprawdzić, czy zapytanie zostało wykonane poprawnie, zanim zacznie się przetwarzać jego wyniki, oraz zwolnić pamięć po zakończeniu przetwarzania wyników. Stosowanie odpowiednich mechanizmów obsługi błędów i zabezpieczeń, takich jak przygotowane zapytania, jest również kluczowe dla bezpieczeństwa aplikacji.
Pytanie 13
Podaj polecenie SQL, które pozwoli na dodanie kolumny miesiacSiewu do tabeli rośliny znajdującej się w bazie danych
A.
INSERTINTOroślinyVALUES(miesiacSiewuint);
B.
UPDATEroślinyADDmiesiacSiewuint;
C.
CREATETABLErośliny{miesiacSiewuint};
D.
ALTERTABLEroślinyADDmiesiacSiewuint;
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź 'ALTER TABLE rośliny ADD miesiacSiewu int;' jest jak najbardziej na miejscu. Używasz tutaj komendy SQL 'ALTER TABLE', co jest standardem, jeśli chcesz coś zmienić w już istniejącej tabeli. W tym przypadku dodajesz nowe pole 'miesiacSiewu' w formacie 'int' do tabeli 'rośliny'. Fajnie, bo dodawanie kolumn w relacyjnych bazach danych to chleb powszedni, zwłaszcza gdy musisz dodać nowe informacje. Na przykład, jak chcesz wiedzieć, kiedy siać rośliny, to zrobienie tego przy pomocy tej komendy pozwoli Ci trzymać te dane blisko innych szczegółów roślin. Warto też pamiętać, żeby nowe kolumny były dobrze indeksowane lub miały jakieś wartości domyślne, bo to może przyspieszyć zapytania do bazy. Tego typu operacje są naprawdę ważne w zarządzaniu bazami danych, bo dają Ci elastyczność, żeby dostosować strukturę bazy do potrzeb Twojej aplikacji.
Pytanie 14
Aby zapewnić integralność danych w bazie programu Microsoft Access, należy zastosować
A. defragmentację bazy
B. archiwizację bazy
C. kwerendę aktualizującą
D. więzy integralnościPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wybór więzów integralności jako metody zapewnienia spójności danych w programie Microsoft Access jest właściwy, ponieważ więzy te definiują zasady, które muszą być spełnione w bazie danych, aby utrzymać spójność i poprawność danych. Przykładowo, można ustawić więzy integralności, które zapobiegają wprowadzeniu duplikatów w kluczowych polach, takich jak identyfikator klienta, co jest kluczowe dla unikania konflikty i błędów w analityce danych. Więzy integralności mogą obejmować takie elementy jak klucze główne, klucze obce oraz unikalne ograniczenia, które pomagają w zachowaniu logiki relacyjnej w bazie danych. Dobrą praktyką jest regularne przeglądanie i aktualizowanie więzów integralności, aby zapewnić ich adekwatność do zmieniających się potrzeb danych. Ponadto, w sytuacjach, gdy dane są wprowadzane przez wiele źródeł, więzy integralności stają się kluczowym narzędziem w zarządzaniu jakością i spójnością danych, co jest zgodne z najlepszymi praktykami w zakresie zarządzania danymi.
Pytanie 15
W tabeli uczniowie (kolumny: imie, nazwisko, klasa) chcemy wypisać uczniów, których nazwisko zaczyna się na literę M. Które zapytanie jest poprawne?
Wyjaśnienie poprawnej odpowiedzi: Do wyszukiwania według wzorca tekstowego służy operator LIKE w klauzuli WHERE. Znak % zastępuje dowolny ciąg znaków, więc nazwiskoLIKE"M%" dopasuje wszystkie nazwiska zaczynające się na M. Poprawne zapytanie to SELECTnazwisko,imieFROMuczniowieWHEREnazwiskoLIKE"M%". Dlatego ta odpowiedź jest właściwa.
Pytanie 16
Poniżej przedstawiono sposób obsługi:
<?php
if (!isset($_COOKIE[$nazwa]))
echo"nie ustawiono!";
elseecho"ustawiono, wartość: ".$_COOKIE[$nazwa];
?>
A. baz danych
B. ciasteczekPoprawna odpowiedź
C. zmiennych tekstowych
D. sesji
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Kod PHP przedstawiony w pytaniu ilustruje użycie mechanizmu ciasteczek w przeglądarce. Ciasteczka to małe pliki tekstowe, które serwer umieszcza na komputerze użytkownika, aby przechowywać informacje między sesjami HTTP. W tym przypadku kod sprawdza, czy zmienna o nazwie $nazwa jest ustawiona w tablicy superglobalnej $_COOKIE. Jeśli ciasteczko o danej nazwie nie zostało ustawione, skrypt zwraca komunikat 'nie ustawiono!'. Gdy ciasteczko istnieje, wyświetlana jest jego wartość. Ciasteczka są powszechnie stosowane do śledzenia sesji użytkowników, przechowywania preferencji czy zachowania stanu zalogowania. Ważnym aspektem jest zrozumienie, że ciasteczka działają po stronie klienta i mogą być modyfikowane przez użytkownika, dlatego powinny być używane z ostrożnością i w połączeniu z innymi mechanizmami zabezpieczeń. Warto pamiętać, że ciasteczka mają ograniczenia co do wielkości i liczby, które mogą być przechowywane przez przeglądarkę. Implementacja ciasteczek powinna być zgodna z regulacjami dotyczącymi prywatności, takimi jak RODO, które nakładają obowiązek informowania użytkowników o ich używaniu oraz uzyskiwania zgody.
Pytanie 17
W SQL przeprowadzono zapytanie, jednak jego realizacja nie powiodła się, co skutkowało błędem: #1396 - Operation CREATE USER failed for 'anna'@'localhost'. Możliwą przyczyną takiego zachowania bazy danych może być
A. istnienie użytkownika anna w baziePoprawna odpowiedź
B. błędna składnia polecenia CREATE USER
C. niewystarczające hasło dla konta anna
D. nieznane polecenie CREATE USER
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź wskazująca na istnienie użytkownika 'anna' w bazie jest prawidłowa, ponieważ MySQL nie pozwala na tworzenie nowego użytkownika, jeśli użytkownik o takiej samej nazwie już istnieje. W przypadku próby wykonania kwerendy CREATE USER dla istniejącego użytkownika, system generuje błąd #1396, co jest zgodne z zasadami zarządzania użytkownikami w bazach danych. Dobra praktyka polega na sprawdzaniu, czy użytkownik już istnieje przed próbą jego utworzenia, co można zrobić za pomocą zapytania SELECT z tabeli mysql.user. Jeśli użytkownik 'anna' byłby już zdefiniowany, aby uniknąć błędów, programista powinien najpierw usunąć istniejącego użytkownika lub zmodyfikować jego uprawnienia, jeżeli to konieczne. Stosowanie poprawnych procedur zarządzania użytkownikami oraz regularne audyty kont użytkowników są kluczowe dla bezpieczeństwa i wydajności systemu baz danych.
Pytanie 18
Aby stworzyć warunek w zapytaniu wybierającym nazwiska wszystkich uczniów z klas początkowych (od pierwszej do trzeciej), można zastosować klauzulę
A.
WHEREklasaIN(1,3)
B.
WHEREklasa>=1ORklasa<=3
C.
WHEREklasaBETWEEN1AND3
Poprawna odpowiedź
D.
WHEREklasa<3
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź "WHERE klasa BETWEEN 1 AND 3" jest poprawna, ponieważ klauzula BETWEEN umożliwia precyzyjne określenie zakresu wartości w bazie danych. W tym przypadku, chcemy wybrać uczniów z klas 1, 2 i 3, co idealnie pasuje do zastosowania klauzuli BETWEEN. Oznacza to, że zapytanie zwróci wszystkie rekordy, gdzie wartość w kolumnie 'klasa' mieści się w przedziale od 1 do 3, włącznie. Przykładowe zapytanie SQL mogłoby wyglądać tak: SELECT nazwisko FROM uczniowie WHERE klasa BETWEEN 1 AND 3; To podejście jest zgodne z dobrymi praktykami, ponieważ jest czytelne, zrozumiałe i łatwe do modyfikacji. Dodatkowo, stosowanie klauzuli BETWEEN jest bardziej efektywne niż inne metody, takie jak użycie operatorów porównania, co może prowadzić do błędów, jeśli na przykład nie uwzględni się wartości granicznych. W standardach SQL klauzula BETWEEN jest powszechnie uznawana za najlepszy sposób na określenie zakresu wartości, co czyni ją kluczowym narzędziem w pracy z danymi w bazach danych.
Pytanie 19
W tabeli mieszkańcy zawierającej pola id, imie, nazwisko, ulica, numer, czynsz (wartość całkowita) należy zidentyfikować osoby zamieszkujące ulicę Mickiewicza pod numerami 71, 72, 80, których czynsz jest niższy niż 1000 zł. Jak będzie wyglądać klauzula WHERE w zapytaniu?
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź jest prawidłowa, ponieważ klauzula WHERE w zapytaniu SQL skutecznie filtruje dane zgodnie z wymaganiami. W tym przypadku, użycie operatora AND w połączeniu z IN i warunkiem < 1000 zapewnia, że zwrócone zostaną jedynie te rekordy, które spełniają wszystkie trzy kryteria: ulica musi być 'Mickiewicza', numer musi być jednym z 71, 72 lub 80, a czynsz musi być mniejszy niż 1000 zł. To jest zgodne z dobrą praktyką w SQL, gdzie łączenie warunków z użyciem operatorów logicznych pozwala na precyzyjne określenie zestawu danych, które nas interesują. Przy tak skonstruowanej klauzuli, zapytanie będzie wydajne i zrozumiałe, co jest kluczowe w pracy z bazami danych. Przykładowe zastosowanie to generowanie raportów dotyczących mieszkańców, co może być istotne dla zarządzania nieruchomościami lub analizy rynku wynajmu. Tego typu zapytania są powszechnie używane w aplikacjach webowych i systemach zarządzania danymi, co podkreśla znaczenie umiejętności formułowania precyzyjnych zapytań SQL.
Pytanie 20
Dana jest tabela studenci o polach id_albumu, ubezpieczenie. Modyfikacja w kolumnie ubezpieczenie polegająca na zmianie wierszy bez wartości (NULL) na ciąg znaków „brak” zostanie wykonana kwerendą
Wyjaśnienie poprawnej odpowiedzi: Prawidłowa kwerenda używa instrukcji UPDATE z klauzulą SET oraz warunkiem w części WHERE: „UPDATE studenci SET ubezpieczenie='brak' WHERE ubezpieczenie IS NULL;”. To dokładnie odpowiada temu, co chcemy zrobić: zaktualizować istniejące rekordy w tabeli, tylko w tych wierszach, gdzie kolumna ubezpieczenie ma wartość NULL. UPDATE służy właśnie do modyfikowania danych w tabeli, a nie do zmiany jej struktury. Kluczowy jest tu warunek WHERE ubezpieczenie IS NULL – bez tego zmienilibyśmy wartość ubezpieczenie na „brak” we wszystkich wierszach, co byłoby poważnym błędem. W SQL porównanie z NULL odbywa się zawsze przez IS NULL lub IS NOT NULL, a nie przez operator =, bo NULL oznacza „brak danych”, a nie konkretną wartość. Moim zdaniem warto zapamiętać ten schemat, bo w praktyce pracy z bazami danych bardzo często trzeba „sprzątać” dane: zastępować wartości NULL jakimiś domyślnymi opisami, np. „nieznany”, „nie dotyczy”, „brak danych”. Przykładowo: UPDATE klienci SET telefon='brak' WHERE telefon IS NULL; albo UPDATE pracownicy SET premia=0 WHERE premia IS NULL;. To jest ten sam wzorzec działania. Dobrą praktyką jest też najpierw wykonać SELECT z tym samym warunkiem WHERE, żeby zobaczyć, które rekordy zostaną zmodyfikowane, zanim puścimy właściwy UPDATE. W projektowaniu baz danych przyjęło się, że UPDATE służy do zmiany zawartości wierszy, a ALTER TABLE do zmiany struktury tabeli (dodawanie kolumn, zmiana typów, kluczy itp.). Mieszanie tych dwóch ról prowadzi potem do dziwnych błędów. W standardowym SQL nie ma możliwości aktualizacji tylko części wierszy poprzez ALTER TABLE, dlatego tutaj jedynym sensownym, poprawnym i zgodnym z dobrymi praktykami rozwiązaniem jest właśnie użycie UPDATE z warunkiem WHERE ubezpieczenie IS NULL.
Pytanie 21
W tabeli personel znajdują się pola: imie, nazwisko, pensja, staz. Aby otrzymać średnią pensję pracowników, dla których staż wynosi od 10 do 20 lat pracy włącznie, należy wykonać kwerendę:
Wyjaśnienie poprawnej odpowiedzi: Poprawna kwerenda to 'SELECT AVG(pensja) FROM personel WHERE staz >= 10 AND staz <= 20;'. Użycie funkcji AVG() jest kluczowe, gdyż jej celem jest obliczenie średniej wartości z konkretnego zestawu danych, w tym przypadku pensji pracowników z określonym stażem. Funkcja ta agreguje dane, zliczając sumę pensji i dzieląc ją przez ich liczbę, co jest standardową metodą obliczania średniej arytmetycznej. W kontekście praktycznym, taką kwerendę można wykorzystać w raportach finansowych dla działu HR, aby ocenić wynagrodzenia w zespole z odpowiednim doświadczeniem. Standardy SQL zalecają użycie funkcji agregujących, takich jak AVG(), do takich obliczeń, co zapewnia dokładność i efektywność w analizie danych. Co więcej, efektywne wykorzystanie takich zapytań pozwala na lepsze planowanie budżetu oraz strategii wynagrodzeń w organizacjach.
Pytanie 22
W systemie baz danych sklepu znajdują się dwie tabele połączone relacją: produkty oraz oceny. Tabela oceny zawiera dowolną liczbę ocen wystawionych przez klientów dla konkretnego produktu, opisaną poprzez pola: id, ocena (pole numeryczne), produktID (klucz obcy). Aby uzyskać maksymalną ocenę dla produktu o ID wynoszącym 10, należy wykorzystać zapytanie
A.
COUNTMAXSELECTocenaFROMocenyWHEREproduktID=10;
B.
MAXSELECTocenaFROMocenyWHEREproduktID=10;
C.
SELECTMAX(ocena)FROMocenyWHEREproduktID=10;
Poprawna odpowiedź
D.
SELECTMAXCOUNT(ocena)FROMocenyWHEREproduktID=10;
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź 'SELECT MAX(ocena) FROM oceny WHERE produktID = 10;' jest poprawna, ponieważ wykorzystuje funkcję agregującą MAX, która zwraca największą wartość w danej kolumnie. W kontekście tego zapytania, funkcja MAX jest stosowana do kolumny 'ocena' w tabeli 'oceny', a dodatkowy warunek 'WHERE produktID = 10' ogranicza wyniki do tylko tych ocen, które są związane z produktem o ID równym 10. To podejście jest zgodne z najlepszymi praktykami SQL, które zalecają korzystanie z funkcji agregujących dla wydobywania statystyk z danych. W praktyce, takie zapytania są niezwykle ważne w analizie danych, na przykład do oceny jakości produktów, co może wpłynąć na decyzje biznesowe. Dzięki umiejętności konstruowania takich zapytań, analitycy mogą w łatwy sposób uzyskać kluczowe informacje niezbędne do strategii marketingowych oraz poprawy jakości obsługi klienta.
Pytanie 23
Która z funkcji agregujących dostępnych w SQL służy do obliczania średniej z wartości znajdujących się w określonej kolumnie?
A. AVGPoprawna odpowiedź
B. SUM
C. MIN
D. COUNT
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja AVG w języku SQL jest wbudowaną funkcją agregującą, która służy do obliczania średniej wartości we wskazanej kolumnie. Oblicza ona średnią arytmetyczną z wartości liczbowych w danej kolumnie, co jest niezwykle przydatne w analizie danych. Na przykład, jeśli mamy tabelę z wynikami sprzedaży, możemy użyć zapytania SQL: SELECT AVG(sprzedaż) FROM tabela_sprzedaży; aby uzyskać średnią sprzedaż. Dobrą praktyką jest stosowanie tej funkcji w połączeniu z klauzulą GROUP BY, co pozwala na obliczenie średnich wartości w różnych grupach danych, na przykład średnia sprzedaż według kategorii produktowej. Przy stosowaniu funkcji AVG warto pamiętać, że ignoruje ona wartości NULL, co wpływa na wynik obliczeń. W kontekście analizy danych w SQL, znajomość takich funkcji jak AVG jest kluczowa dla efektywnego przetwarzania i analizy informacji, co stanowi fundament dobrego zarządzania danymi.
Pytanie 24
Jakie są odpowiednie kroki w odpowiedniej kolejności, które należy podjąć, aby nawiązać współpracę pomiędzy aplikacją internetową po stronie serwera a bazą danych SQL?
A. zapytanie do bazy, wybór bazy, wyświetlenie na stronie WWW, zamknięcie połączenia
B. wybór bazy danych, nawiązanie połączenia z serwerem baz danych, zapytanie do bazy - wyświetlane na stronie WWW, zamknięcie połączenia
C. nawiązanie połączenia z serwerem baz danych, wybór bazy, zapytanie do bazy - wyświetlane na stronie WWW, zamknięcie połączeniaPoprawna odpowiedź
D. wybór bazy, zapytanie do bazy, nawiązanie połączenia z serwerem baz danych, wyświetlenie na stronie WWW, zamknięcie połączenia
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Aby nawiązać współpracę między aplikacją internetową a bazą danych SQL, niezbędne jest przestrzeganie odpowiedniej sekwencji kroków. Proces ten rozpoczyna się od nawiązania połączenia z serwerem baz danych, co jest kluczowe, ponieważ bez aktywnego połączenia aplikacja nie ma możliwości komunikacji z bazą. Następnie dokonujemy wyboru konkretnej bazy danych, z którą chcemy pracować. Jest to istotny krok, ponieważ w przypadku serwera mogą istnieć różne bazy, a aplikacja musi wiedzieć, z którą z nich ma się połączyć. Po dokonaniu wyboru bazy następuje wysłanie zapytania do bazy danych, które może być zapytaniem typu SELECT, INSERT, UPDATE, lub DELETE w zależności od potrzeb aplikacji. Po zrealizowaniu zapytania wyniki są przetwarzane i wyświetlane na stronie internetowej. Ostatnim krokiem jest zamknięcie połączenia z bazą danych, co jest ważne dla zarządzania zasobami, zapobiega to wyciekom pamięci i utrzymuje wydajność serwera. Te kroki są zgodne z ogólnymi standardami tworzenia aplikacji webowych i wzorcami projektowymi, jak na przykład architektura MVC, gdzie kontroler jest odpowiedzialny za zarządzanie komunikacją z bazą danych.
Pytanie 25
Przedstawiony kod PHP nawiązuje połączenie z serwerem bazy danych. Jakiego typu operacje powinny się znaleźć w instrukcji warunkowej w miejscu trzech kropek? $db = mysqli_connect("localhost", "root", "qwerty", "baza1"); if (!$db) { ... }
A. Zamknięcie połączenia z bazą danych
B. Obsługa błędu połączeniaPoprawna odpowiedź
C. Informacja o udanym połączeniu z bazą
D. Obsługa danych uzyskanych z bazy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wybór obsługi błędu połączenia jako prawidłowej odpowiedzi jest zgodny z najlepszymi praktykami programistycznymi w zakresie zarządzania połączeniami z bazą danych. W sytuacji, gdy połączenie nie zostanie nawiązane, ważne jest, aby skutecznie obsłużyć ten błąd. Tylko w ten sposób programista może zrozumieć, co poszło nie tak, a także podjąć odpowiednie kroki w celu skorygowania problemu. Na przykład można wyświetlić komunikat informujący o błędzie, logować go w systemie lub wysłać powiadomienie do administratora. Dobrą praktyką jest również implementacja mechanizmów ponownego łączenia lub alternatywnych metod połączenia, jeśli to możliwe. Warto również zaznaczyć, że niewłaściwe zarządzanie połączeniem z bazą danych może prowadzić do poważnych konsekwencji, takich jak utrata danych, a nawet awarie aplikacji. Dlatego, umieszczając kod do obsługi błędów w instrukcji warunkowej, programista wykazuje się odpowiedzialnością oraz dbałością o jakość kodu.
Pytanie 26
W SQL, aby zmodyfikować strukturę tabeli, na przykład dodając lub usuwając kolumnę, należy użyć polecenia
A.
TRUNCATE
B.
UPDATE
C.
DROPTABLE
D.
ALTERTABLE
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź "ALTER TABLE" jest poprawna, ponieważ jest to standardowe polecenie w języku SQL używane do modyfikacji istniejącej struktury tabeli. Dzięki temu poleceniu można dodawać nowe kolumny, usuwać istniejące, a także zmieniać typy danych kolumn. Przykładowo, aby dodać kolumnę "wiek" do tabeli "pracownicy", można użyć polecenia: "ALTER TABLE pracownicy ADD COLUMN wiek INT;". Innym zastosowaniem może być usunięcie kolumny, co osiągamy poprzez zapis: "ALTER TABLE pracownicy DROP COLUMN wiek;". W praktyce, stosowanie ALTER TABLE jest kluczowe w zarządzaniu bazami danych, szczególnie w przypadku rozwijania aplikacji, gdzie schematy danych mogą ewoluować z czasem. Warto pamiętać, że modyfikacje struktury tabeli mogą wpływać na integralność danych, dlatego przed ich wykonaniem zaleca się tworzenie kopii zapasowych oraz dokładne przemyślenie wpływu zmian na aplikacje korzystające z danej bazy danych.
Pytanie 27
W relacyjnych systemach baz danych, gdy dwie tabele są powiązane przez ich klucze główne, mamy do czynienia z relacją
A. 1..n
B. n..n
C. 1..1Poprawna odpowiedź
D. n..1
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W relacyjnych bazach danych, relacja 1..1 oznacza, że każdemu rekordowi w pierwszej tabeli odpowiada dokładnie jeden rekord w drugiej tabeli, a odwrotnie. Gdy tabele są połączone kluczem głównym, zapewnia to unikalność powiązań między nimi. Przykładami takich relacji mogą być tabele 'Pracownicy' i 'Konta', gdzie każdy pracownik ma jedno konto, a każde konto należy do jednego pracownika. Relacja 1..1 jest typowa w sytuacjach, gdy jedna tabela zawiera szczegółowe informacje o obiektach reprezentowanych w drugiej tabeli. Z perspektywy projektowania baz danych, stosowanie relacji 1..1 pomaga w minimalizowaniu redundancji danych oraz zwiększa spójność informacji. Praktyczne podejście do projektowania bazy danych sugeruje, aby relacje 1..1 były wykorzystywane tam, gdzie konieczne jest zapewnienie jednoznacznego powiązania danych, co wspiera integralność danych zgodnie z normami ACID (Atomicity, Consistency, Isolation, Durability).
Pytanie 28
Aby wygodnie wprowadzać i edytować dane w bazie danych, można posłużyć się:
A. raportem
B. formularzemPoprawna odpowiedź
C. kwerendą SELECT
D. filtrowaniem
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Formularz to wygodny interfejs do pracy z danymi: udostępnia pola odpowiadające kolumnom tabeli, dzięki czemu użytkownik może wprowadzać nowe rekordy i edytować istniejące bez ręcznego pisania zapytań SQL. Stosuje się go w aplikacjach i systemach baz danych, by uprościć i zabezpieczyć wpisywanie danych. Dlatego do wygodnego wprowadzania i modyfikowania danych służy właśnie formularz.
Pytanie 29
Narzędziem do zarządzania bazą danych, które jest zintegrowane w pakiecie XAMPP, jest
A. pgAdmin
B. MySQL Workbench
C. phpMyAdminPoprawna odpowiedź
D. SQLite
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: phpMyAdmin jest popularnym narzędziem wbudowanym w pakiet XAMPP, które służy do zarządzania bazą danych MySQL. Umożliwia użytkownikom łatwe wykonywanie operacji takich jak tworzenie, edytowanie i usuwanie baz danych oraz tabel, a także zarządzanie użytkownikami i uprawnieniami. Interfejs phpMyAdmin jest oparty na przeglądarkach internetowych, co sprawia, że jego obsługa jest intuicyjna nawet dla osób bez zaawansowanej wiedzy technicznej. Przykładowo, można szybko importować lub eksportować dane w różnych formatach, takich jak SQL, CSV czy XML, co jest niezwykle przydatne podczas migracji danych między różnymi środowiskami. Standardy dobrych praktyk przewidują korzystanie z narzędzi takich jak phpMyAdmin w celu minimalizacji ryzyka błędów manualnych, a także w celu zwiększenia efektywności pracy z bazami danych. Dzięki phpMyAdmin, użytkownicy mogą również łatwo monitorować wydajność bazy danych i optymalizować zapytania, co jest kluczowe dla utrzymania wysokiej jakości aplikacji webowych.
Pytanie 30
Dana jest tabela uczniowie, do której wpisano rekordy jak na rysunku. Co będzie wynikiem działania przedstawionego zapytania SQL?
SELECT AVG(ocena) FROM uczniowie;
Nazwisko
Imie
ocena
Kowalski
Sebastian
4
Kaczmarek
Marta
3
Baryła
Zenon
4
Gota
Anna
3
A. Liczba wierszy równa 4
B. Wartość 3.5Poprawna odpowiedź
C. Suma ocen równa 14
D. Dane 4, 3, 4, 3
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Tak, poprawna odpowiedź to 'Wartość 3.5'. W zapytaniu SQL 'SELECT AVG(ocena) FROM uczniowie;' używamy funkcji AVG, żeby obliczyć średnią. W tym przypadku ona bierze oceny z tabeli 'uczniowie' i liczy, ile wynosi średnia. Jak to działa? Suma wszystkich ocen to 14 (3 + 4 + 3 + 4), a mamy cztery oceny, więc dzielimy 14 przez 4 i wychodzi nam 3.5. To jest super przykład, jak można wykorzystać funkcję AVG w SQL, co jest naprawdę przydatne, szczególnie, gdy mamy dużą ilość danych do przeanalizowania. Dobrze jest znać takie funkcje agregujące jak AVG, SUM, MAX czy MIN, bo ułatwiają one analizę danych.
Pytanie 31
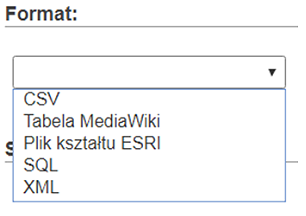
Na ilustracji przedstawiono wybór formatu pliku do importu bazy danych. Który format powinien być wykorzystany, jeśli dane zostały wyeksportowane z programu Excel i zapisane jako tekst z użyciem przecinka do oddzielania wartości pól?
A. CSVPoprawna odpowiedź
B. ESRI
C. XML
D. SQL
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Format CSV jest powszechnie używany do przechowywania danych tabelarycznych, które są eksportowane z programów takich jak Microsoft Excel. CSV, czyli Comma-Separated Values, wykorzystuje przecinek jako separator pól, co sprawia, że jest idealnym wyborem do importowania danych, które są zapisane w ten sposób. W praktyce, CSV jest niezwykle popularny ze względu na swoją prostotę i szeroką kompatybilność z różnymi systemami baz danych oraz narzędziami analitycznymi. CSV jest formatem tekstowym, co oznacza, że dane są zapisane w formacie, który jest łatwy do odczytania przez ludzi, a jednocześnie można go efektywnie przetwarzać programowo. W branży IT i analizie danych, CSV jest standardem ze względu na łatwość integracji i możliwość pracy z dużymi zestawami danych przy stosunkowo niskim zużyciu zasobów systemowych. Praktycznym przykładem zastosowania CSV jest importowanie listy klientów z programu Excel do systemu CRM. W takim przypadku eksportujemy dane z Excela w formacie CSV, a następnie importujemy je do bazy danych, co pozwala na szybkie i efektywne zarządzanie informacjami o klientach. CSV oferuje również możliwość łatwego manipulowania danymi za pomocą skryptów i narzędzi CLI, co czyni go elastycznym rozwiązaniem w wielu środowiskach IT.
Pytanie 32
Została stworzona baza danych z tabelą podzespoły, która zawiera pola: model, producent, typ, cena. Aby uzyskać listę wszystkich modeli pamięci RAM od firmy Kingston uporządkowanych od najniższej do najwyższej ceny, należałoby użyć kwerendy:
Wyjaśnienie poprawnej odpowiedzi: Wybrana kwerenda jest poprawna, ponieważ dokładnie spełnia wymagania zadania. Użycie klauzuli SELECT do wyboru pola 'model' z tabeli 'podzespoły' pozwala na uzyskanie właściwych informacji. Warunek WHERE ogranicza wyniki do tych, które dotyczą pamięci RAM (typ='RAM') oraz producenta Kingston (producent='Kingston'). Kluczowym elementem tej kwerendy jest zastosowanie ORDER BY cena ASC, które sortuje wyniki według ceny w porządku rosnącym, co jest zgodne z wymaganiem wyświetlenia modeli od najtańszej do najdroższej. Przykłady zastosowania takiej kwerendy mogą obejmować systemy zarządzania zapasami, gdzie klienci poszukują najlepszych ofert, czy aplikacje e-commerce, które chcą dostarczyć użytkownikom najbardziej korzystne opcje zakupowe. Stosowanie jasnych i precyzyjnych kwerend SQL, według dobrych praktyk branżowych, jest kluczowe dla wydajności i przejrzystości danych.
Pytanie 33
Jakie działanie wykonuje polecenie DBCC CHECKDB("sklepAGD", Repair_fast) w MS SQL Server?
A. sprawdzi spójność bazy danych i naprawi uszkodzone indeksyPoprawna odpowiedź
B. zweryfikuje spójność danej tabeli oraz naprawi uszkodzone rekordy
C. sprawdzi spójność bazy danych i utworzy kopię zapasową
D. zweryfikuje spójność danej tabeli
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie DBCC CHECKDB w MS SQL Server to narzędzie używane do weryfikacji integralności bazy danych. W przypadku użycia opcji Repair_fast, polecenie to sprawdza spójność bazy danych oraz naprawia uszkodzone indeksy. Jest to istotne w kontekście zapewnienia, że wszystkie dane w bazie są prawidłowo zorganizowane i dostępne. Uszkodzone indeksy mogą prowadzić do problemów z wydajnością zapytań oraz błędów w dostępie do danych. Przykładowo, gdy baza danych ulega uszkodzeniu z powodu awarii sprzętu lub błędów oprogramowania, DBCC CHECKDB umożliwia przywrócenie funkcjonalności. Dobrą praktyką jest regularne wykonywanie tego polecenia jako część strategii utrzymania bazy danych, co pozwoli na wcześniejsze wykrycie potencjalnych problemów, zanim staną się one krytyczne. Warto również zaznaczyć, że DBCC CHECKDB powinno być uruchamiane w odpowiednich oknach serwisowych, by zminimalizować wpływ na wydajność aplikacji korzystających z bazy danych.
Pytanie 34
Co oznacza integralność referencyjna w relacyjnych bazach danych?
A. klucz główny i obcy nie mogą być puste
B. klucz główny i obcy nie zawierają wartości NULL
C. klucz obcy musi równać się kluczowi głównemu powiązanej tabeli albo być NULLPoprawna odpowiedź
D. każdemu kluczowi głównemu odpowiada dokładnie jeden klucz obcy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Integralność referencyjna wymaga, by wartość klucza OBCEGO odpowiadała istniejącemu kluczowi głównemu w powiązanej tabeli albo była pusta (NULL). Nie może wskazywać na nieistniejący rekord. Dlatego klucz obcy musi równać się kluczowi głównemu powiązanej tabeli albo być NULL.
Pytanie 35
Jaki typ danych w MySQL należy zastosować, aby w jednym polu zapisać zarówno datę, jak i czas?
A. DATE
B. BOOLEAN
C. TIMESTAMPPoprawna odpowiedź
D. YEAR
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Typ danych TIMESTAMP w MySQL jest przeznaczony do przechowywania zarówno daty, jak i czasu w jednym polu. Jest szczególnie przydatny w sytuacjach, gdy potrzebne jest śledzenie zdarzeń w czasie, takich jak rejestracja daty i godziny utworzenia lub modyfikacji rekordów w bazie danych. TIMESTAMP przechowuje dane w formacie 'YYYY-MM-DD HH:MM:SS', co pozwala na precyzyjne określenie momentu w czasie. Wartością dodaną tego typu danych jest automatyczne aktualizowanie znacznika czasu przy każdej zmianie rekordu (jeśli ustawimy odpowiednie opcje), co jest zgodne z najlepszymi praktykami w zakresie audytu danych. Przykładem zastosowania może być rejestracja logów aktywności użytkowników w aplikacji internetowej lub monitorowanie transakcji w systemach finansowych, gdzie dokładny czas zdarzenia jest kluczowy. Dodatkowo, TIMESTAMP obsługuje różnice stref czasowych, co czyni go idealnym wyborem w aplikacjach działających w różnych lokalizacjach geograficznych.
Pytanie 36
Zdefiniowana jest tabela uczniowie z polami id, nazwisko, imie oraz klasa. Jakie zapytanie SQL pozwoli nam uzyskać liczbę osób w danym klasa i wskazać jej nazwę?
A.
SELECTSUM(id),klasaFROMuczniowieORDERBYklasa
B.
SELECTSUM(id),klasaFROMuczniowieGROUPBYklasa
C.
SELECTCOUNT(id),klasaFROMuczniowieORDERBYklasa
D.
SELECTCOUNT(id),klasaFROMuczniowieGROUPBYklasa
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź 'SELECT COUNT(id), klasa FROM uczniowie GROUP BY klasa;' jest prawidłowa, ponieważ wykorzystuje funkcję agregującą COUNT do zliczenia liczby uczniów w każdej klasie. Kluczowym elementem jest tutaj klauzula GROUP BY, która grupuje wyniki według kolumny 'klasa'. Dzięki temu uzyskujemy dla każdej klasy osobny wynik z liczbą uczniów. To podejście jest zgodne z dobrymi praktykami w SQL, gdzie użycie funkcji agregujących z grupowaniem pozwala na efektywne przetwarzanie danych. Przykładowo, w przypadku szkoły, taka analiza może być użyta do zarządzania zasobami lub planowania, na przykład, przy ustalaniu liczby nauczycieli potrzebnych w danej klasie. Użycie COUNT zapewnia również, że wynik będzie liczbowy, co jest istotne dla dalszej analizy danych. Warto również pamiętać, że korzystanie z odpowiednich aliasów dla wyników może poprawić czytelność wyników zapytania.
Pytanie 37
Jakie tabele będą weryfikowane przez podane polecenie?
CHECK TABLEpracownicyCHANGED;
A. Tabele, które uległy zmianie od ostatniego sprawdzenia lub nie zostały prawidłowo zamknięte.Poprawna odpowiedź
B. Tabele, które zmieniły się w bieżącej sesji.
C. Tylko tabele, które nie zostały prawidłowo zamknięte.
D. Jedynie tabele referencyjne.
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź, że polecenie CHECK TABLE sprawdzi tabele, które zmieniły się od ostatniej kontroli lub nie zostały poprawnie zamknięte, jest poprawna. Polecenie to jest wykorzystywane w systemach zarządzania bazami danych, takich jak MySQL, do diagnozowania i naprawy problemów związanych z integralnością danych. Kiedy tabele są zmieniane lub nie zostały poprawnie zamknięte, mogą wystąpić uszkodzenia, które mogą prowadzić do błędów przy odczycie lub zapisie danych. W praktyce, administratorzy baz danych regularnie wykonują polecenie CHECK TABLE, aby upewnić się, że struktura tabeli jest nienaruszona i że system operacyjny poprawnie zarządza danymi. Użycie CHECK TABLE w kontekście tabel, które zmieniły się od ostatniej kontroli, jest kluczowe, gdyż pozwala na szybką lokalizację problemów. Warto również zauważyć, że w przypadku dużych baz danych wykonanie tego polecenia może być czasochłonne, dlatego dobrze jest zintegrować jego użycie z harmonogramem regularnych kontroli integralności danych, co jest zgodne z najlepszymi praktykami w zarządzaniu bazami danych.
Pytanie 38
Jakie są wyniki wykonania zapytania SQL?
SELECT count(*) FROM Uczniowie WHERE srednia=5;
A. ilość uczniów, których średnia ocen wynosi 5Poprawna odpowiedź
B. łączna liczba uczniów
C. suma ocen uczniów z średnią 5
D. średnia wszystkich ocen uczniów
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Zapytanie SQL używa funkcji COUNT aby policzyć liczbę rekordów w tabeli Uczniowie spełniających warunek srednia=5 Klauzula WHERE ogranicza zestaw zliczanych rekordów do tych gdzie średnia ocen ucznia wynosi dokładnie 5 W efekcie wynik zapytania odpowiada liczbie uczniów mających średnią ocen równą 5 Takie podejście jest powszechnie stosowane w analizie danych gdzie wymagane jest określenie liczby jednostek spełniających konkretne kryteria Zastosowanie COUNT w połączeniu z WHERE umożliwia precyzyjną kontrolę nad analizowanym zbiorem danych co jest standardem w wielu systemach bazodanowych Praktyczne zastosowanie tej techniki można spotkać w raportowaniu wyników nauczania generowaniu statystyk czy w analizach biznesowych gdzie kluczowe jest zrozumienie struktury i charakterystyki danych Zapytanie to ilustruje dobrą praktykę pracy z bazami danych polegającą na efektywnym i precyzyjnym formułowaniu zapytań w celu uzyskania wartościowych i precyzyjnych informacji
B. klauzula IFNOTEXISTS jest opcjonalna i zapobiega błędowi, gdy tabela już istniejePoprawna odpowiedź
C. do tabeli nie można wpisywać ulic z polskimi znakami
D. rekordem tabeli nie może być „3 MAJA”
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Klauzula IFNOTEXISTS jest OPCJONALNA i zabezpiecza CREATETABLE - jeśli tabela o danej nazwie już istnieje, polecenie nie zgłosi błędu i nie utworzy jej ponownie. Dlatego prawdą jest, że IFNOTEXISTS jest opcjonalna i zapobiega błędowi przy istniejącej tabeli.
Pytanie 40
W jakiej strukturze zapisywane są dane w relacyjnych bazach danych?
A. w listach
B. w kolejkach
C. w wektorach
D. w tabelachPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W relacyjnych bazach danych dane przechowuje się w TABELACH - zbudowanych z wierszy (rekordów) i kolumn (atrybutów), powiązanych ze sobą przez klucze. To fundament modelu relacyjnego i języka SQL. Zapamiętaj: relacyjna baza = dane w powiązanych tabelach.