Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 7 października 2026 20:25
Zakończenie: 7 października 2026 20:42
Egzamin zdany!
Wynik: 28/40 punktów (70,0%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Jako strzał oznaczono 1 odpowiedź - trafionych: 1.
Z odpowiedzi deklarowanych jako pewne poprawnych było 27 z 39. Trafiony strzał to nie jest wiedza - te pytania warto powtórzyć w pierwszej kolejności.
Twój wynik na tle innych
Twój wynik jest lepszy niż 39% podejść do kwalifikacji INF.04.
Porównanie z 24989 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 77,5%, teraz 70,0% (-7,5 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin trafi na Twoje konto, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Aby wykorzystać framework Django, należy pisać w języku
A. Java
B. Python
Twoja odpowiedź
C. JavaScript
D. C#
Poprawna odpowiedź. Framework Django został zaprojektowany specjalnie dla języka Python i z tego powodu wszystkie projekty, aplikacje czy rozszerzenia w Django realizuje się właśnie w tym języku. To nie jest przypadek – Python od lat cieszy się ogromną popularnością w branży webowej, między innymi dzięki swojej czytelności i elastyczności. Moim zdaniem to właśnie ta prostota składni Pythona sprawia, że tak łatwo zacząć nawet większe projekty – nie trzeba tracić czasu na walkę z zawiłościami języka. W praktyce programiści korzystający z Django piszą zarówno widoki, modele, jak i całą logikę aplikacji w Pythonie, wykorzystując przy tym liczne biblioteki i narzędzia tego ekosystemu. Django jest zgodny z filozofią DRY (Don’t Repeat Yourself), co oznacza, że kod w Pythonie staje się bardzo zwięzły i przejrzysty. Często można spotkać się z opinią, że nauka Django to świetny sposób na wejście w świat programowania webowego – sam się z tym zgadzam. Warto wiedzieć, że ogromna społeczność Pythona i Django oferuje mnóstwo wsparcia, dokumentacji oraz gotowych rozwiązań, co na co dzień ułatwia pracę. Tylko w Pythonie zbudujesz pełnoprawną aplikację w Django, bo framework ten nie wspiera innych języków – to się po prostu nie uda, nawet jeśli ktoś próbuje kombinować z integracjami. Widać to choćby po oficjalnych tutorialach i dokumentacji – wszystko, od konfiguracji po deployment, opiera się na pythonowych narzędziach.
Pytanie 2
Jaką strukturę danych można zrealizować, korzystając jedynie z wymienionych poniżej metod:
push(arg) – dodaje element
pop() – usuwa ostatnio dodany element
peek() – zwraca ostatnio dodany element bez usuwania
isEmpty() – sprawdza czy istnieją dane w strukturze
A. stos
Twoja odpowiedź
B. tablica
C. drzewo binarne
D. kolejka
Poprawna odpowiedź. Stos to jedna z najbardziej podstawowych i jednocześnie użytecznych struktur danych. Wszystkie wymienione metody - push, pop, peek oraz isEmpty - są klasycznymi operacjami definiującymi właśnie stos (czyli tzw. LIFO, czyli Last-In-First-Out). Oznacza to, że ostatni element, który został dodany do stosu, będzie pierwszym usuniętym. Z mojego doświadczenia wynika, że stosy są bardzo często wykorzystywane w praktyce, na przykład przy realizacji algorytmów rekurencyjnych (zarówno w kodzie, jak i na niższym poziomie, jak stos wywołań funkcji w pamięci programu), co jest zgodne ze standardami języków programowania, takich jak C, Java czy Python. W praktycznych zastosowaniach stosów używa się m.in. przy sprawdzaniu poprawności nawiasów w wyrażeniach matematycznych, przy parsowaniu kodu, cofnięciach operacji w edytorach tekstu czy realizacji algorytmu przeszukiwania w głąb (DFS). Co ciekawe, stos można łatwo zaimplementować zarówno na tablicach dynamicznych, jak i na listach jednokierunkowych. Dobre praktyki branżowe zalecają, aby stos wykorzystywać zawsze tam, gdzie potrzebny jest szybki dostęp do ostatnio dodanego elementu i nie zachodzi potrzeba dostępu w inny sposób. Moim zdaniem, zrozumienie działania stosu to fundament dla każdego, kto serio podchodzi do programowania i algorytmiki.
Pytanie 3
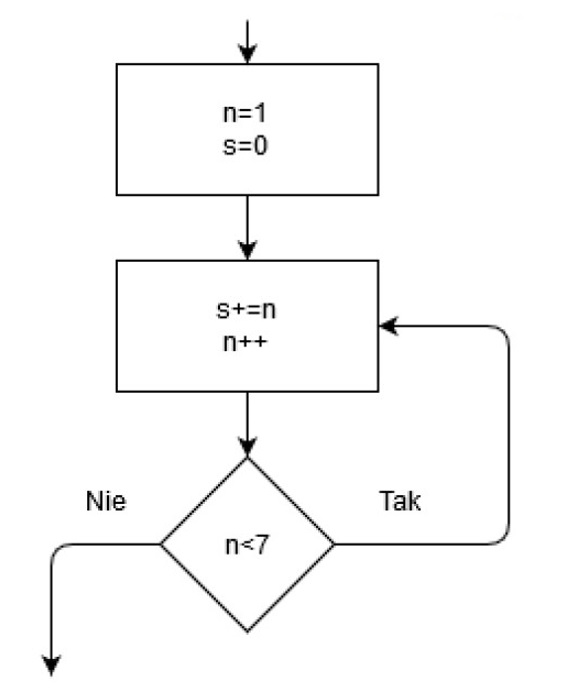
Na ilustracji pokazany jest fragment diagramu blokowego pewnego algorytmu. Ile razy warunek n<7 będzie badany?
A. 5
B. 6
Twoja odpowiedź
C. 7
D. 8
Poprawna odpowiedź. Odpowiedź 4 jest prawidłowa ponieważ algorytm rozpoczyna od n równego 1 i zwiększa tę wartość o jeden w każdej iteracji aż do momentu gdy n stanie się równe 7 Wtedy warunek n mniejsze od 7 przestaje być spełniony co oznacza że warunek ten jest sprawdzany łącznie 6 razy tj dla n równych 1 2 3 4 5 i 6 Jest to typowa pętla kontrolna często spotykana w programowaniu gdzie warunek pętli decyduje o jej zakończeniu W praktyce takie podejście pozwala na efektywne zarządzanie liczbą iteracji i zapewnia klarowność kodu Co więcej użycie pętli z warunkiem końcowym jest zgodne z dobrymi praktykami projektowania algorytmów gdyż minimalizuje ryzyko błędów logicznych poprzez jawne określenie końca pętli Ponadto zrozumienie mechanizmu działania pętli i jej warunków jest kluczowe dla optymalizacji algorytmów i efektywnego zarządzania zasobami co ma bezpośrednie przełożenie na wydajność aplikacji szczególnie w środowiskach wymagających dużej mocy obliczeniowej
Pytanie 4
Jedną z dolegliwości, która pojawia się u programistów w wyniku długotrwałego korzystania z myszki komputerowej lub klawiatury, objawiającą się bólem, drętwieniem oraz zaburzeniami czucia w rejonie 1-3 palca ręki jest
A. kifoza
B. dyskopatia
C. zespół cieśni kanału nadgarstka
Twoja odpowiedź
D. zespół suchego oka
Poprawna odpowiedź. Zespół cieśni kanału nadgarstka to jedna z najczęstszych chorób zawodowych wśród osób pracujących przy komputerze, zwłaszcza programistów czy grafików. Objawia się on bólem, drętwieniem oraz czasem nawet zaburzeniami czucia w obrębie pierwszych trzech palców ręki – dokładnie tak, jak opisano w pytaniu. Dzieje się tak dlatego, że nerw pośrodkowy, który przebiega przez wąski kanał w nadgarstku, jest uciskany na skutek długotrwałego powtarzania tych samych ruchów albo nieprawidłowego ułożenia dłoni na myszce czy klawiaturze. Moim zdaniem temat jest mega ważny, bo wiele osób bagatelizuje drobne drętwienia, a potem kończy się to nawet koniecznością zabiegu! W praktyce najlepiej stosować ergonomiczną klawiaturę i myszkę, robić krótkie przerwy co godzinę i ćwiczyć rozluźnianie nadgarstków. W branży IT coraz częściej zwraca się uwagę na profilaktykę tych schorzeń – nawet firmy zapewniają konsultacje z fizjoterapeutą, a niektórzy znajomi mają specjalne podkładki pod nadgarstki. No i jeszcze jedno – ignorowanie objawów może prowadzić do trwałego uszkodzenia nerwu, więc naprawdę warto od razu reagować na pierwsze sygnały. W literaturze branżowej (np. w wytycznych BHP dla programistów) podkreśla się, że ergonomiczne miejsce pracy i właściwe nawyki to klucz, żeby nie nabawić się tej przypadłości. Z mojego doświadczenia, nawet zmiana kąta nachylenia klawiatury potrafi zrobić dużą różnicę.
Pytanie 5
Co to jest wskaźnik w języku C?
A. Typ danych do zapisywania tekstów
B. Zmienna przechowująca wartość logiczną
C. Zmienna przechowująca adres pamięci
Twoja odpowiedź
D. Funkcja do dynamicznej alokacji pamięci
Poprawna odpowiedź. Wskaźnik w języku C to zmienna przechowująca adres pamięci innej zmiennej. Umożliwia bezpośrednią manipulację pamięcią, co czyni wskaźniki niezwykle potężnym narzędziem w programowaniu niskopoziomowym. Dzięki wskaźnikom można dynamicznie alokować pamięć, przekazywać duże struktury danych do funkcji bez ich kopiowania oraz implementować struktury danych, takie jak listy, drzewa czy grafy. Wskaźniki umożliwiają także iterowanie po tablicach i efektywne zarządzanie zasobami systemowymi, co czyni je kluczowym elementem w programowaniu systemowym.
Pytanie 6
Przedstawione w filmie działania wykorzystują narzędzie
A. generatora kodu java
B. debuggera analizującego wykonujący kod
C. kompilatora dla interfejsu graficznego
D. generatora GUI przekształcającego kod do języka XAML
Twoja odpowiedź
Poprawna odpowiedź. Wybrana odpowiedź jest trafna, bo faktycznie narzędzie pokazane w filmie to generator GUI, który potrafi przekształcać kod do języka XAML. XAML (czyli Extensible Application Markup Language) jest powszechnie używany do deklaratywnego opisywania interfejsów użytkownika, na przykład w aplikacjach WPF czy UWP na platformie .NET. Jak dla mnie, korzystanie z takich generatorów to ogromna wygoda, bo pozwala błyskawicznie przenosić projekt graficzny do formatu czytelnego dla platformy Microsoftu. Z mojego doświadczenia, wiele zespołów programistycznych stosuje takie rozwiązania, żeby oszczędzić czas na ręcznym pisaniu XAML-a (co potrafi być naprawdę żmudne przy dużych projektach). Co ciekawe, takie narzędzia bardzo dobrze współpracują z designerskimi edytorami UI i potrafią zautomatyzować konwersję nawet z innych formatów graficznych, np. Sketch czy Adobe XD do XAML-a. Branżowe standardy zalecają, by wykorzystywać generatorów GUI właśnie do tego celu, bo minimalizuje to liczbę błędów, przyspiesza wdrożenie zmian i ułatwia współpracę między programistami a projektantami. Warto pamiętać, że XAML jest bardzo elastyczny i umożliwia potem ręczną edycję wygenerowanego kodu – czasem powstają drobne poprawki, ale ogólnie to naprawdę przydatne narzędzie. Ogólnie – jeśli tylko projektujesz UI pod .NET, to automatyczna konwersja do XAML-a to jest coś, co warto znać i wykorzystywać w praktyce.
Pytanie 7
Które z poniższych zdań najlepiej określa funkcję zaprzyjaźnioną w ramach klasy?
A. Funkcja, która pozwala na dziedziczenie wielokrotne
B. Funkcja, która ma dostęp do prywatnych pól i metod klasy, z którą jest zaprzyjaźniona
Twoja odpowiedź
C. Funkcja, która uruchamia się automatycznie po stworzeniu obiektu
D. Funkcja, która jest statyczna i nie ma możliwości modyfikacji pól klasy
Poprawna odpowiedź. Funkcja zaprzyjaźniona (ang. friend function) to funkcja, która ma dostęp do prywatnych i chronionych pól oraz metod klasy, mimo że nie jest jej częścią. Służy do realizacji operacji wymagających bezpośredniego dostępu do wewnętrznych elementów klasy, ale bez naruszania zasad hermetyzacji. Przykład w C++: `class Konto { private: double saldo; friend void wyswietlSaldo(Konto k); }`. Funkcja `wyswietlSaldo` może odczytać pole `saldo`, mimo że jest ono prywatne. Funkcje zaprzyjaźnione są używane, gdy konieczna jest bliska współpraca między klasami lub funkcjami, ale nie chcemy nadmiernie otwierać interfejsu klasy.
Pytanie 8
Który z wymienionych elementów jest fundamentalny w architekturze klient-serwer?
A. Scentralizowane przechowywanie danych
Poprawna odpowiedź
B. Wyłącznie komunikacja synchroniczna
C. Brak podziału na funkcje klienta i serwera
D. Zdalne wykonywanie aplikacji na urządzeniu klienta
Twoja odpowiedź
Niepoprawna odpowiedź. Zdalne wykonywanie aplikacji na urządzeniu klienta oznacza model przetwarzania lokalnego, co nie jest główną cechą architektury klient-serwer. Brak podziału na funkcje klienta i serwera narusza podstawową ideę tego modelu, który zakłada rozdzielenie ról pomiędzy te dwie jednostki. Wyłącznie komunikacja synchroniczna ogranicza elastyczność aplikacji i może prowadzić do opóźnień w przetwarzaniu danych.
Pytanie 9
Jak nazywa się wzorzec projektowy, do którego odnosi się ta definicja?
Wzorzec projektowy należący do grupy wzorców strukturalnych. Służy do ujednolicenia dostępu do złożonego systemu poprzez wystawienie uproszczonego, uporządkowanego interfejsu programistycznego, który ułatwia jego użycie.
Źródło Wikipedia. Wolna encyklopedia
A. Dekorator
B. Prototyp
C. Fasada
Twoja odpowiedź
D. Kompozyt
Poprawna odpowiedź. Wzorzec projektowy Fasada jest jednym z kluczowych wzorców strukturalnych używanych w inżynierii oprogramowania. Jego głównym celem jest uproszczenie i ujednolicenie interakcji z złożonym systemem poprzez wystawienie uproszczonego i uporządkowanego interfejsu programistycznego. Fasada ukrywa złożoność systemu, zapewniając jednolity punkt dostępu do zestawu funkcji lub klas. W praktyce fasada jest używana do tworzenia prostych interfejsów dla bardziej złożonych bibliotek lub systemów, co ułatwia ich użycie przez programistów. Na przykład w systemie bankowym fasada może zintegrować różne usługi jak autoryzacja płatności, zarządzanie kontami i generowanie wyciągów, oferując jeden interfejs do ich obsługi. Fasada wspiera dobre praktyki poprzez promowanie niskiej zależności i wysokiej spójności. Zmiany w wewnętrznym działaniu systemu są mniej widoczne na zewnątrz, co zwiększa elastyczność systemu. Fasada jest zgodna z zasadą projektowania SOLID, zwłaszcza z zasadą pojedynczej odpowiedzialności, umożliwiając lepsze zarządzanie kodem i jego utrzymanie. Jej użycie jest powszechne w systemach złożonych, gdzie upraszczanie interfejsów jest kluczowe dla efektywności programistycznej i skalowalności systemu.
Pytanie 10
Jakie ma znaczenie operator "==" w języku C++?
A. Negacja logiczna
B. Przypisanie wartości do zmiennej
C. Zwiększenie wartości zmiennej o 1
D. Porównanie dwóch wartości
Twoja odpowiedź
Poprawna odpowiedź. Operator `==` w języku C++ oraz w wielu innych językach programowania, takich jak Java, Python czy JavaScript, jest używany do porównywania dwóch wartości. Jeśli wartości są równe, zwracana jest wartość logiczna `true`, w przeciwnym razie `false`. Operator ten jest niezbędny w instrukcjach warunkowych i pętlach, umożliwiając programowi podejmowanie decyzji na podstawie porównań. Przykładem użycia jest `if (a == b)`, co oznacza: jeśli zmienna `a` jest równa zmiennej `b`, wykonaj określony blok kodu.
Pytanie 11
Która z wymienionych reguł należy do netykiety?
A. Zaniechanie odpowiadania na wiadomości od innych użytkowników
B. Stosowanie nieformalnego języka w każdej rozmowie
C. Unikanie używania dużych liter w komunikacji
Twoja odpowiedź
D. Udostępnianie treści bez zgody właścicieli
Poprawna odpowiedź. Unikanie pisania wielkimi literami w wiadomościach jest kluczowym elementem netykiety, ponieważ tekst pisany dużymi literami w internecie jest powszechnie interpretowany jako krzyk. To zasada, która ma na celu utrzymanie kultury komunikacji online oraz zapewnienie komfortu odbiorcy. Gdy użytkownik korzysta z wielkich liter, może to być odbierane jako agresywne lub dominujące, co może prowadzić do nieporozumień oraz negatywnych reakcji. Przykładem może być sytuacja, w której osoba, pisząc do grupy na forum internetowym, używa wyłącznie wielkich liter, co może zniechęcić innych do interakcji. Dobrą praktyką jest pisanie w sposób przystępny i zrozumiały, co sprzyja pozytywnej atmosferze w komunikacji. Standardy netykiety, takie jak te przedstawione w dokumentach związanych z etyką w internecie, podkreślają znaczenie szacunku i zrozumienia w interakcjach online, co obejmuje również sposób formułowania wiadomości. Warto także pamiętać o tym, że różne platformy społecznościowe mają swoje zasady, które podkreślają unikanie pisania krzykiem, co potwierdza ogólne podejście do netykiety.
Pytanie 12
Jakie działania należy podjąć, aby uniknąć nieskończonej rekurencji w danej funkcji?
A. Rozszerzyć zakres zmiennych globalnych
B. Zastosować iterację zamiast rekurencji
C. Dodać warunek zakończenia w funkcji
Twoja odpowiedź
D. Wykorzystać automatyczny debugger w kompilatorze
Poprawna odpowiedź. Warunek stopu to taki kluczowy element w rekurencji, który właściwie mówi, kiedy funkcja powinna przestać się wywoływać. Jak masz ten warunek, to funkcja wraca z wynikiem zamiast kręcić się w kółko, co mogłoby prowadzić do jakiegoś szaleństwa, tzn. przepełnienia stosu. Myślę, że warto zwrócić uwagę, że dodanie tego warunku to naprawdę podstawowa sprawa w programowaniu, bo bez niego wszystko może się posypać i przestanie działać tak, jak powinno.
Pytanie 13
Złośliwe oprogramowanie stworzone w celu przyznania hakerom uprawnień administracyjnych do komputera ofiary bez jej świadomości, to
A. robak
B. wirus
C. keylogger
D. rootkit
Twoja odpowiedź
Poprawna odpowiedź. Rootkit to specyficzny rodzaj złośliwego oprogramowania, który został stworzony właśnie po to, żeby uzyskać i utrzymać nieautoryzowane uprawnienia administracyjne na systemie ofiary, a jednocześnie pozostać jak najbardziej niezauważonym. W praktyce, rootkit pozwala atakującemu przejąć pełną kontrolę nad komputerem – może wtedy instalować inne szkodliwe programy, kraść dane czy omijać zabezpieczenia bez wiedzy użytkownika. Co ważne, rootkity są często wykorzystywane przez cyberprzestępców do tzw. eskalacji uprawnień, czyli podniesienia poziomu dostępu z konta zwykłego użytkownika do administratora (roota), co w świecie Linuksa i Unixa jest dość powszechną strategią. Moim zdaniem, to jeden z najtrudniejszych do wykrycia typów malware – potrafi modyfikować systemowe procesy, a nawet podszywać się pod pliki systemowe, co sprawia, że standardowe antywirusy często go nie wykrywają. W branży IT mówi się wręcz o konieczności korzystania z zaawansowanych narzędzi forensics, np. rootkit detectors i regularnym monitorowaniu integralności systemu, zgodnie z zaleceniami CIS Controls. Jeśli ktoś chce się dobrze zabezpieczyć, to naprawdę warto zwracać uwagę na nieoczywiste symptomy: podejrzane procesy, zmiany w kluczowych plikach systemowych czy dziwne aktywności sieciowe. Rootkit to prawdziwy koszmar administratorów i świetny „przykład z życia” na to, jak ważna jest segmentacja uprawnień i stosowanie zasady najmniejszych uprawnień.
Pytanie 14
Co to jest API w kontekście programowania?
A. System zarządzania relacyjnymi bazami danych
B. Metoda kompresji danych w aplikacjach webowych
C. Interfejs programistyczny aplikacji, który definiuje sposób komunikacji między różnymi komponentami oprogramowania
Twoja odpowiedź
D. Narzędzie do testowania interfejsu użytkownika aplikacji
Poprawna odpowiedź. API, czyli Interfejs Programistyczny Aplikacji, to zestaw reguł i protokołów, które umożliwiają różnym komponentom oprogramowania komunikację ze sobą. W praktyce API działa jako most między różnymi systemami, pozwalając na wymianę danych oraz funkcji. Na przykład, API może być wykorzystywane do integracji z zewnętrznymi serwisami, takimi jak systemy płatności, co pozwala na łatwe wdrożenie funkcji zakupów online w aplikacji. Stosowanie API zgodnie z zasadami RESTful czy GraphQL jest powszechną praktyką, ponieważ ułatwia rozwój i utrzymanie aplikacji, umożliwiając tworzenie skalowalnych rozwiązań. Co więcej, dobrze zdefiniowane API zwiększa bezpieczeństwo aplikacji, ograniczając bezpośredni dostęp do wewnętrznych mechanizmów oraz danych. Firmy często tworzą dokumentację API, aby programiści mogli szybko zrozumieć, jak z niego korzystać, co jest zgodne z zasadami dobrych praktyk w branży programistycznej.
Pytanie 15
Co oznacza termin 'hoisting' w JavaScript?
A. Optymalizacja kodu wykonywana przez silnik JavaScript
B. Metoda ładowania skryptów z zewnętrznych źródeł
C. Technika zarządzania pamięcią polegająca na usuwaniu nieużywanych obiektów
D. Przenoszenie deklaracji zmiennych i funkcji na górę ich zakresu podczas fazy kompilacji
Twoja odpowiedź
Poprawna odpowiedź. Termin 'hoisting' w JavaScript odnosi się do mechanizmu, który przenosi deklaracje zmiennych oraz funkcji na górę ich zakresu, zanim kod zostanie wykonany. To oznacza, że zmienne i funkcje mogą być używane przed ich faktycznym zadeklarowaniem w kodzie. Dla zmiennych zadeklarowanych za pomocą 'var', ich deklaracja jest unoszona, ale nie inicjalizacja. To oznacza, że można odwołać się do zmiennej przed jej przypisaniem, ale jej wartość będzie 'undefined'. W przypadku funkcji, cała deklaracja jest przenoszona, co pozwala na wywoływanie funkcji przed ich zdefiniowaniem. Przykład takiego działania to: `console.log(a); var a = 5;` - w tym przypadku, logowanie zmiennej 'a' przed przypisaniem zwróci 'undefined'. Zrozumienie hoistingu jest kluczowe dla pisania poprawnego i czytelnego kodu w JavaScript oraz unikania pułapek, które mogą prowadzić do trudnych do wykrycia błędów. Holistyczne podejście do hoistingu zachęca programistów do stosowania deklaracji na początku funkcji lub skryptu, co poprawia przejrzystość i zarządzanie zakresem w kodzie.
Pytanie 16
Co zostanie wyświetlone w konsoli po wykonaniu poniższego kodu?
console.log(0.1+0.2===0.3);console.log(0.1+0.2);
A. false, 0.30000000000000004
Poprawna odpowiedź
B. true, 0.30000000000000004
C. true, 0.3
Twoja odpowiedź
D. false, 0.3
Niepoprawna odpowiedź. Niepoprawne odpowiedzi wynikają z nieporozumienia dotyczącego reprezentacji liczb zmiennoprzecinkowych w JavaScript. Wiele osób ma tendencję do sądzenia, że operacje matematyczne z użyciem liczb dziesiętnych będą prowadziły do oczekiwanych rezultatów. Przykład `0.1 + 0.2`, który wydaje się prosty, w rzeczywistości ujawnia istotne różnice w precyzji. W przeciwieństwie do liczb całkowitych, które są reprezentowane jednoznacznie, liczby zmiennoprzecinkowe mogą wprowadzać błędy zaokrągleń. Gdyby nasze porównanie zwracało `true`, wskazywałoby to na to, że na poziomie binarnym liczby te są identyczne, co jest w przypadku JavaScript nieprawdziwe. Z kolei podanie `0.3` jako wyniku sumy w niektórych odpowiedziach nie uwzględnia tej samej zasady, co sugeruje, że porównanie tych wartości jest właściwe, mimo że nie jest. Warto zrozumieć, że takie błędne wnioski mogą prowadzić do poważnych problemów w bardziej złożonych obliczeniach, zwłaszcza w aplikacjach finansowych, gdzie precyzja jest niezbędna. Dobrym zwyczajem jest korzystanie z odpowiednich metod, które pozwalają na bezpieczne porównywanie wartości zmiennoprzecinkowych, minimalizując ryzyko błędów. Stosując podejście oparte na tolerancji błędu, można uniknąć pułapek związanych z reprezentacją liczb i poprawić dokładność obliczeń.
Pytanie 17
Wartości składowych RGB koloru #AA41FF zapisane w systemie szesnastkowym po przekształceniu na system dziesiętny są odpowiednio
A. 160, 65, 255
B. 160, 64, 255
Twoja odpowiedź
C. 170, 65, 255
Poprawna odpowiedź
D. 170, 64, 255
Niepoprawna odpowiedź. Przy przekształcaniu wartości szesnastkowych RGB na system dziesiętny łatwo popełnić błąd, bo wystarczy źle podstawić którąś cyfrę albo zmieszać kolejność. W przypadku koloru #AA41FF każda para znaków odpowiada jednej składowej: AA to czerwona, 41 to zielona, a FF to niebieska. Najczęściej błędy pojawiają się, gdy niepoprawnie zinterpretujemy cyfry szesnastkowe jako dziesiętne lub po prostu pomylimy kolejność składowych. Przykładowo, '160' w odpowiedzi zamiast '170' wynika być może z błędnego odczytania AA – bo łatwo pomylić literę A (10) z cyfrą 6 czy 0, zwłaszcza jeśli ktoś nie jest przyzwyczajony do liczb szesnastkowych. Podobnie, '64' zamiast '65' dla 41 to typowy efekt nieuwagi w liczeniu: 4*16+1 daje 65, a nie 64, co pokazuje, jak ważna jest precyzja w prostych działaniach matematycznych. Z kolei zamiana AA na 160 może świadczyć o mechanicznej zamianie liter na liczby bez uwzględnienia ich pozycji w zapisie szesnastkowym. Powszechnym błędem jest też zamiana kolejności składowych lub skupianie się tylko na końcowych cyfrach, przez co mylnie przyjmuje się, że na przykład AA to 160, bo pierwsza cyfra to 1, a nie 10. W praktyce branżowej takie niedokładności prowadzą do złych efektów wizualnych – np. kolor na stronie mocno różni się od zamierzonego lub nie pasuje do reszty projektu. Moim zdaniem takie błędy wynikają zwykle z braku nawyków w przeliczaniu systemów liczbowych. Warto zawsze pamiętać, że każda cyfra szesnastkowa ma swoją wagę, a zamiana wymaga precyzyjnego policzenia: pierwsza cyfra razy 16 plus druga cyfra. W codziennej pracy z grafiką cyfrową czy webdesignem taka pomyłka bardzo rzuca się potem w oczy użytkownikowi, więc lepiej od początku ćwiczyć dokładność niż potem szukać, gdzie zniknęła ta właściwa barwa.
Pytanie 18
Która z poniższych struktur danych jest najbardziej odpowiednia do przechowywania unikalnych elementów?
A. Tablica
Twoja odpowiedź
B. Kolejka priorytetowa
C. Sekwencja
D. Zbiór (Set)
Poprawna odpowiedź
Niepoprawna odpowiedź. Lista pozwala na dodawanie powtarzających się elementów, więc nie daje ci unikalności. Tablica działa podobnie, bo też trzyma duplikaty, bez jakiegoś mechanizmu, który by je automatycznie usuwał. Kolejka priorytetowa przechowuje rzeczy według określonej kolejności, ale tu znowu nie jest mowa o unikalności. Każda z tych struktur ma swoje zadania, ale żadna nie jest tak dobra jak zbiór, jeśli chodzi o trzymanie unikalnych danych. Dziwne, nie?
Pytanie 19
Jakie określenie w programowaniu obiektowym odnosi się do "zmiennej klasy"?
A. Konstruktor
B. Obiekt
C. Pole
Twoja odpowiedź
D. Metoda
Poprawna odpowiedź. Pole (ang. field) to zmienna należąca do klasy, która przechowuje dane opisujące stan obiektu. Jest to integralna część definicji klasy, a każde wystąpienie klasy (obiekt) ma swoje własne kopie pól. Przykład w C++: `class Osoba { public: string imie; int wiek; }`. W tym przypadku `imie` i `wiek` to pola klasy `Osoba`, które opisują właściwości każdej osoby. Pola mogą mieć różne poziomy dostępu (`public`, `private`, `protected`), co umożliwia kontrolowanie, które części programu mają do nich dostęp. Dzięki polom obiekty przechowują swój stan i mogą zmieniać go podczas działania programu.
Pytanie 20
Jakie słowa kluczowe są stosowane w języku C++ do zarządzania wyjątkami?
A. except i finally
B. try i catch
Twoja odpowiedź
C. try i raise
D. throw i handle
Poprawna odpowiedź. Słowa kluczowe 'try' i 'catch' są podstawą obsługi wyjątków w języku C++. Umożliwiają one przechwytywanie i obsługę błędów, które mogą wystąpić podczas wykonywania programu. Blok 'try' zawiera kod, który jest monitorowany pod kątem błędów, a blok 'catch' przechwytuje i przetwarza zgłoszony wyjątek, zapobiegając nieoczekiwanemu zakończeniu programu. Mechanizm ten jest kluczowy dla tworzenia niezawodnego i odpornego na błędy oprogramowania. Dzięki 'try' i 'catch' programista może implementować logikę naprawczą lub logować błędy, co zwiększa stabilność i bezpieczeństwo aplikacji.
Pytanie 21
W jakiej metodzie zarządzania projektami nacisk kładzie się na ograniczenie marnotrawstwa?
A. Waterfall
B. Scrum
C. Kanban
Twoja odpowiedź
D. Prototypowy
Poprawna odpowiedź. Kanban to metodologia zarządzania projektem, która koncentruje się na minimalizacji marnotrawstwa i optymalizacji przepływu pracy. Kluczowym elementem Kanbanu jest wizualizacja procesu za pomocą tablicy, na której znajdują się zadania w różnych fazach realizacji. Dzięki temu zespół może łatwo identyfikować wąskie gardła i eliminować zbędne procesy. Kanban promuje ciągłe doskonalenie (kaizen) i pozwala na dostosowywanie się do zmieniających się priorytetów bez konieczności reorganizacji całego projektu. Ta metodologia jest szeroko stosowana w branży IT, produkcji oraz w zespołach operacyjnych, które wymagają dużej elastyczności.
Pytanie 22
Jakie narzędzie można wykorzystać do tworzenia aplikacji mobilnych typu cross-platform w C#?
A. środowisko XCode
B. platformę Xamarin
Poprawna odpowiedź
C. środowisko Android Studio
D. platformę React Native
Twoja odpowiedź
Niepoprawna odpowiedź. XCode to zintegrowane środowisko programistyczne stworzone przez Apple, które służy głównie do tworzenia aplikacji na platformy iOS oraz macOS. Jego użycie ogranicza się do systemów operacyjnych Apple, co wyklucza możliwość tworzenia aplikacji cross-platform. W kontekście programowania w C#, XCode nie oferuje wsparcia ani funkcji, które umożliwiałyby rozwój aplikacji mobilnych na różne platformy. React Native jest frameworkiem stworzonym przez Facebook, który umożliwia tworzenie aplikacji mobilnych w JavaScript, a nie w C#. Choć React Native wspiera wiele platform, to jednak nie jest to technologia zgodna z C#, co czyni ją nieodpowiednią dla deweloperów preferujących ten język. Android Studio to z kolei oficjalne IDE dla systemu Android, oparte na Javie oraz Kotlinie, co również eliminuje możliwość wykorzystania C#. Tak więc, ani XCode, ani React Native, ani Android Studio nie są odpowiednie do tworzenia aplikacji mobilnych w języku C#, co czyni je niepoprawnymi odpowiedziami w kontekście tego pytania.
Pytanie 23
W frameworkach do budowy aplikacji mobilnych lub desktopowych znajduje zastosowanie wzorzec MVVM, oznaczający Model-View-ViewModel. Te podejście do programowania oznacza, że
A. interfejs użytkownika i logika aplikacji są umieszczone w jednym pliku
B. interfejs użytkownika oraz logika aplikacji są oddzielone
Twoja odpowiedź
C. w aplikacji obecny jest jedynie interfejs użytkownika
D. kontrolki i widoki interfejsu użytkownika są zintegrowane z logiką aplikacji
Poprawna odpowiedź. Wzorzec MVVM, czyli Model-View-ViewModel, jest jednym z kluczowych podejść w architekturze aplikacji, szczególnie w kontekście aplikacji mobilnych i desktopowych. Zakłada on wyraźne rozdzielenie logiki aplikacji (Model) od warstwy prezentacji (View), z pomocą komponentu ViewModel, który działa jako mediator. Dzięki temu programiści mogą łatwiej zarządzać kodem, testować poszczególne komponenty oraz wprowadzać zmiany w interfejsie użytkownika bez wpływu na logikę aplikacji. Przykładem zastosowania MVVM jest framework WPF (Windows Presentation Foundation), w którym dane są wiązane do kontrolek w interfejsie użytkownika, co pozwala na automatyczną aktualizację widoków w przypadku zmian w modelu. Standardy takie jak Data Binding w WPF oraz Reactive Programming w Xamarin i Avalonia, pokazują, jak MVVM ułatwia rozwój aplikacji poprzez separację odpowiedzialności, co prowadzi do większej przejrzystości kodu i łatwości w jego utrzymywaniu.
Pytanie 24
Z analizy złożoności obliczeniowej algorytmów sortowania dla dużych zbiorów danych (powyżej 100 elementów) wynika, że najefektywniejszą metodą jest algorytm sortowania:
sortowanie bąbelkowe
O(n²)
sortowanie przez wstawianie
O(n²)
sortowanie przez scalanie
O(n log n)
sortowanie przez zliczanie
O(n)
sortowanie kubełkowe
O(n²)
A. przez zliczanie
Poprawna odpowiedź
B. bąbelkowego
C. przez scalanie
Twoja odpowiedź
D. kubełkowego
Niepoprawna odpowiedź. Sortowanie bąbelkowe jest jednym z najwolniejszych algorytmów i rzadko jest używane w praktyce ze względu na złożoność O(n^2). Sortowanie kubełkowe może być szybkie, ale jego efektywność zależy od równomiernego rozkładu danych. Sortowanie przez scalanie jest bardziej uniwersalne, ale ma większą złożoność obliczeniową niż Counting Sort i może być mniej efektywne dla dużych zbiorów danych o ograniczonym zakresie.
Pytanie 25
Które słowo kluczowe w C++ służy do definiowania klasy nadrzędnej?
A.
class
Twoja odpowiedź
B.
base
C.
virtual
D.
public
Poprawna odpowiedź. Słowo kluczowe 'class' jest podstawowym elementem języka C++ i służy do deklarowania klasy. Definiuje ono strukturę zawierającą pola (zmienne) oraz metody (funkcje członkowskie), które określają zachowanie obiektu. 'Class' pozwala na enkapsulację danych, co oznacza ukrywanie implementacji wewnętrznej i udostępnianie interfejsu publicznego. Dzięki temu klasy stanowią podstawę programowania obiektowego, umożliwiając organizację kodu w logiczne jednostki. Przykładowa deklaracja klasy w C++ wygląda następująco: 'class Samochod { public: void Jedz(); private: int predkosc; };'.
Pytanie 26
Programista projektuje obsługę bufora drukowania dokumentów. Najnowsze zadanie drukowania jest ustawiane na końcu kolejki, a najstarsze jest przekazywane do wydruku. Strukturą danych najlepiej pasującą do problemu jest
A. LIFO
Twoja odpowiedź
B. FIFO
Poprawna odpowiedź
C. sterta
D. stos
Niepoprawna odpowiedź. W tym zadaniu łatwo pomylić pojęcia, bo kilka odpowiedzi brzmi podobnie technicznie, ale opisują zupełnie inne zachowanie. Stos działa według zasady LIFO, czyli Last In, First Out. Oznacza to, że element dodany jako ostatni jest zdejmowany jako pierwszy. Gdyby bufor drukowania działał jak stos, to najnowszy dokument byłby drukowany przed starszymi. W praktyce byłoby to dość kiepskie i niesprawiedliwe, bo starsze zadania mogłyby czekać bardzo długo, a nawet zostać ciągle spychane przez nowsze dokumenty. Z mojego doświadczenia uczniowie często kojarzą dodawanie na koniec z operacją push na stosie, ale zapominają, że kluczowe jest też to, skąd element jest później pobierany.
Sterta też nie jest właściwym wyborem dla zwykłego bufora drukowania. Heap służy głównie do sprawnego wybierania elementu o największym albo najmniejszym priorytecie, na przykład w kolejce priorytetowej. To ma sens, gdy zadania mają priorytety, terminy lub koszty, ale w treści pytania nie ma nic o priorytetach. Jest za to wyraźnie powiedziane, że najstarsze zadanie ma iść do wydruku. LIFO jako sama zasada również odpada, bo jest przeciwieństwem oczekiwanego zachowania. Poprawne myślenie jest takie: skoro pierwszy dokument, który trafił do bufora, ma być pierwszy obsłużony, to potrzebujemy kolejki FIFO. W profesjonalnych systemach taki wybór daje przewidywalność, prostszą diagnostykę i zachowanie zgodne z intuicją użytkownika.
Pytanie 27
W klasie o nazwie samochod przypisano atrybuty: marka, rocznik, parametry[]. Atrybuty te powinny zostać zdefiniowane jako
A. funkcje
B. metody
Twoja odpowiedź
C. interfejsy
D. pola
Poprawna odpowiedź
Niepoprawna odpowiedź. Wydaje mi się, że często początkujący mają problem z rozróżnieniem między polami, metodami a funkcjami, szczególnie że w niektórych językach te pojęcia się trochę mieszają. Funkcje i metody służą do wykonywania operacji – czyli do działania, modyfikowania czegoś, wyliczania, a nie do przechowywania danych. Jeśli próbujesz zrobić z ‘marka’ czy ‘rocznik’ funkcję lub metodę, tracisz całą strukturę danych, bo te wartości powinny być częścią obiektu – czyli być przechowywane jako pola. Interfejsy to zupełnie inna bajka – one opisują, co klasa powinna potrafić (czyli jakie metody ma mieć), ale same nie przechowują żadnych danych. To tak jakbyś powiedział, że samochód jest instrukcją obsługi, a nie fizycznym przedmiotem z konkretnymi atrybutami. Typowym błędem jest też mylenie pojęcia 'parametry' jako argumentów funkcji – tutaj chodzi o właściwości opisujące obiekt, więc nie pasuje to do funkcji ani metod. Dopiero po zrozumieniu, że pola są miejscem przechowywania stanu obiektu, można dobrze zaprojektować klasę oddającą realny obiekt z rzeczywistości. W praktyce, złe przypisanie atrybutów do funkcji czy interfejsów skutkuje chaosem w kodzie, trudnościami w utrzymaniu aplikacji oraz problemami z rozwojem projektu. Pola są po prostu fundamentem do budowania logiki obiektowej i każda próba ich zastąpienia innymi mechanizmami rodzi niepotrzebne komplikacje.
Pytanie 28Strzał
Jaką właściwość ma sieć synchroniczna?
A. Nie jest konieczna synchronizacja zegarów
B. Transmisja danych odbywa się w wyznaczonych interwałach czasowych
Twoja odpowiedź
C. Gwarantuje większą elastyczność w przesyłaniu danych
D. Przekazywanie danych zachodzi w sposób niesystematyczny
Poprawna odpowiedź. Sieć synchroniczna charakteryzuje się tym, że transmisja danych odbywa się w ustalonych odstępach czasu, co oznacza, że wszystkie urządzenia w sieci są zsynchronizowane do jednego zegara. Taki sposób przesyłania danych pozwala na precyzyjne określenie momentu, w którym dane są wysyłane i odbierane, co redukuje opóźnienia i błędy w komunikacji. Przykładem sieci synchronicznej jest system TDM (Time Division Multiplexing), który dzieli czas na różne sloty, przydzielając każdy slot konkretnemu użytkownikowi lub urządzeniu. Dzięki temu każdy uczestnik sieci ma gwarancję, że w swoim czasie dostanie dostęp do medium transmisyjnego. Standardy takie jak SONET (Synchronous Optical Network) i SDH (Synchronous Digital Hierarchy) są przykładami technologii, które wykorzystują synchronizację do efektywnego przesyłania danych na dużych odległościach. Takie podejście jest powszechnie stosowane w telekomunikacji, gdzie wysoka wydajność i niezawodność transmisji są kluczowe dla jakości usług.
Pytanie 29
Który z poniższych przykładów stanowi aplikację mobilną wykorzystującą bazę danych?
A. Aplikacja do robienia zdjęć
B. Aplikacja kalkulator
C. Aplikacja gromadząca listę kontaktów użytkownika
Twoja odpowiedź
D. Aplikacja wyświetlająca lokalny czas
Poprawna odpowiedź. Aplikacja przechowująca listę kontaktów użytkownika korzysta z bazy danych do przechowywania, odczytywania i zarządzania danymi. Tego typu aplikacje mobilne muszą efektywnie zarządzać dużą ilością danych i zapewniać ich szybki dostęp. Bazy danych, takie jak SQLite czy Firebase, są szeroko stosowane w aplikacjach mobilnych, umożliwiając przechowywanie kontaktów, wiadomości, notatek i innych informacji użytkownika. Dzięki bazom danych możliwe jest także synchronizowanie danych pomiędzy urządzeniami i przechowywanie ich w chmurze.
Pytanie 30
Ile kilobajtów (KB) znajduje się w jednym megabajcie (MB)?
A. 1000
B. 100
C. 10
D. 1024
Twoja odpowiedź
Poprawna odpowiedź. W informatyce jednostki pamięci są często używane do określenia pojemności danych. 1 megabajt (MB) równa się 1024 kilobajtom (KB) w systemie binarnym, który jest podstawowym systemem liczbowym używanym w komputerach. Wynika to z faktu, że komputery operują w systemie binarnym, gdzie wartości są potęgami liczby 2. Z definicji, 1 MB to 2 do potęgi 20 bajtów, co daje 1048576 bajtów. Kiedy dzielimy tę wartość przez 1024, otrzymujemy 1024 kilobajty. W praktyce, ta konwersja jest niezwykle istotna w kontekście zarządzania pamięcią oraz określania rozmiarów plików. Na przykład, przy pobieraniu plików z internetu, znając tę konwersję, można lepiej oszacować czas pobierania oraz zarządzanie przestrzenią dyskową. Warto również zauważyć, że niektóre systemy operacyjne i producenci sprzętu używają systemu dziesiętnego, w którym 1 MB to 1000 KB, co prowadzi do nieporozumień. Dlatego znajomość różnic między systemami binarnym i dziesiętnym jest kluczowa dla zrozumienia pojemności pamięci komputerowej i odpowiednich jednostek.
Pytanie 31
Podczas programowania kontrolki stepper przedstawionej na ilustracji w aplikacji mobilnej, należy zarządzać zmienną, która zawsze przechowuje jej bieżącą wartość. Jakie zdarzenie można wykorzystać do osiągnięcia tej funkcjonalności?
A. SizeChanged
B. Unfocused
C. ValueChanged
Twoja odpowiedź
D. DescendantAdded
Poprawna odpowiedź. Zdarzenie ValueChanged jest kluczowe w kontekście programowania kontrolek takich jak stepper w aplikacjach mobilnych. To zdarzenie jest wywoływane zawsze, gdy wartość kontrolki zostaje zmieniona przez użytkownika, co umożliwia natychmiastowe przetwarzanie tej zmiany i aktualizację interfejsu użytkownika lub innych powiązanych komponentów. W praktyce, użycie zdarzenia ValueChanged to dobry przykład reaktywnego programowania, gdzie aplikacja reaguje na akcje użytkownika w czasie rzeczywistym. Przy implementacji takiego zdarzenia należy zadbać o poprawne sprawdzanie zakresu wartości, aby uniknąć błędów logicznych. Warto również pamiętać o optymalizacji wydajności takiej obsługi, zwłaszcza w aplikacjach złożonych z wielu komponentów zależnych od wartości steppera. Praktyczne zastosowanie tego zdarzenia można znaleźć w aplikacjach e-commerce, gdzie steppery mogą być używane do wyboru ilości produktów w koszyku, a zmiana wartości natychmiast wpływa na obliczenie ceny całkowitej. Używanie zdarzeń takich jak ValueChanged jest zgodne z dobrymi praktykami projektowania interfejsów użytkownika, poprawiając ich responsywność i interaktywność.
Pytanie 32
Jedną z zasad standardu WCAG 2.0 jest
A. ograniczanie treści na stronie przez rezygnację z używania alternatywnych tekstów dla obrazów i filmów
B. stosowanie różnych palet kolorystycznych, w tym o wysokim kontraście
Twoja odpowiedź
C. używanie jednego, odpowiednio dużego rozmiaru czcionki
D. unikanie przedstawiania informacji w formie uproszczonej
Poprawna odpowiedź. Stosowanie różnych palet kolorystycznych, zwłaszcza takich z wysokim kontrastem, to naprawdę kluczowa sprawa w dostępności cyfrowej. Tak mówi standard WCAG 2.0, dokładniej zasada 1 – Postrzegalność. Chodzi tu głównie o kryterium sukcesu 1.4.3 (Kontrast – minimum), które wyraźnie określa, że tekst i treść graficzna muszą być czytelne dla osób z różnymi potrzebami, np. słabszym wzrokiem albo daltonizmem. Moim zdaniem warto sobie uświadomić, jak wielka to różnica. Przykładowo, jeśli tekst na stronie jest szary na białym tle, osoby starsze lub z wadami wzroku mogą po prostu nie być w stanie nic przeczytać. W praktyce, wysokokontrastowe kombinacje, np. biały tekst na czarnym tle lub na żółtym, bardzo poprawiają dostępność strony. Widać to choćby w trybach "high contrast" w systemach Windows – często osoby pracujące długo przy komputerze z tego korzystają, bo wzrok się mniej męczy. Branżowe dobre praktyki zalecają również nie polegać wyłącznie na kolorze podczas przekazywania informacji – przykładowo, jeśli błąd w formularzu jest oznaczony tylko na czerwono, osoba z daltonizmem tego nie zauważy. To wszystko pokazuje, że kolory i kontrast to nie tylko estetyka, ale klucz do równego dostępu. Z mojego doświadczenia, gdy projektuje się strony zgodnie z WCAG, dobrze jest testować różne ustawienia kontrastu albo korzystać z narzędzi jak Colour Contrast Analyser, żeby mieć pewność, że wszyscy użytkownicy skorzystają ze strony bez problemów.
Pytanie 33
Które z poniższych jest podstawowym rodzajem testów używanych w testowaniu jednostkowym?
A. Testy systemowe
B. Testy akceptacyjne
C. Testy jednostkowe
Twoja odpowiedź
D. Testy integracyjne
Poprawna odpowiedź. Testy jednostkowe są kluczowym elementem procesu testowania oprogramowania, szczególnie w kontekście metodologii programowania zwinnego. Polegają one na testowaniu pojedynczych najmniejszych części programu, takich jak funkcje czy metody, w izolacji od reszty systemu. Dzięki temu możemy szybko wykryć błędy i upewnić się, że dany fragment kodu działa zgodnie z oczekiwaniami. W praktyce, testy jednostkowe są często automatyzowane i stanowią podstawę dla procesu ciągłej integracji (CI). Przykładem zastosowania testów jednostkowych może być sprawdzenie, czy funkcja dodająca dwie liczby zwraca poprawny wynik dla różnych zestawów danych wejściowych. Dzięki testom jednostkowym programiści mogą z większą pewnością modyfikować i rozwijać kod, mając pewność, że nie wprowadzają nowych błędów. To właśnie testy jednostkowe pozwalają na szybkie wykrywanie regresji i są fundamentem dla bardziej zaawansowanych form testowania, takich jak testy integracyjne czy systemowe. Dbanie o dobrze zdefiniowany zestaw testów jednostkowych jest uznawane za dobrą praktykę w branży IT i podnosi jakość oprogramowania.
Pytanie 34
Technika konstruowania algorytmu polegająca na rozbiciu na dwa lub więcej mniejszych podproblemów, aż do momentu, gdy ich części będą wystarczająco proste do bezpośredniego rozwiązania, nosi nazwę:
A. najkrótszej trasy
B. dziel i zwyciężaj
Twoja odpowiedź
C. heurystycznej
D. komiwojażera
Poprawna odpowiedź. Technika „dziel i zwyciężaj” (ang. divide and conquer) to jedno z tych podejść, które moim zdaniem warto naprawdę dobrze rozumieć, bo spotyka się je praktycznie wszędzie w informatyce. Chodzi tutaj o rozbijanie dużego problemu na mniejsze, bardziej strawne kawałki, które rozwiązujemy niezależnie, a potem składamy wyniki w całość. To bardzo eleganckie, bo pozwala np. mocno uprościć złożone zadania, a przy okazji często optymalizuje czas działania algorytmu. Przykładem mogą być sortowanie szybkie (quicksort) czy sortowanie przez scalanie (merge sort). W praktyce branżowej, kiedy pracuje się nad dużymi systemami albo algorytmami operującymi na wielkich zbiorach danych, taki sposób myślenia bardzo się przydaje, bo pozwala łatwo podzielić pracę nawet między kilku programistów. Standardy branżowe, zwłaszcza w kontekście rozwiązań algorytmicznych czy projektowania systemów, promują właśnie takie modularne podejście. Sam kiedyś przekonałem się, że dużo łatwiej jest testować i utrzymywać kod, kiedy trzyma się tej zasady. Fajnie wiedzieć, że często to właśnie „dziel i zwyciężaj” leży u podstaw wielu struktur danych, algorytmów wyszukiwania czy nawet analizy obrazu, nie tylko w typowym programowaniu. Warto pamiętać, że to nie tylko teoria – w codziennej pracy taki styl rozwiązywania problemów pozwala szybciej wychwytywać i naprawiać błędy, a to przecież kluczowe w projektach IT.
Pytanie 35
Jakie jest kluczowe działanie przy opracowywaniu zbiorów danych do rozwiązania problemu programistycznego?
A. Zmiana języka programowania na bardziej wydajny
B. Weryfikacja zbiorów danych przed ich zastosowaniem
C. Wybór odpowiednich struktur danych
Twoja odpowiedź
D. Realizacja algorytmu sortującego
Poprawna odpowiedź. Wybór właściwych struktur danych to mega ważny krok, kiedy projektujesz swoje zestawy danych. To, jaką strukturę wybierzesz, ma ogromny wpływ na to, jak szybko i efektywnie będą działać algorytmy. Każda struktura ma swoje plusy i minusy – na przykład listy pozwalają na elastyczne zarządzanie elementami, stosy i kolejki trzymają dane w określonej kolejności, a drzewa czy grafy są już do bardziej skomplikowanych problemów. Dobrze dobrane struktury mogą znacznie przyspieszyć działanie programu i zmniejszyć zużycie zasobów. Moim zdaniem, jeśli chcesz projektować efektywne algorytmy, musisz naprawdę dobrze rozumieć, jak różne struktury działają i umieć je dopasować do problemu, który chcesz rozwiązać.
Pytanie 36
Jakie znaczenie ma krajowa normalizacja dla produktów i usług?
A. Ogranicza liczbę dostępnych towarów
B. Usuwa konieczność przeprowadzania kontroli jakości
Twoja odpowiedź
C. Restrukcjonuje innowacje technologiczne
D. Gwarantuje lepszą zgodność oraz jakość
Poprawna odpowiedź
Niepoprawna odpowiedź. Wielu ludzi myśli, że normalizacja zmniejsza liczbę dostępnych produktów, ale to nie tak. W rzeczywistości standardy sprawiają, że pojawia się jeszcze więcej różnych produktów, które spełniają określone normy. A ten pomysł, że pozbywanie się kontroli jakości to coś dobrego, to chyba jakieś nieporozumienie – normalizacja wcale nie zastępuje kontroli jakości, ona ją raczej wspiera. I nie ma co mówić, że innowacji technologicznych jest mniej przez normalizację – wręcz przeciwnie, standardy dają solidny podstawy do tego, żeby rozwijać nowe technologie i produkty, które odpowiadają potrzebom rynku.
Pytanie 37
Z podanej definicji pola licznik można wywnioskować, iż
classMojaKlasa{privatestaticintlicznik;...
A. pole nie może być zmieniane w kodzie klasy
B. bieżąca wartość pola jest wspólna dla wszystkich instancji klasy i nie może być zmieniana
Twoja odpowiedź
C. pole jest związane z określoną instancją klasy i jego wartość jest unikalna tylko dla tej instancji
D. bieżąca wartość pola jest wspólna dla wszystkich instancji klasy
Poprawna odpowiedź
Niepoprawna odpowiedź. Warto się chwilę zatrzymać i przeanalizować, skąd biorą się błędne przekonania dotyczące pól statycznych. Bardzo częstym nieporozumieniem jest utożsamianie słowa static z czymś „niezmiennym” albo uniemożliwiającym modyfikacje. Tymczasem static oznacza tyle, że pole nie jest związane z pojedynczym obiektem, tylko z całą klasą – czyli wszystkie obiekty tej klasy dzielą jedną, wspólną wartość licznik. To nie jest tak, że static czyni pole stałym – żeby pole było niezmienne, potrzeba słowa kluczowego final (w Javie), a tutaj go ewidentnie nie ma. Często osoby początkujące mylą static z final i stąd pojawia się przekonanie, że pole nie może być modyfikowane – co nie jest prawdą. Równie błędne jest zakładanie, że każde pole, które nie jest static, jest automatycznie unikalne per instancja. Gdybyśmy usunęli static z definicji licznik, wtedy rzeczywiście każda instancja MojaKlasa miałaby swoją własną wersję tej zmiennej, ale w tym przypadku wszystkie obiekty współdzielą tę samą wartość. Jeszcze inny błąd to przekonanie, że pole prywatne (private) nie może być zmieniane w kodzie klasy – w rzeczywistości private ogranicza dostęp do pola tylko do wnętrza klasy, ale metody tej klasy mają pełne prawo je modyfikować. Tak więc, patrząc z perspektywy dobrych praktyk programistycznych i samej składni, static to po prostu cecha, która decyduje o zakresie współdzielenia pola pomiędzy instancjami, a nie o jego niezmienności czy widoczności na zewnątrz. Moim zdaniem kluczowe jest wyciągnięcie z tego wniosku, że static to współdzielenie, a nie blokada zmian – i na tym polega istota poprawnej odpowiedzi w tym pytaniu.
Pytanie 38
1 terabajt (TB) to ile gigabajtów (GB)?
A. 1000
Twoja odpowiedź
B. 1024
Poprawna odpowiedź
C. 2048
D. 512
Niepoprawna odpowiedź. Odpowiedzi 1000, 2048 i 512 są błędne z różnych powodów. Zaczynając od 1000 – często spotykana w reklamach, zwłaszcza w kontekście dysków twardych, odnosi się do systemu dziesiętnego, gdzie 1 TB to 1 000 GB. Ale w informatyce to tak nie działa, bo 1 TB to 1024 GB, co może nieco mylić. Odpowiedź 2048 to też nie to, bo tu mamy do czynienia z pomyleniem jednostek – 2048 wynika z 2^11 i nie pasuje do terabajtów i gigabajtów. Na koniec, 512, to w ogóle nie gra, bo 512 MB to tylko 0,5 GB, co w porównaniu do 1 TB jest po prostu za małe. Dlatego warto ogarnąć te różnice między systemami binarnym i dziesiętnym, żeby dobrze wiedzieć, jak przeliczać jednostki pamięci.
Pytanie 39
Jakie z wymienionych działań jest fundamentalne w modelu kaskadowym?
A. Równoległe prowadzenie wielu etapów projektu
B. Zakończenie jednej fazy przed rozpoczęciem następnej
Twoja odpowiedź
C. Przeprowadzanie testów systemu po zakończeniu każdej fazy
D. Iteracyjne wprowadzanie modyfikacji na każdym poziomie
Poprawna odpowiedź. Kończenie jednej fazy przed rozpoczęciem kolejnej to kluczowa cecha modelu kaskadowego (Waterfall). W tym podejściu projekt jest realizowany etapami – analiza, projektowanie, implementacja, testowanie i wdrożenie – bez możliwości powrotu do poprzednich faz. Dzięki temu model Waterfall jest przejrzysty i łatwy do zarządzania, szczególnie w projektach o stabilnych wymaganiach. Jednak jego ograniczeniem jest brak elastyczności, co może prowadzić do problemów, jeśli wymagania zmienią się w trakcie trwania projektu.
Pytanie 40
Które z podejść do tworzenia aplikacji najlepiej uwzględnia przyszłe zmiany w funkcjonalności?
A. Zastosowanie modularnej architektury aplikacji
Poprawna odpowiedź
B. Skupienie się tylko na estetce aplikacji
C. Tworzenie bez wcześniejszej specyfikacji technicznej
Twoja odpowiedź
D. Pisanie kodu bez jakiejkolwiek dokumentacji
Niepoprawna odpowiedź. Projektowanie bez wcześniejszej specyfikacji technicznej prowadzi do chaosu i zwiększa ryzyko błędów na późniejszych etapach rozwoju. Pisanie kodu bez dokumentacji utrudnia jego późniejsze utrzymanie i sprawia, że inne osoby w zespole mogą mieć trudności z rozumieniem funkcjonalności. Skupienie się wyłącznie na wyglądzie aplikacji pomija kluczowe aspekty jej funkcjonalności i nie pozwala na dostosowanie systemu do zmieniających się potrzeb użytkowników.