Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 00:33
Zakończenie: 29 września 2026 00:51
Egzamin zdany!
Wynik: 33/40 punktów (82,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 68% podejść do kwalifikacji INF.04.
Porównanie z 23418 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprawa! Poprzednio 72,5%, teraz 82,5% (+10,0 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Która z metod zarządzania projektem jest oparta na przyrostach realizowanych w sposób iteracyjny?
A. Model spiralny
B. Model wodospadowy (waterfall)Twoja odpowiedź
C. Metodyki zwinne (Agile)Poprawna odpowiedź
D. Model prototypowy
Niepoprawna odpowiedź. Model kaskadowy, znany też jako waterfall, jest trochę inny. Działa sekwencyjnie, więc każda faza projektu musi się skończyć, zanim zaczniemy następną – nie ma tu miejsca na iteracje. Z kolei model prototypowy polega na tworzeniu próbnych wersji aplikacji, ale też nie skupia się na iteracyjnym dostarczaniu funkcjonalności. A model spiralny łączy w sobie aspekty prototypowania i podejścia kaskadowego, przy czym iteracje są długie i bardziej cykliczne, a nie krótkie i dynamiczne, jak w Agile.
Pytanie 2
Jakie są korzyści z wykorzystania struktur danych typu mapa (np. HashMap w Javie) w kontekście tworzenia zbiorów danych?
A. Bo pozwalają na sortowanie danych bez dodatkowych działań
B. Gdyż nie potrzebują znajomości wielkości danych przed kompilacją
C. Z powodu szybkiego uzyskiwania dostępu do elementów przy użyciu kluczaTwoja odpowiedź
D. Ponieważ struktury danych typu mapa zajmują mniej pamięci niż tablice
Poprawna odpowiedź. Mapa, na przykład HashMap w Javie, to taka fajna struktura, która trzyma pary klucz-wartość. Dzięki temu szybko możemy znaleźć dane, korzystając z unikalnego klucza. HashMap jest super, bo pozwala nam na błyskawiczne dodawanie, usuwanie i wyszukiwanie elementów w czasie O(1). To naprawdę przydaje się, gdy pracujemy z dużymi zbiorami danych. Używamy jej często w aplikacjach wymagających szybkiego dostępu do informacji, jak różne bazy danych czy strony internetowe. No i jeszcze jej elastyczność – można ją łatwo dostosować do zmieniających się zestawów danych, co jest dużym plusem.
Pytanie 3
Jakie znaczenie ma polimorfizm w programowaniu obiektowym?
A. Pozwala na tworzenie obiektów z wielu różnych klas równocześnie
B. Ogranicza dostęp do atrybutów klasy
C. Dzieli program na klasy oraz obiekty
D. Umożliwia jednej metodzie działać w różnorodny sposób w zależności od klasy, do której należyTwoja odpowiedź
Poprawna odpowiedź. Polimorfizm to zdolność obiektów do używania tej samej metody lub interfejsu, ale z różnymi implementacjami, w zależności od klasy obiektu. Dzięki polimorfizmowi można wywołać metodę `obiekt.wyswietl()`, która zachowuje się inaczej w klasie `Samochod` i inaczej w klasie `Motocykl`, mimo że nazwa metody pozostaje taka sama. Polimorfizm ułatwia rozbudowę aplikacji, ponieważ nowe klasy mogą być dodawane bez modyfikacji istniejącego kodu, co zwiększa elastyczność i rozszerzalność programu. Jest to jedna z najważniejszych zasad programowania obiektowego, obok dziedziczenia i hermetyzacji.
Pytanie 4
Co to jest CSS Grid?
A. Format plików graficznych obsługiwany przez CSS3
B. Biblioteka komponentów wizualnych dla aplikacji webowych
C. Dwuwymiarowy system układu elementów na stronie opary na siatkachTwoja odpowiedź
D. Metoda optymalizacji plików CSS dla lepszej wydajności strony
Poprawna odpowiedź. CSS Grid to nowoczesny, dwuwymiarowy system układu elementów na stronie internetowej, który umożliwia projektantom i deweloperom łatwe i elastyczne tworzenie skomplikowanych układów. Dzięki CSS Grid możemy definiować zarówno kolumny, jak i wiersze, co pozwala na precyzyjne umieszczanie elementów w kontekście całego układu. Przykładem zastosowania CSS Grid może być stworzenie responsywnej galerii zdjęć, gdzie można łatwo zmieniać liczbę kolumn w zależności od szerokości ekranu. CSS Grid jest zgodny z najnowszymi standardami W3C i stał się kluczowym elementem w nowoczesnym web designie. Dzięki właściwościom takim jak grid-template-areas, grid-template-columns, czy grid-auto-rows, projektanci mogą w intuicyjny sposób organizować treści, co poprawia zarówno estetykę, jak i użyteczność stron. Ponadto, korzystanie z CSS Grid pozwala na zmniejszenie zależności od zewnętrznych bibliotek JavaScript do układania elementów, co podnosi wydajność i usprawnia proces tworzenia stron.
Pytanie 5
Zajmując się pracą w zespole oraz dbając o jego efektywne funkcjonowanie, nie powinniśmy
A. skupiać się jedynie na własnych korzyściachPoprawna odpowiedź
B. przyjmować odpowiedzialności za swoje decyzje
C. wspierać się nawzajem
D. sumiennie i w ustalonym terminie realizować swoje zadaniaTwoja odpowiedź
Niepoprawna odpowiedź. Przeanalizujmy to szerzej. Wspieranie się wzajemnie w zespole to wręcz podstawa nowoczesnych metod pracy – praktycznie wszystkie opracowania dotyczące efektywności zespołowej podkreślają, że bez wzajemnej pomocy żaden zespół nie osiągnie wysokiego poziomu działania. To nie jest tylko teoria; w praktyce nawet przy świetnych umiejętnościach technicznych, brak współpracy doprowadza do konfliktów i dublowania pracy. Z kolei sumienne i terminowe wykonywanie zadań to w zasadzie fundament profesjonalizmu. Dobre praktyki branżowe, chociażby w zarządzaniu projektami IT, wielokrotnie wskazują, że niedotrzymywanie terminów przez jednego członka zespołu rozkłada wysiłki całej grupy. Wielu początkujących błędnie zakłada, że liczy się tylko własna wydajność, ale efekty końcowe zależą od rzetelności wszystkich. Jeśli chodzi o przyjmowanie odpowiedzialności za własne decyzje, to również element dojrzałości zawodowej – w wielu firmach wręcz się tego wymaga, bo tylko wtedy można wyciągać konstruktywne wnioski i usprawniać procesy. Typowym błędem myślowym jest przekonanie, że wystarczy dobrze robić swoją część, a reszta nie ma znaczenia. Niestety takie podejście prowadzi do rozmycia odpowiedzialności i konfliktów przy podziale zadań. Zamiast tego branża preferuje model, gdzie każdy bierze odpowiedzialność za swoje działania i równocześnie myśli o całym zespole. Warto więc unikać pułapki myślenia tylko o indywidualnych potrzebach i pamiętać, że kluczem do sukcesu jest całościowe spojrzenie na pracę grupową.
Pytanie 6
Jaka jest złożoność obliczeniowa poniższego algorytmu?
for (inti = 0; i < n; i++) {
for (intj = 0; j < n; j++) {
for (intk = 0; k < n; k++) {
array[i][j][k] = i + j + k;
}
}
}
A. O(n)
B. O(n³)Twoja odpowiedź
C. O(n²)
D. O(n log n)
Poprawna odpowiedź. Złożoność obliczeniowa przedstawionego algorytmu wynosi O(n³), co wynika z trzech zagnieżdżonych pętli, z których każda iteruje po n elementach. W praktyce oznacza to, że liczba operacji, które algorytm wykonuje, rośnie proporcjonalnie do sześcianu liczby n. Przykładowo, jeśli mamy dwa wymiary, złożoność będzie O(n²), ale w tym przypadku mamy trzy wymiary (i, j, k), co podwyższa złożoność do O(n³). Takie sytuacje zdarzają się często w problemach związanych z przetwarzaniem danych w trzech wymiarach, takich jak grafika komputerowa czy analiza danych 3D. W branży, dobrze jest pamiętać, że złożoność O(n³) może być nieefektywna dla dużych n, dlatego warto analizować algorytmy pod kątem ich wydajności i stosować różne techniki optymalizacji, jak na przykład podział danych czy struktury danych zmniejszające złożoność. Warto również zrozumieć, że dla dużych wartości n, czas wykonania algorytmu może być zauważalnie dłuższy, co wpływa na ogólną efektywność systemu.
Pytanie 7
Co zostanie wypisane w konsoli po wykonaniu poniższego kodu JavaScript?
Poprawna odpowiedź. Wykonując podany kod JavaScript, otrzymujemy wynik 20 w konsoli. Dzieje się tak, ponieważ obiekt `a` jest przypisany do zmiennej `b`, co oznacza, że obie zmienne wskazują na ten sam obiekt w pamięci. Kiedy zmieniamy właściwość `value` obiektu za pomocą zmiennej `b`, zmiana ta wpływa również na obiekt `a`, ponieważ oba odwołują się do tej samej instancji obiektu. Wartości w JavaScript mogą być przekazywane przez referencję, co oznacza, że manipulując jedną referencją, wpływamy na obiekt, do którego ta referencja odnosi się. Przykład ten ilustruje, jak ważne jest zrozumienie różnicy między typami prymitywnymi (przekazywanymi przez wartość) a obiektami (przekazywanymi przez referencję). W praktyce, taka wiedza jest kluczowa przy pracy z obiektami w JavaScript, zwłaszcza w kontekście zarządzania stanem aplikacji, gdzie modyfikacje obiektów mogą mieć szeroki wpływ na cały system.
Pytanie 8
Jakie są różnice między typem łańcuchowym a typem znakowym?
A. Typ znakowy przechowuje pojedyncze znaki, a łańcuchowy ciągi znakówTwoja odpowiedź
B. Typ łańcuchowy przechowuje pojedyncze znaki, a znakowy długie ciągi znaków
C. Typ znakowy przechowuje dane logiczne, a łańcuchowy tekst
D. Typ łańcuchowy obsługuje liczby całkowite, a znakowy liczby zmiennoprzecinkowe
Poprawna odpowiedź. Typ znakowy (char) przechowuje pojedyncze znaki, natomiast typ łańcuchowy (string) przechowuje ciągi znaków. Różnica ta ma kluczowe znaczenie w programowaniu, ponieważ typ 'char' jest używany do operacji na pojedynczych literach, cyfrze lub symbolu, podczas gdy 'string' umożliwia przechowywanie i manipulowanie całymi wyrazami lub zdaniami. W wielu językach 'string' to bardziej złożona struktura danych, która zawiera tablicę znaków (array of characters), co pozwala na efektywną pracę z tekstem i budowanie interaktywnych aplikacji.
Pytanie 9
Jakie są różnice między konstruktorem a zwykłą metodą w klasie?
A. Konstruktor powinien zwracać jakąś wartość
B. Konstruktor można wywołać bez konieczności tworzenia obiektu
C. Konstruktor jest uruchamiany jedynie przez destruktor
D. Konstruktor zawsze nosi tę samą nazwę co klasa i nie zwraca wartościTwoja odpowiedź
Poprawna odpowiedź. Konstruktor różni się od zwykłych metod klasy tym, że nosi taką samą nazwę jak klasa i nie zwraca żadnej wartości, nawet `void`. Konstruktor jest wywoływany automatycznie podczas tworzenia obiektu i nie można go wywołać ręcznie jak zwykłą metodę. Jego zadaniem jest inicjalizacja pól obiektu i przygotowanie go do działania. Przykład w C++: `class Samochod { public: Samochod() { marka = "Ford"; } }`. W przeciwieństwie do innych metod konstruktor nie wymaga deklaracji typu zwracanego, co jest jedną z jego najbardziej charakterystycznych cech.
Pytanie 10
Co to jest CORS (Cross-Origin Resource Sharing)?
A. Protokół komunikacji między różnymi bazami danych
B. Metoda udostępniania API dla aplikacji mobilnych
C. Technika optymalizacji ładowania zasobów statycznych
D. Mechanizm bezpieczeństwa, który określa, które domeny mogą uzyskiwać dostęp do zasobów na serwerzeTwoja odpowiedź
Poprawna odpowiedź. CORS, czyli Cross-Origin Resource Sharing, to mechanizm bezpieczeństwa stosowany w aplikacjach internetowych, który reguluje, które zewnętrzne domeny mają prawo uzyskiwać dostęp do zasobów na serwerze. Jest to szczególnie istotne w kontekście aplikacji klienckich działających w przeglądarkach, gdzie zapytania do różnych źródeł (tzw. cross-origin requests) mogą prowadzić do problemów z bezpieczeństwem, takich jak ataki typu CSRF (Cross-Site Request Forgery) czy XSS (Cross-Site Scripting). Przykładowo, jeśli aplikacja internetowa hostowana na domenie A próbuje uzyskać dane z API na domenie B, serwer na domenie B może poprzez nagłówki CORS określić, czy i jakie żądania od domeny A będą honorowane. Przy odpowiedniej konfiguracji, serwer może zezwolić na dostęp tylko dla zaufanych źródeł, co zapobiega nieautoryzowanym operacjom. W praktyce, stosowanie CORS przyczynia się do stworzenia bezpieczniejszych aplikacji webowych, zgodnych z aktualnymi standardami bezpieczeństwa w sieci, takimi jak W3C i OWASP.
Pytanie 11
Która technologia służy do tworzenia responsywnych stron internetowych?
A. REST API
B. Media Queries w CSSTwoja odpowiedź
C. Local Storage
D. WebSockets
Poprawna odpowiedź. Media Queries w CSS to technika, która pozwala na tworzenie responsywnych stron internetowych poprzez dostosowywanie stylów do różnych rozmiarów ekranów i urządzeń. Dzięki zastosowaniu reguł media queries, projektanci mogą definiować, jak elementy na stronie mają się zachowywać w zależności od szerokości ekranu, orientacji urządzenia czy jego rozdzielczości. Na przykład, można ustawić większe marginesy na dużych ekranach desktopowych, a na mniejszych urządzeniach mobilnych zredukować je, aby lepiej wykorzystać ograniczoną przestrzeń. Stosując media queries, można również zmieniać rozmiary czcionek, układ kolumn czy widoczność niektórych elementów, co jest kluczowe dla optymalizacji użytkowania na różnych platformach. Jest to częścią podejścia mobile-first, które stało się standardem w nowoczesnym web designie. Warto również zaznaczyć, że korzystanie z media queries wspiera dostępność i użyteczność stron internetowych, co jest zgodne z dobrymi praktykami branżowymi.
Pytanie 12
Co to jest XSS (Cross-Site Scripting)?
A. Protokół komunikacyjny używany w aplikacjach internetowych
B. Framework do tworzenia responsywnych stron internetowych
C. Technika optymalizacji kodu JavaScript do zwiększenia wydajności strony
D. Luka bezpieczeństwa pozwalająca na wstrzyknięcie złośliwego kodu do stron przeglądanych przez innych użytkownikówTwoja odpowiedź
Poprawna odpowiedź. Cross-Site Scripting (XSS) to luka bezpieczeństwa, która umożliwia atakującym wstrzykiwanie złośliwego kodu JavaScript do stron internetowych, które są następnie przeglądane przez innych użytkowników. W wyniku tego ataku, złośliwy kod może być wykonany w kontekście przeglądarki ofiary, co może prowadzić do kradzieży sesji, danych osobowych, czy też przejęcia kontroli nad kontem użytkownika. Aby zapobiegać XSS, programiści powinni stosować techniki takie jak walidacja i oczyszczanie danych wejściowych, a także korzystanie z nagłówków HTTP, takich jak Content Security Policy (CSP). Przykładem może być sytuacja, gdy aplikacja webowa przyjmuje dane w formularzach bez odpowiedniego sprawdzenia, co pozwala na umieszczenie skryptu, który zyskuje dostęp do cookies użytkownika. Zrozumienie i zabezpieczenie się przed XSS jest kluczowe w kontekście budowania bezpiecznych aplikacji webowych, co jest zgodne z najlepszymi praktykami branżowymi.
Pytanie 13
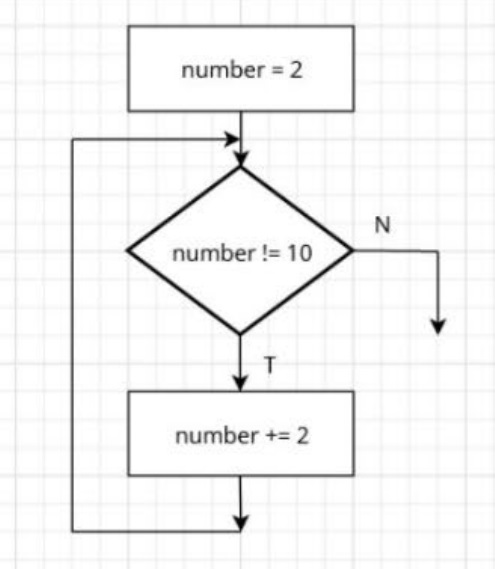
Algorytm zaprezentowany w zadaniu można zrealizować w języku Java wykorzystując instrukcję
A.
if
B.
while
Twoja odpowiedź
C.
try
D.
switch
Poprawna odpowiedź. Pętla while w języku Java jest idealna do implementacji algorytmów, które wymagają wielokrotnego wykonywania bloku kodu dopóki określony warunek logiczny pozostaje prawdziwy. W przedstawionym schemacie blokowym widzimy iteracyjny proces, który zaczyna się od przypisania wartości 2 do zmiennej number, a następnie kontynuuje dodawanie 2 do tej zmiennej tak długo, jak długo jej wartość nie osiągnie 10. Struktura ta jest typowym przykładem problemu, który najlepiej rozwiązać za pomocą pętli while. Wyrażenie warunkowe number != 10 jest sprawdzane przed każdą iteracją pętli, co umożliwia zakończenie pętli w momencie, gdy warunek przestaje być prawdziwy. To podejście jest zgodne z dobrymi praktykami programistycznymi, które zalecają minimalizowanie niepotrzebnych obliczeń i zwiększanie czytelności kodu. Pętle while są często stosowane w sytuacjach, gdy liczba iteracji nie jest z góry znana i zależy od dynamicznie zmieniających się warunków, co czyni je wszechstronnym narzędziem w wielu aplikacjach, od przetwarzania danych po kontrolę przepływu w symulacjach komputerowych. Praktyczna znajomość pętli pozwala na efektywne rozwiązywanie problemów w złożonych projektach informatycznych.
Pytanie 14
Przedstawiony na filmie kod napisany w języku C++ nie kompiluje się. Co należy zmienić w tym kodzie, aby proces kompilacji wykonał się bez błędów?
A. naprawić błąd w funkcji sprawdz, który polega na braku nawiasów {} w pętli for
B. poprawnie zapisać warunek w instrukcji if w linii 11, np. sprawdz(x)==trueTwoja odpowiedź
C. dodać deklarację funkcji sprawdz przed funkcją mainPoprawna odpowiedź
D. zadeklarować zmienną sprawdz przed jej wykorzystaniem w linii 11
Niepoprawna odpowiedź. Wielu początkujących programistów skupia się na szczegółach składniowych lub drobiazgach logicznych, kiedy pojawia się błąd kompilacji w C++. Jednak często przyczyną jest coś bardzo podstawowego, jak brak deklaracji funkcji przed jej użyciem. Jeśli chodzi o zapis warunku w instrukcji 'if', to kompilator nie zgłasza błędu, gdy używamy wyrażenia typu 'if (sprawdz(x))' – to całkowicie poprawna składnia, a dopisywanie '==true' jest redundantne i nie wnosi niczego nowego. Bardzo często widzę, że ktoś skupia się na tym, żeby warunek koniecznie porównywać do true, ale tak naprawdę to kwestia stylu, nie poprawności. Pozostawienie nawiasów klamrowych w pętli for jest oczywiście dobrą praktyką, ale ich brak nie zawsze generuje błąd kompilacji, jeśli pętla ma tylko jedną instrukcję. Kompilator C++ potrafi to rozpoznać i nie zgłasza błędu – sprowadza się to bardziej do czytelności i unikania błędów logicznych niż do samej poprawności kompilacji. Odpowiedź dotycząca deklarowania zmiennej 'sprawdz' to już nieporozumienie – 'sprawdz' to funkcja, a nie zmienna, więc nie deklarujemy jej w ten sposób. Ten błąd pokazuje, jak łatwo pomylić pojęcia w językach programowania, zwłaszcza jeśli dopiero zaczynamy przygodę z kodowaniem. Główna zasada, którą warto tu zapamiętać, to: każda funkcja używana przed jej zdefiniowaniem musi być zadeklarowana – to właśnie tego brakuje w typowym przykładzie z pytania. Bez deklaracji kompilator nie wie, jaką sygnaturę ma funkcja, a to skutkuje błędem już na poziomie kompilacji. Z mojego doświadczenia wynika, że takie drobne rzeczy potrafią skutecznie utrudnić życie, dlatego warto czytać komunikaty kompilatora i znać podstawowe zasady działania języka C++.
Pytanie 15
Który z wymienionych elementów stanowi przykład złożonego typu danych?
A.
char
B.
struct
Twoja odpowiedź
C.
bool
D.
int
Poprawna odpowiedź. Typ 'struct' w C++ to super sprawa, bo pozwala na trzymanie różnych danych pod jedną nazwą. Dzięki temu można łatwo zorganizować zmienne, które różnią się typami. Wyobraź sobie, że możesz stworzyć strukturę, która będzie reprezentować na przykład samochód z jego marką, rocznikiem i ceną. To naprawdę ułatwia pracę z danymi! Każde pole w strukturze może mieć inny typ, co czyni 'struct' bardzo uniwersalnym narzędziem do modelowania różnych obiektów, jak ludzie czy produkty. W zasadzie, to takie logiczne pudełko, do którego wrzucasz różne informacje i masz do nich szybki dostęp.
Pytanie 16
Jedną z dolegliwości, która pojawia się u programistów w wyniku długotrwałego korzystania z myszki komputerowej lub klawiatury, objawiającą się bólami, drętwieniem oraz zaburzeniami czucia w obszarze 1-3 palca dłoni jest
A. kifoza
B. zespół suchego oka
C. zespól cieśni kanału nadgarstkaTwoja odpowiedź
D. Dyskopatia
Poprawna odpowiedź. Zespół cieśni kanału nadgarstka to schorzenie, które powstaje w wyniku ucisku na nerw pośrodkowy w kanale nadgarstka. Jest to wąski tunel utworzony przez kości nadgarstka oraz więzadła, przez który przechodzą ścięgna oraz nerwy odpowiedzialne za czucie i ruch w dłoni. Objawy zespołu cieśni kanału nadgarstka obejmują bóle, drętwienie oraz zaburzenia czucia, szczególnie w obszarze pierwszych trzech palców ręki. Praca z myszą komputerową i klawiaturą przez długi czas, szczególnie w niewłaściwej ergonomicznej pozycji, może prowadzić do nadmiernego obciążenia i zapalenia tkanek otaczających nerw pośrodkowy. W praktyce, osoby cierpiące na to schorzenie często skarżą się na problemy z chwytaniem przedmiotów, a także na osłabienie siły uchwytu. W leczeniu zespołu cieśni kanału nadgarstka zaleca się m.in. unikanie czynników przyczynowych, stosowanie ortez, fizjoterapię oraz w niektórych przypadkach leczenie chirurgiczne. Należy również zwrócić uwagę na ergonomię stanowiska pracy, co może znacząco zredukować ryzyko wystąpienia tej dolegliwości. Zarządzanie czasem spędzanym przy komputerze oraz regularne przerwy są kluczowe w prewencji tego schorzenia.
Pytanie 17
Aby zdefiniować zmienną, która będzie działała jako licznik instancji danej klasy, należy wprowadzenie takiego zmiennej poprzedzić słowem kluczowym
A.
operator
B.
register
C.
static
Twoja odpowiedź
D.
virtual
Poprawna odpowiedź. Słowo kluczowe static jest absolutnie podstawą, jeśli chodzi o definiowanie zmiennych, które mają być współdzielone przez wszystkie instancje danej klasy. Gdy w klasie utworzysz zmienną statyczną, nie jest ona powiązana z żadnym konkretnym obiektem, tylko istnieje jedna taka zmienna dla całej klasy, niezależnie od liczby utworzonych obiektów. To niesamowicie przydatne, np. właśnie przy liczeniu instancji – wystarczy inkrementować taką zmienną w konstruktorze. W C++ czy Javie jest to standardowy sposób na śledzenie, ile obiektów danego typu zostało utworzonych. Z mojej perspektywy, korzystanie ze static to nie tylko wygoda, ale też sygnał dla innych programistów, że dana wartość jest globalna w kontekście klasy, a nie obiektu. Przykład praktyczny: jeżeli masz klasę Samochód i chcesz wiedzieć, ile samochodów zostało już utworzonych, to deklarujesz static int licznik; i za każdym razem, gdy konstruktor się odpala, robisz licznik++. Takie podejście jest bardzo czytelne i od razu wiadomo, o co chodzi. Warto też pamiętać, że static może być używany nie tylko do liczenia instancji, ale też do przechowywania różnych konfiguracji czy referencji do wspólnych zasobów. Zdecydowanie jest to jedna z lepszych praktyk, szczególnie kiedy program zaczyna rosnąć i zależy nam na porządku w kodzie.
Pytanie 18
Środowiskiem dedykowanym do tworzenia aplikacji mobilnych dla urządzeń Apple i wykorzystującym do tego celu różne języki programowania w tym Java i Objective C jest
A. NetBeans
B. Android Studio
C. React Native
D. XCodeTwoja odpowiedź
Poprawna odpowiedź. XCode to środowisko, które faktycznie jest fundamentem tworzenia aplikacji na urządzenia Apple, czyli iPhone’y, iPady czy nawet MacBooki. Apple od lat inwestuje w rozwój XCode i właśnie tam programiści mogą budować zarówno aplikacje natywne, jak i np. gry – i to z wykorzystaniem różnych języków, takich jak Objective-C i Swift. Co ciekawe, dawniej używano też Objective-C prawie wyłącznie, ale od kilku lat Apple promuje Swift, bo jest nowocześniejszy i dużo przyjemniej się w nim pisze. Moim zdaniem XCode to taki niezbędnik – bez niego praktycznie nie da się pisać porządnych aplikacji na iOS czy macOS. Samo środowisko jest zintegrowane ze wszystkimi narzędziami Apple: symulatorem urządzeń, Interface Builderem do projektowania graficznego oraz narzędziami do debugowania i testowania. Z mojego doświadczenia, jak ktoś zaczyna przygodę z aplikacjami mobilnymi dla Apple, to właśnie XCode jest pierwszym programem, z którym spędzi dużo czasu. I trochę ułatwia życie, bo automatycznie konfiguruje projekty pod standardy Apple, nie trzeba nic ręcznie ustawiać. To też świetne miejsce do nauki, bo dokumentacja jest wprost wbudowana w środowisko. Co ważne, XCode jest wymagany, żeby wrzucić gotową aplikację do App Store – tak jest po prostu zrobiony ekosystem Apple i żadna alternatywa nie daje tyle integracji i wsparcia dla natywnych rozwiązań Apple.
Pytanie 19
Co to jest REST API?
A. Framework do testowania API
B. Biblioteka JavaScript do komunikacji z bazami danych
C. Protokół sieciowy do transferu danych binarnych
D. Architektura API oparta o zasoby i standardowe operacje HTTPTwoja odpowiedź
Poprawna odpowiedź. REST API (Representational State Transfer Application Programming Interface) to architektura API, która koncentruje się na zasobach i wykorzystuje standardowe operacje HTTP, takie jak GET, POST, PUT i DELETE. Dzięki tej architekturze każdy zasób, na przykład użytkownik czy produkt, jest reprezentowany przez unikalny identyfikator URL, co ułatwia dostęp i manipulację danymi. REST API jest szeroko stosowane w aplikacjach webowych i mobilnych, ponieważ pozwala na łatwą integrację różnych systemów oraz umożliwia wykorzystanie technologii takich jak JSON i XML do wymiany danych. Przykładem praktycznego zastosowania REST API może być aplikacja do zarządzania zadaniami, w której użytkownicy mogą tworzyć, edytować i usuwać zadania za pomocą odpowiednich zapytań HTTP. Dobrą praktyką przy projektowaniu REST API jest stosowanie odpowiednich statusów HTTP, takich jak 200 (OK), 201 (Created) czy 404 (Not Found), co ułatwia komunikację między klientem a serwerem oraz zwiększa transparentność działania API. Dodatkowo, REST API jest zgodne z zasadą bezstanowości, co oznacza, że każdy nowy request zawiera wszystkie informacje potrzebne do jego przetworzenia.
Pytanie 20
Jakie jest podstawowe działanie w ochronie miejsca zdarzenia?
A. Zastosowanie sterylnych materiałów opatrunkowych
B. Zagwarantowanie stabilności ciała rannego
C. Zagwarantowanie odpowiedniego oświetlenia
D. Usunięcie niebezpiecznych przedmiotów z otoczeniaTwoja odpowiedź
Poprawna odpowiedź. Z mojego doświadczenia, usunięcie niebezpiecznych rzeczy z miejsca, gdzie doszło do wypadku, to naprawdę kluczowa sprawa. Dzięki temu zmniejszamy szanse na dodatkowe obrażenia i możemy lepiej pomóc poszkodowanemu, nie narażając siebie na ryzyko. Na przykład, warto odsunąć ostre narzędzia, wyłączyć działające maszyny czy podnieść ciężkie przedmioty, które mogłyby kogoś zranić. Takie działania są istotne w każdej sytuacji, czy to wypadek na drodze, czy w pracy.
Pytanie 21
Jakie znaczenie ma poziom dostępności AAA w WCAG 2.0?
A. Najnizszy poziom dostępności
B. Najwyższy poziom dostępnościTwoja odpowiedź
C. Średni standard dostępności
D. Dostosowanie tylko do użytkowników mobilnych
Poprawna odpowiedź. Poziom dostępności AAA w WCAG 2.0 oznacza najwyższy standard dostępności, który ma na celu zapewnienie, że treści internetowe są dostępne dla wszystkich użytkowników, w tym osób z różnymi rodzajami niepełnosprawności. WCAG, czyli Wytyczne dotyczące dostępności treści internetowych, są międzynarodowym standardem, który definiuje, jak tworzyć dostępne treści. Poziom AAA obejmuje wszystkie wytyczne z poziomów A i AA oraz dodatkowe wymagania, które są bardziej rygorystyczne. Przykładem może być konieczność zapewnienia alternatywnych opisów dla wszystkich mediów, w tym dla materiałów wideo i audio, a także użycie odpowiednich kontrastów kolorystycznych. W praktyce oznacza to, że strony internetowe muszą być projektowane z myślą o właściwej nawigacji, dostępnym oprogramowaniu czytającym oraz dostosowanych formatach tekstowych, które są łatwe do przetwarzania przez osoby z różnymi ograniczeniami. Wdrożenie poziomu AAA jest wyzwaniem, ale przyczynia się do bardziej inkluzywnego środowiska online.
Pytanie 22
Jakie jest główne zadanie ochrony danych osobowych?
A. Gwarantowanie anonimowości dla internautów
B. Zabezpieczenie danych osobowych przed nieautoryzowanym dostępem i ich wykorzystaniemTwoja odpowiedź
C. Udostępnianie danych osobowych w celach marketingowych
D. Utrudnianie działalności organom ścigania
Poprawna odpowiedź. Ochrona danych osobowych przed nieuprawnionym dostępem i wykorzystaniem to podstawowy cel ochrony danych osobowych. Zasady ochrony prywatności, takie jak RODO (GDPR), zapewniają użytkownikom prawo do kontroli nad swoimi danymi i decydowania, kto może je przetwarzać. Firmy i organizacje muszą wdrażać środki techniczne oraz organizacyjne, aby zabezpieczyć dane przed wyciekiem, kradzieżą i nadużyciami. Przestrzeganie tych zasad nie tylko chroni jednostki, ale również buduje zaufanie klientów do przedsiębiorstw.
Pytanie 23
W jaki sposób określa się wypadek związany z pracą?
A. Każde zdarzenie, które wymaga interwencji technicznej w miejscu zatrudnieniaTwoja odpowiedź
B. Nagłe zdarzenie związane z pracą, powodujące uraz lub śmierćPoprawna odpowiedź
C. Każde zdarzenie, które prowadzi do opóźnienia w wykonaniu obowiązków
D. Każdy incydent wynikający z działania osób trzecich
Niepoprawna odpowiedź. Zdarzenia, które powodują opóźnienia w realizacji zadań, nie są klasyfikowane jako wypadki przy pracy – mogą to być awarie lub błędy proceduralne, ale nie prowadzą do urazu pracownika. Zdarzenia wymagające pomocy technicznej mogą być awariami sprzętu, ale jeśli nie skutkują urazem, nie są uznawane za wypadki przy pracy. Incydenty spowodowane przez osoby trzecie mogą mieć wpływ na bezpieczeństwo pracy, ale nie są automatycznie klasyfikowane jako wypadki przy pracy – konieczne jest dokładne ustalenie związku z wykonywanymi obowiązkami zawodowymi.
Pytanie 24
Co to jest debouncing w JavaScript?
A. Mechanizm zarządzania pamięcią dla zmiennych globalnych
B. Proces optymalizacji kodu JavaScript podczas kompilacji
C. Metoda usuwania zduplikowanych zdarzeń w kodzie
D. Technika ograniczająca częstotliwość wywoływania funkcji poprzez opóźnienie jej wykonaniaTwoja odpowiedź
Poprawna odpowiedź. Debouncing to technika programistyczna stosowana w JavaScript, która ma na celu ograniczenie częstotliwości wywoływania funkcji poprzez wprowadzenie opóźnienia w jej wykonaniu. Zazwyczaj jest wykorzystywana w kontekście zdarzeń, takich jak przewijanie, zmiana rozmiaru okna czy wprowadzanie danych do formularzy. Przykładowo, przy użyciu debouncingu w funkcji, która wykonuje zapytanie do serwera podczas pisania w polu tekstowym, można ustawić opóźnienie, które uniemożliwi wielokrotne wywołanie funkcji przed upływem określonego czasu. Taki zabieg pozwala na zredukowanie liczby niepotrzebnych zapytań, co z kolei zmniejsza obciążenie serwera i poprawia wydajność aplikacji. W praktyce implementacja debouncingu często korzysta z techniki setTimeout, gdzie po każdym wywołaniu funkcji z resetowaniem timera czeka się na ostatnie wywołanie przed wykonaniem funkcji. Dobrym przykładem jest sytuacja, gdy użytkownik wpisuje tekst w polu wyszukiwania: zamiast wysyłać zapytanie za każdym razem, gdy zmienia się jego zawartość, można ustawić debouncing na 300 milisekund, co pozwala na wysłanie zapytania tylko po zakończeniu pisania, gdy użytkownik przestaje wprowadzać dane.
Pytanie 25
W obrębie klasy pracownik zdefiniowano następujące metody:
Którą z nich można, zgodnie z jej funkcją, rozszerzyć o element diagnostyczny o treści:
cout << "Obiekt został usunięty";
A.
~pracownik
Twoja odpowiedź
B.
operator==
C.
wypisz
D.
pracownik
Poprawna odpowiedź. Wybranie destruktora ~pracownik do umieszczenia komunikatu diagnostycznego o usunięciu obiektu jest jak najbardziej słuszne i zgodne z praktykami programowania obiektowego w C++. To właśnie destruktor odpowiada za wykonywanie wszelkich czynności „na pożegnanie” obiektu, czyli w momencie jego zwalniania z pamięci. Właśnie tu umieszcza się takie rzeczy jak logowanie faktu usunięcia, czyszczenie zasobów zewnętrznych czy zwalnianie pamięci dynamicznej. W praktyce, gdy zadeklarujemy cout << "Obiekt został usunięty"; w destruktorze, będziemy mieli jasny sygnał przy każdym końcu życia obiektu, co świetnie nadaje się do diagnostyki i szukania błędów w zarządzaniu pamięcią. Moim zdaniem każdy programista, nawet początkujący, powinien chwilę pobawić się takimi komunikatami, żeby lepiej zrozumieć, kiedy dokładnie destruktor jest wołany (np. przy wyjściu ze scope’u, delete, końcu programu itp.). To też dobry sposób, żeby wychwycić niechciane wycieki pamięci lub zrozumieć, dlaczego obiekt nie został jeszcze usunięty. Wzorce projektowe, takie jak RAII, wręcz opierają się na działaniu destruktorów. W branży często stosuje się podobne rozwiązania do debugowania problematycznych fragmentów kodu. Ogólnie rzecz biorąc, umieszczanie komunikatów w destruktorze jest praktycznym i polecanym sposobem na rozpoznanie cyklu życia obiektu – i to w każdej większej aplikacji C++.
Pytanie 26
Który z wymienionych typów stanowi przykład typu znakowego?
A.
boolean
B.
char
Twoja odpowiedź
C.
string
D.
float
Poprawna odpowiedź. Typ 'char' to przykład typu znakowego, który przechowuje pojedynczy znak (litera, cyfra, symbol). W językach takich jak C++, Java czy C, typ 'char' zajmuje jeden bajt pamięci i jest podstawą do obsługi operacji tekstowych oraz przetwarzania danych wejściowych. Typy znakowe są często wykorzystywane do manipulacji łańcuchami tekstowymi, przechowywania kodów ASCII i pracy z danymi wejściowymi. Znaki są podstawowym elementem budowy tekstów i mogą być łączone w tablice (ciągi znaków) lub przetwarzane indywidualnie.
Pytanie 27
W aplikacji mobilnej, aby określić warianty grafiki w zależności od wielkości ekranu, należy (uwaga: odpowiedzi wariantowe dla dwóch systemów - sugerować się systemem omawianym na zajęciach)
A. iOS: dodać do nazw sufiksy oznaczające rozdzielczość, np. 32ppi. Android: umieścić grafikę w odpowiednich katalogach: 32ppi, 64ppi, 96ppiTwoja odpowiedź
B. iOS: dodać do nazw plików sufiksy @2x, @3x. Android: umieścić grafikę w odpowiednich folderach drawable: -hdpi, -xhpi, xxhdpiPoprawna odpowiedź
C. iOS: dodać do nazw sufiksy #2x, #3x. Android: dodać do nazw sufiks rozdzielczości: -32x32, -64x64, -96x96
D. iOS: utworzyć katalogi hdpi, lhpi, xhpi i dodać do nich grafiki. Android: utworzyć katalogi 32x32, 64x64, 96x96 i dodać do nich grafiki
Niepoprawna odpowiedź. Lepiej nie używać oznaczeń w stylu 32ppi czy 64ppi, bo to nie pasuje do żadnej z tych platform. To bardziej pasuje do druku, a nie aplikacji mobilnych. Foldery 32x32 czy 64x64 też nie mają sensu w kontekście Androida czy iOS. Jak stworzysz foldery o nazwach lhpi czy 32x32 to może być problem z wyświetlaniem grafiki na różnych urządzeniach. Z mojego doświadczenia, lepiej trzymać się ustalonych standardów, żeby uniknąć błędów.
Pytanie 28
Jakie działanie wykonuje polecenie "git pull"?
A. Eliminuje plik z repozytorium
B. Zachowuje zmiany w lokalnym repozytorium
C. Pobiera zmiany z zdalnego repozytorium i scala je z lokalnymTwoja odpowiedź
D. Tworzy nową gałąź w repozytorium
Poprawna odpowiedź. Polecenie 'git pull' pobiera najnowsze zmiany ze zdalnego repozytorium i scala je z lokalnym repozytorium. Jest to jedno z podstawowych poleceń w Git, pozwalające na synchronizację lokalnej kopii projektu z wersją przechowywaną w chmurze lub na serwerze. Dzięki 'git pull' programiści mogą na bieżąco aktualizować swoje repozytoria i unikać konfliktów, które mogłyby wyniknąć z pracy na nieaktualnej wersji kodu. Proces ten automatycznie łączy pobrane zmiany, co eliminuje konieczność ręcznego kopiowania plików lub komend.
Pytanie 29
Co to jest Event Loop w JavaScript?
A. Mechanizm pozwalający na asynchroniczne wykonywanie kodu mimo jednowątkowej natury JavaScriptTwoja odpowiedź
B. Technika obsługi zdarzeń w aplikacjach React
C. Protokół komunikacji między różnymi częściami aplikacji webowej
D. System zarządzania cyklem życia komponentów w Angular
Poprawna odpowiedź. Event Loop w JavaScript to kluczowy mechanizm, który umożliwia asynchroniczne wykonywanie kodu mimo jednowątkowej natury tego języka. JavaScript działa w jednym wątku, co oznacza, że może wykonywać jedną operację w danym czasie. Event Loop pozwala jednak na zarządzanie operacjami asynchronicznymi, takimi jak wywołania API czy operacje na danych, które mogą trwać dłużej. Dzięki temu, zamiast czekać na zakończenie tych operacji, kod może kontynuować wykonywanie innych zadań. W praktyce, gdy operacja asynchroniczna kończy się, jej wynik jest umieszczany w kolejce do przetworzenia, a Event Loop zajmuje się ich przetwarzaniem, kiedy główny wątek jest dostępny. To podejście sprawia, że aplikacje webowe są bardziej responsywne, ponieważ nie blokują interfejsu użytkownika podczas oczekiwania na zakończenie długoterminowych zadań. Dobrą praktyką jest zrozumienie działania Event Loop, ponieważ pozwala to na efektywniejsze zarządzanie asynchronicznością w kodzie JavaScript, co jest niezwykle istotne w przypadku rozwijania nowoczesnych aplikacji webowych.
Pytanie 30
Jaką rolę odgrywa interpreter w kontekście programowania?
A. Zoptymalizowuje wydajność aplikacji w środowisku produkcyjnym
B. Generuje plik wykonywalny dla systemu operacyjnego
C. Łączy kod źródłowy z zewnętrznymi bibliotekami
D. Przekłada kod źródłowy na język maszynowy w trakcie działania programuTwoja odpowiedź
Poprawna odpowiedź. Interpreter tłumaczy kod źródłowy na język maszynowy instrukcja po instrukcji, co oznacza, że każda linia kodu jest analizowana i wykonywana na bieżąco. Dzięki temu programy interpretowane, takie jak te w Pythonie, Ruby czy JavaScript, mogą być szybko testowane i uruchamiane bez konieczności wcześniejszej kompilacji. Interpretacja pozwala na elastyczność w procesie rozwoju, ponieważ zmiany w kodzie są widoczne natychmiast po zapisaniu pliku. To czyni interpreter idealnym narzędziem do prototypowania i budowania aplikacji w dynamicznych środowiskach.
Pytanie 31
Który z podanych algorytmów operujących na jednowymiarowej tablicy posiada złożoność obliczeniową O(n²)?
A. Wyszukiwanie binarne
B. Wypisanie elementów
C. Sortowanie szybkie
D. Sortowanie bąbelkoweTwoja odpowiedź
Poprawna odpowiedź. Sortowanie bąbelkowe, znane również jako bubble sort, to prosty algorytm sortowania, który działa na zasadzie wielokrotnego przechodzenia przez tablicę i porównywania sąsiadujących ze sobą elementów. Algorytm ten ma złożoność obliczeniową O(n^2), co oznacza, że w najgorszym przypadku liczba operacji porównania wzrasta kwadratowo wraz ze wzrostem liczby elementów w tablicy. Przykładowo, dla tablicy o 5 elementach algorytm może wykonać do 10 porównań. W praktyce sortowanie bąbelkowe jest rzadko stosowane w dużych zbiorach danych ze względu na swoją niską efektywność, jednak jest to dobry przykład do nauki podstaw algorytmów sortujących. Standardy algorytmów sortujących, takie jak te zawarte w podręcznikach algorytmiki, często używają sortowania bąbelkowego jako przykładu do omówienia prostych koncepcji związanych z sortowaniem. Warto zauważyć, że chociaż algorytm ten jest prosty do zrozumienia, jego złożoność czasowa sprawia, że nie jest on praktyczny do stosowania w produkcyjnych rozwiązaniach, gdyż bardziej optymalne algorytmy, jak sortowanie szybkie czy sortowanie przez scalanie, osiągają złożoność O(n log n).
Pytanie 32
Jakie są główne różnice między środowiskiem RAD (Rapid Application Development) a klasycznymi IDE w odniesieniu do aplikacji mobilnych?
A. RAD nie obsługuje interfejsu użytkownika
B. RAD pozwala na szybsze budowanie aplikacji dzięki narzędziom do wizualnego designu i automatycznego generowania koduTwoja odpowiedź
C. RAD działa tylko na urządzeniach z systemem iOS
D. RAD koncentruje się wyłącznie na procesie debugowania aplikacji
Poprawna odpowiedź. RAD (Rapid Application Development) umożliwia szybsze tworzenie aplikacji mobilnych dzięki narzędziom do wizualnego projektowania i automatycznego generowania kodu. RAD koncentruje się na iteracyjnym podejściu do rozwoju oprogramowania, w którym prototypy są budowane i testowane w krótkich cyklach, co pozwala na szybkie dostosowywanie aplikacji do zmieniających się wymagań użytkowników. W kontekście aplikacji mobilnych, RAD skraca czas tworzenia poprzez graficzne narzędzia do budowy interfejsów, gotowe komponenty oraz integrację z backendem. Frameworki RAD, takie jak OutSystems, Mendix czy Flutter, pozwalają na szybkie wdrażanie i modyfikację aplikacji mobilnych, co znacząco zwiększa efektywność programistów.
Pytanie 33
Które narzędzie najlepiej nadaje się do wyszukiwania błędów w czasie wykonywania programu?
A. DebuggerTwoja odpowiedź
B. Kompilator
C. Interpreter
D. Linker
Poprawna odpowiedź. Debugger jest narzędziem przeznaczonym właśnie do wyszukiwania błędów pojawiających się podczas działania programu, czyli w czasie wykonywania. Pozwala uruchomić aplikację krok po kroku, zatrzymać ją na breakpointach, podejrzeć wartości zmiennych, sprawdzić stos wywołań, warunki logiczne oraz moment, w którym program zaczyna zachowywać się inaczej niż zakładaliśmy. W praktyce używa się go np. gdy aplikacja kompiluje się bez problemu, ale po kliknięciu przycisku zwraca zły wynik, wyrzuca wyjątek albo wpada w nieskończoną pętlę. Moim zdaniem to jedno z najważniejszych narzędzi programisty, bo samo czytanie kodu często nie wystarcza. Dobre praktyki branżowe mówią, żeby błąd najpierw odtworzyć, potem zawęzić miejsce występowania problemu, a dopiero później poprawiać kod. Debugger świetnie w tym pomaga. W środowiskach takich jak Visual Studio, IntelliJ IDEA, Eclipse czy VS Code debugowanie jest normalną częścią pracy, obok testów jednostkowych, logowania i analizy stack trace. Warto też pamiętać, że debugger nie zastępuje testów, ale bardzo dobrze uzupełnia proces kontroli jakości oprogramowania.
Pytanie 34
Jakie środowisko developerskie służy do tworzenia aplikacji na platformę iOS?
A. Studio Androida
B. Visual Studio Code
C. Eclipse
D. XCodeTwoja odpowiedź
Poprawna odpowiedź. XCode to oficjalne środowisko programistyczne (IDE) firmy Apple, które jest wykorzystywane do tworzenia aplikacji na systemy iOS, macOS, watchOS i tvOS. XCode oferuje pełne wsparcie dla języków Swift i Objective-C oraz narzędzia do projektowania interfejsów użytkownika (Storyboard), debugowania aplikacji, testowania wydajności i optymalizacji kodu. XCode posiada także symulatory urządzeń Apple, co umożliwia testowanie aplikacji na różnych modelach iPhone’ów, iPadów oraz Apple Watch. XCode jest niezbędnym narzędziem dla deweloperów tworzących aplikacje na ekosystem Apple i pozwala na łatwą publikację aplikacji w App Store.
Pytanie 35
Który z wymienionych frameworków jest charakterystyczny dla aplikacji komputerowych pisanych w C#?
A. React
B. WPF (Windows Presentation Foundation)Twoja odpowiedź
C. Spring
D. Qt
Poprawna odpowiedź. WPF (Windows Presentation Foundation) to framework firmy Microsoft, który jest powszechnie wykorzystywany do tworzenia aplikacji desktopowych w języku C#. WPF pozwala na projektowanie zaawansowanych interfejsów użytkownika (UI) z wykorzystaniem XAML (Extensible Application Markup Language), co umożliwia oddzielenie logiki aplikacji od warstwy prezentacyjnej. WPF wspiera grafikę wektorową, animacje oraz różne efekty wizualne, co czyni go idealnym narzędziem do budowy nowoczesnych, estetycznych aplikacji dla systemu Windows. Integracja z .NET i Visual Studio umożliwia szybkie tworzenie aplikacji oraz korzystanie z bogatych bibliotek i gotowych komponentów UI. WPF jest szczególnie ceniony za elastyczność, obsługę danych i możliwość tworzenia aplikacji responsywnych.
Pytanie 36
Co to jest Docker?
A. System zarządzania bazami danych
B. Platforma do tworzenia, wdrażania i uruchamiania aplikacji w kontenerachTwoja odpowiedź
C. Narzędzie do automatyzacji procesu tworzenia dokumentacji
D. Framework JavaScript do tworzenia aplikacji mobilnych
Poprawna odpowiedź. Docker to platforma, która umożliwia tworzenie, wdrażanie i uruchamianie aplikacji w kontenerach. Kontenery to lekkie, przenośne jednostki, które zawierają wszystko, co potrzebne do uruchomienia aplikacji, w tym kod źródłowy, biblioteki i zależności. Dzięki Dockerowi programiści mogą łatwo tworzyć środowiska, które są zgodne z produkcją, co zmniejsza ryzyko błędów związanych z różnicami między tymi środowiskami. Przykładowo, jeśli tworzysz aplikację webową, możesz użyć Dockera do uruchomienia bazy danych w kontenerze, co pozwala na łatwe zarządzanie jej wersjami oraz konfiguracją. Docker staje się standardem w wielu firmach i projektach open source, ponieważ umożliwia szybsze wdrażanie aplikacji oraz automatyzację wielu procesów. Dzięki konteneryzacji można również łatwo skalować aplikacje, co jest niezwykle ważne w przypadku rosnącego ruchu użytkowników.
Pytanie 37
Tworząc aplikację opartą na obiektach, należy założyć, że program będzie zarządzany przez
A. moduły zawierające funkcje oraz zmienne globalne
B. definicję warunków końcowego rozwiązania
C. pętlę dyspozytora, która w zależności od zdarzenia wywoła właściwą funkcjęTwoja odpowiedź
D. zbiór instancji klas współpracujących ze sobąPoprawna odpowiedź
Niepoprawna odpowiedź. Często spotykam się z przekonaniem, że budowanie programów opartych na modułach z funkcjami i zmiennymi globalnymi jest wystarczające, zwłaszcza w mniejszych projektach. Jednak takie podejście prowadzi do dużej trudności w utrzymaniu i rozwoju aplikacji, szczególnie gdy program zaczyna rosnąć. Globalne zmienne powodują tzw. efekt uboczny – nie wiadomo gdzie i kiedy ich stan się zmienia, co niesamowicie utrudnia debugowanie i wprowadzanie nowych funkcjonalności. Pętle dyspozytora i reakcja na zdarzenia to raczej domena programowania proceduralnego lub prostych systemów sterowania, ale nie oddają istoty programowania obiektowego – tu nie chodzi o centralne zarządzanie funkcjami, tylko o to, żeby obiekty same wiedziały, jak mają na siebie reagować. Zdarza mi się widzieć takie podejście w starszych aplikacjach, gdzie cała logika mieści się w jednym dużym pliku z wielką pętlą i masą instrukcji warunkowych – naprawdę trudno takie rozwiązania rozwijać bez wpadania w spaghetti code. Co do definicji warunków końcowych jako sposobu zarządzania programem, to jest to raczej element algorytmiki, a nie struktury aplikacji obiektowej. Moim zdaniem takie myślenie wynika z braku zrozumienia, jak ważna jest modularność i enkapsulacja w programowaniu obiektowym. Branżowe standardy (np. SOLID, DRY) podkreślają, że kod dobrze podzielony na obiekty i odpowiedzialności minimalizuje błędy i pozwala łatwo rozbudowywać aplikacje. Wspólna praca wielu instancji klas, każdej z jasno zdefiniowaną rolą, pozwala na tworzenie dużo bardziej elastycznych i odpornych na zmiany systemów. Jeśli ktoś nadal opiera projekt na globalnych zmiennych czy centralnej pętli, to prędzej czy później napotka na ścianę komplikacji, której można łatwo uniknąć, stosując paradygmat obiektowy.
Pytanie 38
Co to jest WebSockets?
A. Biblioteka JavaScript do manipulacji danymi JSON
B. Format zapisu danych w bazach NoSQL
C. Metoda zabezpieczania połączeń HTTP
D. Protokół komunikacyjny zapewniający dwukierunkową komunikację między przeglądarką a serweremTwoja odpowiedź
Poprawna odpowiedź. WebSockets to protokół komunikacyjny, który umożliwia dwukierunkową, pełnodupleksową komunikację między klientem a serwerem. To oznacza, że zarówno przeglądarka, jak i serwer mogą wysyłać dane w dowolnym momencie, co znacząco różni się od tradycyjnego modelu HTTP, gdzie klient inicjuje każde połączenie. Przykładem zastosowania WebSockets jest aplikacja czatu w czasie rzeczywistym, gdzie użytkownicy mogą widzieć wiadomości natychmiastowo, bez potrzeby odświeżania strony. Dodatkowo, WebSockets zmniejszają opóźnienia w komunikacji, co jest kluczowe w aplikacjach wymagających szybkiej interakcji, takich jak gry online czy platformy do handlu. Warto zaznaczyć, że WebSockets są zdefiniowane w standardzie IETF jako RFC 6455, a ich wykorzystanie powinno być zgodne z najlepszymi praktykami w zakresie bezpieczeństwa, takimi jak użycie protokołu wSecure WebSockets (wss://) do zapewnienia bezpieczeństwa przesyłanych danych.
Pytanie 39
Który z wymienionych elementów może stanowić część menu w aplikacji desktopowej?
A. CheckBoxTwoja odpowiedź
B. MenuItemPoprawna odpowiedź
C. Canvas
D. ScrollBar
Niepoprawna odpowiedź. CheckBox to komponent, który umożliwia wybór jednej lub wielu opcji, ale nie jest częścią systemu menu – zwykle znajduje się w formularzach lub ustawieniach aplikacji. ScrollBar to element interfejsu umożliwiający przewijanie treści w oknie aplikacji, ale nie jest elementem menu. Canvas to kontener do rysowania elementów graficznych i obiektów, ale nie pełni funkcji w kontekście tworzenia menu aplikacji desktopowych.
Pytanie 40
W języku C# szablon List umożliwia korzystanie z listy. Z definicji obiektu kolekcji wynika, że jego elementami mogą być:
List<int> wykaz= newList<int>();
A. elementy o nieokreślonym typie
B. liczby rzeczywiste
C. liczby całkowiteTwoja odpowiedź
D. elementy typu List
Poprawna odpowiedź. Jeżeli chodzi o kolekcje generyczne w C#, to List<int> jest przykładem bardzo konkretnego zastosowania. Ten zapis oznacza, że tworzymy listę, której elementami mogą być wyłącznie liczby całkowite – dokładnie takie, jakie reprezentuje typ int w .NET (czyli 32-bitowe liczby całkowite ze znakiem). Wynika to z idei generyczności: typ podany w nawiasach ostrych (<int>) precyzyjnie narzuca typ przechowywanych danych. To daje nam bezpieczeństwo typów, na które zwracają uwagę wszyscy programiści C# – nie da się przez pomyłkę dodać tam np. napisu czy obiektu innego typu. Z mojego doświadczenia mogę powiedzieć, że to bardzo upraszcza życie, bo kompilator od razu wychwyci próby niewłaściwego użycia. Praktycznie, gdy tworzysz List<int>, możesz ją wykorzystać np. do przechowywania identyfikatorów, wyników testów, liczb losowych – wszędzie tam, gdzie operujesz właśnie na liczbach całkowitych. Warto dodać, że generyczność jest jednym z filarów nowoczesnych języków, pozwalając pisać kod elastyczny i bezpieczny zarazem. Trochę jak z pudełkiem na śrubki: jak wrzucisz inne rzeczy, to od razu się pogubisz i zrobi się bałagan. Tutaj jest bardzo jasno – List<int> to zawsze lista liczb całkowitych i już. Dobre praktyki branżowe podpowiadają, żeby zawsze stosować jak najbardziej precyzyjne typy w generycznych kolekcjach, bo to ułatwia późniejsze utrzymanie kodu i ogranicza potencjalne błędy.