Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 18 października 2026 00:41
Zakończenie: 18 października 2026 01:01
Egzamin niezdany
Wynik: 11/40 punktów (27,5%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 16% podejść do kwalifikacji INF.03.
Porównanie z 46769 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Funkcja PHP var_dump() prezentuje dane na temat zmiennej, w tym jej typ oraz wartość. Jakim wynikiem zakończy się poniższy fragment kodu?
$x=59.85;var_dump($x);
A.
string(5)"59.85"
B.
float(59.85)
Poprawna odpowiedź
C.
int(59)
Twoja odpowiedź
D.
array(2){[0]=>int(59)[1]=>int(85)}
Niepoprawna odpowiedź. Wybrane odpowiedzi nie są zgodne z poprawnym wynikiem działania funkcji var_dump() w PHP. Odpowiedź, która sugeruje, że wynik to "int(59)" jest błędna, ponieważ funkcja ta nie konwertuje zmiennoprzecinkowych wartości na liczby całkowite, a 59.85 jest wyraźnie liczbą zmiennoprzecinkową. Inna odpowiedź, sugerująca "string(5) "59.85"", jest myląca, ponieważ zmienna $x została zadeklarowana jako liczba, a nie jako string. PHP automatycznie określa typ zmiennej na podstawie przypisanej wartości, a w tym przypadku jest to typ float. Odpowiedź "array(2) { [0]=> int(59) [1]=> int(85) }" również jest nieprawidłowa, ponieważ nie mamy do czynienia z tablicą, a z pojedynczą zmienną. Przykłady te ilustrują typowe nieporozumienia dotyczące typów danych w PHP. Programiści powinni zrozumieć, że PHP jest dynamicznie typowanym językiem, co oznacza, że typ zmiennej jest określany podczas wykonywania programu, a nie w czasie kompilacji. Właściwe zrozumienie typów danych oraz ich konwersji jest kluczowe dla zapewnienia poprawności i bezpieczeństwa kodu.
Pytanie 2
Jaki będzie rezultat po uruchomieniu podanego skryptu?
Niepoprawna odpowiedź. Wybór błędnych odpowiedzi może wynikać z tego, że nie do końca rozumiesz, jak działają konstruktory i destruktory w programowaniu obiektowym. Nie jest tak, że nie ma żadnego napisu, bo nawet jeżeli nie stworzysz obiektu, to przy końcu skryptu destruktor powinien się uruchomić i wtedy wyświetli się 'test2'. Tak że, gdy mówisz, że tylko 'test1' się pokaże, to nie bierzesz pod uwagę, co się dzieje po zakończeniu skryptu. I to, co napisałeś, że tylko 'test2' się wyświetli, też nie jest prawdą, bo konstruktor musi być wywołany, kiedy robi się obiekt. Zrozumienie tych wszystkich spraw jest naprawdę ważne, by dobrze zarządzać danymi w aplikacjach, zwłaszcza w większych projektach, gdzie jest masa obiektów i różne interakcje między nimi.
Pytanie 3
Co oznacza skrót SQL?
A. Simple Query Logic
B. Standard Quality Language
C. Structured Query Language
Poprawna odpowiedź
D. Sequential Question Language
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe rozwinięcia są wymyślone i nie funkcjonują w informatyce. „Standard Quality Language”, „Sequential Question Language” czy „Simple Query Logic” brzmią podobnie, ale nie są poprawnym rozwinięciem skrótu. SQL to Structured Query Language.
Pytanie 4
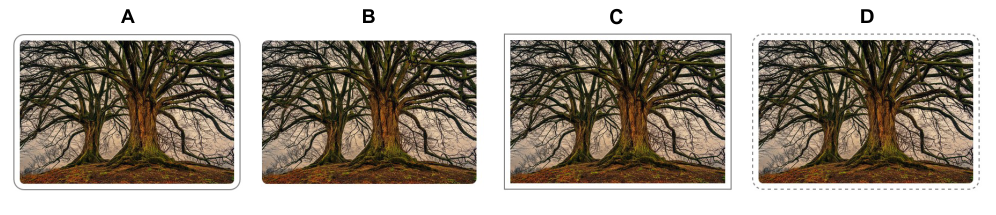
Który z przedstawionych obrazów ma zastosowany poniższy styl CSS?
Poprawna odpowiedź. Obraz A został sformatowany za pomocą stylu CSS, który określa podstawowe cechy estetyczne elementu graficznego. Pierwszym aspektem jest zastosowanie właściwości padding wynoszącej 5px, co oznacza, że wokół obrazu znajduje się wewnętrzny margines o szerokości 5 pikseli. To zapewnia przestrzeń między obrazem a jego ramką, zwiększając czytelność i estetykę wizualną. Następnie, użyto border o grubości 1px z kolorem solid grey. Ten cienki, szary obrys dodaje subtelny akcent, który pomaga wyróżnić obraz na tle strony. Wartość border-radius wynosi 10px, co dodaje zaokrąglone rogi, nadając nowoczesny wygląd. Takie zaokrąglenie jest często stosowane w nowoczesnym designie, aby nadać strony bardziej przyjazny i estetyczny wygląd. Stylizacja obrazów w ten sposób jest zgodna z zasadami responsywności i dostępności, co jest istotne w projektowaniu interfejsów użytkownika. Stosowanie takich technik pozwala na tworzenie spójnych i estetycznych stron internetowych, które są zgodne z obecnymi standardami UX i UI.
Pytanie 5
Wskaż NIEPRAWIDŁOWY opis optymalizacji kodu wygenerowanego przez program
A. Jej celem jest sprawdzenie zgodności z wymogami formalnymi
Poprawna odpowiedź
B. W celu przyspieszenia wykonania kodu przez procesor może być przeprowadzana na różnych etapach działania
C. Powinna prowadzić do zmiany kodu źródłowego w taki sposób, aby działał on szybciej
Twoja odpowiedź
D. Jej celem jest zwiększenie efektywności programu
Niepoprawna odpowiedź. Wszelkie odpowiedzi, które sugerują, że celem optymalizacji kodu wynikowego jest sprawdzenie zgodności z wymogami formalnymi, są błędne. Tego rodzaju podejście myślowe może prowadzić do poważnych nieporozumień w kontekście rozwoju oprogramowania. W rzeczywistości, optymalizacja kodu koncentruje się głównie na zwiększeniu wydajności, a nie na zgodności z formalnościami. Wiele osób myli te pojęcia, co może skutkować szkodliwym podejściem, w którym skupiają się na spełnieniu formalnych wymagań bez zrozumienia, że kluczowym celem jest poprawa funkcjonalności i szybkości działania programu. Co więcej, odpowiedzi sugerujące, że modyfikacje kodu źródłowego prowadzące do większej szybkości działania nie są istotne, są również mylne. W rzeczywistości, optymalizacja kodu często wymaga przekształceń na poziomie kodu źródłowego, aby zapewnić lepszą wydajność. Dobre praktyki programistyczne zalecają testowanie i profilowanie kodu, aby zidentyfikować obszary wymagające poprawy. Warto także pamiętać, że optymalizacja powinna być prowadzona na różnych etapach rozwoju aplikacji, aby dostosować kod do zmieniających się potrzeb użytkowników oraz wymagań technicznych. Ignorowanie tych aspektów może prowadzić do stagnacji w rozwoju oprogramowania i obniżenia jego jakości.
Pytanie 6
Który użytkownik domyślnie posiada pełne uprawnienia do zarządzania bazą danych w systemie MySQL?
A. root
Poprawna odpowiedź
B. sysadmin
C. admin
Twoja odpowiedź
D. mysqld
Niepoprawna odpowiedź. Pozostałe nazwy nie są domyślnym kontem administratora MySQL. „admin” i „sysadmin” brzmią wiarygodnie, ale MySQL nie zakłada ich automatycznie - to konta, które ewentualnie trzeba utworzyć samemu. „mysqld” w ogóle nie jest użytkownikiem, lecz nazwą procesu (demona) serwera MySQL działającego w systemie. Konto z pełnymi uprawnieniami tworzone domyślnie przy instalacji to root, dlatego to ono jest poprawne.
Pytanie 7
Mamy do czynienia z tablicą o nazwie tab, która zawiera liczby całkowite różniące się od zera. Zawarty w języku PHP kod ma na celu:
foreach ($tab as &$liczba) $liczba = $liczba * (-1); unset($liczba);
A. wyliczenie iloczynu wszystkich wartości w tablicy
B. zmienić wszystkie elementy tablicy na liczby o przeciwnym znaku
Twoja odpowiedź
C. przekształcić elementy tablicy na wartości zapisane w zmiennej liczba
D. obliczyć wartość bezwzględną elementów tej tablicy
Poprawna odpowiedź. Odpowiedź jest prawidłowa, ponieważ przedstawiony kod w języku PHP używa pętli foreach do iteracji po tablicy o nazwie tab. Dzięki zastosowaniu operatora & przed nazwą zmiennej $liczba, zmienna ta jest przekazywana przez referencję. Oznacza to, że każda modyfikacja dokonywana na zmiennej $liczba wpływa bezpośrednio na odpowiedni element tablicy. Wewnątrz pętli każda liczba w tablicy jest mnożona przez -1, co skutkuje zmianą jej znaku na przeciwny. W praktyce taka operacja jest powszechnie stosowana, gdy istnieje potrzeba szybkiej zmiany wszystkich wartości w strukturze danych na ich negatywne odpowiedniki, na przykład w algorytmach matematycznych lub finansowych. Istotnym aspektem jest również unikanie modyfikacji oryginalnych danych, co jest kluczowe w procesie przetwarzania danych. Po zakończeniu pętli unset($liczba) usuwa referencję, aby uniknąć niepożądanych efektów ubocznych. Takie podejście jest zgodne z dobrymi praktykami programowania, które kładą nacisk na zarządzanie pamięcią i poprawność danych.
Pytanie 8
W podanym kodzie JavaScript ponumerowano linie dla ułatwienia. W programie występuje błąd, ponieważ po wykonaniu żadna wiadomość nie jest wyświetlana. Aby usunąć ten błąd, należy
1. if (a < b)
2. document.write(a);
3. document.write(" jest mniejsze");
4. else
5. document.write(b);
6. document.write(" jest mniejsze");
A. w liniach 2 i 5 zmienne a i b umieścić w cudzysłowach
B. w liniach 3 i 6 zamienić znaki cudzysłowu na apostrof, np. ' jest mniejsze'
C. umieścić znaki $ przed nazwami zmiennych
Twoja odpowiedź
D. dodać nawiasy klamrowe w sekcjach if oraz else
Poprawna odpowiedź
Niepoprawna odpowiedź. Wstawienie znaków $ przed zmiennymi a i b jest podejściem, które nie ma zastosowania w standardowym JavaScript, gdyż nie jest to sposób na wskazywanie zmiennych w tym języku. W rzeczywistości, znaki $ są używane w niektórych bibliotekach, takich jak jQuery, ale nie wpływają na samą składnię JavaScript. Użycie apostrofów zamiast cudzysłowów również nie rozwiązuje problemu, gdyż JavaScript zezwala na użycie zarówno cudzysłowów, jak i apostrofów do definiowania ciągów tekstowych, jednak nie wpływa to na wykonanie bloków kodu. Zmiana zmiennych na ciągi znakowe w liniach 2 i 5 wprowadza błąd, ponieważ zamiast wartości zmiennych a i b, kod wyświetli dosłownie tekst 'a' oraz 'b', co nie jest zamierzonym celem. W programowaniu, ważne jest nie tylko zrozumienie składni, ale także logiki, jaką ona za sobą niesie. Regularne stosowanie dobrych praktyk, takich jak wstawianie nawiasów klamrowych, pozwala uniknąć takich typowych błędów, które mogą prowadzić do niewłaściwego działania kodu. Ponadto, poznanie i przestrzeganie standardów programistycznych znacznie zwiększa jakość i niezawodność tworzonych aplikacji.
Pytanie 9
Jakie będzie działanie podanych instrukcji JavaScript?
var elementy = document.getElementsByClassName("styl1"); for(var i = 0; i < elementy.length; i++) elementy[i].style.fontWeight = "bolder";
A. Dla wszystkich elementów na stronie zostanie zastosowany styl pogrubienia tekstu na bolder
B. Jedynie dla elementu o id równym styl1 będzie przypisany styl pogrubienia tekstu na bolder
Twoja odpowiedź
C. Wyłącznie dla pierwszego elementu przypisanego do klasy styl1 zostanie nadany styl pogrubienia tekstu bolder
D. Dla wszystkich elementów przypisanych do klasy styl1 zostanie nadany styl pogrubienia tekstu bolder
Poprawna odpowiedź
Niepoprawna odpowiedź. Jednym z często popełnianych błędów jest założenie że metoda getElementsByClassName przypisuje styl wszystkim elementom na stronie. W rzeczywistości zwraca ona tylko te elementy które posiadają określoną klasę styl1. To ogranicza zakres działania funkcji wyłącznie do wybranych elementów z przypisaną klasą co jest istotne dla zrozumienia selektorów w JavaScript. Innym nieporozumieniem może być przekonanie że metoda działa podobnie do selektorów CSS takich jak ID gdzie tylko jeden element jest modyfikowany. W rzeczywistości metoda ta operuje na kolekcji elementów a nie na pojedynczym elemencie. Dodatkowo częstym błędem jest myślenie że getElementsByClassName działa jak querySelector który mógłby zwrócić tylko pierwszy napotkany element. To nieporozumienie może prowadzić do błędnych założeń na temat zakresu i efektu działania skryptu. Warto również pamiętać że manipulacja stylami poprzez bezpośrednie modyfikowanie właściwości style elementu często jest bardziej wydajna niż modyfikowanie arkuszy stylów CSS zwłaszcza w kontekście dynamicznego działania skryptów na stronie internetowej. Kluczowe jest zrozumienie jak różne metody selekcji i manipulacji dokumentem wpływają na działanie i wydajność aplikacji webowych oraz unikanie myślenia że jedna metoda selekcji jest uniwersalna dla wszystkich celów i przypadków użycia co jest istotne w profesjonalnym podejściu do programowania w JavaScript i pracy z DOM.
Pytanie 10
Zarządzanie procesem przekształcania kodu źródłowego stworzonego przez programistę na kod maszynowy, który jest zrozumiały dla komputera, nosi nazwę
A. wdrażanie
Twoja odpowiedź
B. kompilowanie
Poprawna odpowiedź
C. rozpoczynanie
D. analizowanie
Niepoprawna odpowiedź. Implementowanie oznacza wprowadzenie rozwiązania programistycznego w życie, co często jest mylone z procesem kompilacji. Chociaż obie te czynności są kluczowe w cyklu życia oprogramowania, to jednak implementacja odnosi się do fazy, w której kod jest pisany i testowany w kontekście rzeczywistego zastosowania, a nie do jego przetwarzania do postaci, która może być wykonana przez komputer. Debugowanie z kolei to proces identyfikacji i naprawy błędów w kodzie, co jest zupełnie innym działaniem niż kompilowanie. Podczas debugowania programista analizuje działanie kodu w czasie rzeczywistym, używając narzędzi do śledzenia wartości zmiennych i funkcji, co nie ma bezpośredniego związku z konwersją kodu na instrukcje maszynowe. Uruchamianie to proces wykonania już skompilowanego kodu, co również nie dotyczy etapu kompilacji. Warto zrozumieć, że każda z tych czynności ma swoje unikalne miejsce w cyklu życia oprogramowania, a ich wymiana lub mylenie prowadzi do nieporozumień w zakresie tworzenia i wdrażania aplikacji. Dlatego znajomość tych różnic jest niezbędna dla każdego programisty, aby móc efektywnie pracować nad swoimi projektami oraz współpracować z innymi członkami zespołu w zgodzie z najlepszymi praktykami branżowymi.
Pytanie 11
Na czym polega operacja selekcji w algebrze relacji?
A. na wyborze krotek spełniających określone warunki
Poprawna odpowiedź
B. na usunięciu pustych wierszy
C. na wyborze krotek bez wartości NULL
Twoja odpowiedź
D. na usunięciu krotek z powtarzającymi się polami
Niepoprawna odpowiedź. Pozostałe opisy mylą selekcję z innymi operacjami. Usuwanie pustych wierszy lub krotek z NULL oraz eliminacja duplikatów to osobne czynności (ta ostatnia przypomina DISTINCT). Selekcja wybiera wiersze według warunku, podczas gdy wybór kolumn to projekcja.
Poprawna odpowiedź. Poprawnie wychwyciłeś najważniejszy element składni: zapis hurtownia.* po słowie ON oznacza całą bazę danych o nazwie hurtownia, a nie pojedynczą tabelę. W składni GRANT w MySQL i innych systemach bazodanowych mamy kilka poziomów nadawania uprawnień: można nadać uprawnienia do całej bazy (database), do konkretnej tabeli, a nawet do pojedynczych kolumn. Kluczowe jest to, co znajduje się po słowie ON. Jeżeli podamy nazwa_bazy.* – tak jak tutaj – to uprawnienie SELECT dotyczy wszystkich tabel w tej bazie danych. Gdyby chodziło o jedną tabelę, składnia wyglądałaby np. GRANT SELECT ON hurtownia.zamowienia TO 'sprzedawca'@'localhost'; i wtedy prawo dotyczyłoby wyłącznie tabeli zamowienia. W tym poleceniu dodatkowo jasno określony jest użytkownik: 'sprzedawca'@'localhost'. W MySQL użytkownik jest identyfikowany parą nazwa_użytkownika@host, więc nie jest to ani root, ani żaden inny login, tylko konkretny użytkownik o nazwie sprzedawca, który łączy się z serwera localhost. To jest typowy scenariusz np. dla aplikacji sprzedażowej instalowanej na tym samym serwerze co baza. Taki użytkownik często dostaje tylko SELECT do bazy hurtownia, żeby mógł odczytywać dane (np. listę produktów, stany magazynowe, historię zamówień), ale nie miał uprawnień do modyfikacji struktury bazy czy kasowania rekordów. Moim zdaniem jest to bardzo dobra praktyka bezpieczeństwa: tworzy się osobnych użytkowników o wąskim zakresie uprawnień zamiast wszędzie używać konta root. W realnych projektach webowych, np. w PHP czy innych językach backendowych, w pliku konfiguracyjnym aplikacji podaje się właśnie takiego technicznego użytkownika, który ma GRANT SELECT (czasem też INSERT/UPDATE) tylko na jedną, konkretną bazę. Dzięki temu nawet jeśli aplikacja zostanie zhakowana, atakujący ma dużo mniejsze pole do popisu, bo nie dysponuje pełnymi uprawnieniami administracyjnymi. Dobrze też zapamiętać, że GRANT SELECT nie daje prawa do tworzenia nowych tabel ani zmiany struktury – to są osobne uprawnienia (CREATE, ALTER, DROP). Tutaj mówimy wyłącznie o możliwości wykonywania zapytań odczytujących dane ze wszystkich tabel w bazie hurtownia, co w praktyce oznacza, że użytkownik sprzedawca może spokojnie robić SELECT * FROM jakakolwiek_tabela; pod warunkiem, że ta tabela znajduje się właśnie w tej bazie.
Pytanie 13
Jakie zadanie wykonuje funkcja agregująca AVG w poniższym zapytaniu?
SELECTAVG(cena) FROMuslugi;
A. obliczyć średnią arytmetyczną cen wszystkich usług
Poprawna odpowiedź
B. sprawdzić, ile usług znajduje się w tabeli
C. wyznaczyć największą cenę za usługi
Twoja odpowiedź
D. zsumować ceny wszystkich usług
Niepoprawna odpowiedź. Wskazanie, że AVG sumuje koszty wszystkich usług, to niezbyt trafne stwierdzenie. Prawda jest taka, że AVG nie sumuje, tylko liczy średnią. Do zsumowania wartości powinieneś użyć funkcji SUM, która podaje całkowity koszt. Również myślenie, że AVG pokazuje najwyższą cenę, jest mylne - do tego mamy funkcję MAX, która wyciąga największą wartość. Podobnie, pomysł, że AVG zlicza ilość usług, nie jest poprawny, bo do tego służy funkcja COUNT, która zlicza tylko niepuste wartości. Widać, że można się pogubić w tych funkcjach. Ważne, żeby wiedzieć, co każda z nich robi, zanim zaczniemy analizować dane. Funkcje AVG, SUM, MAX i COUNT mają różne zadania, i zrozumienie ich zastosowania to klucz do skutecznej analizy danych w bazach.
Pytanie 14
W tabeli pracownicy zdefiniowano klucz główny jako INTEGER z atrybutami NOT NULL oraz AUTO_INCREMENT. Dodatkowo zdefiniowano kolumny imie oraz nazwisko. W przypadku wykonania poniższej kwerendy SQL wprowadzającej dane, w której pominięto pole klucza, w bazie danych MySQL wystąpi:
A. dodanie rekordu do tabeli, dla klucza głównego zostanie przypisana kolejna wartość naturalna
Poprawna odpowiedź
B. ignorowanie polecenia, tabela nie ulegnie zmianie
C. dodanie rekordu do tabeli, dla klucza głównego zostanie przypisana wartość NULL
Twoja odpowiedź
D. błąd związany z nieprawidłową liczbą kolumn
Niepoprawna odpowiedź. Kiedy pomijasz wartość klucza głównego w instrukcji INSERT, to naprawdę może to prowadzić do zamieszania, jeśli nie rozumiesz, jak działają klucze w bazach danych. Mówienie, że pojawi się błąd z nieprawidłową liczbą pól, to tak, jakbyś nie znał zasad działania tabel w MySQL. Jak masz klucz główny ustawiony na AUTO_INCREMENT, to naprawdę nie musisz go podawać, bo system zrobi to za Ciebie. Powinieneś wiedzieć, że klucz główny jest mega ważny do identyfikacji rekordów w tabeli i jest potrzebny, żeby wszystko działało jak należy. Z kolei druga błędna odpowiedź, która mówi, że MySQL zignoruje polecenie, pokazuje, że nie łapiesz koncepcji, jak silnik bazy danych zajmuje się brakującymi danymi. MySQL nie zignoruje tego, tylko zareaguje i przydzieli nową wartość klucza. A jeszcze jedna rzecz – przypisanie wartości NULL do klucza głównego to już w ogóle zła droga, bo klucz musi być unikalny i nigdy nie może być pusty. Tego rodzaju myślenie wskazuje na typowe błędy, które wynikają z niepełnego rozumienia działania kluczy w bazach danych i jak to się ma do wprowadzania nowych rekordów.
Pytanie 15
Z jakich elementów składa się tabela generowana przez poniższy kod?
Poprawna odpowiedź. Kod w pytaniu przedstawia strukturę HTML dla tabeli. Tabela składa się z jednej pary znaczników <tr>, co oznacza, że zawiera jeden wiersz. Wewnątrz tego wiersza znajdują się dwa znaczniki <td>, reprezentujące dwie komórki, czyli kolumny. Praktyczne zastosowanie tabel w HTML obejmuje prezentację danych w sposób strukturalny, co jest szczególnie użyteczne w przypadku raportów, cenników czy kalendarzy. Dobre praktyki w projektowaniu stron internetowych sugerują stosowanie tabel do prezentacji danych, nie zaś do układania treści na stronie, co było popularne w starszych wersjach HTML. W nowoczesnym podejściu do front-endu, używa się CSS i Flexbox lub Grid do układania elementów. Jednak zrozumienie podstaw HTML, takich jak prawidłowa struktura tabeli, jest kluczowe dla tworzenia semantycznych i dostępnych stron WWW. Tabele powinny być też wzbogacone o elementy takie jak <thead>, <tbody> i <tfoot> dla lepszej organizacji danych i wsparcia przez technologie asystujące dla osób z niepełnosprawnościami.
Pytanie 16
W tabeli artykuły wykonano następujące instrukcje dotyczące uprawnień użytkownika jan:
GRANT ALL PRIVILEGES ON artykuly TO jan
REVOKE SELECT, UPDATE ON artykuly FROM jan
Po zrealizowaniu tych instrukcji pracownik jan będzie uprawniony do
A. tworzenia tabeli oraz edytowania danych w niej
B. tworzenia tabeli i wypełniania jej danymi
Poprawna odpowiedź
C. edycji danych oraz przeglądania tabeli
Twoja odpowiedź
D. wyświetlania zawartości tabeli
Niepoprawna odpowiedź. Wybrane odpowiedzi, które nie są poprawne, nie uwzględniają szczególnych ograniczeń, które zostały nałożone na użytkownika Jana po wykonaniu polecenia REVOKE. W przypadku odpowiedzi sugerujących, że Jan mógłby aktualizować dane i przeglądać tabelę, brakuje zrozumienia znaczenia polecenia REVOKE, które jednoznacznie odmawia tych uprawnień. Aktualizowanie danych w tabeli wymaga posiadania uprawnienia UPDATE, które Jan utracił. Z kolei odpowiedzi sugerujące tworzenie tabeli i aktualizowanie w niej danych oraz przeglądanie tabeli są również mylące, ponieważ wykluczają kluczowy aspekt ograniczeń narzuconych przez polecenie REVOKE. Użytkownik Jan nie może przeglądać danych w tabeli, ponieważ nie ma aktualnie uprawnienia SELECT. Ponadto, w kontekście SQL, każdy użytkownik musi mieć przyznane konkretne uprawnienia do realizacji określonych operacji na danych, co w przypadku Jana oznacza, że jego uprawnienia do SELECT i UPDATE są nieodwracalnie usunięte, co czyni wszystkie te odpowiedzi nieaktualnymi.
Pytanie 17
Która technika rozwiązywania konfliktów w firmie bywa niebezpieczna i może ZAOSTRZYĆ konflikt?
A. kompromis
B. arbitraż
C. ignorowanie
Twoja odpowiedź
D. separacja
Poprawna odpowiedź. Ignorowanie konfliktu polega na udawaniu, że problemu nie ma - i właśnie dlatego bywa groźne: nierozwiązana sprawa narasta, emocje się kumulują, a strona, która czuje się lekceważona, reaguje coraz ostrzej. Zamiast wygasić spór, takie unikanie zwykle go zaostrza. Dlatego niebezpieczną techniką jest ignorowanie.
Pytanie 18
Jaką kwerendę w bazie MariaDB należy zastosować, aby wybrać artykuły z cenami mieszczącymi się w zakresie obustronnie domkniętym <10, 20>?
A.
SELECT*FROMArtykulyWHERECenaIN(10,20)
B.
SELECT*FROMArtykulyWHERECenaBETWEEN10AND20
Twoja odpowiedź
C.
SELECT*FROMArtykulyWHERECena>10ANDCena<20
D.
SELECT*FROMArtykulyWHERECenaLIKE1%,2%
Poprawna odpowiedź. Odpowiedź ta jest prawidłowa, ponieważ wykorzystuje operator BETWEEN, który jest idealnym narzędziem do określenia przedziału wartości w bazie danych. W przypadku tego zapytania, operator BETWEEN obejmuje wszystkie wartości z przedziału obustronnie domkniętego od 10 do 20, co oznacza, że zostaną uwzględnione zarówno wartości 10 jak i 20. Tego typu zapytanie jest niezwykle przydatne w praktyce, gdy chcemy szybko wyselekcjonować dane spełniające określone kryteria. Wartością dodaną stosowania BETWEEN jest oszczędność czasu i zwiększenie czytelności zapytań, co jest zgodne z zasadami dobrych praktyk w programowaniu SQL. Przykładem zastosowania może być sytuacja, gdy w firmie potrzebujemy analizować sprzedaż produktów w określonym przedziale cenowym, aby ocenić efektywność promocji. Dzięki temu rozwiązaniu możemy szybko i efektywnie uzyskać potrzebne dane, co ułatwia podejmowanie decyzji biznesowych.
Pytanie 19
Aby za pomocą instrukcji SELECT uzyskać listę nazwisk osób mieszkających na osiedlu, przy czym nazwiska te nie mogą się powtarzać, należy sformułować zapytanie w następujący sposób
A.
SELECTAVG(nazwisko)FROMmieszkancy
B.
SELECTTOP10nazwiskoFROMmieszkancy
C.
SELECTnazwiskoFROMmieszkancyORDERBYnazwisko
Twoja odpowiedź
D.
SELECTDISTINCTnazwiskoFROMmieszkancy
Poprawna odpowiedź
Niepoprawna odpowiedź. Odpowiedzi, które nie wykorzystują klauzuli DISTINCT, nie są w stanie spełnić wymogu eliminacji duplikatów w wynikach zapytania. Na przykład, użycie "SELECT nazwisko FROM mieszkancy ORDER BY nazwisko;" tylko sortuje wyniki według nazwisk, ale nie eliminuje powtarzających się rekordów. To jest typowy błąd w myśleniu, gdzie użytkownicy mogą myśleć, że sortowanie wystarczy, aby uzyskać unikalne wyniki. Jeżeli w tabeli znajduje się wiele osób o tym samym nazwisku, zapytanie to nadal zwróci wszystkie wystąpienia, co prowadzi do niepożądanych rezultatów. Z kolei "SELECT TOP 10 nazwisko FROM mieszkancy;" ogranicza wyniki do tylko 10 pierwszych rekordów, ale nie zapewnia ich unikalności. W zależności od kolejności, w jakiej dane są prezentowane, wynik może zawierać duplikaty, co nie spełnia wymagań zadania. Dodatkowo, "SELECT AVG(nazwisko) FROM mieszkancy;" ma na celu obliczenie średniej, co jest nonsensowne w kontekście kolumny tekstowej jak 'nazwisko', ponieważ średnia nie jest miarodajną miarą dla danych tekstowych. Takie podejście demonstruje niewłaściwe zrozumienie typów danych i ich zastosowań w SQL. W każdej sytuacji, umiejętność poprawnego formułowania zapytań SQL jest kluczowa dla efektywnej pracy z bazami danych i unikania błędów analitycznych.
Pytanie 20
Co robi funkcja przedstawiona w kodzie JavaScript?
function tekst() {
  var h = location.hostname;
  document.getElementById("info").innerHTML = h;
}
A. umożliwić przejście do wskazanej lokalizacji hosta
B. wyświetlić w elemencie o id = "info" adres hosta wskazany przez pierwszy odnośnik
C. wyświetlić w elemencie o id = "info" nazwę hosta, z którego pochodzi wyświetlona strona
Twoja odpowiedź
D. pokazać na przycisku lokalizację hosta, a po jego naciśnięciu umożliwić przejście do określonej lokalizacji
Poprawna odpowiedź. Prawidłowa odpowiedź wskazuje, że kod JavaScript wywołuje metodę location.hostname, która zwraca nazwę hosta aktualnie odwiedzanej strony. Hostname jest częścią obiektu Location, który reprezentuje bieżący URL dokumentu. Kod przypisuje wynik tej metody do zmiennej h, a następnie ustawia innerHTML elementu o id info na wartość tej zmiennej. Dzięki takim operacjom, kod efektywnie wyświetla nazwę hosta w elemencie o konkretnym identyfikatorze na stronie HTML. Jest to częsta technika używana w aplikacjach webowych, gdzie istotne jest dynamiczne wyświetlanie informacji o aktualnym połączeniu. Znajomość obiektu Location oraz jego właściwości, takich jak hostname, to podstawowa umiejętność w pracy z językiem JavaScript, szczególnie w kontekście manipulacji DOM. Takie podejście jest zgodne z dobrymi praktykami, gdyż unika bezpośredniego wpisywania danych w kodzie, co zwiększa elastyczność i ułatwia utrzymanie aplikacji.
Pytanie 21
Testy sprawdzające, czy aplikacja działa poprawnie w różnych architekturach serwera, konfiguracjach i środowiskach, to testy:
A. bezpieczeństwa
B. użyteczności
C. kompatybilności
Twoja odpowiedź
D. funkcjonalności
Poprawna odpowiedź. Testy sprawdzające, czy aplikacja działa poprawnie w różnych architekturach serwera, konfiguracjach i środowiskach, to testy KOMPATYBILNOŚCI (zgodności). Upewniają się, że oprogramowanie współpracuje z różnym sprzętem, systemami i przeglądarkami. Dlatego są to testy kompatybilności.
Pytanie 22
Pętla while ma działać, dopóki zmienna x należy do przedziału otwartego (-2, 5). Który warunek to zapisuje (PHP)?
A.
($x<-2)||($x>5)
Twoja odpowiedź
B.
($x>-2)&&($x<5)
Poprawna odpowiedź
C.
($x==-2)&&($x<5)
D.
($x>-2)||($x>5)
Niepoprawna odpowiedź. Pozostałe warunki źle opisują przedział. ($x==-2)&&($x<5) wymagałoby, by x był równy dokładnie -2 (a to wartość WYŁĄCZONA z przedziału otwartego). Warianty z || (($x>-2)||($x>5), ($x<-2)||($x>5)) opisują sumę zbiorów, czyli wartości POZA przedziałem albo zbyt szeroko. Przedział (-2, 5) to ($x>-2)&&($x<5).
Pytanie 23
Wskaż fragment kodu HTML5, który zostanie uznany przez walidator za niepoprawny?
Niepoprawna odpowiedź. Odpowiedzi <p class="stl" id="a">tekst</p>, <p class="stl" style="color: #F00">tekst</p> oraz <p class="stl">tekst</p> są poprawne i zgodne z standardami HTML5. Element <p> jest ogólnym znacznikiem używanym do definiowania paragrafów, a jego właściwe użycie obejmuje dodanie klas i identyfikatorów, co może być przydatne do stylizacji i skryptów. Użycie klasy 'stl' w pierwszym przykładzie pozwala na łatwe stylizowanie tego elementu w arkuszach stylów, co jest zgodne z zasadami modularności i ponownego użycia kodu. W przypadku drugiego przykładu, zastosowanie atrybutu style pozwala na bezpośrednie zastosowanie stylu, co jest właściwym podejściem w kontekście prostych aplikacji, chociaż w praktyce lepiej jest unikać inline styles ze względu na trudności w utrzymaniu kodu. Ostatni przykład, czyli <p class="stl">tekst</p>, nie zawiera żadnych dodatkowych atrybutów, ale także jest poprawny i może być używany w wielu kontekstach, gdzie stylizacja nie jest wymagana. Błędne jest myślenie, że elementy HTML5 są jedynie kontenerami treści - ich semantyka i zastosowanie klasy, identyfikatorów oraz stylów mają kluczowe znaczenie dla efektywności i organizacji kodu, co powinno być brane pod uwagę przy projektowaniu stron internetowych.
Pytanie 24
Fragment kwerendy SQL zaprezentowany w ramce ma na celu uzyskanie
SELECT COUNT(wartosc) FROM ...
A. liczbę wierszy.
Poprawna odpowiedź
B. sumę wartości w kolumnie wartosc.
Twoja odpowiedź
C. liczbę kolumn.
D. średnią wartość w kolumnie wartosc.
Niepoprawna odpowiedź. SELECT COUNT(wartosc) w zapytaniu SQL jest często mylone z innymi funkcjami agregującymi, co może prowadzić do nieporozumień dotyczących jego działania. COUNT jest specyficznie zaprojektowany do zliczania niepustych wartości w określonej kolumnie, dlatego nie jest używany do obliczania sumy czy średniej wartości. Suma w kolumnie wartosc wymagałaby użycia funkcji SUM(wartosc), która zlicza wartości liczbowe. Z kolei obliczanie średniej wartości w kolumnie wymagałoby zastosowania funkcji AVG(wartosc), która dzieli sumę wartości przez liczbę niepustych wierszy. Mylenie tych funkcji może prowadzić do błędnych interpretacji danych i niepoprawnych wyników, co jest kluczowe w środowisku biznesowym, gdzie precyzja i dokładność są niezbędne. Warto zauważyć, że zrozumienie różnic w działaniu funkcji agregujących jest fundamentalne dla efektywnej analizy danych. Stosowanie odpowiednich funkcji pozwala na optymalizację zapytań oraz zapewnia, że uzyskane wyniki są zgodne z oczekiwaniami analitycznymi, co jest kluczowe w podejmowaniu decyzji opartych na danych.
Pytanie 25
Na podstawie filmu wskaż, która cecha dodana do stylu CSS zamieni miejscami bloki aside i nav, pozostawiając w środku blok section?
A. nav { float: right; } section { float: right; }
Poprawna odpowiedź
B. nav { float: left; } aside { float: left; }
Twoja odpowiedź
C. nav { float: right; }
D. aside {float: left; }
Niepoprawna odpowiedź. W tym zadaniu kluczowe jest zrozumienie, jak naprawdę działa float, a nie tylko samo skojarzenie, że „left to lewo, right to prawo”. Wiele osób myśli, że wystarczy ustawić jeden element na lewo, drugi na prawo i wszystko magicznie się poukłada. W praktyce przeglądarka trzyma się bardzo konkretnych reguł: najpierw liczy kolejność elementów w HTML, potem dopiero stosuje float i układa je możliwie jak najwyżej i jak najbliżej odpowiedniej krawędzi.
Jeśli nada się float tylko dla aside albo tylko dla nav, to zmienia się ich pozycja, ale układ trzech bloków nie spełni warunku z zadania: aside i nav nie zamienią się miejscami z pozostawieniem section w środku. Przykładowo, samo float: left na aside niczego nie „zamieni”, bo element i tak pojawia się jako pierwszy w kodzie, więc będzie u góry, tylko że „przyklejony” do lewej. Z kolei ustawienie nav na prawą stronę bez odpowiedniego floatowania section prowadzi do sytuacji, gdzie section nadal zachowuje się jak normalny blok, zwykle ląduje pod elementami pływającymi albo obok nich w sposób mało przewidywalny dla początkującego.
Częsty błąd myślowy polega też na tym, że ktoś próbuje wszystkim elementom dać float: left, licząc na to, że przeglądarka „ułoży je po swojemu”. Wtedy jednak wszystkie te bloki ustawiają się w jednym kierunku, w kolejności z HTML, więc nie ma mowy o świadomym „zamienianiu miejsc”. Brak zrozumienia, że float wyjmuje element z normalnego przepływu i wpływa na to, jak kolejne elementy zawijają się wokół niego, prowadzi właśnie do takich błędnych odpowiedzi. Z mojego doświadczenia lepiej jest najpierw narysować sobie prosty schemat: w jakiej kolejności idą znaczniki i które z nich mają pływać w prawo, a które zostać w naturalnym układzie. Dopiero wtedy dobiera się konkretne deklaracje CSS. Takie myślenie przydaje się nie tylko przy float, ale też przy nauce flexboxa czy grida, gdzie kolejność w DOM i własności układu też grają ogromną rolę.
Pytanie 26
Arkusze stylów w formacie kaskadowym są tworzone w celu
A. ułatwienia formatowania strony
Poprawna odpowiedź
B. połączenia struktury dokumentu strony z odpowiednią formą jej wizualizacji
C. nadpisywania wartości znaczników, które już zostały ustawione na stronie
Twoja odpowiedź
D. blokowania wszelkich zmian w wartościach znaczników już przypisanych w pliku CSS
Niepoprawna odpowiedź. Wybór błędnych odpowiedzi może wynikać z nieporozumienia dotyczącego funkcji kaskadowych arkuszy stylów i ich zastosowania w procesie tworzenia stron internetowych. Odpowiedzi sugerujące blokowanie jakichkolwiek zmian w wartościach znaczników w pliku CSS są mylące, ponieważ CSS zaprojektowane jest właśnie po to, aby umożliwiać modyfikacje stylów. Arkusze stylów nie blokują zmian, tylko lepiej organizują i strukturalizują kod, co sprzyja łatwiejszemu wprowadzaniu przyszłych poprawek. Z kolei połączenie struktury dokumentu strony z właściwą formą prezentacji jest bardziej związane z HTML, który odpowiada za strukturę treści strony. CSS natomiast odpowiada głównie za stylizację i nie ma na celu bezpośredniego łączenia tych aspektów, lecz oddzielenie ich. Warto również zauważyć, że nadpisywanie wartości znaczników na stronie to szczególna funkcjonalność CSS, ale nie jest to jej główny cel. Główna idea CSS polega na uproszczeniu procesu formatowania, co podkreśla znaczenie kaskadowości, gdzie reguły mogą być dziedziczone i nadpisywane w sposób przemyślany i kontrolowany. Typowymi błędami myślowymi w tym kontekście są zamiana celów CSS z HTML oraz brak zrozumienia mechanizmów kaskadowości, co prowadzi do nieprawidłowych wniosków na temat roli, jaką CSS odgrywa w projektowaniu stron internetowych.
Pytanie 27
Dany jest fragment kodu PHP z zadeklarowaną zmienną tablicową. Jakie imię zostanie wyświetlone po wykonaniu tego kodu?
Niepoprawna odpowiedź. W zadanym pytaniu istotne jest zrozumienie indeksowania tablic w PHP które jest językiem o indeksowaniu zerowym. Oznacza to że pierwszy element tablicy ma indeks 0 drugi ma indeks 1 i tak dalej. Częstym błędem jest intuicyjne przypisywanie pierwszemu elementowi indeksu 1 co prowadzi do niepoprawnych wyników. W przypadku omawianego kodu tablica zawiera elementy: 'Anna' 'Tomasz' 'Krzysztof' i 'Aleksandra'. Aby uzyskać dostęp do trzeciego elementu należy użyć indeksu 2 a nie 3. Element o indeksie 2 w tej tablicy to 'Krzysztof' co jest poprawną odpowiedzią. Pomyłki w indeksowaniu mogą prowadzić do trudnych do zdiagnozowania błędów w programach takich jak 'undefined offset' gdy próbujemy uzyskać dostęp do nieistniejącego indeksu. Dlatego ważne jest aby zawsze weryfikować zakres i poprawność używanych indeksów zwłaszcza w skomplikowanych strukturach danych. Dodatkowo warto zaznaczyć że w niektórych językach programowania takie jak Python indeksowanie również jest zerowe co pozwala na łatwiejsze przejście pomiędzy różnymi językami programowania bez zmiany mentalnego modelu działania tablic.
Pytanie 28
Instrukcja w języku SQL
GRANT ALL PRIVILEGES ON klienci TO pracownik
A. Odbiera wszystkie uprawnienia pracownikowi do tabeli klienci
B. Przyznaje wszystkie uprawnienia do tabeli klienci użytkownikowi pracownik
Twoja odpowiedź
C. Przyznaje uprawnienia grupie klienci do tabeli pracownik
D. Przenosi uprawnienia z grupy klienci na użytkownika pracownik
Poprawna odpowiedź. Odpowiedź jest poprawna, ponieważ polecenie GRANT ALL PRIVILEGES ON klienci TO pracownik w języku SQL rzeczywiście nadaje wszystkie dostępne uprawnienia do tabeli klienci użytkownikowi pracownik. To oznacza, że pracownik zyskuje możliwość wykonywania wszelkich operacji na tej tabeli, w tym SELECT, INSERT, UPDATE oraz DELETE. Przykład zastosowania tego polecenia jest istotny w kontekście zarządzania bazami danych, gdzie administratorzy muszą przyznawać różnorodne uprawnienia użytkownikom w zależności od ich roli. Przykładowo, jeśli pracownik jest odpowiedzialny za wprowadzanie i aktualizację danych klientów, to nadanie mu wszystkich uprawnień jest uzasadnione. Ważne jest, aby przyznawać uprawnienia zgodnie z zasadą najmniejszych uprawnień, co oznacza, że użytkownik powinien mieć tylko te uprawnienia, które są niezbędne do realizacji jego zadań. W praktyce, administrator baz danych powinien monitorować przyznane uprawnienia i regularnie je przeglądać, aby zapewnić bezpieczeństwo systemu. Koszty błędów w przyznawaniu uprawnień mogą być znaczne, w tym ryzyko nieautoryzowanego dostępu do danych, dlatego kluczowe jest stosowanie dobrych praktyk w zarządzaniu uprawnieniami.
Pytanie 29
Przedstawiony kod źródłowy, zapisany w języku C++, ma za zadanie dla wprowadzanych dowolnych całkowitych liczb różnych od zera wypisać:
Niepoprawna odpowiedź. Wybierając odpowiedź, która mówi o liczbach pierwszych, można chyba zauważyć, że jest tu pewne nieporozumienie. Program nie ma na celu wyłapania liczb pierwszych, które zaczynają się od 2 i mają dokładnie dwa dzielniki – 1 i siebie samego. Zamiast tego, ten kod skupia się na parzystości liczb, co jest zupełnie czymś innym. Jak widać, sugerowanie, że program wypisuje wszystkie liczby, też jest błędne, bo nieparzyste liczby są po prostu pomijane. A odpowiedź dotycząca liczb nieparzystych to już w ogóle błąd, bo program nawet ich nie uwzględnia. W programowaniu ważne jest, żeby dobrze zrozumieć, co robi dany kod i jakie ma cele. To pomoże unikać błędów i nieporozumień w przyszłości.
Pytanie 30
W jaki sposób będzie uporządkowana lista stworzona z wszystkich kolumn tabeli uczniowie, obejmująca uczniów o średniej wyższej niż 5, która zostanie zwrócona jako rezultat przedstawionego zapytania?
SELECT * FROM uczniowie WHEREsrednia > 5 ORDER BY klasa DESC;
A. Malejąco według parametru klasa
Poprawna odpowiedź
B. Rosnąca według parametru klasa
Twoja odpowiedź
C. Rosnaco według parametru srednia
D. Malejąco według parametru srednia
Niepoprawna odpowiedź. Zapytanie SQL zawiera klauzulę ORDER BY klasa DESC co wskazuje że sortowanie odbywa się malejąco według kolumny klasa Niepoprawne odpowiedzi sugerują różne podejścia do sortowania które nie są zgodne z rzeczywistym działaniem zapytania Po pierwsze sortowanie malejąco według parametru średnia oznaczałoby że rekordy są uporządkowane od najwyższej do najniższej wartości średniej co nie jest prawdą dla tego zapytania ponieważ używamy ORDER BY klasa a nie srednia Po drugie sortowanie rosnąco według średniej oznaczałoby uporządkowanie od najniższej do najwyższej wartości średniej co nie jest objęte żadnym aspektem tego zapytania Trzecią błędną koncepcją jest sortowanie rosnąco według klasy co oznaczałoby że wyniki są uporządkowane od najniższej do najwyższej wartości klasy jednak zapytanie wyraźnie specyfikuje malejące sortowanie DESC co jest przeciwieństwem sortowania rosnącego Takie niepoprawne odpowiedzi mogą wynikać z braku zrozumienia funkcji klauzuli ORDER BY oraz różnic między DESC a ASC Typowym błędem jest założenie że sortowanie zawsze odbywa się według parametru który jest przedmiotem filtrowania w klauzuli WHERE co nie jest regułą w języku SQL Istotne jest zrozumienie że klauzula WHERE ogranicza wyniki do tych które spełniają określone warunki podczas gdy ORDER BY określa kolejność wyświetlania tych wyników Uważne analizowanie struktury i składni zapytań SQL jest kluczowe w unikaniu takich błędów
Pytanie 31
Rekord w bazie danych jest jednoznacznie identyfikowany przez pole:
A. klucza podstawowego
Poprawna odpowiedź
B. klucza obcego
C. numeryczne
D. relacji
Twoja odpowiedź
Niepoprawna odpowiedź. Klucz OBCY służy do powiązań między tabelami, a nie do identyfikacji rekordu. Samo pole numeryczne nie gwarantuje unikalności, a „pole relacji” nie jest pojęciem identyfikatora. Rekord identyfikuje klucz podstawowy.
Pytanie 32
Wskaż komendę, która dokonuje aktualizacji danych w tabeli?
A.
CREATE
B.
SELECT
C.
UPDATE
Twoja odpowiedź
D.
ALTER
Poprawna odpowiedź. Odpowiedź "UPDATE" jest jak najbardziej trafna. To takie podstawowe polecenie SQL, które pozwala na aktualizowanie już istniejących danych w tabeli. Możesz dzięki niemu zmienić jeden albo kilka wierszy w tabeli, w zależności od tego, jakie masz kryteria. Na przykład, jeśli mamy tabelę "pracownicy" i chcemy zwiększyć pensję programistów do 6000 zł, wystarczy użyć polecenia: `UPDATE pracownicy SET pensja = 6000 WHERE stanowisko = 'programista';`. To polecenie działa w taki sposób, że modyfikuje dane, ale przy tym dba o integralność, co jest bardzo ważne w pracy z bazami danych. Warto zawsze dodawać klauzulę WHERE, żeby zmiany dotyczyły tylko wybranych wierszy – to pomoże uniknąć sytuacji, w której przypadkiem zmienisz wszystko. Umiejętność korzystania z UPDATE jest naprawdę istotna, jeżeli chcesz efektywnie zarządzać swoimi danymi.
Pytanie 33
Tabela samochody zawiera poniższe rekordy.
id
klasa_id
marka
model
rocznik
1
1
ford
ka
2017
2
2
seat
toledo
2016
3
3
opel
zafira
2018
4
2
fiat
500X
2018
5
3
opel
insignia
2017
Po wykonaniu podanego zapytania SQL, jakie dane zostaną zwrócone?
Niepoprawna odpowiedź. W tym zapytaniu trzeba bardzo dokładnie rozdzielić dwie sprawy: filtrowanie rekordów i wybór kolumn do wyświetlenia. Warunek WHERE rocznik > 2017 AND marka = 'opel' nie oznacza, że należy pokazać wszystkie ople z tabeli. Operator AND wymaga spełnienia obu warunków naraz, więc opel insignia z rocznika 2017 odpada, bo 2017 nie jest większe od 2017. To drobny detal, ale w SQL znak > jest ścisły, czyli nie obejmuje wartości równej. Gdyby miało przejść także 2017, trzeba by użyć rocznik >= 2017. Częstym błędem jest też dopisywanie do wyniku marki, na przykład traktowanie wyniku jako „opel zafira”. Tymczasem SELECT model jasno mówi, że zwracana jest tylko kolumna model, bez kolumny marka. Baza danych nie dopisuje automatycznie innych pól tylko dlatego, że były użyte w warunku WHERE. Podobnie wynik „zafira; insignia” bierze się zwykle z zauważenia marki opel, ale pominięcia ograniczenia na rocznik. Natomiast „opel zafira; opel insignia” miesza oba błędy naraz: pokazuje zbyt wiele rekordów oraz zbyt wiele kolumn. Z mojego doświadczenia najlepiej analizować takie zapytanie etapami: najpierw odfiltrować wiersze po roczniku, potem po marce, a dopiero na końcu spojrzeć, co jest w SELECT. Tak działa to też w realnych aplikacjach, np. przy wyszukiwarkach ofert, raportach i panelach administracyjnych.
Pytanie 34
Klucz obcy w tabeli jest używany w celu
A. zdefiniowania relacji 1..n łączącej go z kluczem głównym innej tabeli
Poprawna odpowiedź
B. umożliwienia jednoznacznej identyfikacji rekordu w danej tabeli
C. opracowania formularza do wprowadzania danych do tabeli
D. połączenia go z innymi kluczami obcymi w tabeli
Twoja odpowiedź
Niepoprawna odpowiedź. Klucz obcy w tabeli często mylony jest z innymi elementami struktury bazy danych, co prowadzi do nieporozumień w jego zastosowaniu. Odpowiedzi sugerujące, że klucz obcy służy do łączenia go z innymi kluczami obcymi tabeli, są mylne, ponieważ klucze obce nie są same w sobie elementami łączącymi, ale raczej definiują relację z kluczem głównym innej tabeli. Tworzenie formularza wpisującego dane do tabeli również nie jest funkcją klucza obcego, który służy do wskazywania relacji między danymi, a nie do interakcji użytkownik-baza danych. Umożliwienie jednoznacznej identyfikacji rekordu w tabeli jest funkcją klucza głównego, a nie klucza obcego; klucz obcy zazwyczaj nie identyfikuje rekordu, lecz odnosi się do rekordu w innej tabeli. Przykładowo, jeśli w tabeli 'Zamówienia' klucz obcy wskazuje na 'KlientID' w tabeli 'Klienci', to nie identyfikuje on zamówienia, lecz łączy je z klientem. W wyniku tych błędnych założeń, projektanci baz danych mogą wprowadzać niepoprawne relacje, co prowadzi do problemów z integralnością i spójnością danych, a także utrudnia analizowanie związanych ze sobą informacji.
Pytanie 35
Istnieje tabela o nazwie wycieczki z kolumnami: nazwa, cena oraz miejsca (reprezentujące liczbę dostępnych miejsc). Aby wyświetlić tylko nazwy wycieczek, których cena jest mniejsza od 2000 zł oraz mają co najmniej cztery wolne miejsca, należy użyć zapytania
Niepoprawna odpowiedź. Wszystkie inne odpowiedzi są po prostu błędne i prowadzą do złych wyników w kontekście pytania. Na przykład zapytanie z operatorem OR, czyli 'SELECT nazwa FROM wycieczki WHERE cena < 2000 OR miejsca > 4', pozwala na zwrócenie wycieczek, które spełniają tylko jeden z warunków. To oznacza, że mogą być pokazywane wycieczki droższe, które mają wystarczająco dużo miejsc, co jest niezgodne z wymaganiami. Jeszcze innym błędnym przypadkiem jest użycie operatora AND w 'SELECT nazwa FROM wycieczki WHERE cena < 2000 AND miejsca > 3', gdzie ten drugi warunek jest zbyt ogólny. Powinien precyzować, że miejsc musi być co najmniej cztery, a nie tylko więcej niż trzy. Co więcej, zapytanie 'SELECT * FROM wycieczki WHERE cena < 2000 AND miejsca > 4' zwróci wszystkie kolumny, a nie tylko nazwy wycieczek, co też nie jest tym, czego potrzebujemy. Typowe błędy w myśleniu, które prowadzą do tych błędnych wniosków, to złe łączenie warunków i niewłaściwe zrozumienie, co jest ważne w kontekście wymagań. Aby dobrze pisać zapytania SQL, kluczowe jest zrozumienie struktury danych i logiki, która pozwala na wybranie odpowiednich rekordów.
Pytanie 36
Istnieje tabela o nazwie przedmioty, która zawiera kolumny ocena i uczenID. Jakie zapytanie należy wykorzystać, aby obliczyć średnią ocen ucznia z ID równym 7?
A.
SELECTCOUNT(ocena)FROMprzedmiotyWHEREuczenID=7;
B.
AVGSELECTocenaFROMprzedmiotyWHEREuczenID=7;
C.
SELECTAVG(ocena)FROMprzedmiotyWHEREuczenID=7;
Poprawna odpowiedź
D.
COUNTSELECTocenaFROMprzedmiotyWHEREuczenID=7;
Twoja odpowiedź
Niepoprawna odpowiedź. Pierwsza z błędnych odpowiedzi, AVG SELECT ocena FROM przedmioty WHERE uczenID=7; jest niewłaściwa, ponieważ składnia SQL jest błędna. W SQL kluczowe słowo AVG powinno występować jako część funkcji agregującej w kontekście SELECT, a nie przed nim. Niezrozumienie struktury komendy SQL prowadzi do powstawania takich błędów. Kolejny błąd dotyczy odpowiedzi COUNT SELECT ocena FROM przedmioty WHERE uczenID=7;, w której zamiast obliczania średniej, wykorzystano funkcję COUNT. COUNT służy do liczenia liczby wierszy spełniających określony warunek, a nie do obliczania wartości średniej. Użytkownicy mogą mylić te funkcje, jednak ich zastosowanie jest całkowicie różne. Ostatnia odpowiedź, SELECT COUNT(ocena) FROM przedmioty WHERE uczenID=7;, również odnosi się do zliczania, co nie odpowiada na pytanie o średnią. W obrębie SQL, dobre praktyki obejmują zrozumienie i prawidłowe stosowanie odpowiednich funkcji do określonych celów. Niepoprawne podejście do zagadnienia może prowadzić nie tylko do błędnych wyników, ale również do poważnych problemów w analizie danych, co podkreśla znaczenie właściwego formułowania zapytań oraz znajomości podstawowych funkcji SQL.
Pytanie 37
Który typ przypisać kolumnie z kodami pocztowymi, by przechowywała tekst o STAŁEJ długości?
A.
TEXT
Twoja odpowiedź
B.
BLOB
C.
CHAR
Poprawna odpowiedź
D.
DECIMAL
Niepoprawna odpowiedź. Pozostałe typy się nie nadają. TEXT przechowuje długie teksty o ZMIENNEJ długości, BLOB służy do danych binarnych (np. plików), a DECIMAL to typ liczbowy - zgubiłby myślnik i zero wiodące. Tekst stałej długości daje CHAR.
Pytanie 38
Aby strona poprawnie skalowała się na urządzeniach mobilnych, w sekcji <head> należy umieścić:
Poprawna odpowiedź. Znacznik <metaname="viewport"content="width=device-width, initial-scale=1"> mówi przeglądarce mobilnej, że szerokość rzutni (viewport) ma odpowiadać szerokości urządzenia, a strona ma startować w skali 1:1. Bez niego telefon renderuje stronę jako szeroką i pomniejsza ją, przez co media queries nie działają jak należy. Dlatego dla poprawnego skalowania na komórkach niezbędny jest meta viewport.
Pytanie 39
Co należy zrobić, aby strona internetowa była dostępna dla osób z niepełnosprawnościami, zgodnie z wytycznymi WCAG?
A. testować stronę wyłącznie w najpopularniejszej przeglądarce
B. opisywać obrazy tekstem alternatywnym, a kontrolki etykietami
Poprawna odpowiedź
C. używać tylko akapitów, bez nagłówków h1-h6
D. stosować tylko jedną barwę i jej odcienie
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe odpowiedzi nie poprawiają dostępności, a część wręcz jej szkodzi. Rezygnacja z nagłówków h1-h6 odbiera czytnikom ekranu plan dokumentu, przez co trudniej się po nim poruszać. Testowanie tylko w jednej, najpopularniejszej przeglądarce dotyczy zgodności technicznej, a nie potrzeb osób z niepełnosprawnościami. Ograniczenie palety do jednego koloru i jego odcieni nie gwarantuje odpowiedniego kontrastu ani czytelności. Dostępność zapewnia opisywanie obrazów tekstem alternatywnym oraz etykietowanie kontrolek formularza, dlatego to ta odpowiedź jest poprawna.
Pytanie 40
W CSS zapis w postaci
h1::first-letter{color:red;}
spowoduje, że kolor czerwony będzie dotyczył
A. pierwszej linii akapitu
B. pierwszej litery nagłówka drugiego poziomu
C. tekstów nagłówka pierwszego poziomu
Twoja odpowiedź
D. pierwszej litery nagłówka pierwszego poziomu
Poprawna odpowiedź
Niepoprawna odpowiedź. Pierwsza linia paragrafu nie jest poprawną odpowiedzią, ponieważ selektor h1::first-letter odnosi się konkretnie do nagłówków, a nie do paragrafów. W CSS każdy element HTML ma swoje unikalne selektory, a h1 odnosi się do nagłówka pierwszego stopnia. Z kolei tekst nagłówka pierwszego stopnia jest także niepoprawny, gdyż odnosi się do całego tekstu w elemencie h1, a nie tylko do pierwszej litery. Pseudo-element first-letter działa wyłącznie na tej pierwszej literze, a nie na całym nagłówku. Ostatnia odpowiedź, dotycząca pierwszej litery nagłówka drugiego stopnia, jest również błędna, gdyż selektor h1::first-letter nie ma zastosowania do h2, a jedynie do h1. Aby zmienić styl pierwszej litery w nagłówku drugiego stopnia, należałoby użyć selektora h2::first-letter. Różnice te są kluczowe w zrozumieniu jak działają selektory CSS oraz jak przypisane są style do konkretnych elementów w dokumentach HTML.