Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 28 września 2026 02:46
Zakończenie: 28 września 2026 02:46
Egzamin niezdany
Wynik: 0/40 punktów (0,0%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 0% podejść do kwalifikacji INF.03.
Porównanie z 43340 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
W tabeli mieszkańcy zawierającej pola id, imie, nazwisko, ulica, numer, czynsz (wartość całkowita) należy zidentyfikować osoby zamieszkujące ulicę Mickiewicza pod numerami 71, 72, 80, których czynsz jest niższy niż 1000 zł. Jak będzie wyglądać klauzula WHERE w zapytaniu?
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź jest prawidłowa, ponieważ klauzula WHERE w zapytaniu SQL skutecznie filtruje dane zgodnie z wymaganiami. W tym przypadku, użycie operatora AND w połączeniu z IN i warunkiem < 1000 zapewnia, że zwrócone zostaną jedynie te rekordy, które spełniają wszystkie trzy kryteria: ulica musi być 'Mickiewicza', numer musi być jednym z 71, 72 lub 80, a czynsz musi być mniejszy niż 1000 zł. To jest zgodne z dobrą praktyką w SQL, gdzie łączenie warunków z użyciem operatorów logicznych pozwala na precyzyjne określenie zestawu danych, które nas interesują. Przy tak skonstruowanej klauzuli, zapytanie będzie wydajne i zrozumiałe, co jest kluczowe w pracy z bazami danych. Przykładowe zastosowanie to generowanie raportów dotyczących mieszkańców, co może być istotne dla zarządzania nieruchomościami lub analizy rynku wynajmu. Tego typu zapytania są powszechnie używane w aplikacjach webowych i systemach zarządzania danymi, co podkreśla znaczenie umiejętności formułowania precyzyjnych zapytań SQL.
Pytanie 2
Jakiej funkcji w języku PHP należy użyć, aby nawiązać połączenie z bazą danych pod nazwą zwierzaki?
A. $polacz = sql_connect('localhost', 'root', '', 'zwierzaki')
B. $polacz = mysqli_connect('localhost', 'root', '', 'zwierzaki')Poprawna odpowiedź
C. $polacz = db_connect('localhost', 'root', '', 'zwierzaki')
D. $polacz = server_connect('localhost', 'root', '', 'zwierzaki')
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź $polacz = mysqli_connect('localhost', 'root', '', 'zwierzaki'); jest poprawna, ponieważ wykorzystuje funkcję mysqli_connect, która jest dedykowana do nawiązywania połączeń z bazami danych MySQL w języku PHP. Funkcja ta przyjmuje cztery argumenty: adres serwera (w tym przypadku 'localhost'), nazwę użytkownika ('root'), hasło (które jest puste w tym przykładzie) oraz nazwę bazy danych ('zwierzaki'). Użycie mysqli jest zgodne z aktualnymi standardami i dobrą praktyką w programowaniu, ponieważ oferuje szereg usprawnień w porównaniu do starszych metod, takich jak mysql_connect, które zostały usunięte w nowszych wersjach PHP. Mysqli (MySQL Improved) wspiera zarówno programowanie obiektowe, jak i proceduralne, co czyni go bardziej elastycznym. W przypadku nawiązywania połączenia warto również pamiętać o obsłudze błędów, co można osiągnąć poprzez dodatkowe sprawdzenie, czy połączenie zostało nawiązane pomyślnie za pomocą funkcji mysqli_connect_error(). Przykład poprawnego użytkowania w kodzie mógłby wyglądać następująco: $polacz = mysqli_connect('localhost', 'root', '', 'zwierzaki'); if (!$polacz) { die('Connection failed: ' . mysqli_connect_error()); }
Pytanie 3
Wykonanie następującego polecenia PHP umożliwia:
$zapytanie = mysqli_query($db, "UPDATE ...");
A. zmianę struktury bazy
B. pobranie danych z bazy
C. dodanie nowych danych do bazy
D. zmianę danych w baziePoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie PHP mysqli_query z użyciem instrukcji SQL UPDATE służy do modyfikacji danych w bazie danych. Funkcja mysqli_query umożliwia wykonywanie zapytań SQL na połączeniu z bazą danych reprezentowanym przez zmienną $db. Instrukcja UPDATE jest stosowana do aktualizacji istniejących rekordów w tabeli w bazie danych. Przykładowo, jeśli chcesz zaktualizować pole nazwa w tabeli użytkownicy, możesz użyć polecenia UPDATE users SET name='NowaNazwa' WHERE id=1. To podejście umożliwia dynamiczne zarządzanie danymi, co jest kluczowe w aplikacjach internetowych wymagających bieżącej aktualizacji informacji. W praktyce należy pamiętać o dobrych praktykach, takich jak walidacja danych wejściowych i zabezpieczenie przed atakami SQL injection, np. poprzez stosowanie przygotowanych zapytań. Aktualizowanie danych w bazie to jedna z podstawowych operacji CRUD (Create Read Update Delete), które są fundamentem zarządzania danymi w większości aplikacji obsługujących bazy danych. Poprawne użycie tej funkcji wymaga zrozumienia struktury SQL i znajomości specyfiki używanego systemu zarządzania bazą danych.
Pytanie 4
Tabela gory zawiera dane o polskich szczytach oraz górach, w których się one znajdują. Jakie zapytanie należy wykonać, aby zobaczyć Koronę Gór Polskich, czyli najwyższy szczyt w każdym z pasm górskich?
Wyjaśnienie poprawnej odpowiedzi: Wybrana kwerenda SELECT pasmo, szczyt, MAX(wysokosc) FROM gory GROUP BY pasmo; jest poprawna, ponieważ umożliwia uzyskanie najwyższego szczytu w każdym pasmie górskim. W tym przypadku użycie funkcji agregującej MAX pozwala na zidentyfikowanie maksymalnej wartości kolumny 'wysokosc' dla każdej grupy utworzonej przez 'pasmo'. Podczas stosowania klauzuli GROUP BY, dane są dzielone na różne grupy na podstawie wartości w kolumnie 'pasmo', a następnie dla każdej grupy obliczana jest maksymalna wysokość szczytu. Taki sposób zorganizowania danych jest zgodny z najlepszymi praktykami SQL, które rekomendują wykorzystanie funkcji agregujących w połączeniu z grupowaniem, aby uzyskać zwięzłe i precyzyjne wyniki. Przykładowo, po wykonaniu tej kwerendy, otrzymamy listę pasm górskich wraz z najwyższymi szczytami, co jest niezbędne do analizy geograficznej i turystycznej.
Pytanie 5
Wskaż najefektywniejszą metodę wyczyszczenia wszystkich danych z tabeli adresy, nie wpływając na jej strukturę
A.
DROPTABLEadresy;
B.
TRUNCATETABLEadresy;
Poprawna odpowiedź
C.
DELETETABLEadresy;
D.
DELETE*FROMadresy;
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: TRUNCATE TABLE adresy; jest najszybszym sposobem na usunięcie wszystkich rekordów z tabeli bez usuwania jej struktury. Operacja TRUNCATE działa na poziomie strony, co oznacza, że nie przetwarza pojedynczych wierszy, jak ma to miejsce w przypadku DELETE. Dzięki temu, TRUNCATE jest znacznie wydajniejszy, szczególnie w przypadku dużych zbiorów danych. W praktyce, użycie TRUNCATE TABLE jest zalecane, gdy chcemy szybko oczyścić tabelę z danych, a następnie wprowadzić nowe rekordy. Warto jednak pamiętać, że TRUNCATE nie wywołuje kaskadowych usunięć w tabelach powiązanych z kluczami obcymi, co może być istotne w projektowaniu bazy danych. Użycie TRUNCATE może również przywrócić licznik identyfikatorów (np. AUTO_INCREMENT w MySQL) do wartości początkowej, co jest ważnym aspektem, jeśli zależy nam na tym, by nowe dane zaczynały się od określonej wartości. Praktyka wykorzystania TRUNCATE powinna być jednak stosowana ostrożnie, szczególnie w kontekście transakcji, ponieważ operacja ta nie jest odwracalna w przypadku dużych zbiorów danych, co skontrastować należy z DELETE, które można wykorzystać w ramach transakcji i przywrócić dane, jeśli zajdzie taka potrzeba. Dlatego, TRUNCATE TABLE jest zalecaną metodą w odpowiednich scenariuszach, ale jej użycie wymaga pełnego zrozumienia kontekstu bazy danych oraz powiązań między tabelami.
Pytanie 6
Jak określa się podzbiór strukturalnego języka zapytań, który dotyczy formułowania zapytań do bazy danych przy użyciu polecenia SELECT?
A. SQL DDL (ang. Data Definition Language)
B. SQL DCL (ang. Data Control Language)
C. SQL DML (ang. Data Manipulation Language)
D. SQL DQL (ang. Data Query Language)Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: SQL DQL (Data Query Language) to podzbiór języka SQL, który koncentruje się na formułowaniu zapytań do baz danych w celu pobierania danych. Jego głównym elementem jest polecenie SELECT, które umożliwia użytkownikom wybieranie specyficznych danych z tabel oraz ich przetwarzanie w różnorodny sposób, w tym filtrowanie, sortowanie i łączenie danych z różnych źródeł. Przykładem zastosowania DQL jest zapytanie typu 'SELECT * FROM employees WHERE department = 'Sales';', które zwraca wszystkich pracowników z działu sprzedaży. DQL jest kluczowym elementem w analizie danych oraz raportowaniu, co sprawia, że znajomość tego podzbioru jest niezbędna dla analityków danych oraz programistów. Zrozumienie i umiejętność korzystania z DQL pozwala na efektywne wykorzystanie baz danych w praktycznych zastosowaniach biznesowych, takich jak generowanie raportów, analiza trendów oraz wspieranie decyzji strategicznych. Standardy SQL określają dobre praktyki związane z tworzeniem zapytań, co pozwala na zachowanie wydajności i czytelności kodu.
Pytanie 7
Podczas zapisywania hasła użytkownika w serwisie WWW, na przykład w bankowości internetowej, aby zabezpieczyć je przed odczytaniem, zazwyczaj stosuje się funkcję
A. kluczaPoprawna odpowiedź
B. abstrakcyjnych
C. cyklometrycznych
D. mieszających
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Użycie klucza do zabezpieczania haseł użytkowników jest standardową praktyką w dziedzinie bezpieczeństwa informatycznego. Klucz, który może być generowany na podstawie hasła lub stanowić odrębny, losowy ciąg znaków, jest stosowany w procesach szyfrowania. Dzięki temu, nawet jeśli dane hasło zostanie przechwycone, bez klucza nie jest możliwe jego odczytanie. W praktyce powszechnie wykorzystuje się algorytmy kryptograficzne, takie jak AES (Advanced Encryption Standard), które wymagają kluczy do szyfrowania i deszyfrowania informacji. W kontekście hasła użytkownika, stosuje się także techniki takie jak hashowanie, gdzie dane są przekształcane w unikalny skrót. Przykładem jest funkcja bcrypt, która nie tylko przechowuje hasło, ale i dodaje sól, co dodatkowo utrudnia ataki słownikowe. Takie podejście do zarządzania hasłami jest zgodne z najlepszymi praktykami, jak OWASP Password Storage Cheat Sheet, która zaleca unikanie przechowywania haseł w formie czystego tekstu oraz stosowanie silnych algorytmów kryptograficznych.
Pytanie 8
Dostępna jest tabela pracownicy zawierająca pola id, nazwisko, imię oraz wynagrodzenie. Kolumnę wynagrodzenie można usunąć przy użyciu następującej instrukcji
A.
DROPTABLEpracownicyDELETECOLUMNwynagrodzenie
B.
ALTERTABLEpracownicyDELETEwynagrodzenie
C.
ALTERTABLEpracownicyDROPCOLUMNwynagrodzenie
Poprawna odpowiedź
D.
ALTERTABLEpracownicyDELETECOLUMNwynagrodzenie
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W prawidłowej odpowiedzi powinno być 'ALTER TABLE pracownicy DROP COLUMN wynagrodzenie;'. To polecenie ALTER TABLE to coś, co używamy, żeby zmodyfikować to, co już mamy w tabeli w bazie danych. Jak chcemy usunąć kolumnę, to kluczowe jest użycie DROP COLUMN, bo to dokładnie mówi, co chcemy zrobić – usunąć konkretną kolumnę. W praktyce często tak usuwamy zbędne dane, kiedy kolumna już nie jest potrzebna. Usunięcie kolumny upraszcza strukturę bazy danych i może zwiększyć wydajność, bo mamy mniej danych do przechowywania. Fajnie jest też pamiętać, żeby zanim coś zmienimy, zrobić kopię zapasową tabeli – nigdy nie wiadomo, kiedy mogą się przydać stare dane. No i jak pracujesz z dużą bazą danych, to najlepiej robić takie rzeczy w nocy czy w weekend, żeby nie wpływać na działanie systemu w godzinach szczytu.
Pytanie 9
W poniższym zapytaniu SQL znak „*” wskazuje, że w wyniku tego zapytania zostaną zwrócone:
SELECT*FROMmieszkancyWHEREimie='Anna';
A. wszystkie rekordy z tabeli mieszkańcy będą widoczne
B. zostaną wyświetlone wszystkie kolumny tabeli mieszkańcyPoprawna odpowiedź
C. zostanie pokazane pole zatytułowane „*” (gwiazdka)
D. warunek dotyczący imienia zostanie pominięty
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W zapytaniu SQL, operator '*' jest używany do oznaczania wszystkich kolumn w tabeli. W kontekście zapytania 'SELECT * FROM mieszkancy WHERE imie = 'Anna';', zapytanie to zwraca wszystkie kolumny z tabeli 'mieszkancy', które spełniają warunek określony w klauzuli WHERE, czyli te rekordy, w których pole 'imie' ma wartość 'Anna'. Przykład zastosowania: jeśli tabela 'mieszkancy' zawiera kolumny takie jak 'id', 'imie', 'nazwisko', 'adres', to wynik zapytania będzie zawierał wszystkie te kolumny dla osób o imieniu 'Anna'. Używanie '*' w zapytaniach jest powszechnie stosowaną praktyką, ale w dobrych praktykach programistycznych zaleca się określanie, które kolumny są faktycznie potrzebne w wyniku, aby zoptymalizować zapytania i zmniejszyć ilość przesyłanych danych, szczególnie w większych bazach danych.
Pytanie 10
Aby z tabeli Pracownicy wybrać tylko nazwiska kończące się na literę „i”, można zastosować następującą kwerendę SQL
Wyjaśnienie poprawnej odpowiedzi: Prawidłowa kwerenda SQL do wyszukania nazwisk pracowników, których ostatnią literą jest 'i', to 'SELECT nazwisko FROM Pracownicy WHERE nazwisko LIKE "%i";'. Operator LIKE w SQL jest używany do wyszukiwania wzorców w danych tekstowych. W tym przypadku symbol '%' przed literą 'i' oznacza, że przed 'i' może występować dowolna liczba znaków (w tym zero), co umożliwia znalezienie wszystkich nazwisk kończących się na tę literę. Przykładowe nazwiska, które mogą być zwrócone przez tę kwerendę to 'Kowalski', 'Nowak', czy 'Wiśniewski'. Zgodnie z standardem SQL, użycie podwójnych cudzysłowów dla wzorca jest właściwe w kontekście baz danych, jednak w wielu systemach baz danych, w tym MySQL, częściej stosuje się pojedyncze cudzysłowy. Warto także zauważyć, że technika ta jest przydatna przy pracy z bazami danych, gdyż umożliwia elastyczne wyszukiwanie informacji oraz jest szczególnie cenne w aplikacjach wymagających filtrowania danych według specyficznych kryteriów.
Pytanie 11
Jakie zadanie ma funkcja PHP o nazwie mysql_select_db()?
A. wyznaczyć bazę, z której będą pozyskiwane danePoprawna odpowiedź
B. nawiązać połączenie między bazą danych a serwerem SQL
C. uzyskać dane z bazy danych na podstawie zapytania
D. wyznaczyć tabelę, z której będą pozyskiwane dane
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja <span>mysql_select_db()</span> w PHP jest naprawdę ważna, bo pozwala nam wybrać konkretną bazę danych, z której chcemy czerpać informacje. Gdy już nawiążemy połączenie z serwerem MySQL przez <span>mysql_connect()</span>, to pierwsze co powinniśmy zrobić, to wybrać bazę danych, na której będziemy działać. To ważny krok, bo w każdej bazie może być sporo tabel, a nasze zapytania muszą iść do odpowiedniej. Na przykład, jeśli mamy bazę danych 'sklep' i potrzebujemy tabeli 'produkty', to musimy wywołać <span>mysql_select_db('sklep')</span>. Dzięki temu MySQL wie, gdzie szukać naszych tabel i informacji. Z mojego doświadczenia, dobrze jest upewnić się, że wybraliśmy odpowiednią bazę danych przed wykonaniem jakichkolwiek zapytań, bo wtedy unikamy różnych problemów z kontekstem danych.
Pytanie 12
Jeden klient może mieć wiele zamówień, a każde zamówienie należy do jednego klienta. Jaka to relacja?
A.
n..1
B.
1..n
Poprawna odpowiedź
C.
n..n
D.
1..1
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Jeden klient i wiele jego zamówień, przy czym każde zamówienie należy do JEDNEGO klienta - to klasyczna relacja jeden-do-wielu, zapisywana 1..n. W bazie realizuje ją klucz obcy klient_id w tabeli zamówień. Zapamiętaj: „jeden ma wiele, każde z wielu wraca do jednego” = 1..n.
Pytanie 13
Zamieszczone zapytanie SQL przyznaje prawo SELECT:
A. do wszystkich tabel w bazie hurtowniaPoprawna odpowiedź
B. do wszystkich kolumn w tabeli hurtownia
C. dla użytkownika root na serwerze sprzedawca
D. dla użytkownika root na serwerze localhost
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie GRANT SELECT ON hurtownia.* TO sprzedawca@localhost; nadaje prawo SELECT dla wszystkich tabel w bazie danych o nazwie hurtownia. Symbol * po nazwie bazy oznacza, że uprawnienia dotyczą wszystkich tabel w tej bazie. Jest to popularny sposób przyznawania uprawnień w systemach zarządzania bazami danych takich jak MySQL. Prawidłowe zarządzanie uprawnieniami jest kluczowe w zapewnieniu bezpieczeństwa i efektywności pracy z bazami danych. Przyznanie prawa SELECT oznacza, że użytkownik sprzedawca może odczytywać dane, co jest często stosowane w przypadku użytkowników, którzy potrzebują dostępu do raportów lub analiz. Zgodnie z dobrymi praktykami warto przyznawać minimalny poziom uprawnień niezbędny do wykonywania określonych zadań co chroni przed nieautoryzowanym dostępem lub modyfikacją danych. Przyznając uprawnienia warto także monitorować logi dostępu w celu wykrywania potencjalnych nieprawidłowości. Również istotne jest aby użytkownik localhost miał dostęp tylko z lokalnego serwera co ogranicza ryzyko zdalnych ataków.
Pytanie 14
W bazie danych wykonano następujące polecenia dotyczące uprawnień użytkownika adam. Po ich realizacji użytkownik adam uzyska uprawnienia do
GRANT ALL PRIVILEGES ON klienci TO adam REVOKE SELECT, INSERT, UPDATE ON klienci FROM adam
A. modyfikowania danych i przeglądania tabeli klienci
B. przeglądania tabeli klienci oraz dodawania do niej sektorów
C. usuwania tabeli lub jej rekordówPoprawna odpowiedź
D. tworzenia tabeli klienci oraz modyfikowania w niej danych
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Prawidłowa odpowiedź dotycząca usunięcia tabeli lub jej rekordów wynika z analizy poleceń SQL które zostały wykonane na użytkowniku adam. Instrukcja GRANT ALL PRIVILEGES zapewnia użytkownikowi wszystkie dostępne uprawnienia do tabeli klienci w tym możliwość usunięcia zarówno całej tabeli jak i jej rekordów. Jednakże w dalszej kolejności polecenie REVOKE SELECT INSERT UPDATE ogranicza te konkretne uprawnienia. Pozostawia to użytkownikowi adam pełne prawo do korzystania z polecenia DELETE które umożliwia usunięcie poszczególnych rekordów oraz DROP które pozwala usunąć całą tabelę. Jest to kluczowe w zarządzaniu bazą danych zwłaszcza w kontekście zapewnienia integralności i bezpieczeństwa danych. W praktyce administratorzy baz danych muszą umiejętnie zarządzać uprawnieniami aby zapewnić odpowiedni poziom bezpieczeństwa oraz kontrolę dostępu zgodnie z najlepszymi praktykami branżowymi. Dzięki temu można uniknąć nieautoryzowanego dostępu do wrażliwych danych oraz przypadkowego usunięcia ważnych informacji
Pytanie 15
Jakie są właściwe etapy tworzenia bazy danych?
A. Zdefiniowanie celu, stworzenie tabel, utworzenie relacji, normalizacjaPoprawna odpowiedź
B. Zdefiniowanie celu, normalizacja, utworzenie relacji, stworzenie tabel
C. Zdefiniowanie celu, normalizacja, stworzenie tabel, utworzenie relacji
D. Zdefiniowanie celu, utworzenie relacji, stworzenie tabel, normalizacja
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W procesie tworzenia bazy danych kluczowym pierwszym krokiem jest określenie celu, który pozwala zrozumieć, jakie dane będą gromadzone oraz jakie operacje będą na nich wykonywane. Następnie przystępuje się do stworzenia tabel, które stanowią fundamentalne elementy bazy danych. Każda tabela powinna odpowiadać określonym kategoriom danych, a ich struktura powinna być dobrze przemyślana, aby umożliwić efektywne przechowywanie, zarządzanie oraz odczytywanie informacji. Po utworzeniu tabel ważne jest, aby zdefiniować relacje między nimi, co umożliwia integrację danych oraz ich logiczne powiązanie. Na końcu procesu następuje normalizacja, która ma na celu eliminację redundancji danych oraz zwiększenie integralności bazy, co przekłada się na jej wydajność. Przykładem może być stworzenie bazy danych dla systemu zarządzania uczelnią, gdzie tabele odpowiadają za studentów, kursy i wykładowców. Właściwe zdefiniowanie relacji pomoże w zrozumieniu, którzy studenci uczą się na jakich kursach, a normalizacja zabezpieczy przed powielaniem danych.
Pytanie 16
Wartość atrybutu w tabeli, który pełni rolę klucza głównego
A. nigdy nie jest innego typu niż numeryczny
B. musi być unikalnaPoprawna odpowiedź
C. może przyjmować wartość null (NULL)
D. jest używana do szyfrowania zawartości tabeli
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Klucz podstawowy w bazach danych to coś, co naprawdę musi być unikalne, żeby każda informacja w tabeli była dobrze zidentyfikowana. Przykładowo, w tabeli 'Klienci' mamy kolumnę 'ID_klienta'. To jest dobry klucz podstawowy, bo każdy klient musi mieć swój własny numer, żeby nie było sytuacji, gdzie dwóch klientów ma ten sam identyfikator. Gdyby klucz podstawowy był taki sam dla różnych rekordów, mogłoby to wywołać spore zamieszanie przy aktualizacjach czy usuwaniu danych. Warto też pamiętać, że są takie rzeczy jak indeksy, które mogą pomóc w zapewnieniu, że klucz podstawowy jest unikalny i przyspiesza wyszukiwanie danych. Można użyć kluczy naturalnych, które mają sens w kontekście danych, albo kluczy syntetycznych, które system tworzy sam, jak na przykład GUID-y. Z mojego doświadczenia, to znajomość tych zasad naprawdę pomaga w lepszym projektowaniu baz danych.
Pytanie 17
W pokazanym fragmencie zapytania w języku SQL, polecenie SELECT ma na celu uzyskanie wyników z komendy SELECT COUNT(wartosc) FROM....?
A. średnią wartości w kolumnie wartosc
B. sumę wartości w kolumnie wartosc
C. liczbę rekordówPoprawna odpowiedź
D. średnią wartości w tabeli
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W kontekście zapytania SQL, komenda SELECT COUNT(wartosc) ma na celu zwrócenie liczby wierszy w danej tabeli, które spełniają określone kryteria. Funkcja COUNT jest jedną z agregujących funkcji zapytań SQL, która zlicza liczbę niepustych wartości w kolumnie. Jeżeli argumentem funkcji jest konkretna kolumna, to zostaną zliczone tylko te wiersze, w których ta kolumna zawiera wartości, natomiast jeżeli użyjemy COUNT(*) bez podawania kolumny, zliczymy wszystkie wiersze tabeli, niezależnie od tego, czy kolumny zawierają wartości. Przykład praktyczny: jeśli mamy tabelę 'Zamówienia' i chcemy zliczyć liczbę dokonanych zamówień, można użyć zapytania SELECT COUNT(*) FROM Zamówienia; co zwróci całkowitą liczbę zamówień w tabeli. Istotne jest, aby zrozumieć, że COUNT zwraca liczbę wierszy, a nie sumę, średnią lub inne statystyki. W standardzie SQL nie ma specyfikacji, która by zmieniała tę funkcjonalność, co czyni ją uniwersalną w różnych bazach danych, takich jak MySQL, PostgreSQL, czy SQL Server.
Pytanie 18
Która z funkcji agregujących dostępnych w SQL służy do obliczania średniej z wartości znajdujących się w określonej kolumnie?
A. AVGPoprawna odpowiedź
B. MIN
C. COUNT
D. SUM
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja AVG w języku SQL jest wbudowaną funkcją agregującą, która służy do obliczania średniej wartości we wskazanej kolumnie. Oblicza ona średnią arytmetyczną z wartości liczbowych w danej kolumnie, co jest niezwykle przydatne w analizie danych. Na przykład, jeśli mamy tabelę z wynikami sprzedaży, możemy użyć zapytania SQL: SELECT AVG(sprzedaż) FROM tabela_sprzedaży; aby uzyskać średnią sprzedaż. Dobrą praktyką jest stosowanie tej funkcji w połączeniu z klauzulą GROUP BY, co pozwala na obliczenie średnich wartości w różnych grupach danych, na przykład średnia sprzedaż według kategorii produktowej. Przy stosowaniu funkcji AVG warto pamiętać, że ignoruje ona wartości NULL, co wpływa na wynik obliczeń. W kontekście analizy danych w SQL, znajomość takich funkcji jak AVG jest kluczowa dla efektywnego przetwarzania i analizy informacji, co stanowi fundament dobrego zarządzania danymi.
Pytanie 19
Kod
SELECT imie, pesel, wiek FROM dane WHERE wiek IN (18,30)
wybiera
A. imiona, numery PESEL oraz wiek osób mieszczących się w przedziale od 18 do 30 lat
B. imiona, numery PESEL oraz wiek osób w wieku dokładnie 18 lub 30 latPoprawna odpowiedź
C. imiona, numery PESEL oraz wiek osób, które mają więcej niż 30 lat
D. imiona, nazwiska oraz numery PESEL osób, które mają mniej niż 18 lat
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź jest prawidłowa, ponieważ zapytanie SQL `SELECT imie, pesel, wiek FROM dane WHERE wiek IN (18,30)` w sposób precyzyjny selekcjonuje dane tylko dla osób, których wiek wynosi dokładnie 18 lub 30 lat. Użycie operatora `IN` pozwala na wskazanie konkretnych wartości, które nas interesują, w tym przypadku są to dwa liczby: 18 i 30. Takie podejście jest zgodne z najlepszymi praktykami w tworzeniu zapytań SQL, gdyż umożliwia efektywne filtrowanie danych i minimalizowanie obciążenia bazy danych poprzez ograniczenie ilości przetwarzanych rekordów. W kontekście aplikacji, które wymagają analizy danych demograficznych, na przykład w systemach monitorujących wiek klientów, tego typu zapytania są niezwykle przydatne. Pozwalają na szybkie wyciąganie informacji potrzebnych do podejmowania decyzji, jak na przykład dostosowywanie ofert marketingowych do określonych grup wiekowych. Przykładowo, w instytucji finansowej analiza wieku klientów może być kluczowa w tworzeniu ofert produktów kredytowych skierowanych do osób młodych oraz do tych w średnim wieku, co pozwala na lepsze zrozumienie i zaspokojenie ich potrzeb.
Pytanie 20
Które zapytanie wybierze z tabeli klient nazwiska zaczynające się na literę „Z” (o dowolnej długości)?
A.
SELECTnazwiskoFROMklientWHEREnazwiskoLIKE'Z%';
Poprawna odpowiedź
B.
SELECTnazwiskoFROMklientWHEREnazwiskoLIKE'Z_%';
C.
SELECTnazwiskoFROMklientWHEREnazwisko='Z_?';
D.
SELECTnazwiskoFROMklientWHEREnazwisko='Z?';
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wyszukiwanie po fragmencie tekstu wymaga operatora LIKE i znaków wieloznacznych. Tu potrzebujemy nazwisk zaczynających się na „Z” o dowolnej dalszej części, czyli wzorca 'Z%', gdzie % zastępuje dowolny ciąg (także pusty): SELECTnazwiskoFROMklientWHEREnazwiskoLIKE'Z%';. Dlatego ta kwerenda jest poprawna.
Pytanie 21
W jakiej strukturze zapisywane są dane w relacyjnych bazach danych?
A. w wektorach
B. w tabelachPoprawna odpowiedź
C. w kolejkach
D. w listach
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W relacyjnych bazach danych dane przechowuje się w TABELACH - zbudowanych z wierszy (rekordów) i kolumn (atrybutów), powiązanych ze sobą przez klucze. To fundament modelu relacyjnego i języka SQL. Zapamiętaj: relacyjna baza = dane w powiązanych tabelach.
Pytanie 22
Po zrealizowaniu polecenia użytkownik Jacek będzie miał możliwość
B. modyfikować strukturę tabeli oraz dodawać nowe dane
C. przeglądać dane w tabeli i wstawiać nowe danePoprawna odpowiedź
D. usuwać rekordy z tabeli i przeglądać informacje
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie GRANT SELECT, INSERT ON baza1.mojaTabela TO 'Jacek'@'localhost'; przyznaje użytkownikowi Jacek uprawnienia do przeglądania danych (SELECT) oraz wstawiania nowych danych (INSERT) do tabeli mojaTabela w bazie danych baza1. To oznacza, że Jacek nie ma możliwości usuwania tabeli ani zmiany jej struktury, co jest zarezerwowane dla uprawnień takich jak ALTER czy DROP. Zastosowanie tych uprawnień jest kluczowe w kontekście bezpieczeństwa i zarządzania danymi, ponieważ pozwala na kontrolowanie, kto może wykonywać określone operacje w bazie danych. Przykładem praktycznego zastosowania może być sytuacja, w której zespół programistów musi umożliwić pracownikom działu sprzedaży dostęp do danych klientów w tabeli, ale jednocześnie chce zapobiec przypadkowemu usunięciu lub modyfikacji struktury tabeli. W ten sposób, przyznając tylko uprawnienia SELECT i INSERT, administracja bazy danych może zapewnić odpowiedni poziom kontroli nad danymi, co jest zgodne z najlepszymi praktykami w zakresie zarządzania danymi i zabezpieczeń.
Pytanie 23
Tabela odlotów zawiera dane przedstawione na ilustracji. Wykonanie zapytania SQL spowoduje zwrócenie informacji:
SELECT id FROM odloty WHERE samoloty_id > 2 AND kierunek LIKE '_a%';
id
samoloty_id
nr_rejsu
kierunek
czas
dzien
status_lotu
1
1
FR1646
Neapol
09:20:00
2019-07-25
wystartowal
2
1
FR1327
ALICANTE
09:10:00
2019-07-25
Opóźniony 10 min
3
2
W63425
Warszawa
09:45:00
2019-07-25
odprawa
4
3
LX5647
Londyn LT
10:03:00
2019-07-25
odprawa
5
3
LX5673
Malta
10:06:00
2019-07-25
opoznienie 20 min
6
3
LX5622
Wieden
10:13:00
2019-07-25
7
4
LH9821
Berlin
10:16:00
2019-07-25
8
4
LH9888
Hamburg
10:19:00
2019-07-25
A. 5; 8Poprawna odpowiedź
B. 4; 5; 6; 7; 8
C. zbiór pusty
D. 3; 5; 8
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Zapytanie SQL SELECT id FROM odloty WHERE samoloty_id > 2 AND kierunek LIKE '_a%' używa dwóch warunków w klauzuli WHERE. Pierwszy warunek samoloty_id > 2 filtruje rekordy, których pole samoloty_id jest większe niż 2. Drugi warunek kierunek LIKE '_a%' szuka w kolumnie kierunek ciągów znaków, które mają literę 'a' jako drugi znak, co jest osiągane przez użycie znaku podkreślenia '_' jako symbolu jednego dowolnego znaku. Operator LIKE pozwala na dopasowanie wzorca z użyciem symboli wieloznacznych, co jest przydatne w sytuacjach, gdy potrzebujemy znaleźć dane na podstawie częściowego dopasowania tekstu. Zastosowanie wzorca '_a%' oznacza, że szukamy tylko takich wartości, które mają co najmniej dwa znaki, a drugim znakiem musi być 'a'. W tabeli odloty, rekordy spełniające oba te warunki to rekordy 5 i 8, ponieważ ich pole samoloty_id jest odpowiednio 3 i 4 (czyli większe niż 2), a pole kierunek to odpowiednio Malta i Hamburg, które pasują do wzorca '_a%' gdzie 'M' i 'H' to odpowiednio pierwszy znak. Praktyczne zastosowanie takich zapytań SQL pozwala na efektywne przeszukiwanie baz danych pod kątem specyficznych potrzeb użytkownika, co ma kluczowe znaczenie w zarządzaniu informacjami w dużych systemach.
Pytanie 24
Jakie słowo kluczowe w SQL należy zastosować, aby usunąć powtarzające się rekordy?
A. GROUP BY
B. DISTINCTPoprawna odpowiedź
C. ORDER BY
D. LIKE
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Słowo kluczowe DISTINCT jest używane w języku SQL do eliminowania duplikatów z wyników zapytań. Gdy zastosujemy DISTINCT w zapytaniu SELECT, baza danych zwróci tylko unikalne wiersze, co jest niezwykle przydatne, gdy chcemy uzyskać listę bez powtarzających się wartości. Na przykład, jeśli mamy tabelę 'klienci' z kolumną 'miasto', a nasze zapytanie brzmi: 'SELECT DISTINCT miasto FROM klienci;', wówczas wynik będzie zawierał tylko unikalne nazwy miast, eliminując wszelkie duplikaty. To podejście nie tylko upraszcza analizę danych, ale również poprawia wydajność zapytań w wielu przypadkach, zwłaszcza gdy przetwarzamy duże zbiory danych. Użycie DISTINCT jest zgodne z najlepszymi praktykami w zakresie optymalizacji baz danych, ponieważ pozwala zapobiegać przypadkowemu wprowadzaniu niepotrzebnych danych podczas analizy. Warto także zauważyć, że DISTINCT działa na całym zestawie kolumn w zapytaniu. Oznacza to, że jeśli wybierzemy wiele kolumn z DISTINCT, unikalne wiersze będą określane na podstawie kombinacji wartości we wszystkich tych kolumnach, co daje jeszcze większą kontrolę nad wynikami zapytania.
Pytanie 25
Jakie tabele będą weryfikowane przez podane polecenie?
CHECK TABLEpracownicyCHANGED;
A. Tabele, które zmieniły się w bieżącej sesji.
B. Jedynie tabele referencyjne.
C. Tabele, które uległy zmianie od ostatniego sprawdzenia lub nie zostały prawidłowo zamknięte.Poprawna odpowiedź
D. Tylko tabele, które nie zostały prawidłowo zamknięte.
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź, że polecenie CHECK TABLE sprawdzi tabele, które zmieniły się od ostatniej kontroli lub nie zostały poprawnie zamknięte, jest poprawna. Polecenie to jest wykorzystywane w systemach zarządzania bazami danych, takich jak MySQL, do diagnozowania i naprawy problemów związanych z integralnością danych. Kiedy tabele są zmieniane lub nie zostały poprawnie zamknięte, mogą wystąpić uszkodzenia, które mogą prowadzić do błędów przy odczycie lub zapisie danych. W praktyce, administratorzy baz danych regularnie wykonują polecenie CHECK TABLE, aby upewnić się, że struktura tabeli jest nienaruszona i że system operacyjny poprawnie zarządza danymi. Użycie CHECK TABLE w kontekście tabel, które zmieniły się od ostatniej kontroli, jest kluczowe, gdyż pozwala na szybką lokalizację problemów. Warto również zauważyć, że w przypadku dużych baz danych wykonanie tego polecenia może być czasochłonne, dlatego dobrze jest zintegrować jego użycie z harmonogramem regularnych kontroli integralności danych, co jest zgodne z najlepszymi praktykami w zarządzaniu bazami danych.
Pytanie 26
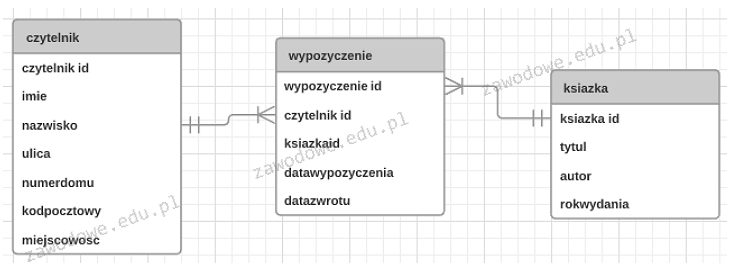
W zaprezentowanym schemacie bazy danych o nazwie biblioteka, składniki: czytelnik, wypożyczenie oraz książka są
A. polami
B. atrybutami
C. encjamiPoprawna odpowiedź
D. krotkami
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W modelowaniu relacyjnych baz danych encje są kluczowymi elementami, które reprezentują obiekty rzeczywistego świata, wokół których zbudowana jest struktura bazy. W przedstawionym diagramie bazy danych biblioteki encjami są czytelnik wypozyczenie i ksiazka. Każda z tych encji posiada swoje własne atrybuty, które opisują jej właściwości na przykład encja czytelnik ma takie atrybuty jak imię nazwisko i adres. W kontekście praktycznym encje są odwzorowywane na tabele w bazie danych gdzie wiersze tabeli reprezentują poszczególne instancje encji a kolumny reprezentują atrybuty. Rozumienie różnicy między encjami a atrybutami jest istotne dla efektywnego projektowania baz danych zgodnie z dobrymi praktykami takimi jak normalizacja, która pomaga unikać redundancji danych. W związku z tym prawidłowe zrozumienie i identyfikacja encji ma kluczowe znaczenie w budowaniu skalowalnych i wydajnych baz danych. W praktyce analizy danych encje są podstawą do tworzenia modeli relacyjnych które umożliwiają generowanie raportów i analizowanie danych w sposób zorganizowany i logiczny
Pytanie 27
Użytkownik Jan będzie miał możliwość realizacji
GRANTALLPRIVILEGESONdane.*TO'Jan'@'localhost';
A. tylko operacje manipulacji danymi oraz zmienić jedynie swoje uprawnienia
B. wszystkie operacje na tabelach bazy dane oraz przekazywać prawa innym użytkownikom
C. wyłącznie operacje CREATE, ALTER, DROP na tabelach w bazie dane
D. wszystkie operacje na tabelach w bazie danePoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź jest prawidłowa, ponieważ polecenie GRANT ALL PRIVILEGES ON dane.* TO 'Jan'@'localhost'; przyznaje użytkownikowi Jan wszelkie uprawnienia na wszystkich tabelach w bazie danych o nazwie 'dane'. Oznacza to, że Jan może wykonywać wszystkie operacje, takie jak SELECT, INSERT, UPDATE, DELETE, CREATE, ALTER, DROP i inne, które są związane z zarządzaniem danymi oraz strukturą bazy. W praktyce oznacza to, że Jan ma pełną kontrolę nad bazą danych, co może być przydatne w scenariuszach, gdzie administratorzy chcą umożliwić użytkownikom elastyczność w zarządzaniu danymi. Warto jednak pamiętać, że przyznawanie ALL PRIVILEGES powinno być stosowane ostrożnie, aby uniknąć nieautoryzowanego dostępu do informacji. Dobrym rozwiązaniem jest stosowanie polityki minimalnych uprawnień, która ogranicza możliwości użytkowników do tylko tych, które są niezbędne do ich codziennych obowiązków.
Pytanie 28
Aby zwiększyć wydajność operacji na bazie danych dla pól często używanych w wyszukiwaniu lub sortowaniu, należy:
A. utworzyć indeksPoprawna odpowiedź
B. utworzyć osobną tabelę na te pola
C. dodać klucz obcy
D. dodać więzy integralności
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Indeks to dodatkowa struktura bazy, która działa jak skorowidz w książce: zamiast przeglądać cały zbiór wierszy, baza sięga do uporządkowanego spisu i szybko odnajduje szukane wartości. Dlatego dla kolumn często występujących w warunkach WHERE, sortowaniu czy złączeniach zakłada się indeksy - przyspieszają odczyt nawet wielokrotnie. Trzeba pamiętać, że indeksy nieco spowalniają zapis i zajmują miejsce, więc zakłada się je świadomie, na właściwych polach. Do poprawy wydajności wyszukiwania służy właśnie indeks.
Pytanie 29
Obiektem w bazie danych, który wykorzystywany jest do podsumowywania, prezentacji oraz drukowania danych, jest
A. formularz
B. zapytanie
C. zestawienie
D. raportPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Raport jest obiektem baz danych, który służy do podsumowywania, wyświetlania oraz wydruków danych. Jego główną funkcją jest agregacja i prezentacja informacji w sposób przystępny dla użytkownika. Raporty mogą być wykorzystywane do analizy danych, prezentacji wyników oraz podejmowania decyzji biznesowych. Przykładem zastosowania raportu może być generowanie miesięcznego raportu sprzedaży, który zawiera szczegółowe informacje o przychodach, kosztach oraz zyskach w danym okresie. Z perspektywy dobrych praktyk, raporty powinny być projektowane w taki sposób, aby były czytelne i zrozumiałe, a ich struktura powinna być zgodna z wymaganiami użytkowników. W kontekście standardów, raporty mogą być również generowane automatycznie przy użyciu narzędzi business intelligence, co pozwala na zwiększenie efektywności i dokładności analiz. Dobrze zdefiniowane raporty przyczyniają się do lepszego zrozumienia zbiorów danych oraz wspierają procesy decyzyjne w organizacji.
Pytanie 30
W bazie danych produkt znajdują się artykuły wyprodukowane po 2000 roku, zawierające pola nazwa oraz rok_produkcji. Klauzula SQL wyświetli zestawienie artykułów wyprodukowanych
SELECT * FROM `produkt` WHERE SUBSTR(rok_produkcji, 3, 2) = 17;
A. przed rokiem 2017
B. po roku 2017
C. w roku 2017Poprawna odpowiedź
D. w latach innych niż 2017
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W tej klauzuli SQL, co widzimy, filtrujemy dane z tabeli produkt. Użycie funkcji SUBSTR(rok_produkcji, 2) pozwala nam wyciągnąć dwie ostatnie cyfry z roku produkcji. To jest super przydatne, bo dzięki temu możemy uzyskać rok w formacie dwu-cyfrowym. Jak porównujemy to z 17, to znaczy, że szukamy rekordów, których rok produkcji kończy się na 17, co odpowiada pełnemu roku, czyli 2017. Takie podejście ma sens, gdy chcemy szybko przeszukać dane dotyczące konkretnego roku, nie bawiąc się w cały numer. Umiejętność korzystania z funkcji tekstowych w SQL, jak SUBSTR, jest naprawdę istotna w analizie danych, szczególnie gdy struktura tabeli nie pozwala na łatwe użycie wartości liczbowych. Ludzie pracujący z bazami danych powinni znać te sztuczki, bo to pozwala na lepsze dopasowanie filtracji danych do potrzeb. Fajne jest też dokumentowanie takich zapytań, żeby inni mogli zrozumieć, o co chodzi.
Pytanie 31
W języku MySQL należy wykorzystać polecenie REVOKE, aby użytkownikowi anna cofnąć możliwość wprowadzania zmian wyłącznie w definicji struktury bazy danych. Polecenie, które służy do odebrania tych uprawnień, ma następującą formę
Wyjaśnienie poprawnej odpowiedzi: Polecenie REVOKE w MySQL jest używane do odbierania przydzielonych uprawnień użytkownikom. W przypadku użytkownika 'anna', aby odebrać mu prawa do modyfikacji struktury bazy danych, należy użyć polecenia REVOKE z odpowiednimi uprawnieniami. Wybór REVOKE CREATE ALTER DROP jest poprawny, ponieważ obejmuje kluczowe prawa związane z zarządzaniem strukturą tabeli. Uprawnienie CREATE pozwala na tworzenie nowych obiektów, ALTER umożliwia modyfikację istniejących obiektów, a DROP pozwala na ich usuwanie. Przydzielając te uprawnienia, użytkownik ma pełną kontrolę nad strukturą bazy danych. Odbierając te uprawnienia, ograniczamy możliwości użytkownika do modyfikacji struktury, co jest kluczowe w kontekście zarządzania bezpieczeństwem bazy danych i zapewnienia integralności danych. Przykładem zastosowania tego polecenia może być sytuacja, w której administrator bazy danych chce, aby użytkownik miał jedynie prawa do wprowadzania danych, ale nie do zmiany ich struktury. W takich przypadkach ważne jest, aby precyzyjnie definiować uprawnienia użytkowników, co może pomóc w unikaniu nieautoryzowanych zmian i potencjalnych utrat danych. Należy również odwołać się do standardów SQL, które definiują zarządzanie uprawnieniami w obiektach bazy danych, co jest kluczowym elementem każdego systemu zarządzania bazą danych.
Pytanie 32
Konstrukcja w języku SQL ALTER TABLE USA... służy do
A. usunięcia tabeli USA
B. nadpisania istniejącej tabeli USA
C. zmiany tabeli USAPoprawna odpowiedź
D. stworzenia nowej tabeli USA
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie SQL ALTER TABLE jest używane do modyfikacji istniejącej tabeli w bazie danych. W kontekście odpowiedzi na to pytanie, modyfikacja tabeli USA może obejmować różne operacje, takie jak dodawanie nowych kolumn, modyfikowanie istniejących kolumn, usuwanie kolumn lub zmiana typu danych kolumn. Przykładowo, jeśli chcemy dodać kolumnę z datą utworzenia rekordu, moglibyśmy użyć polecenia ALTER TABLE USA ADD COLUMN created_at DATE. Ważne jest, aby pamiętać, że ALTER TABLE nie tworzy nowej tabeli, ani jej nie usuwa, co jest kluczowe dla zrozumienia jego funkcji. Dobre praktyki przy użyciu ALTER TABLE obejmują wykonanie kopii zapasowej bazy danych przed wprowadzeniem zmian, aby uniknąć utraty danych, a także rozważenie wpływu wprowadzanych zmian na już istniejące dane oraz indeksy. Ponadto, każda operacja ALTER TABLE może wymagać zablokowania tabeli, co wpływa na dostępność bazy danych podczas modyfikacji.
Pytanie 33
Jakie zadania programistyczne należy wykonać na serwerze?
A. Ukrywanie i wyświetlanie elementów strony w zależności od aktualnej pozycji kursora
B. Zapisanie danych pozyskanych z aplikacji internetowej w bazie danychPoprawna odpowiedź
C. Zmiana stylu HTML na stronie spowodowana ruchem kursora
D. Weryfikacja danych wprowadzonych do pola tekstowego na bieżąco
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Zapisanie danych pobranych z aplikacji internetowej w bazie danych to zadanie, które powinno być wykonywane po stronie serwera ze względów bezpieczeństwa, integralności danych oraz zarządzania zasobami. Serwer jest odpowiedzialny za przechowywanie informacji, które mogą być wykorzystywane przez wielu użytkowników, co wymaga centralizacji ich przetwarzania. W przypadku aplikacji internetowych, dane są często przesyłane z klienta (przeglądarki) do serwera, gdzie są walidowane oraz zapisywane w bazach danych. Na przykład, gdy użytkownik rejestruje się w aplikacji, jego dane osobowe są wysyłane do serwera, który sprawdza poprawność tych informacji i zapisuje je w bazie danych. Właściwe implementacje powinny stosować bezpieczne połączenia (np. HTTPS), a także techniki, takie jak sanitizacja danych, aby unikać ataków typu SQL Injection. Dobrą praktyką jest także stosowanie ORM (Object-Relational Mapping), co umożliwia łatwiejsze zarządzanie danymi i ich relacjami. Przechowywanie danych po stronie serwera pozwala na efektywne zarządzanie zasobami i umożliwia późniejsze przetwarzanie informacji w sposób zorganizowany i bezpieczny.
Pytanie 34
Który zestaw zawiera wyłącznie języki programowania działające po stronie serwera?
A. C#, Python, Ruby, PHP, JavaScript
B. Java, C#, AJAX, Ruby, PHP
C. Java, C#, Python, Ruby, PHPPoprawna odpowiedź
D. Java, C#, Python, ActionScript, PHP
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Po stronie serwera działają języki, których kod wykonuje się na serwerze i generuje treść wysyłaną do przeglądarki - zestaw Java, C#, Python, Ruby, PHP zawiera wyłącznie takie języki. Dlatego poprawny jest ten zestaw.
Pytanie 35
Która funkcja SQL NIE przyjmuje żadnych argumentów?
A.
NOW()
Poprawna odpowiedź
B.
UPPER()
C.
LEN()
D.
YEAR()
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja NOW() zwraca bieżącą datę i godzinę serwera (np. 2026-06-1314:05:00) i NIE przyjmuje żadnych argumentów - nawiasy zostają puste. Używa się jej np. przy zapisie momentu dodania rekordu: INSERTINTOlog(data)VALUES(NOW()). Zapamiętaj: NOW() działa „samo z siebie”, bo bierze czas z systemu, a nie z przekazanej wartości.
Pytanie 36
Głównym celem systemu CMS jest oddzielenie treści serwisu informacyjnego od jego wizualnej formy. Ten efekt osiągany jest przez generowanie zawartości
A. z plików HTML o stałej zawartości oraz wizualizacji z użyciem ustalonego szablonu
B. z bazy danych oraz wizualizacji poprzez atrybuty HTML
C. z bazy danych oraz wyglądu ze zdefiniowanego szablonuPoprawna odpowiedź
D. z plików HTML o stałej zawartości oraz wizualizacji przy pomocy technologii FLASH
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Poprawna odpowiedź na to pytanie to "z bazy danych oraz wyglądu ze zdefiniowanego szablonu". Systemy CMS (Content Management System) mają na celu oddzielenie treści od prezentacji, co pozwala na łatwiejsze zarządzanie i aktualizowanie zawartości serwisu. Wykorzystanie bazy danych do przechowywania treści jest kluczowe, ponieważ umożliwia dynamiczne generowanie zawartości na stronach internetowych. Dzięki temu, gdy zmienia się treść w bazie danych, zmiany te są automatycznie odzwierciedlane na stronie bez potrzeby modyfikacji statycznych plików HTML. Szablony, które definiują wygląd, są również niezmiernie ważne, ponieważ pozwalają na spójność wizualną serwisu i jego łatwą adaptację w przypadku zmian w designie. Przykładem może być użycie systemu szablonów, takiego jak Twig w Symfony, który umożliwia separację logiki biznesowej od prezentacji, co ułatwia pracę developerom i designerom. Takie podejście jest zgodne z najlepszymi praktykami w branży, zapewniając przy tym elastyczność i skalowalność serwisów internetowych.
Pytanie 37
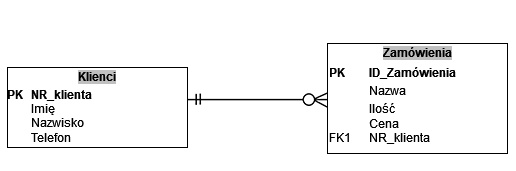
Na przedstawionym diagramie ER zapis FK1 oznacza
A. relację 1:N.
B. klucz obcy.Poprawna odpowiedź
C. klucz podstawowy.
D. relację 1:1.
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Skrót FK1 na diagramie ER oznacza klucz obcy (ang. foreign key) i jest to dokładnie to, co powinno łączyć tabelę Zamówienia z tabelą Klienci. W relacyjnych bazach danych klucz obcy to atrybut lub zestaw atrybutów, który wskazuje na klucz podstawowy w innej tabeli. Dzięki temu baza danych wie, że konkretne zamówienie należy do konkretnego klienta. W twoim diagramie pole NR_klienta w tabeli Zamówienia jest oznaczone jako FK1, czyli jest kluczem obcym odwołującym się do NR_klienta będącego kluczem podstawowym (PK) w tabeli Klienci. To jest klasyczny przykład relacji 1:N – jeden klient może mieć wiele zamówień, a każde zamówienie jest powiązane z dokładnie jednym klientem. W praktyce, w SQL, taka relacja jest definiowana mniej więcej tak: `FOREIGN KEY (NR_klienta) REFERENCES Klienci(NR_klienta)`. Taka definicja pozwala silnikowi bazy danych pilnować spójności referencyjnej, czyli np. nie pozwoli wstawić zamówienia z numerem klienta, który nie istnieje w tabeli Klienci, ani usunąć klienta, do którego wciąż istnieją zamówienia (chyba że jawnie zdefiniujemy CASCADE). Z mojego doświadczenia poprawne używanie kluczy obcych bardzo upraszcza później raportowanie, łączenie tabel w zapytaniach JOIN i ogólnie utrzymanie porządku w bazie. W modelowaniu ER oznaczenie FK wraz z numerem (FK1, FK2 itd.) to po prostu sposób na jednoznaczne nazwanie konkretnych kluczy obcych, gdy w systemie jest ich więcej. W dobrze zaprojektowanych bazach danych zawsze warto jawnie definiować foreign key, zamiast tylko „ufać”, że aplikacja będzie podawała poprawne dane – to jest po prostu dobra praktyka i standard w profesjonalnych projektach.
Pytanie 38
Co robi kwerenda:
ALTERTABLEartykulyMODIFYcenafloat;
?
A. zmienia typ kolumny cena na floatPoprawna odpowiedź
B. usuwa kolumnę cena
C. dodaje kolumnę cena typu float, jeśli nie istnieje
D. zmienia nazwę kolumny cena na float
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie ALTERTABLEartykulyMODIFYcenafloat; zmienia DEFINICJĘ istniejącej kolumny cena, ustawiając jej typ na float (liczba zmiennoprzecinkowa). Klauzula MODIFY służy właśnie do zmiany właściwości kolumny, która już istnieje. Dlatego polecenie zmienia typ kolumny cena na float.
B. zmieniać strukturę tabeli i wstawiać nowe dane.
C. usuwać tabelę i tworzyć nową.
D. przeglądać dane w tabeli i wstawiać nowe dane.Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Twoja odpowiedź jest poprawna. Użytkownik Jacek po wydaniu polecenia SQL 'GRANT SELECT, INSERT ON baza1.mojaTabela TO 'Jacek'@'localhost';' zyskuje możliwość przeglądania (SELECT) oraz wstawiania (INSERT) danych do tabeli 'mojaTabela' znajdującej się w bazie danych 'baza1'. Jest to zgodne ze standardami SQL i dobrymi praktykami zarządzania uprawnieniami w systemach baz danych. Uprawnienie SELECT pozwala na odczyt danych z tabeli, co jest niezbędne do analizy danych, a uprawnienie INSERT umożliwia dodawanie nowych rekordów do tabeli, co jest kluczowe dla utrzymywania aktualności danych. Pamiętaj, że kontrola dostępu do danych jest kluczowym elementem zarządzania bazami danych, zarówno pod względem bezpieczeństwa, jak i zgodności z regulacjami prawnymi.
Pytanie 40
W systemie bazy danych dotyczącej pojazdów, pole kolor w tabeli samochody może przyjmować wartości tylko z listy lakier. Aby zrealizować połączenie między tabelami samochody a lakier przez relację, należy użyć kwerendy
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź 4 jest poprawna, ponieważ dokładnie określa, jak należy zdefiniować relację między tabelą samochody a tabelą lakier w kontekście bazy danych. W tym przypadku, pole kolor w tabeli samochody pełni rolę klucza obcego, który odnosi się do kolumny lakierId w tabeli lakier. To połączenie jest niezbędne, aby zapewnić integralność danych oraz umożliwić korzystanie z relacyjnych własności baz danych. Klucz obcy stosowany w relacjach między tabelami pozwala na ograniczenie wartości, które mogą być wprowadzone do pola kolor, zapewniając, że będą one zgodne z wartościami zdefiniowanymi w tabeli lakier. Przykładowo, jeśli chcemy zapewnić, że każdy samochód ma przypisany kolor z określonej palety, stosowanie kluczy obcych jest najlepszą praktyką. Tego rodzaju podejście jest zgodne z normami ACID (Atomicity, Consistency, Isolation, Durability), co zwiększa niezawodność operacji na bazie danych.