Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 30 września 2026 00:49
Zakończenie: 30 września 2026 00:55
Egzamin zdany!
Wynik: 26/40 punktów (65,0%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 48% podejść do kwalifikacji INF.03.
Porównanie z 43769 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 77,5%, teraz 65,0% (-12,5 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
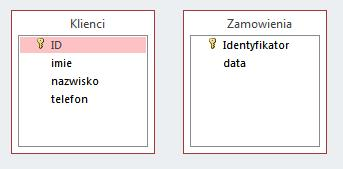
Na ilustracji przedstawiono dwie tabele. Aby ustanowić między nimi relację jeden do wielu, gdzie jedna strona to Klienci, a druga strona to Zamowienia, należy
A. wprowadzić pole klucza obcego do tabeli Zamowienia i powiązać je z ID tabeli Klienci.Poprawna odpowiedź
B. stworzyć trzecią tabelę z dwoma kluczami obcymi. Jeden klucz połączyć z ID tabeli Klienci, a drugi klucz połączyć z ID tabeli Zamowienia.
C. powiązać relacją pola ID z obu tabel.
D. dodać pole klucza obcego do tabeli Klienci i powiązać je z ID tabeli Zamowienia.Twoja odpowiedź
Niepoprawna odpowiedź. Zrozumienie, dlaczego inne podejścia do tworzenia relacji jeden do wielu są błędne, wymaga wyjaśnienia działania kluczy podstawowych i obcych. Połączenie pól ID z obu tabel nie tworzy poprawnej relacji jeden do wielu, ponieważ nie definiuje, które pole służy jako klucz obcy. Tego typu połączenie może prowadzić do niejednoznaczności i problemów z integralnością danych. Dodanie klucza obcego do tabeli Klienci i połączenie go z ID tabeli Zamowienia również nie jest prawidłowe, ponieważ przeczyłoby to logice relacji jeden do wielu, gdzie jeden klient może mieć wiele zamówień, a nie odwrotnie. W praktyce takie podejście mogłoby prowadzić do powielania danych w tabeli Klienci i komplikacji przy zarządzaniu danymi. Zdefiniowanie trzeciej tabeli z dwoma kluczami obcymi jest podejściem stosowanym przy relacjach wiele do wielu, a nie jeden do wielu, jak w tym przypadku. Takie rozwiązanie byłoby nieefektywne w tej sytuacji i niepotrzebnie skomplikowałoby strukturę bazy danych. Poprawne zrozumienie tych koncepcji jest kluczowe dla projektowania wydajnych i spójnych systemów baz danych, zgodnych z zasadami normalizacji i dobrych praktyk inżynierii danych.
Pytanie 2
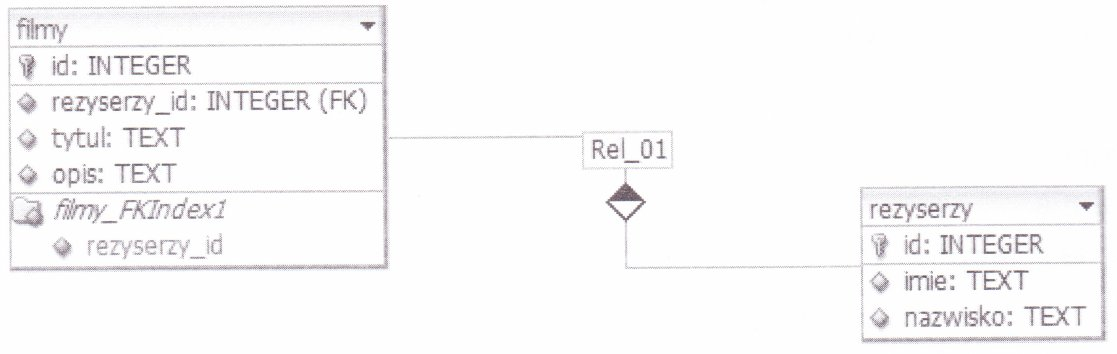
Na ilustracji pokazano relację jeden do wielu. Łączy ona
A. klucz obcy rezyserzy_id tabeli filmy z kluczem obcym id tabeli rezyserzy
B. klucz obcy rezyserzy_id tabeli filmy z kluczem podstawowym id tabeli rezyserzyTwoja odpowiedź
C. klucz podstawowy id tabeli filmy z kluczem podstawowym id tabeli rezyserzy
D. klucz podstawowy id tabeli filmy z kluczem obcym rezyserzy_id tabeli rezyserzy
Poprawna odpowiedź. Relacja jeden do wielu w bazach danych często wiąże się z sytuacją, gdzie jeden rekord w tabeli nadrzędnej może być powiązany z wieloma rekordami w tabeli podrzędnej. W tym kontekście tabela nadrzędna to rezyserzy posiadająca klucz podstawowy id, natomiast tabela podrzędna to filmy która odnosi się do tej wartości poprzez klucz obcy rezyserzy_id. Klucz podstawowy to unikalny identyfikator rekordu w tabeli, który pozwala na jednoznaczne rozróżnienie każdego rekordu. Klucz obcy natomiast jest atrybutem w tabeli podrzędnej, który odnosi się do klucza podstawowego w tabeli nadrzędnej. Jest to zgodne z teorią normalizacji baz danych, gdzie relacje jeden do wielu są standardowym podejściem do projektowania struktur danych. Użycie klucza obcego pozwala na utrzymanie integralności referencyjnej, co oznacza że każda wartość klucza obcego musi odpowiadać wartości klucza podstawowego w powiązanej tabeli lub być null, jeśli taka relacja jest dozwolona. Praktyczne zastosowanie tej relacji można zaobserwować w systemach zarządzania treścią, gdzie jeden autor (reżyser) może mieć przypisanych wiele artykułów (filmów), jednak każdy artykuł jest przypisany do jednego autora, co umożliwia na przykład efektywne zarządzanie danymi i generowanie raportów o twórczości danego autora.
Pytanie 3
Która pętla w PHP wykona swoje instrukcje CO NAJMNIEJ RAZ, bo warunek sprawdzany jest dopiero na końcu?
A.
foreach
B.
do...while
Twoja odpowiedź
C.
while
D.
for
Poprawna odpowiedź. Pętla do...while najpierw WYKONUJE blok instrukcji, a dopiero potem sprawdza warunek - dlatego jej ciało wykona się przynajmniej raz, nawet gdy warunek od początku jest fałszywy. Stosuje się ją, gdy coś trzeba zrobić co najmniej raz, np. wyświetlić menu, a potem pytać o powtórzenie. Zapamiętaj: warunek na KOŃCU = minimum jedno wykonanie.
Pytanie 4
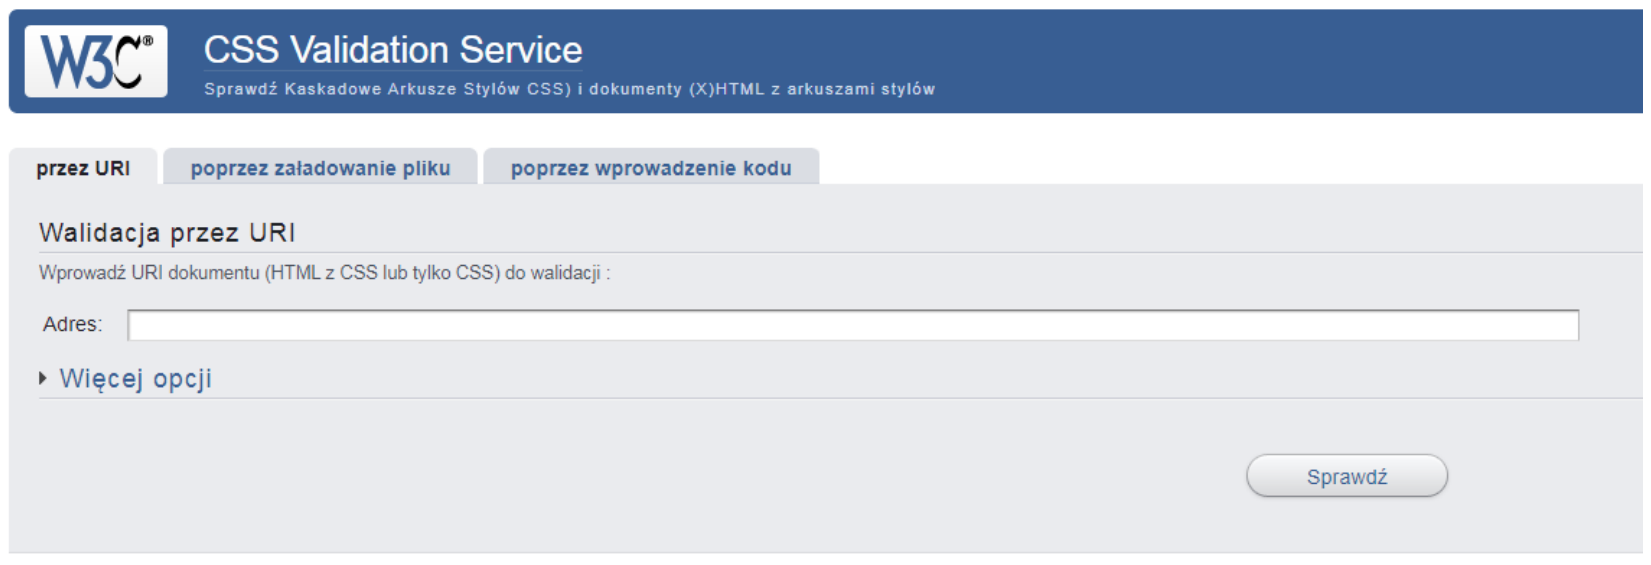
Przedstawiony serwis internetowy służy do walidacji
A. skryptów JavaScript.
B. dokumentów HTML.
C. bazy danych SQL.
D. arkuszy stylów.Twoja odpowiedź
Poprawna odpowiedź. Twoja odpowiedź jest prawidłowa. Strona internetowa 'CSS Validation Service' jest narzędziem stworzonym przez konsorcjum W3C do walidacji arkuszy stylów CSS. W3C, czyli World Wide Web Consortium, to międzynarodowa społeczność, która rozwija otwarte standardy mające na celu długoterminowe wzrost i rozwój sieci WWW. Narzędzie do walidacji CSS zapewnia mechanizm sprawdzania kodu CSS pod kątem zgodności ze standardami W3C. Dzięki temu deweloperzy mogą upewnić się, że ich arkusze stylów są poprawne, co jest kluczowe dla zapewnienia prawidłowego wyglądu i działania stron internetowych na różnych platformach i przeglądarkach. Walidator CSS pomaga także naprawić ewentualne błędy w kodzie. To jest praktyczne zastosowanie tej usługi - utrzymanie jednolitych standardów kodowania, co prowadzi do większej interoperacyjności pomiędzy różnymi technologiami i narzędziami.
Pytanie 5
Jaką wartość wydrukuje na standardowe wyjście poniższy fragment kodu C++?
int obliczenia( int x ) { x %= 3; x++; return x; }
int main() { std::cout<<obliczenia(32); }
A. 32
B. 3Poprawna odpowiedź
C. 0
D. 2Twoja odpowiedź
Niepoprawna odpowiedź. Rozważając dostępne odpowiedzi musimy przeanalizować dlaczego niektóre z nich są błędne w kontekście działania fragmentu programu. Zaczynając od odpowiedzi 0 warto zauważyć że reszta z dzielenia 32 przez 3 nie wynosi 0 co oznacza że operacja x %= 3 nie da w wyniku zera. Wartość 0 mogłaby być wynikiem tylko wtedy gdyby liczba 32 była podzielna przez 3 co nie jest prawdą w tym przypadku. Przechodząc dalej odpowiedź 32 sugeruje że operacje wewnątrz funkcji nie zmieniają wartości x co jest błędnym założeniem. Operacja x %= 3 zmienia wartość x na 2 a następnie x++ zmienia ją na 3. Dlatego wynik nie może być 32 ponieważ funkcja jawnie modyfikuje wartość wejściową. W kontekście odpowiedzi 2 operacje w funkcji mogą rzeczywiście prowadzić do wyniku 2 jeśli pominie się krok inkrementacji. Jednakże analiza kodu pokazuje że po operacji modulo wartość x wynosi 2 a następny krok to x++ który zwiększa tę wartość do 3. W rezultacie żadna z tych odpowiedzi nie uwzględnia pełnego przepływu operacji w funkcji co prowadzi do nieprawidłowych wniosków. Analizując ten problem można zauważyć jak ważne jest dokładne śledzenie przepływu danych w programie oraz zrozumienie wpływu każdej operacji na ostateczny wynik co jest kompetencją kluczową w profesjonalnym programowaniu.
Pytanie 6
Jaką wartość zwróci funkcja zao, która została zdefiniowana w języku C++, gdy zostanie wywołana z argumentem 3.55?
intzao(floatx) {returnx+0.5;}
A. 4Poprawna odpowiedź
B. 3
C. 4.05
D. 3.5Twoja odpowiedź
Niepoprawna odpowiedź. Wartości zwracane przez funkcje w C++ mogą być mylące, gdy nie zrozumiemy, jak działa zaokrąglanie i operacje na liczbach zmiennoprzecinkowych. Rozważając odpowiedzi 3, 3.5 i 4.05, można zauważyć, że każda z tych odpowiedzi opiera się na błędnym zrozumieniu zastosowania funkcji zaofloat. Odpowiedź 3 wynika z błędu myślowego, który zakłada, że dodanie 0.5 do wartości 3.55 skutkuje zmniejszeniem wartości do najbliższej liczby całkowitej, co jest niezgodne z zasadami matematycznymi. Z kolei odpowiedź 3.5 może wydawać się logiczna dla kogoś, kto może pomyśleć, że dodanie 0.5 w jakimś sensie zmienia wartość do tej liczby, jednak w rzeczywistości, gdyby tak było, funkcja nie spełniałaby swojej podstawowej roli. Odpowiedź 4.05, mimo że jest poprawnym wynikiem dodania do 3.55 wartości 0.5, nie jest właściwą odpowiedzią w kontekście pytania, ponieważ nie uwzględnia zasady zaokrąglania do najbliższej liczby całkowitej. W praktyce programiści często napotykają podobne problemy i dlatego dobrym zwyczajem jest, aby jasno określać wymagania dotyczące wyników i stosować odpowiednie metody zaokrąglania, kiedy to konieczne, aby uniknąć nieporozumień.
Pytanie 7
Który z formatów to format grafiki WEKTOROWEJ?
A. SVGPoprawna odpowiedź
B. GIF
C. PNG
D. JPGTwoja odpowiedź
Niepoprawna odpowiedź. Pozostałe formaty są RASTROWE - przechowują obraz jako siatkę pikseli, więc przy powiększaniu tracą ostrość. JPG kompresuje stratnie (zdjęcia), PNG bezstratnie (z przezroczystością), a GIF obsługuje proste animacje. Wektorowy z tej listy jest tylko SVG.
Pytanie 8
Wszelkie dane, które dostarczają informacji o innych danych, nazywane są
A. metadata.Twoja odpowiedź
B. metalanguage.
C. markup language.
D. databus.
Poprawna odpowiedź. Poprawna odpowiedź to „metadata”, czyli po polsku metadane. Metadane to wszystkie dane, które opisują inne dane. Można powiedzieć, że są to „informacje o informacji”. Przykład z życia: plik zdjęcia JPG. Sam obraz to dane, a takie elementy jak data wykonania, model aparatu, rozdzielczość, lokalizacja GPS, autor – to właśnie metadane zapisane np. w formacie EXIF. Podobnie w świecie WWW: w dokumencie HTML mamy sekcję <head>, a w niej znaczniki <meta>. Te znaczniki nie są wyświetlane użytkownikowi jako treść strony, ale przekazują wyszukiwarkom i przeglądarkom informacje o stronie, np. opis, słowa kluczowe, kodowanie znaków, język. To jest klasyczny przykład metadanych w praktyce. W bazach danych metadane to np. definicje tabel, typy kolumn, klucze główne, indeksy, ograniczenia. System zarządzania bazą danych przechowuje je w tzw. katalogach systemowych. Dzięki temu wie, jak interpretować rekordy, jakie są relacje między tabelami, jakie są dopuszczalne wartości. Bez metadanych dane byłyby po prostu chaotycznym zbiorem bitów, z którego niewiele da się wyciągnąć. W standardach branżowych stosuje się różne schematy metadanych, np. Dublin Core dla zasobów cyfrowych, czy schema.org dla stron internetowych, aby wyszukiwarki lepiej rozumiały zawartość. Z mojego doświadczenia warto od początku myśleć o metadanych jako o czymś, co podnosi jakość systemu: ułatwia wyszukiwanie, integrację, automatyczne przetwarzanie danych. Dobra praktyka jest taka, żeby dla ważnych zasobów (pliki, rekordy w bazie, strony WWW, API) zawsze planować strukturę metadanych: kto utworzył, kiedy, jaki typ, wersja, status. To bardzo pomaga przy utrzymaniu aplikacji, debugowaniu i rozwoju systemu.
Pytanie 9
W HTML, aby ustawić tytuł dokumentu na "Moja strona", który pojawi się na karcie przeglądarki internetowej, należy użyć zapisu
A.
<metaname="title"content="Moja strona">
B.
<metatitle="Moja strona">
C.
<head>Moja strona</head>
D.
<title>Moja strona</title>
Twoja odpowiedź
Poprawna odpowiedź. Element <title> w HTML jest naprawdę ważny, bo to właśnie on ustala, co zobaczysz na zakładce w przeglądarce. Powinien być umieszczony w sekcji <head>, co jest zgodne z tym, co mówi W3C. Poprawny zapis wygląda tak: <title>Moja strona</title>, co sprawia, że "Moja strona" będzie się pokazywać jako tytuł w przeglądarce. Tytuł strony ma spore znaczenie dla SEO, bo wpływa na to, jak strona jest pozycjonowana w wynikach wyszukiwania. Warto, żeby tytuł był krótki, ale jednocześnie zawierał istotne informacje, a najlepiej, żeby nie miał więcej niż 60 znaków, żeby się nie obcinał w wynikach. Fajnie też umieścić w tytule kluczowe słowa, które opisują, o czym jest strona, bo to może zwiększyć jej atrakcyjność i CTR. Dobrze skonstruowany tytuł to też lepsza dostępność, bo ułatwia użytkownikom poruszanie się i orientowanie w otwartych zakładkach.
Pytanie 10
Aby w tabeli praca, tworzonej w SQL, dodać warunek w kolumnie stawka, który nakazuje przyjmowanie dodatnich wartości rzeczywistych mniejszych niż 50, należy zastosować zapis
A. ... stawka float CHECK(stawka>0 AND stawka<50.00)Poprawna odpowiedź
B. ... stawka float CHECK(stawka>0 OR stawka<50.00)Twoja odpowiedź
C. ... stawka float CHECK(stawka BETWEEN 0 AND 50.00)
D. ... stawka float CHECK(stawka IN (0, 50.00))
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi wykorzystuje operator IN, który nie jest odpowiedni dla tego przypadku. Operator IN służy do sprawdzania, czy wartość znajduje się w zbiorze dozwolonych wartości. W kontekście stawki, nie ma sensu ograniczać się tylko do wartości 0 i 50.00, ponieważ chcemy, by 'stawka' mogła przyjmować wiele wartości w przedziale od 0 do 50, a nie tylko te dwa. Kolejna odpowiedź stosuje operator OR, co prowadzi do błędnej interpretacji wymagań. Użycie OR oznacza, że 'stawka' mogłaby być większa od 0 lub mniejsza od 50, co w efekcie pozwalałoby na wprowadzenie wartości, które nie spełniają założonego kryterium, takich jak liczby ujemne. Ostatnia z odpowiedzi używa operatora BETWEEN, który również nie jest odpowiedni, ponieważ tworzy zakres od 0 do 50, co nie spełnia warunku, że stawka musi być większa od 0. Zatem, wszystkie trzy odpowiedzi nie zapewniają poprawnej weryfikacji danych w kolumnie 'stawka' w tabeli SQL, co jest kluczowe dla utrzymania jakości i integralności danych.
Pytanie 11
Które znaczniki HTML wyświetlą tekst „Dobre strony mojej strony” w JEDNYM wierszu, jeśli nie zastosowano żadnych reguł CSS?
Poprawna odpowiedź. Domyślnie (bez CSS) tekst zostanie w jednym wierszu tylko wtedy, gdy użyjemy elementów LINIOWYCH - takim jest <span>, który nie wymusza nowej linii. Dlatego dwa <span> jeden po drugim wyświetlą się obok siebie w tym samym wierszu. Dlatego poprawny jest wariant ze <span>.
Pytanie 12
Którą funkcję z menu Kolory programu GIMP użyto, w celu uzyskania efektu przedstawionego w filmie?
A. Barwienie.
B. Inwersja.
C. Progowanie.Twoja odpowiedź
D. Krzywe.
Poprawna odpowiedź. Prawidłowo wskazana funkcja to „Progowanie”, bo dokładnie ona zamienia obraz kolorowy lub w odcieniach szarości na obraz dwuwartościowy: piksel jest albo czarny, albo biały, w zależności od tego, czy jego jasność przekracza ustawiony próg. W GIMP-ie znajdziesz ją w menu Kolory → Progowanie. Suwakami ustalasz zakres poziomów jasności, które mają zostać potraktowane jako „białe”, a wszystko poza tym zakresem staje się „czarne”. Efekt, który się wtedy uzyskuje, jest bardzo charakterystyczny: mocno kontrastowy, bez półtonów, coś w stylu skanu czarno-białego lub grafiki do druku na ploterze tnącym. Z mojego doświadczenia progowanie świetnie nadaje się do przygotowania logotypów, szkiców technicznych, schematów, a także do wyciągania konturów z lekko rozmytych zdjęć. Często używa się go też przed wektoryzacją, żeby program śledzący krawędzie miał wyraźne granice między czernią a bielą. W pracy z grafiką na potrzeby stron WWW próg bywa stosowany np. przy tworzeniu prostych ikon, piktogramów albo masek (maski przezroczystości można przygotować właśnie na bazie obrazu progowanego). Dobrą praktyką jest najpierw sprowadzenie obrazu do odcieni szarości i dopiero potem użycie progowania, bo wtedy masz większą kontrolę nad tym, jak rozkłada się jasność i gdzie wypadnie granica progu. Warto też pamiętać, że progowanie jest operacją destrukcyjną – traci się informacje o półtonach – więc najlepiej pracować na kopii warstwy, żeby w razie czego móc wrócić do oryginału i poprawić ustawienia progu.
Pytanie 13
1 <script>2 constliczba = 1;
3 letgora = 10, dol = 1;
4 letpodaj = parseInt(prompt("Podaj liczbę całkowitą z zakresu <1-10>"));
5 liczba = Math.random() * ( gora - dol + 1 ) + dol;
6 liczba = parseInt(liczba);
7 if (liczba == podaj) {
8 document.write("Liczba została odgadnięta");
9 } else {
10document.write("Niestety nie tym razem");
11 }
12</script>
Przedstawiony fragment kodu JavaScript powinien wylosować liczbę całkowitą z zakresu <1 , 10> i porównać ją z liczbą podaną przez użytkownika w oknie dialogowym. Skrypt po uruchomieniu generuje błąd, którego przyczyną jest
A. przypisanie wartości do stałej liczba w piątej linii skryptu .Poprawna odpowiedź
B. błędna składnia instrukcji warunkowej if ... else.
C. błędna składnia deklaracji zmiennych gora i dol w drugiej linii skryptu.Twoja odpowiedź
D. niepotrzebne użycie konwersji z funkcji prompt do liczby całkowitej.
Niepoprawna odpowiedź. W tym zadaniu łatwo skupić się na szczegółach, które wyglądają podejrzanie, ale w rzeczywistości są poprawne. Wiele osób patrzy najpierw na deklarację zmiennych `gora` i `dol` w trzeciej linii, bo mamy tam dwa identyfikatory zadeklarowane w jednym wierszu: `let gora = 10, dol = 1;`. Taka składnia w JavaScript jest całkowicie poprawna i bardzo często spotykana w kodzie produkcyjnym. Standard ECMAScript dopuszcza deklarację wielu zmiennych w jednym instrukcie `let`, `const` czy `var`, oddzielonych przecinkami. To nie ma żadnego wpływu na poprawność działania skryptu, jest tylko kwestią stylu kodowania. Niektórzy lintersi zalecają jedną zmienną na linię, ale to jest wyłącznie konwencja, nie błąd.
Podobnie z instrukcją warunkową `if ... else`. Konstrukcja `if (liczba == podaj) { ... } else { ... }` jest jak najbardziej poprawna składniowo. Nawet użycie operatora `==` (zamiast bardziej restrykcyjnego `===`) nie powoduje tu błędu wykonania, najwyżej może być dyskusyjne ze względu na dobre praktyki, bo `===` nie robi konwersji typów. Jednak w tym konkretnym kodzie obie wartości są konwertowane do liczb, więc porównanie zadziała logicznie. Błąd wykonania nie ma więc źródła w warunku.
Czasem pojawia się też myśl, że problemem może być `parseInt(prompt(...))`, bo prompt zwraca tekst. Tymczasem właśnie dlatego używamy `parseInt`, żeby zamienić łańcuch znaków na liczbę całkowitą. Bez tej konwersji porównywalibyśmy liczbę z tekstem, co mogłoby dawać dziwne wyniki logiczne. Konwersja jest tu więc nie tylko „nie niepotrzebna”, ale wręcz wskazana. W nowoczesnym kodzie można by użyć np. `Number(prompt(...))` albo dodatkowo sprawdzić, czy użytkownik faktycznie podał liczbę, ale sam `parseInt` jest jak najbardziej OK.
Sednem problemu nie są więc ani deklaracje `gora` i `dol`, ani składnia `if ... else`, ani konwersja wartości z prompta, tylko próba nadpisania stałej. Z mojego doświadczenia wynika, że to bardzo typowy błąd przy nauce `const` i `let`: mylenie stałych z „zwykłymi” zmiennymi. Warto zawsze zadać sobie pytanie: czy ta wartość ma się zmieniać w czasie działania skryptu? Jeśli tak, używamy `let`. Jeśli nie, wtedy dopiero `const`. To prosta zasada, która pozwala uniknąć takich błędów logicznych i runtime'owych.
Pytanie 14
W języku PHP zmienna typu float może przyjmować wartości
A. wartości nieliczbowe
B. jedynie liczby całkowite
C. wartości zmiennoprzecinkoweTwoja odpowiedź
D. wartości logiczne
Poprawna odpowiedź. W języku PHP zmienne typu float są używane do reprezentowania liczb zmiennoprzecinkowych, co oznacza, że mogą przechowywać zarówno wartości całkowite, jak i wartości z częścią ułamkową. Typ float w PHP jest szczególnie przydatny w sytuacjach, gdzie precyzyjne obliczenia są niezbędne, na przykład w aplikacjach finansowych, gdzie obliczenia z użyciem pieniędzy wymagają uwzględnienia centów. W praktyce, operacje na zmiennych typu float mogą obejmować dodawanie, odejmowanie, mnożenie oraz dzielenie. Warto również zauważyć, że PHP obsługuje zarówno liczby w formacie dziesiętnym, jak i w notacji naukowej. Dobrą praktyką jest używanie funkcji takich jak round() do zaokrąglania wyników obliczeń zmiennoprzecinkowych, aby uniknąć problemów z precyzją, które mogą występować w wyniku ograniczeń reprezentacji liczb zmiennoprzecinkowych w pamięci komputera. W dokumentacji PHP, typ float jest jasno zdefiniowany jako liczba zmiennoprzecinkowa, co podkreśla jego kluczową rolę w różnych zastosowaniach programistycznych. Zrozumienie tego typu zmiennych jest fundamentem dla efektywnego programowania w PHP.
Pytanie 15
Które z poniższych stwierdzeń odnosi się prawidłowo do grafiki rastrowej?
A. W trakcie procesu skalowania, jakość obrazu nie ulega zmianie
B. Jest to forma przedstawienia obrazu za pomocą siatki pikseli, które są odpowiednio kolorowane w układzie pionowo-poziomym na monitorze, drukarce lub innym urządzeniu wyjściowymTwoja odpowiedź
C. Obraz zapisywany jest w postaci figur geometrycznych zorganizowanych w układzie współrzędnych
D. Grafika rastrowa nie jest zapisana w formacie WMF (ang. Windows Metafile Format - format metaplików w Windows)
Poprawna odpowiedź. Grafika rastrowa to technika reprezentacji obrazów, w której obraz składa się z siatki pikseli. Każdy piksel ma przypisany kolor, co pozwala na precyzyjne odwzorowanie detali i kolorystyki. Taki sposób przedstawienia obrazu znajduje zastosowanie w grafice komputerowej, fotografii cyfrowej oraz w druku. W praktyce, obrazy rastrowe są powszechnie wykorzystywane w programach graficznych, takich jak Adobe Photoshop czy GIMP, gdzie edytuje się poszczególne piksele. Publikacje internetowe, jak także różnorodne formy marketingu wizualnego, opierają się na grafice rastrowej, ponieważ umożliwia ona tworzenie złożonych i bogatych w szczegóły obrazów. Ważnym aspektem grafiki rastrowej jest rozdzielczość, która określa ilość pikseli w obrazie; im wyższa rozdzielczość, tym większa jakość. Wydruki, które zyskują na jakości dzięki zastosowaniu technologii rastrowej, są zgodne z najlepszymi praktykami odnośnie do standardów drukarskich, co umożliwia osiągnięcie wysokiej jakości wydruków. Zrozumienie grafiki rastrowej jest kluczowe dla każdego, kto interesuje się tworzeniem i edytowaniem obrazów w kontekście cyfrowym.
Pytanie 16
Wskaż zapis stylu CSS formatujący punktor list numerowanych na wielkie cyfry rzymskie, a list punktowanych na kwadraty.
A. ol { list-style-type: upper-alpha; }
   ul { list-style-type: disc; }

B. ol { list-style-type: square; }
   ul { list-style-type: upper-roman; }

C. ol { list-style-type: disc; }
   ul { list-style-type: upper-alpha; }

D. ol { list-style-type: upper-roman; }
   ul { list-style-type: square; }
D.Twoja odpowiedź
B.
A.
C.
Poprawna odpowiedź. Gratulacje, twoja odpowiedź jest poprawna! Wybór opcji D. odnosi się do poprawnego formatowania list w CSS. Odpowiedź pokazuje dobrą znajomość właściwości list-style-type, która jest kluczowa do formatowania typów list. W tym przypadku, dla listy numerowanej (ol), jest ustawiona wartość upper-roman, która reprezentuje wielkie cyfry rzymskie. Dla listy punktowanej (ul) ustawiamy wartość square, co daje efekt punktów w formie kwadratów. To właśnie takie formatowanie list jest preferowane w branży ze względu na jego estetykę i czytelność. Pamiętaj, że zrozumienie i umiejętność manipulacji różnymi właściwościami CSS jest kluczem do tworzenia atrakcyjnych i funkcjonalnych stron internetowych.
Pytanie 17
Wskaż zdanie, które jest fałszywe w odniesieniu do poniższej definicji funkcji w języku C++?
Poprawna odpowiedź. Funkcja w języku C++ z deklaracją 'void' na początku oznacza, że nie zwraca żadnej wartości. Jest to zgodne z poprawną odpowiedzią nr 3. Tego typu funkcje używane są często w sytuacjach, gdy nie jest konieczne przekazywanie wyniku, a operacje są wykonywane na danych wejściowych. Deklaracja parametrów przez referencję 'float &x, float &y' pozwala na bezpośrednią modyfikację wartości przekazanych do funkcji zmiennych. Oznacza to, że wszelkie zmiany dokonane na tych parametrach wewnątrz funkcji są odzwierciedlane w zmiennych oryginalnych. Taka technika jest szeroko stosowana w programowaniu, aby zwiększyć efektywność i zmniejszyć ilość niepotrzebnych kopii danych. Funkcja 'zamien' ilustruje wymianę wartości dwóch zmiennych przy użyciu tymczasowej zmiennej 'tmp', co jest klasycznym podejściem do tego problemu programistycznego. Zachowanie funkcji bez zwracania wartości jest zgodne z zasadami projektowania funkcji użytkowych, które realizują pewne operacje proceduralne na danych. Stosowanie referencji zwiększa kontrolę nad pamięcią i wydajność programu, co jest krytyczne w aplikacjach o wysokiej wydajności. Zrozumienie tego aspektu jest istotne dla prawidłowego biegu programu i efektywnego zarządzania zasobami.
Pytanie 18
Aby utworzyć tabelę w języku SQL, należy użyć polecenia
A.
CREATETABLE
Twoja odpowiedź
B.
ADDTABLE
C.
INSERTTABLE
D.
ALTERTABLE
Poprawna odpowiedź. Odpowiedź 'CREATE TABLE' jest poprawna, ponieważ w języku SQL to polecenie jest używane do tworzenia nowych tabel w bazie danych. Umożliwia definiowanie struktury tabeli, w tym nazw kolumn, typów danych oraz ograniczeń, takich jak klucze główne czy unikalność. Przykładowe użycie polecenia 'CREATE TABLE' może wyglądać następująco: 'CREATE TABLE pracownicy (id INT PRIMARY KEY, imie VARCHAR(50), nazwisko VARCHAR(50));'. W tym przykładzie tworzymy tabelę 'pracownicy' z trzema kolumnami: 'id', 'imie' oraz 'nazwisko'. Warto zaznaczyć, że zgodnie z najlepszymi praktykami, przed wykonaniem polecenia warto sprawdzić, czy tabela o danej nazwie już istnieje, aby uniknąć błędów związanych z podwójnym tworzeniem. Zapewnienie odpowiedniej struktury bazy danych już na etapie jej tworzenia przekłada się na lepszą wydajność oraz łatwiejsze zarządzanie danymi w przyszłości.
Pytanie 19
Aby zwiększyć wydajność operacji na bazie danych, należy dla pól, które są często wyszukiwane lub sortowane
A. utworzyć indeksTwoja odpowiedź
B. stworzyć osobną tabelę przechowującą tylko te pola
C. dodać więzy integralności
D. dodać klucz obcy
Poprawna odpowiedź. Tworzenie indeksu na polach, które często przeszukujesz lub sortujesz, to naprawdę ważna rzecz, jeśli chodzi o wydajność baz danych. Indeksy działają trochę jak spis treści w książkach – pozwalają systemowi szybko znaleźć te dane, których potrzebujesz, bez przeszukiwania całego folderu. Dzięki nim zapytania SELECT mogą iść jak burza, co ma ogromne znaczenie w aplikacjach, gdzie liczy się czas. Przykład? Jeśli zrobisz indeks na kolumnie 'email' w tabeli 'Users', to znacznie szybciej odnajdziesz użytkowników po adresie email. W praktyce warto też regularnie monitorować, jak działają te indeksy i je optymalizować, na przykład usuwając te, które są zbędne, żeby nie przeciążać bazy danych. Dobrze jest pamiętać, że przy dodawaniu lub aktualizowaniu danych, indeksy mogą trochę spowolnić działanie, więc lepiej używać ich z głową.
Pytanie 20
Zaprezentowana linia kodu w języku PHP ma na celu
define("OSOBA", "Anna Kowalska");
A. porównać dwa ciągi znaków
B. ustalić wartość dla zmiennej $OSOBA
C. przypisać dwie wartości do tablicy
D. zdefiniować stałą o nazwie OSOBATwoja odpowiedź
Poprawna odpowiedź. Odpowiedź "zdefiniować stałą o nazwie OSOBA" jest prawidłowa, ponieważ linia kodu define("OSOBA", "Anna Kowalska"); w języku PHP służy do tworzenia stałej. Stała to wartość, która nie zmienia się w trakcie działania programu. W tym przypadku, stała o nazwie OSOBA jest przypisywana do wartości "Anna Kowalska". Użycie stałych jest uważane za dobrą praktykę programistyczną, ponieważ pozwala na zdefiniowanie wartości, które mają być używane w różnych częściach aplikacji, co zwiększa czytelność i ułatwia zarządzanie kodem. Przykładem zastosowania stałych może być przechowywanie kluczy API, które nie powinny być zmieniane w trakcie działania aplikacji. Ponadto, korzystanie ze stałych może poprawić wydajność, gdyż PHP nie musi za każdym razem przeprowadzać operacji przypisania. Warto również zauważyć, że stałe w PHP są globalne i mogą być używane w dowolnym miejscu w kodzie, co czyni je bardzo użytecznymi w dużych projektach. Właściwe definiowanie i użycie stałych jest kluczowe dla utrzymania porządku i spójności w projekcie, co jest zgodne z ogólnie uznawanymi standardami programowania.
Pytanie 21
Tabela podzespoly ma pola: model, producent, typ, cena. Które zapytanie wyświetli modele dysków SSD firmy Samsung od najdroższego do najtańszego?
Poprawna odpowiedź. Dyski SSD firmy Samsung to część wspólna dwóch warunków - typ „SSD” ORAZ producent „Samsung” - więc łączymy je AND, a od najdroższego do najtańszego sortuje ORDERBYcenaDESC. Wybieramy model z podzespoly. Dlatego ta kwerenda jest poprawna.
Pytanie 22
Wskaź poprawną formę kodowania polskich znaków w pliku HTML?
A.
<metaset= "UTF-8">
B.
<metacharset="UTF-8">
Twoja odpowiedź
C.
<meta>
D.
<metacontent='UTF8'>
Poprawna odpowiedź. Odpowiedź <meta charset="UTF-8"> to strzał w dziesiątkę! To zgodny z nowoczesnymi standardami HTML sposób na określenie kodowania znaków w dokumencie. Dzięki temu, że używamy atrybutu 'charset' z wartością 'UTF-8', mówimy przeglądarkom, że tekst powinien być interpretowany według tego kodowania. UTF-8 jest super popularne, bo obsługuje wszystkie znaki w Unicode. To oznacza, że możemy pisać wszystkie polskie znaki diakrytyczne, czyli te jak ą, ć, ę, ł itd., bez obaw o błędy w wyświetlaniu. Jeśli wstawisz ten tag w sekcji <head> swojego dokumentu HTML, masz pewność, że strona będzie dobrze wyglądać w różnych przeglądarkach i na różnych urządzeniach. Dobrze jest umieszczać go na początku sekcji <head>, żeby uniknąć problemów z pokazywaniem treści. Co więcej, korzystanie z UTF-8 jest rekomendowane przez W3C, więc to naprawdę dobry wybór dla nowoczesnych aplikacji webowych.
Pytanie 23
W trakcie weryfikacji stron internetowych nie uwzględnia się
A. błędów w składni kodu
B. źródła pochodzenia narzędzi edytorskichTwoja odpowiedź
C. zgodności z różnymi przeglądarkami
D. działania hiperłączy
Poprawna odpowiedź. Walidacja stron internetowych to proces, który ma na celu zapewnienie, że HTML, CSS oraz inne elementy technologii webowych są zgodne ze standardami określonymi przez W3C (World Wide Web Consortium). W kontekście walidacji nie bada się źródła pochodzenia narzędzi edytorskich, ponieważ te narzędzia, takie jak edytory tekstu czy IDE (Integrated Development Environment), są jedynie medium do tworzenia kodu, a nie jego treści. Z perspektywy walidacji, kluczowe jest, aby kod był syntaktycznie poprawny oraz spełniał standardy interoperability, takie jak HTML5 czy CSS3. Przykładem walidacji może być użycie narzędzi takich jak W3C Validator, które analizują kod strony i wskazują błędy składniowe, problemy z dostępnością oraz niezgodności z różnymi przeglądarkami. Dzięki walidacji, developers mogą zapewnić, że ich strony będą działały poprawnie na różnych urządzeniach i przeglądarkach, co wpływa na lepsze doświadczenia użytkowników. Walidacja jest zatem kluczowym krokiem w procesie tworzenia stron internetowych, zapewniającym ich jakość i zgodność ze światowymi standardami.
Pytanie 24
Które imiona spełniają warunek
SELECTimieFROMmieszkancyWHEREimieLIKE'_r%';
?
A. Krzysztof, Krystyna, Romuald
B. Gerald, Jarosław, Marek, Tamara
C. Arieta, Krzysztof, Krystyna, TristanTwoja odpowiedź
D. Rafał, Rebeka, Renata, Roksana
Poprawna odpowiedź. Wzorzec '_r%' oznacza: jeden dowolny znak (_), potem litera „r”, potem dowolny ciąg (%) - czyli DRUGĄ literą imienia musi być „r”. Pasują np. Arieta, Krzysztof, Krystyna, Tristan. Dlatego to ten zestaw.
Pytanie 25
Którego elementu nie powinno się umieszczać w nagłówku pliku HTML?
A.
<title>
B.
<h2>
Poprawna odpowiedź
C.
<meta>
Twoja odpowiedź
D.
<link>
Niepoprawna odpowiedź. Udzielenie odpowiedzi na pytanie o znaczniki w nagłówku dokumentu HTML może prowadzić do nieporozumień, jeśli nie zrozumie się właściwego kontekstu użycia każdej z opcji. Znacznik <link>, używany do powiązania dokumentu HTML z zasobami zewnętrznymi, takimi jak arkusze stylów CSS, powinien być umieszczany w sekcji <head>, a nie w <body>. Jego zastosowanie ma kluczowe znaczenie dla ładowania stylów na stronie, co wpływa na jej wygląd i układ. Z kolei znaczniki <title> i <meta> również są przeznaczone do umieszczania w sekcji <head> i dostarczają istotnych informacji o stronie, takich jak tytuł, opis i słowa kluczowe. Tytuł wyświetlany jest na pasku tytułowym przeglądarki oraz w wynikach wyszukiwania, a metadane wpływają na SEO oraz udostępnianie treści w serwisach społecznościowych. Niepoprawne byłoby zatem umieszczanie tych znaczników w sekcji <body>, ponieważ nie spełniają swojej funkcji w kontekście strukturalnym dokumentu. Warto pamiętać, że nieprawidłowe umiejscowienie znaczników w HTML narusza standardy W3C, co może prowadzić do problemów z renderowaniem strony i jej użytecznością. Zrozumienie, gdzie i jak stosować różne znaczniki, jest niezbędne dla tworzenia poprawnych i efektywnych stron internetowych.
Pytanie 26
Co umożliwia polecenie BACKUPLOG w MS SQL Server?
A. wykonanie pełnej kopii bazy
B. odczyt komunikatów z tworzenia kopii
C. kopię zapasową dziennika transakcjiTwoja odpowiedź
D. zalogowanie się do kopii zapasowej
Poprawna odpowiedź. Polecenie BACKUPLOG w MS SQL Server tworzy kopię zapasową DZIENNIKA TRANSAKCJI - zapisuje zmiany od ostatniej kopii, co pozwala odtworzyć bazę do konkretnego momentu w czasie. Dlatego BACKUPLOG wykonuje kopię dziennika transakcji.
Pytanie 27
Który typ danych należy przypisać atrybutowi „Telefon”, jeśli numer zaczyna się od znaku „+” i numeru kierunkowego kraju?
A. tekstowyTwoja odpowiedź
B. binarny
C. wyliczeniowy
D. liczbowy
Poprawna odpowiedź. Numer telefonu zaczynający się od „+” i kodu kraju zawiera znaki, których typ liczbowy nie przechowa (np. plus, ewentualne spacje czy zera wiodące), dlatego atrybutowi „Telefon” przypisuje się typ TEKSTOWY. Na numerze i tak nie wykonuje się działań matematycznych. Dlatego właściwy jest typ tekstowy.
Pytanie 28
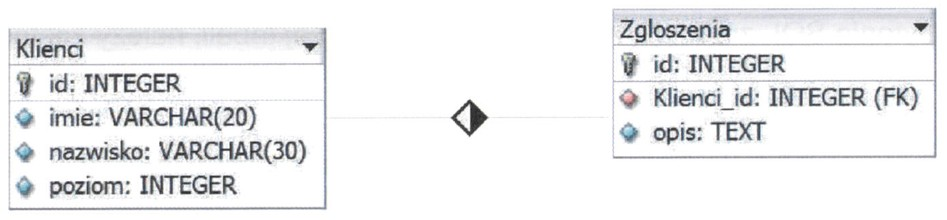
Tabele Klienci oraz Zgłoszenia są ze sobą połączone relacją jeden do wielu. W celu uzyskania jedynie opisu zgłoszenia oraz odpowiadającego mu nazwiska klienta dla zgłoszenia o numerze 5, należy wykonać polecenie
Niepoprawna odpowiedź. Niepoprawne odpowiedzi wynikają z błędnego zrozumienia, jak działa relacja klucz główny-klucz obcy w bazach danych. W relacyjnych bazach danych tabele są często powiązane relacjami, gdzie jedna tabela posiada klucz obcy odnoszący się do klucza głównego innej tabeli. W kontekście zapytania SQL, aby poprawnie połączyć tabele i uzyskać odpowiednie dane, musimy użyć klauzuli JOIN z właściwym warunkiem ON. Błędne odpowiedzi pokazują typowe nieporozumienia: jedna z alternatywnych odpowiedzi próbuje połączyć tabele bez użycia klauzuli ON, co prowadzi do błędnych wyników, ponieważ nie określa w jaki sposób rekordy z tabeli Klienci są powiązane z rekordami z tabeli Zgłoszenia. Inna odpowiedź błędnie zakłada, że filtrujemy dane na podstawie id klienta zamiast id zgłoszenia, co prowadzi do nieprawidłowego zestawu wyników niezgodnego z założeniami zadania. Takie błędy mogą wynikać z niedostatecznego zrozumienia struktury bazy danych oraz mechanizmów filtracji i łączenia danych w SQL. Kluczem do poprawnego zapytania jest jasne zrozumienie, jak relacje w bazach danych pozwalają na efektywne łączenie danych i selekcję pożądanych rekordów, co jest podstawą analizy danych i ich raportowania w systemach informacyjnych. Unikanie takich błędów wymaga znajomości syntaktyki SQL i logicznego sposobu myślenia o danych i ich powiązaniach.
Pytanie 29
W programie MS Access w ustawieniach pola klasa należy określić maskę wprowadzania danych. Jaką maskę należy ustawić, aby dane wprowadzone składały się z trzech znaków w formacie: obowiązkowa cyfra, następnie dwie obowiązkowe litery?
Ogólne
Rozmiar pola
3
Format
Maska wprowadzania
Tytuł
Wartość domyślna
Reguła spr. poprawności
Tekst reguły spr. poprawności
Wymagane
Nie
Zerowa dł. dozwolona
Tak
Indeksowane
Nie
Kompresja Unicode
Tak
Tryb IME
Bez formantu
Tryb zdania edytora IME
Brak
Tagi inteligentne
A. 000
B. 0CCTwoja odpowiedź
C. 0LLPoprawna odpowiedź
D. CLL
Niepoprawna odpowiedź. W przypadku maski wprowadzania danych w MS Access, należy zrozumieć, jakie znaczenie mają poszczególne symbole używane do stworzenia maski. Symbole te określają, co użytkownik może wprowadzić w każdym miejscu pola. Często spotykanym błędem jest wybór niewłaściwego symbolu, co prowadzi do niepoprawnego formatu danych. W przypadku masek takich jak 0CC, 000 i CLL, każda z nich stosuje niewłaściwe podejście do formatu wymaganego w pytaniu. Maska 0CC zakłada, że po cyfrze mogą znajdować się dowolne znaki, co nie spełnia wymagań dotyczących dwóch obowiązkowych liter. Maska 000 z kolei wymusza wprowadzenie trzech cyfr, co całkowicie mija się z celem, ponieważ wymagany jest format składający się z jednej cyfry i dwóch liter. Maska CLL sugeruje, że pierwszy znak może być dowolnym znakiem (cyfrą lub literą), co również jest niezgodne z wymaganiami, gdzie pierwszą pozycję musi zajmować cyfra. Takie nieporozumienia mogą wynikać z braku zrozumienia znaczenia symboli używanych w maskach wprowadzania danych. Kluczem do poprawnego zastosowania masek w MS Access jest więc dokładne poznanie, jakie symbole są dostępne i jakie mają zastosowanie, aby zwiększyć spójność i integralność danych w systemach bazodanowych. Zrozumienie tych zasad pozwala również uniknąć typowych błędów wynikających z niepoprawnej interpretacji wymagań dotyczących formatowania danych, co jest istotne nie tylko w kontekście egzaminacyjnym, ale także w praktycznej pracy z bazami danych. Poprawne zrozumienie i stosowanie masek wprowadzania danych jest elementem profesjonalnego zarządzania danymi, gdzie każda baza musi spełniać określone standardy jakości i wydajności.
Pytanie 30
Jaki znak (lub znaki) rozpoczyna komentarz jednoliniowy w języku JavaScript?
A.
#
B.
<!--
C.
<?
D.
//
Twoja odpowiedź
Poprawna odpowiedź. W JavaScript komentarz jednoliniowy rozpoczyna się od // - wszystko za nim, do końca wiersza, interpreter pomija. Komentarz wieloliniowy ujmuje się natomiast w /*...*/. Komentarze służą do opisu kodu i czasowego wyłączania fragmentów; nie wpływają na działanie programu. Dlatego komentarz jednoliniowy w JS otwiera //.
Pytanie 31
Znacznik <ins> w HTML jest używany do wskazywania
A. tekstu, który został usuniętyTwoja odpowiedź
B. tekstu, który został przeformatowany
C. cytowanego fragmentu tekstu
D. tekstu, który został dodanyPoprawna odpowiedź
Niepoprawna odpowiedź. Wybierając błędne odpowiedzi, pokazujesz, że coś może być niejasne, jeśli chodzi o znaczniki HTML. Na przykład, myślenie, że <ins> to znacznik do oznaczania cytatów, to pomyłka. Do tego zadania służy <blockquote> albo <q>, które mają swoje własne, zupełnie inne znaczenie. Jeśli wybrałeś opcję mówiącą o oznaczaniu usuniętego tekstu, to też jest błąd, bo do tego mamy znacznik <del>. A użycie <ins> w kontekście zmiany formatu tekstu to jeszcze jedna pomyłka, bo ten znacznik nie mówi nic o formatowaniu. Tak naprawdę, <ins> tylko wskazuje nowe fragmenty tekstu, a nie zmienia ich stylu. Jeżeli nie rozumiesz tych funkcji różnych znaczników HTML, to łatwo można wpaść w pułapkę błędów w kodzie, co później będzie miało wpływ na semantykę stron oraz ich dostępność. Dlatego tak ważne jest, żeby znać różnice między tymi znacznikami i korzystać z nich, jak należy.
Pytanie 32
Które narzędzie wiersza poleceń tworzy KOPIĘ ZAPASOWĄ bazy MySQL (zrzut do pliku)?
A.
mysqlcheck
B.
mysqldump
Poprawna odpowiedź
C.
create
D.
truncate
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe pozycje nie tworzą backupu. mysqlcheck sprawdza i naprawia tabele, truncate czyści tabelę z danych, a create tworzy obiekty. Zrzut bazy do pliku wykonuje mysqldump.
Pytanie 33
Aby utworzyć nową bazę danych, należy użyć polecenia SQL:
A.
NEWDATABASE
B.
CREATETABLE
C.
CREATEDATABASE
Twoja odpowiedź
D.
ALTERDATABASE
Poprawna odpowiedź. Nową bazę danych zakłada polecenie CREATEDATABASE, po którym podaje się jej nazwę, np. CREATEDATABASEsklep. Dopiero w utworzonej bazie tworzy się tabele poleceniem CREATETABLE. Oba należą do języka DDL. Dlatego do utworzenia bazy służy CREATEDATABASE.
Pytanie 34
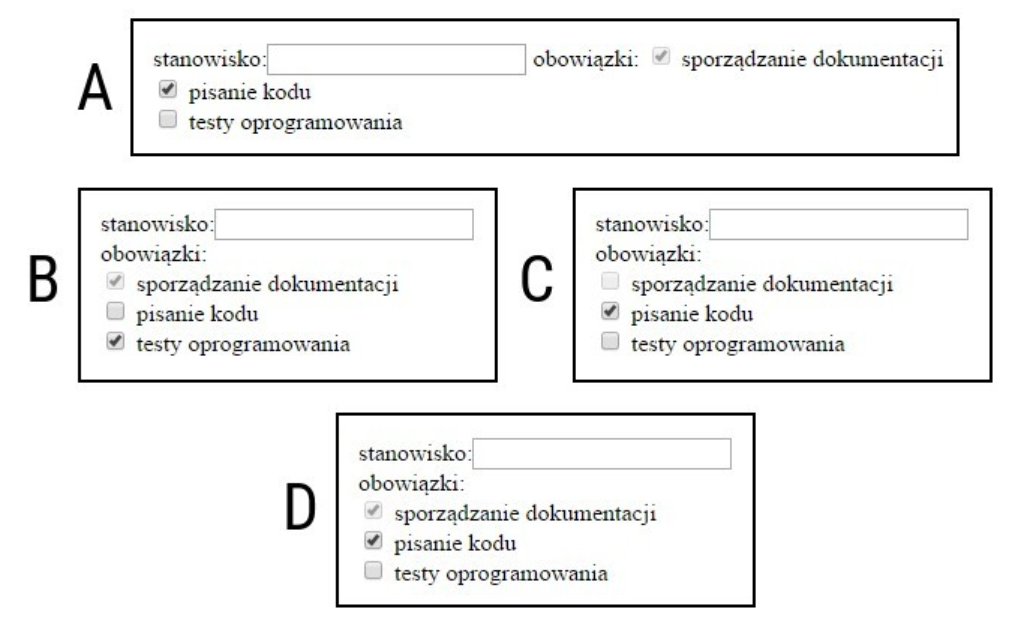
Zamieszczony kod HTML formularza zostanie wyświetlony przez przeglądarkę w sposób:
Poprawna odpowiedź. Odpowiedź D wynika bezpośrednio z kolejności elementów i atrybutów w formularzu HTML. Po napisie stanowisko: znajduje się pole tekstowe input type=text, a zaraz po nim znacznik przełamania linii br, więc tekst obowiązki: musi pojawić się w następnym wierszu. Po obowiązki: jest następne br, dlatego lista pól checkbox zaczyna się jeszcze niżej. Pierwszy checkbox ma jednocześnie atrybuty disabled oraz checked, więc będzie zaznaczony, ale nieaktywny, zwykle wyszarzony i użytkownik nie będzie mógł go odznaczyć. To ważny szczegół, bo samo disabled nie usuwa zaznaczenia z ekranu. Drugi checkbox ma checked, więc jest zaznaczony normalnie. Trzeci nie ma checked, więc pozostaje pusty. Moim zdaniem to dobry przykład na to, że w HTML często decydują małe atrybuty bez wartości, takie jak checked, disabled czy required. W praktyce przy formularzach trzeba też pamiętać, że pole disabled nie jest wysyłane z formularzem do serwera, nawet jeśli wygląda na zaznaczone. To jest zgodne z działaniem standardowych kontrolek formularzy HTML i ma znaczenie np. przy projektowaniu ankiet, paneli administracyjnych albo formularzy rekrutacyjnych.
Pytanie 35
Jaki jest wynik wykonania pętli for w poniższym kodzie PHP, jeśli chodzi o wypisanie liczb?
Niepoprawna odpowiedź. Analizując inne odpowiedzi zwróćmy uwagę na błędy w logice pętli i operacji modulo które mogą prowadzić do błędnych wyników. Jedną z częstych pomyłek jest niedokładne zrozumienie działania operatora % który zwraca resztę z dzielenia. W kontekście pętli for ważne jest zrozumienie że zmienna kontrolująca i jest modyfikowana zgodnie z określonym krokiem tutaj i -= 2 co oznacza że i zmniejsza się o 2 w każdej iteracji pętli. Niepoprawne odpowiedzi mogą wynikać z założenia że pętla wykonuje się dla innych wartości i niż te faktycznie użyte. Na przykład wynik 1 0 1 0 sugeruje błędne założenie o nieparzystym kroku lub innej inicjalizacji zmiennej i. Możliwe że interpretacja warunku końcowego i > 1 nie została właściwie zrozumiana co prowadzi do założenia że pętla trwa dłużej niż powinna. Innym błędem może być zaniedbanie uwzględnienia kolejności wykonania instrukcji w ciele pętli. Zapominanie o dokładnym zrozumieniu jak działa i jest modyfikowane w każdej iteracji pętli może prowadzić do oczekiwania niepoprawnych wyników. Edukacyjnie ważne jest upewnienie się że każdy krok pętli jest dokładnie przeanalizowany a wynik działania operatora modulo jest zawsze przewidywalnie interpretowany w ramach iteracji pętli. Zrozumienie tych zasad jest kluczowe w pisaniu wydajnego i bezbłędnego kodu w PHP i innych językach programowania.
Pytanie 36
Który znacznik HTML jest elementem BLOKOWYM?
A.
<p>
Poprawna odpowiedź
B.
<img>
C.
<span>
Twoja odpowiedź
D.
<strong>
Niepoprawna odpowiedź. Pozostałe znaczniki są LINIOWE (inline). <span> oznacza fragment tekstu, <strong> pogrubia, a <img> wstawia obraz w linii - nie wymuszają nowej linii. Elementem blokowym jest <p>.
Pytanie 37
Który obiekt bazy danych służy głównie do drukowania lub wyświetlania zestawień danych?
A. makro
B. moduł
C. raportTwoja odpowiedź
D. formularz
Poprawna odpowiedź. Raport to obiekt bazy przeznaczony głównie do DRUKOWANIA i wyświetlania zestawień - grupuje, sortuje i podsumowuje dane w przejrzystej, gotowej do wydruku formie. Zapamiętaj: gdy potrzebujesz wydruku lub czytelnego podsumowania, tworzysz raport.
Pytanie 38
Przyjmując, że użytkownik Adam nie miał dotychczas żadnych uprawnień, polecenie SQL przyzna mu prawa jedynie do
GRANTCREATE, ALTERONsklep.*TOadam;
A. tworzenia i zmiany struktury wszystkich tabel w bazie sklepPoprawna odpowiedź
B. tworzenia oraz modyfikowania struktury w tabeli sklepTwoja odpowiedź
C. dodawania i modyfikacji danych we wszystkich tabelach bazy sklep
D. dodawania i modyfikacji danych w tabeli sklep
Niepoprawna odpowiedź. Ta odpowiedź nie jest właściwa, bo dotyczy wstawiania i zmieniania danych w tabeli 'sklep', a tak naprawdę polecenie SQL daje tylko uprawnienia do zmiany struktury tabel, nie do danych w środku. Do wstawiania danych potrzebne jest użycie komendy 'INSERT', której tutaj w ogóle nie ma. Jak ktoś ma tylko prawa do tworzenia i zmiany struktury tabel, to nie może dodać ani zmienić danych, a to jest kluczowe do operacji na danych. I jeszcze jedno – odpowiedzi, które mówią o ograniczeniu do jednej tabeli, też są błędne, bo 'sklep.*' dotyczy wszystkich tabel w bazie. Ważne, żeby rozróżniać te uprawnienia, bo często ludzie mylą uprawnienia do zarządzania strukturą tabel z możliwościami operacji na danych. To zrozumienie różnic jest kluczowe dla bezpiecznego zarządzania bazami danych i trzymania się zasady minimalnych uprawnień, co jest naprawdę dobrą praktyką w świecie bezpieczeństwa informatycznego.
Pytanie 39
Znaczniki HTML <strong> oraz <em>, które mają na celu podkreślenie istotności tekstu, pod względem formatowania odpowiadają znacznikom
A.
<i> oraz <mark>
B.
<u> oraz <sup>
C.
<b> oraz <i>
Twoja odpowiedź
D.
<b> oraz <u>
Poprawna odpowiedź. Znaczniki HTML <strong> oraz <em> mają kluczowe znaczenie w kontekście semantyki i formatowania tekstu w dokumentach HTML. Znacznik <strong> wskazuje na tekst o zwiększonej ważności, co jest zgodne z jego domyślnym formatowaniem, które w większości przeglądarek wyświetla tekst pogrubiony. Z kolei znacznik <em> sugeruje tekst, który powinien być akcentowany w odpowiedni sposób, a jego domyślne formatowanie to kursywa. W związku z tym, ich odpowiednikami pod względem formatowania są znaczniki <b> oraz <i>. Znacznik <b> służy do pogrubienia tekstu, ale nie niesie ze sobą żadnej dodatkowej semantyki, natomiast <i> używany jest do kursywy bez wskazania na ważność. W praktyce, należy używać <strong> i <em> tam, gdzie semantyka jest kluczowa dla zrozumienia treści, a dodatkowe znaczenie przekłada się na lepsze pozycjonowanie w wyszukiwarkach oraz dostępność dla osób korzystających z technologii asystujących. Ważne jest, by przestrzegać dobrych praktyk webowych i stosować znaczniki semantyczne, co pozwoli na efektywne przekazywanie informacji zarówno użytkownikom, jak i robotom indeksującym.
Pytanie 40
Jaką metodę przesyłania należy wykorzystać, by zapewnić największe bezpieczeństwo danych zaszyfrowanych w formularzu, które są wysyłane do kodu PHP?
A. Metoda GET, za pomocą protokołu HTTP
B. Metoda POST, za pomocą protokołu HTTP
C. Metoda POST, za pomocą protokołu HTTPSTwoja odpowiedź
D. Metoda GET, za pomocą protokołu HTTPS
Poprawna odpowiedź. Jak wiemy, wybieranie metody POST przy użyciu HTTPS to naprawdę najlepszy sposób na przesyłanie wrażliwych danych. Dlaczego? Bo metoda POST przesyła dane w ciele żądania, więc są one mniej widoczne dla niepowołanych osób. W przeciwieństwie do metody GET, która wrzuca wszystko do adresu URL. A protokół HTTPS to już zupełnie inna bajka, bo szyfruje cały ruch między użytkownikiem a serwerem. W praktyce to znaczy, że nasze dane, przykładowo hasła w formularzach logowania, są lepiej chronione przed podsłuchiwaniem. Oprócz tego warto pamiętać o standardach OWASP, które mocno podkreślają, jak ważne jest stosowanie HTTPS i POST tam, gdzie przesyłamy wrażliwe informacje. To naprawdę mogłoby uratować nas przed różnymi atakami, jak Man-in-the-Middle, więc nie ma co ryzykować i warto stosować te metody.