Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 30 września 2026 15:22
Zakończenie: 30 września 2026 15:24
Egzamin niezdany
Wynik: 1/40 punktów (2,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 7% podejść do kwalifikacji INF.04.
Porównanie z 23512 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Która z operacji logicznych zwróci wartość "true", gdy obie zmienne są sobie równe?
A.
x||y
B.
x==y
Poprawna odpowiedź
C.
x!=y
Twoja odpowiedź
D.
x&&y
Niepoprawna odpowiedź. Operator `x && y` to operator logiczny `AND`, który zwraca `true` tylko wtedy, gdy zarówno `x`, jak i `y` są prawdziwe (różne od zera). Operator `x || y` to operator `OR`, który zwraca `true`, jeśli przynajmniej jedna z wartości jest prawdziwa. Operator `x != y` to operator nierówności, który zwraca `true`, jeśli wartości `x` i `y` są różne. Żaden z tych operatorów nie służy do porównywania równości dwóch wartości w taki sposób jak `==`.
Pytanie 2
Jakie cechy powinien posiadać skuteczny negocjator?
A. lojalność, nieśmiałość, uczciwość
B. dobra reputacja, przekora, porywczośćTwoja odpowiedź
C. asertywność, pesymizm, buta
D. intuicja, cierpliwość, asertywnośćPoprawna odpowiedź
Niepoprawna odpowiedź. Analizując pozostałe propozycje, łatwo zauważyć, że zawierają one cechy, które niekoniecznie przekładają się na skuteczność w negocjacjach, a wręcz mogą utrudniać osiąganie korzystnych rezultatów. Często mylimy lojalność z umiejętnością prowadzenia twardych rozmów – bycie lojalnym wobec własnej firmy czy wartości jest ważne, ale nieśmiałość to cecha, która wyklucza aktywne uczestnictwo w negocjacjach. Osoba nieśmiała może bać się zabrać głos, wyrazić swoje potrzeby, co finalnie prowadzi do ustępstw na własną niekorzyść. Uczciwość – jasne, to fundament relacji biznesowych, tyle że sama uczciwość nie wystarczy, jeśli nie potrafimy prowadzić rozmów stanowczo i efektywnie. Dobra reputacja, przekora i porywczość to kolejny zestaw, który jest trochę mylący. Przekora sugeruje upór dla zasady, co w negocjacjach prowadzi do impasu. Porywczość natomiast sprawia, że negocjator daje się ponieść emocjom, a przecież właśnie opanowanie i zimna kalkulacja są wysoko cenione w tej profesji. Dobra reputacja jest atutem, ale jej brak nie wyklucza sukcesów negocjacyjnych – dużo ważniejsze są konkretne umiejętności. Z kolei zestawienie asertywności z pesymizmem i butą zupełnie się nie sprawdza. Pesymizm z góry zakłada niepowodzenie, co wpływa negatywnie na pewność siebie oraz stosunek do rozmówcy. Buta natomiast często prowadzi do niepotrzebnych spięć i zamyka drogę do kompromisu. W praktyce, profesjonaliści rekomendują, aby stawiać na empatię, cierpliwość, opanowanie, otwartość i umiejętność słuchania. Typowym błędem jest skupienie się na jednej pozytywnej cesze i ignorowanie jej kontekstu czy zestawienia z innymi – skuteczny negocjator to nie tylko ktoś z dobrą reputacją czy asertywnością, ale osoba, która potrafi połączyć wiele cech i narzędzi, by elastycznie reagować na zmieniające się warunki rozmów. Warto o tym pamiętać, analizując wymagania stawiane przed negocjatorami zarówno w podręcznikach, jak i praktyce zawodowej.
Pytanie 3
Początkowym celem środowisk IDE takich jak: lntellij IDEA, Eclipse, NetBeans jest programowanie w języku
A. C#
B. C++
C. PythonTwoja odpowiedź
D. JavaPoprawna odpowiedź
Niepoprawna odpowiedź. C# jest językiem programowania opracowanym przez firmę Microsoft, który jest głównie używany w ekosystemie .NET. Chociaż istnieją IDE, które wspierają C#, takie jak Visual Studio, to IntelliJ IDEA, Eclipse i NetBeans nie zostały zaprojektowane z myślą o tym języku. C++ jest językiem programowania o dużych możliwościach, stosowanym głównie w systemach operacyjnych, oprogramowaniu sterownikowym oraz aplikacjach wymagających wysokiej wydajności. Chociaż istnieją wtyczki do Eclipse, które wspierają C++, to głównym celem tych IDE nie jest rozwój w tym języku, a ich główne funkcje koncentrują się na Java. Python, znany ze swojej prostoty i przyjazności dla początkujących, ma również swoje dedykowane środowiska IDE, takie jak PyCharm i Anaconda, które są bardziej optymalne dla tego języka. IDE, takie jak IntelliJ IDEA, Eclipse i NetBeans, nie oferują pełnego wsparcia dla Pythona, co sprawia, że programowanie w tym języku w tych środowiskach nie jest tak efektywne, jak w dedykowanych narzędziach.
Pytanie 4
Który z objawów może sugerować zawał serca?
A. Gorączka oraz dreszcze
B. Ból brzucha po spożyciu posiłku
C. Intensywny ból w klatce piersiowej promieniujący do lewej rękiPoprawna odpowiedź
D. Spadek nastrojuTwoja odpowiedź
Niepoprawna odpowiedź. Ból brzucha po zjedzeniu posiłku jest częstym objawem problemów trawiennych, takich jak refluks żołądkowy, niestrawność lub wrzody, ale nie wskazuje na zawał serca. Gorączka i dreszcze mogą być oznaką infekcji lub grypy, a nie problemów kardiologicznych. Obniżenie nastroju jest objawem psychologicznym, związanym z depresją lub zmęczeniem, ale nie wskazuje na nagłe zagrożenie zdrowotne związane z sercem. Rozpoznanie i rozróżnienie tych objawów jest kluczowe dla szybkiej diagnozy i leczenia.
Pytanie 5
W zamieszczonej ramce znajdują się notatki testera dotyczące przeprowadzanych testów aplikacji. Jakiego typu testy planuje przeprowadzić tester?
zmierzyć czas zalogowania się użytkownika
ustalić domyślną liczbę produktów na stronie, dla której renderowanie jest akceptowalne czasowo
czy wizualizacja danych na mapie przebiega bez opóźnień?
czy czas logowania wzrasta znacznie przy logowaniu 10 użytkowników, 100, 1000?
jaka minimalna prędkość pobierania jest wymagana, aby aplikacja była zaakceptowana przez klienta?
A. BezpieczeństwaTwoja odpowiedź
B. Jednostkowe
C. Interfejsu
D. WydajnościowePoprawna odpowiedź
Niepoprawna odpowiedź. Testy jednostkowe, choć niezwykle ważne, koncentrują się na weryfikacji małych fragmentów kodu, zwykle pojedynczych funkcji lub metod. Mają one na celu upewnienie się, że każdy komponent działa zgodnie z oczekiwaniami. W kontekście pytania, które odnosi się do mierzenia czasu logowania i wydajności pod obciążeniem, testy jednostkowe nie są odpowiednie, ponieważ nie sprawdzają, jak system radzi sobie z różnym obciążeniem. Testy interfejsu koncentrują się na sprawdzaniu, czy użytkownik może wchodzić w interakcje z systemem w sposób intuicyjny i bezbłędny. Nie dotyczą jednak aspektów wydajnościowych, takich jak czas renderowania czy czas logowania przy dużym obciążeniu. Z kolei testy bezpieczeństwa są niezbędne do identyfikacji luk w systemie, które mogłyby być wykorzystane przez atakujących. Skupiają się na takich aspektach jak kontrola dostępu, ochrona danych i odporność na ataki typu DDoS. W pytaniu jednak nie ma odniesienia do kwestii bezpieczeństwa, takich jak czy system jest odporny na eskalację uprawnień czy ataki typu SQL Injection. Często błędnie myśli się, że wystarczy sprawdzić podstawowe funkcje aplikacji, ignorując, jak zachowuje się ona pod obciążeniem, co jest krytycznym aspektem jej rzeczywistej użyteczności w środowisku produkcyjnym. Aby zapewnić pełną jakość aplikacji, konieczne jest przeprowadzanie wszystkich typów testów odpowiednio do ich celu, ale w kontekście pytania tylko testy wydajnościowe bezpośrednio odnoszą się do przedstawionych zagadnień związanych z czasem odpowiedzi i obciążeniem systemowym.
Pytanie 6
Jakie ma znaczenie operator "==" w języku C++?
A. Przypisanie wartości do zmiennej
B. Zwiększenie wartości zmiennej o 1Twoja odpowiedź
C. Porównanie dwóch wartościPoprawna odpowiedź
D. Negacja logiczna
Niepoprawna odpowiedź. Operator `=` to operator przypisania, który służy do przypisywania wartości do zmiennej (`a = 5`). Jest to jedna z najczęstszych przyczyn błędów logicznych, gdy zamiast `==` przypadkowo używa się `=`, co prowadzi do przypisania wartości zamiast porównania. Operator `!=` oznacza nierówność i zwraca `true`, gdy dwie wartości są różne, co jest przeciwieństwem `==`. Operator `!` to negacja logiczna – przekształca wartość logiczną na jej przeciwną, np. `!true` zwraca `false`. W żadnym z tych przypadków operatory te nie służą do porównywania równości w taki sposób, jak `==`.
Pytanie 7
Po wykonaniu poniższego kodu na konsoli zostanie wyświetlona liczba:
inta=0x73;cout<<a;
A. 0Twoja odpowiedź
B. 108
C. 73
D. 115Poprawna odpowiedź
Niepoprawna odpowiedź. Wiele osób myli się, gdy widzi zapis 0x73, uznając, że to po prostu liczba 73 w dziesiętnym, bo tak wygląda najprościej. Jednak w rzeczywistości ten prefiks „0x” informuje kompilator, że mamy do czynienia z liczbą zapisaną w systemie szesnastkowym (heksadecymalnym), a nie dziesiętnym. To jest taki bardzo charakterystyczny zapis w językach programowania (C, C++, Java, czasem nawet Python), który pozwala programiście jasno określić, w jakim systemie podaje liczbę. Zakładając, że ktoś wybierze 108 lub 73, można podejrzewać, że ta osoba nie przeliczyła heksadecymalnej liczby na dziesiętną lub po prostu nie zwróciła uwagi na prefiks. 0x73 to w rzeczywistości (7 * 16) + 3, czyli 112 + 3, co daje 115. Niektórym może się też wydawać, że heksadecymalne 0x73 to 73 dziesiętnie, ale to typowy błąd początkujących. Wybór zera z kolei może wynikać z nieporozumienia – być może ktoś pomyślał, że a nie zostało zainicjalizowane lub kod nie wypisuje nic, ale tutaj jawnie inicjujemy a wartością heksadecymalną. Praktyka pokazuje, że podobne nieporozumienia pojawiają się na początku nauki programowania, szczególnie gdy nie ma jeszcze „wyczucia” systemów liczbowych. Tak naprawdę, jeśli chcemy być profesjonalni, trzeba od razu nauczyć się, że każda liczba z 0x na początku jest heksadecymalna, a cout zawsze wypisze jej dziesiętną reprezentację, o ile nie zmienimy flagi strumienia (std::hex itd.). To takie podstawy, które potem pozwalają pewniej obracać się w kodzie, gdzie często występują maski bitowe czy operacje na rejestrach. Moim zdaniem, wielu początkujących inżynierów właśnie przez nieuwagę na takie detale traci sporo czasu na debugowanie prostych błędów. Warto więc na przyszłość za każdym razem zatrzymać się na chwilę i zastanowić, czy na pewno dobrze rozpoznajemy system liczbowy wykorzystywany w danym fragmencie kodu.
Pytanie 8
Co to jest API w kontekście programowania?
A. System zarządzania relacyjnymi bazami danychTwoja odpowiedź
B. Metoda kompresji danych w aplikacjach webowych
C. Narzędzie do testowania interfejsu użytkownika aplikacji
D. Interfejs programistyczny aplikacji, który definiuje sposób komunikacji między różnymi komponentami oprogramowaniaPoprawna odpowiedź
Niepoprawna odpowiedź. Pojęcie API jest często mylone z innymi aspektami programowania, co może prowadzić do nieporozumień. Narzędzia do testowania interfejsu użytkownika aplikacji, choć ważne, dotyczą zupełnie innej dziedziny niż API. Testowanie interfejsu użytkownika koncentruje się na ocenie, jak dobrze aplikacja działa z perspektywy użytkownika, a nie na tym, jak różne komponenty oprogramowania komunikują się ze sobą. Z kolei metoda kompresji danych w aplikacjach webowych odnosi się do technik optymalizacji przesyłanych informacji, ale nie ma nic wspólnego z definiowaniem komunikacji między systemami. Kompresja może poprawić wydajność aplikacji, ale nie wpływa na sposób, w jaki te aplikacje ze sobą współdziałają. Ponadto, systemy zarządzania relacyjnymi bazami danych (RDBMS) to narzędzia do przechowywania i zarządzania danymi, które mogą być wykorzystywane przez API, ale nie definiują, czym jest API. Często błędne podejście do zrozumienia API wynika z braku znajomości tego, jak różne technologie współdziałają w ekosystemie programistycznym. Kluczowe jest zrozumienie, że API jest narzędziem do ułatwienia komunikacji między różnymi aplikacjami, co jest fundamentem nowoczesnych architektur oprogramowania.
Pytanie 9
Która biblioteka JavaScript jest najczęściej używana do tworzenia testowalnych funkcji asynchronicznych?
A. AxiosTwoja odpowiedź
B. Underscore.js
C. D3.js
D. Moment.js
Poprawna odpowiedź. Axios jest jedną z najpopularniejszych bibliotek JavaScript używanych do obsługi żądań HTTP, zwłaszcza w kontekście asynchronicznych operacji. Umożliwia łatwe tworzenie funkcji asynchronicznych, które mogą komunikować się z serwerami. Dzięki wsparciu dla obietnic (Promises), Axios pozwala na prostsze zarządzanie wynikami operacji asynchronicznych. Przykładowo, można użyć go do wykonywania zapytań do API w aplikacjach webowych. Przy pomocy Axios, developerzy mogą łatwo wysyłać żądania GET, POST i inne, a także obsługiwać odpowiedzi i błędy. Z perspektywy dobrych praktyk, Axios wspiera interceptory, które pozwalają na globalne zarządzanie zapytaniami i odpowiedziami, co jest szczególnie przydatne w dużych aplikacjach. Co więcej, Axios obsługuje również anulowanie żądań, co może być istotne w kontekście użytkowników, którzy mogą na przykład zmienić zdanie przed zakończeniem operacji. Takie cechy czynią Axios narzędziem niezwykle przydatnym w nowoczesnym programowaniu JavaScript.
Pytanie 10
Jakie jest poprawne określenie interfejsu (szablonu klasy) w języku Java?
Wyjaśnienie poprawnej odpowiedzi: W języku Java interfejs określa zbiór abstrakcyjnych metod, które klasa implementująca musi zaimplementować. Poprawna definicja interfejsu nie zawiera zmiennych instancji ani konstruktorów, co jest błędem w pierwszej definicji. Interfejsy służą do deklarowania metod, które są automatycznie publiczne i abstrakcyjne. W czwartej definicji, interfejs IMyInterface zawiera dwie metody mth1 i mth2 bez implementacji, co jest zgodne z zasadami Javy. Metody w interfejsie nie mają ciał, co wskazuje, że są przeznaczone do implementacji w klasie, która zadeklaruje się jako implementująca ten interfejs. Interfejsy są kluczowe dla polimorfizmu w Javie, pozwalając na tworzenie kodu, który może pracować z obiektami różnych klas w jednolity sposób, o ile klasy te implementują wspólny interfejs. Zastosowanie interfejsów zwiększa spójność i elastyczność kodu, umożliwiając łatwe dodawanie nowych funkcjonalności bez ingerencji w istniejącą strukturę kodu. Interfejsy są także wykorzystywane do tworzenia klasycznych wzorców projektowych jak Adapter, Strategia czy Obserwator, co jest dobrą praktyką w programowaniu obiektowym.
Pytanie 11
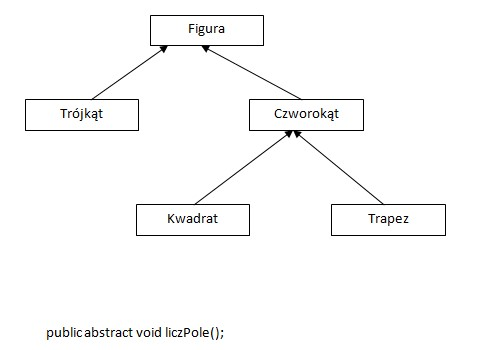
Przyjmując, że opisana hierarchia klas właściwie odzwierciedla figury geometryczne i każda figura ma zdefiniowaną metodę do obliczania pola, to w której klasie można znaleźć deklarację metody liczPole()?
A. trójkąt
B. czworokąt
C. trapez
D. figuraPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Deklaracja metody liczPole() powinna znajdować się w klasie bazowej, czyli w tym przypadku w klasie „figura”. To podejście jest zgodne z zasadami programowania obiektowego i tzw. polimorfizmem. Dzięki temu każda klasa dziedzicząca po „figurze” jest zobowiązana do własnej implementacji tej metody. To bardzo praktyczne rozwiązanie, bo umożliwia tworzenie ogólnych kolekcji (np. List<Figura>), które mogą przechowywać obiekty różnych figur, a następnie wywoływać liczPole() na każdym z nich bez zastanawiania się, jakiego typu to dokładnie obiekt. Z mojego doświadczenia wynika, że tak właśnie projektuje się API i biblioteki geometryczne – klasa bazowa narzuca kontrakt, a szczegóły są po stronie konkretnych figur. Warto dodać, że zgodnie z dobrymi praktykami, do deklarowania takich metod używa się słowa kluczowego „abstract”, co jasno komunikuje, że metoda musi być uzupełniona w klasach potomnych. Takie podejście mocno ułatwia rozbudowę kodu, np. kiedy chcemy dodać nowy typ figury, wystarczy, że nadpiszemy liczPole(). Moim zdaniem to jeden z najfajniejszych przykładów, jak dobrze przemyślana architektura kodu oszczędza czas i nerwy programistom.
Pytanie 12
Który z poniższych elementów UI umożliwia graficzną nawigację pomiędzy różnymi sekcjami aplikacji?
A. Obszar tekstowy
B. Przycisk opcji
C. MenuPoprawna odpowiedź
D. Rozwijana lista
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Pasek menu to kluczowy element interfejsu użytkownika, który umożliwia wizualną nawigację pomiędzy różnymi sekcjami aplikacji. Paski menu są powszechnie stosowane w aplikacjach desktopowych i mobilnych, ponieważ pozwalają na szybki dostęp do różnych funkcji oraz ustawień. Dzięki ich hierarchicznej strukturze użytkownicy mogą łatwo odnaleźć potrzebne narzędzia i opcje, co zwiększa intuicyjność i wygodę korzystania z aplikacji.
Pytanie 13
Przeprowadzając analizę kodu interfejsu graficznego napisanego w języku XAML, można zauważyć, że:
A. przyciski są ustawione poziomo obok siebiePoprawna odpowiedź
B. obraz znajduje się po lewej stronie, a pozostałe elementy po prawej
C. elementy: tekst, obraz, przycisk Like, przycisk Share, tekst są ułożone jeden pod drugim
D. tekst "Fotograf" znajduje się po prawej stronie obrazu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W analizowanym kodzie XAML widzimy, że element <StackLayout> z atrybutem Orientation="Horizontal" zawiera przyciski <Button> z tekstami "Like" i "Share". W XAML, stosując stack layout z orientacją poziomą, elementy w nim zawarte są umieszczane obok siebie w rzędzie. To sprawia, że przyciski "Like" i "Share" są widoczne na interfejsie użytkownika ułożone poziomo, zgodnie z tym, co jest opisane w poprawnej odpowiedzi. Użycie StackLayout z orientacją poziomą to często spotykana praktyka w projektowaniu interfejsów, gdy chcemy zorganizować elementy w rzędzie, na przykład przyciski na pasku narzędzi. Zrozumienie tego mechanizmu jest istotne, ponieważ pozwala na efektywne zarządzanie przestrzenią w aplikacjach mobilnych i webowych, gdzie dostępne miejsce może być ograniczone. Praktyczne zastosowanie takiego układu można zobaczyć na przykład w projektowaniu formularzy, gdzie grupujemy elementy w logiczny sposób, ułatwiając użytkownikowi interakcję z aplikacją. Dobre praktyki w projektowaniu interfejsów użytkownika zalecają, aby układ elementów był intuicyjny i zgodny z oczekiwaniami użytkowników, co StackLayout z orientacją poziomą doskonale realizuje w wielu przypadkach.
Pytanie 14
Który z wymienionych elementów stanowi przykład złożonego typu danych?
A.
struct
Poprawna odpowiedź
B.
char
C.
int
D.
bool
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Typ 'struct' w C++ to super sprawa, bo pozwala na trzymanie różnych danych pod jedną nazwą. Dzięki temu można łatwo zorganizować zmienne, które różnią się typami. Wyobraź sobie, że możesz stworzyć strukturę, która będzie reprezentować na przykład samochód z jego marką, rocznikiem i ceną. To naprawdę ułatwia pracę z danymi! Każde pole w strukturze może mieć inny typ, co czyni 'struct' bardzo uniwersalnym narzędziem do modelowania różnych obiektów, jak ludzie czy produkty. W zasadzie, to takie logiczne pudełko, do którego wrzucasz różne informacje i masz do nich szybki dostęp.
Pytanie 15
Jakie cechy posiada model prototypowy w zakresie zarządzania projektami?
A. Realizowaniem pełnej wersji produktu przed przeprowadzeniem testów
B. Szczegółowym planowaniem każdego etapu projektu przed jego realizacją
C. Rozwojem produktu w sposób iteracyjny w krótkich cyklach
D. Przygotowaniem wersji systemu w ograniczonym zakresie w celu uzyskania opinii od użytkownikaPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Model prototypowy w zarządzaniu projektami to taka sprytna technika, gdzie tworzymy coś w rodzaju wczesnej wersji systemu, czyli prototypu. To nam pozwala zebrać opinie od użytkowników i przetestować różne pomysły zanim w ogóle weźmiemy się za pełną wersję. Fajną sprawą jest to, że gdy mamy ten prototyp, to łatwiej wyłapać błędy, zanim wszystko zostanie w pełni zbudowane. Największa zaleta? Możemy dostosować i poprawiać aplikację na podstawie tego, co mówią użytkownicy. Dzięki temu ryzyko, że stworzymy coś, co nie spełnia ich oczekiwań, jest znacznie mniejsze. Prototypy to często chleb powszedni w projektach UX/UI, aplikacjach webowych czy oprogramowaniu dla firm, gdzie tak istotne jest, by dobrze trafiać w potrzeby końcowych użytkowników.
Pytanie 16
Tworząc aplikację opartą na obiektach, należy założyć, że program będzie zarządzany przez
A. definicję warunków końcowego rozwiązania
B. zbiór instancji klas współpracujących ze sobąPoprawna odpowiedź
C. pętlę dyspozytora, która w zależności od zdarzenia wywoła właściwą funkcję
D. moduły zawierające funkcje oraz zmienne globalne
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: W programowaniu obiektowym najważniejsze jest właśnie to, że wszystko opiera się na współpracujących ze sobą instancjach klas, czyli obiektach. To one przechowują dane (atrybuty) i zachowania (metody), a cała logika programu kręci się wokół ich interakcji. W praktyce oznacza to, że projektując aplikację, skupiasz się na tym, jakie obiekty będą potrzebne (np. Użytkownik, Zamówienie, Produkt), jakie mają cechy i jak ze sobą współpracują. Takie podejście pozwala na łatwiejsze zarządzanie złożonymi programami – moim zdaniem dużo prościej utrzymać i rozwijać kod, gdy jest podzielony na logiczne byty. To też zgodne ze standardami jak SOLID czy wzorce projektowe typu MVC, gdzie każda część aplikacji odpowiada za coś konkretnego, a komunikacja odbywa się przez wywołania metod. Przykład? W sklepie internetowym klasy takie jak Koszyk i Produkt "rozmawiają" ze sobą: koszyk dodaje produkt, sprawdza jego stan itd. Co ciekawe, takie ułożenie bardzo ułatwia testowanie jednostkowe – testujesz zachowanie pojedynczych obiektów, zamiast całych skomplikowanych funkcji rozsianych po programie. Z własnego doświadczenia mogę powiedzieć, że praca z kodem opartym o obiekty jest po prostu przyjemniejsza, mniej chaotyczna i zdecydowanie bardziej odporna na błędy przy rozwoju projektu.
Pytanie 17
Jakiego typu funkcja jest tworzona poza klasą, ale ma dostęp do jej prywatnych i chronionych elementów?
A. Konstruktor
B. Funkcja zaprzyjaźnionaPoprawna odpowiedź
C. Destruktor
D. Metoda statyczna
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Funkcja zaprzyjaźniona to specjalny typ funkcji, który jest deklarowany jako 'friend' w ciele klasy, co pozwala jej na dostęp do prywatnych i chronionych składowych tej klasy. Chociaż funkcja zaprzyjaźniona jest definiowana poza klasą, może operować na jej wewnętrznych danych, co czyni ją bardzo użytecznym narzędziem w programowaniu obiektowym. Tego rodzaju funkcje są często wykorzystywane w przypadkach, gdy konieczne jest współdziałanie dwóch klas lub funkcji narzędziowych, które muszą manipulować danymi wewnętrznymi klasy, ale nie powinny być jej metodami członkowskimi. Dzięki funkcjom zaprzyjaźnionym można zapewnić elastyczność w dostępie do danych przy jednoczesnym zachowaniu hermetyzacji klasy. Przykładem może być przeciążenie operatorów, np. operator +, który musi mieć dostęp do prywatnych składowych obu operandów.
Pytanie 18
Jakie jest najważniejsze działanie w trakcie analizy wymagań klienta przed rozpoczęciem realizacji projektu aplikacji?
A. Selekcja języka programowania
B. Zrozumienie potrzeb biznesowych i oczekiwań klientaPoprawna odpowiedź
C. Stworzenie diagramu Gantta
D. Rozdzielenie ról w zespole projektowym
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Fajnie, że zauważyłeś, jak ważne jest zrozumienie potrzeb biznesowych i oczekiwań klienta. To kluczowa sprawa przed rozpoczęciem pracy nad projektem aplikacji. Bez tego, nawet najfajniejszy kod może nie spełniać wymagań, a to byłoby szkoda, prawda? Analiza wymagań to nie tylko rozpoznanie celów, ale też spotkania z osobami zaangażowanymi w projekt i zbadanie rynku. Dzięki temu możemy stworzyć aplikację, która naprawdę odpowiada na specyficzne potrzeby, co czyni ją bardziej użyteczną i konkurencyjną. No i oczywiście, jak dobrze określimy, czego potrzebują użytkownicy, to mniej nieporozumień po drodze, a klienci będą bardziej zadowoleni, co zawsze jest na plus.
Pytanie 19
Które z poniższych stwierdzeń najlepiej charakteryzuje tablicę asocjacyjną?
A. Tablica przechowująca dane w formie par klucz-wartośćPoprawna odpowiedź
B. Tablica, która przechowuje wartości, do których można uzyskać dostęp tylko za pomocą indeksów numerycznych
C. Tablica, która zmienia swoje wymiary w trakcie działania programu
D. Tablica, która przechowuje wyłącznie dane tekstowe
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Tablica asocjacyjna to fajna rzecz, bo przechowuje dane w formie par klucz-wartość. W przeciwieństwie do zwykłych tablic, gdzie używasz numerów do indeksowania, tutaj możesz mieć różne unikalne klucze, na przykład teksty czy liczby. To naprawdę ułatwia wyszukiwanie informacji i organizowanie danych. W Pythonie nazywa się to 'słownikami', a w C++ używa się 'map'. Moim zdaniem, to świetne narzędzie do pracy z większymi zbiorami danych.
Pytanie 20
Który z wymienionych algorytmów działających na tablicy jednowymiarowej ma złożoność obliczeniową \( O(n^2) \)?
A. Wyświetlenie elementów
B. Sortowanie szybkie
C. Wyszukiwanie metodą binarną
D. Sortowanie bąbelkowePoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Sortowanie bąbelkowe to taki klasyczny algorytm, który ma złożoność \( O(n^2) \). Chociaż jest dość prosty w zrozumieniu, to nie za bardzo sprawdza się w większych zbiorach danych. Działa tak, że porównuje sąsiadujące ze sobą elementy i zamienia je miejscami, jeśli są w złej kolejności. Trochę to czasochłonne, ale warto znać ten algorytm, bo pokazuje podstawy sortowania.
Pytanie 21
Jakie jest oznaczenie komentarza wieloliniowego w języku Java?
A.
// ... //
B.
""" ... """
C.
<!-- ... -->
D.
/* ... */
Poprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Komentarze wieloliniowe w języku Java zapisuje się właśnie w taki sposób: /* ... */. Taki zapis pozwala na umieszczenie kilku linii tekstu między znakami otwierającym /* i zamykającym */, które kompilator całkowicie ignoruje podczas tłumaczenia kodu. Z mojego doświadczenia to jest najwygodniejsza forma, kiedy trzeba wyłączyć większy fragment kodu – np. część algorytmu, której chwilowo nie chcemy wykonywać lub większy blok dokumentacji. Bardzo często używa się komentarzy wieloliniowych przy pisaniu tzw. docstringów, choć w Javie do dokumentacji API lepiej stosować komentarze JavaDoc z podwójnym ukośnikiem i gwiazdką (/** ... */), ale zwykłe /* ... */ są super uniwersalne – czy to na zajęciach, czy w dużych projektach zespołowych. Moim zdaniem, jeśli uczysz się Javy, warto pamiętać, żeby nie mieszać komentarzy wieloliniowych z jednoliniowymi (// ...), bo to czasem prowadzi do zamieszania, szczególnie przy większych refaktoryzacjach. Co ciekawe, takie same komentarze znajdziesz też w C czy C++, więc jak ktoś zna te języki, to szybko się odnajdzie. W sumie to prosta sprawa, ale zdziwiłbyś się ile osób próbuje stosować inne formaty, które działają w zupełnie innych technologiach. No i jeszcze taka drobna uwaga z praktyki: nigdy nie wstawiaj komentarza wieloliniowego wewnątrz innego; Java tego nie obsługuje i kompilator się pogubi.
Pytanie 22
Który z poniższych składników NIE jest konieczny do stworzenia klasy w C++?
A. Zastosowanie słowa kluczowego class
B. Definicja funkcji członkowskich klasy
C. Definicja destruktoraPoprawna odpowiedź
D. Deklaracja atrybutów klasy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Do utworzenia klasy w C++ nie jest wymagana definicja destruktora. Destruktor to specjalna metoda klasy, która jest wywoływana automatycznie w momencie zniszczenia obiektu, ale jego obecność jest opcjonalna. Klasy, które nie operują bezpośrednio na zasobach zewnętrznych, takich jak dynamiczna pamięć lub pliki, często nie potrzebują destruktora, ponieważ domyślny destruktor generowany przez kompilator jest wystarczający. Aby utworzyć klasę, wystarczy deklaracja pól i metod oraz użycie słowa kluczowego 'class'. To sprawia, że C++ pozwala na szybkie definiowanie prostych klas, które można później rozwijać w miarę potrzeby.
Pytanie 23
Jaką strukturę danych obrazuje zamieszczony kod w języku C#?
int[,]array=newint[3,3];
A. tablicę jednowymiarową
B. listę
C. stos
D. tablicę dwuwymiarowąPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Kod, który widzisz, tworzy tablicę dwuwymiarową w języku C#. Zapis int[,] array = new int[3, 3]; oznacza, że deklarujesz strukturę, gdzie każdy element jest dostępny przez dwa indeksy – pierwszy wskazuje wiersz, drugi kolumnę. Tablice dwuwymiarowe są bardzo popularne przy przechowywaniu macierzy, plansz w grach (na przykład szachownicy czy sudoku), a nawet obrazów, gdzie każdy piksel opisuje się przez współrzędne. Moim zdaniem, znajomość takich struktur naprawdę ułatwia tworzenie bardziej złożonych algorytmów, bo niekiedy dostępu do danych nie da się zamknąć w jednej linii, tylko trzeba się poruszać w dwóch wymiarach. Jeżeli chodzi o dobre praktyki, to warto pamiętać, że tablica dwuwymiarowa w .NET jest strukturą "prostokątną", czyli każdy wiersz ma tyle samo kolumn – coś jak klasyczna tabela w Excelu. To różni się od tzw. tablic tablic (ang. jagged arrays), które pozwalają mieć nierówną liczbę elementów w wierszach, ale to już trochę inna bajka. W twoim przykładzie stworzyłeś tablicę o rozmiarze 3x3, czyli 9 elementów, do których odwołujesz się za pomocą array[wiersz, kolumna]. Może się to wydawać proste, ale z mojego doświadczenia to właśnie takie zrozumienie podstawowych konstrukcji pozwala pisać czytelny i wydajny kod. W branży często spotyka się sytuacje, gdzie optymalizacja działania na tablicach – zwłaszcza tych dwuwymiarowych – robi różnicę, więc warto to mieć dobrze opanowane.
Pytanie 24
Ergonomiczną oraz właściwą pozycję do pracy przy komputerze zapewni fotel, którego
A. podłokietniki są 30 cm powyżej blatu
B. oparcie w rejonie szyi jest nachylone do przodu o 40ᵒ
C. oparcie wspiera lordozę w dolnym odcinku plecówPoprawna odpowiedź
D. podłokietniki znajdują się 20 cm poniżej blatu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Prawidłowa i ergonomiczna pozycja pracy przy komputerze jest kluczowa dla zdrowia i komfortu użytkownika. Oparcie krzesła, które zapewnia lordozę w odcinku lędźwiowym, jest niezbędne, ponieważ pozwala na zachowanie naturalnej krzywizny kręgosłupa. Lordoza lędźwiowa to naturalne wygięcie kręgosłupa w dolnej części pleców, które wspiera prawidłowe ułożenie ciała podczas siedzenia. Krzesło powinno być zaprojektowane tak, aby oparcie przylegało do krzywizny ciała, co minimalizuje ryzyko bólu pleców oraz przeciążeń. Praktycznym przykładem ergonomicznej pozycji jest ustawienie oparcia w taki sposób, aby jego dolna część była dostosowana do odcinka lędźwiowego. Zgodnie z normami ISO 9241, które dotyczą ergonomii miejsc pracy przy komputerze, krzesło powinno umożliwiać użytkownikowi przyjęcie wygodnej pozycji z podparciem dla dolnej części pleców. W odpowiedniej pozycji stopy powinny spoczywać płasko na podłodze, a kolana powinny być na poziomie bioder, co wspiera prawidłowe krążenie krwi oraz redukuje napięcia mięśniowe.
Pytanie 25
W języku Java wyjątek ArrayIndexOutOfBoundsException występuje, gdy następuje próba dostępu do elementu tablicy, którego
A. wartość przekracza rozmiar tablicy
B. indeks jest równy lub większy od rozmiaru tablicyPoprawna odpowiedź
C. wartość przewyższa jego indeks
D. indeks mieści się w zakresie od 0 do n-1, gdzie n oznacza rozmiar tablicy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Wyjątek ArrayIndexOutOfBoundsException w Javie to taki klasyk, na który łatwo się naciąć, zwłaszcza gdy operujesz na tablicach dynamicznie lub masz jakieś pętle i zapomnisz o poprawnych granicach. Ta odpowiedź jest prawidłowa, bo w języku Java indeksowanie tablic zaczyna się od 0, a ostatni poprawny indeks to zawsze rozmiar tablicy minus jeden. Jeśli próbujesz dostać się do elementu, którego indeks jest równy lub większy od rozmiaru tablicy, silnik uruchomieniowy Javy od razu rzuci ten wyjątek. Przykład? Masz tablicę int[] t = new int[5]; i próbujesz odwołać się do t[5] albo t[10] – nie zadziała, bo legalne są tylko indeksy 0, 1, 2, 3, 4. Moim zdaniem to jeden z tych wyjątków, które wyraźnie pokazują, jak ważne jest zabezpieczanie kodu i stosowanie praktyk takich jak sprawdzanie długości tablicy przed dostępem do jej elementów. W profesjonalnym kodzie, zwłaszcza komercyjnym, nie zostawia się takich rzeczy przypadkowi – często stosuje się pętle typu for (int i = 0; i < array.length; i++), żeby mieć pewność, że nigdzie nie wyjedziemy poza zakres. Dobra praktyka to też wykorzystywanie narzędzi jak testy jednostkowe, żeby wyłapywać takie błędy. Warto pamiętać, że ten wyjątek jest unchecked, czyli nie musisz go łapać w kodzie, ale dobrze jest rozumieć, że jego pojawienie się oznacza błąd w logice programu. Osobiście uważam, że jeśli ktoś raz się na tym przejedzie, to już zawsze sprawdza rozmiar tablicy przed dostępem – taka nauczka na całe życie programisty.
Pytanie 26
Która z niżej wymienionych pozycji jest ekwiwalentem biblioteki jQuery?
A. Bootstrap
B. TypeScript
C. Express.js
D. LodashPoprawna odpowiedź
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Lodash to popularna biblioteka JavaScript, która dostarcza gotowe funkcje umożliwiające manipulację tablicami, obiektami oraz danymi. Lodash upraszcza wiele złożonych operacji, takich jak filtrowanie, mapowanie, sortowanie i grupowanie danych. Dzięki Lodash programiści mogą efektywnie zarządzać złożonymi strukturami danych, co prowadzi do zwiększenia czytelności i efektywności kodu. Biblioteka jest szeroko stosowana w aplikacjach frontendowych i backendowych, a jej funkcje są zoptymalizowane pod kątem wydajności, co czyni ją nieocenionym narzędziem w dużych projektach. Lodash często bywa porównywany do jQuery, jednak jego głównym celem jest manipulacja danymi, a nie elementami DOM. Dzięki swojej wszechstronności Lodash znajduje zastosowanie w niemal każdym projekcie JavaScript, zarówno w prostych aplikacjach webowych, jak i dużych projektach korporacyjnych.
Pytanie 27
Środowiskiem dedykowanym do tworzenia aplikacji mobilnych dla urządzeń Apple i wykorzystującym do tego celu różne języki programowania w tym Java i Objective C jest
A. React Native
B. XCodePoprawna odpowiedź
C. NetBeans
D. Android Studio
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: XCode to środowisko, które faktycznie jest fundamentem tworzenia aplikacji na urządzenia Apple, czyli iPhone’y, iPady czy nawet MacBooki. Apple od lat inwestuje w rozwój XCode i właśnie tam programiści mogą budować zarówno aplikacje natywne, jak i np. gry – i to z wykorzystaniem różnych języków, takich jak Objective-C i Swift. Co ciekawe, dawniej używano też Objective-C prawie wyłącznie, ale od kilku lat Apple promuje Swift, bo jest nowocześniejszy i dużo przyjemniej się w nim pisze. Moim zdaniem XCode to taki niezbędnik – bez niego praktycznie nie da się pisać porządnych aplikacji na iOS czy macOS. Samo środowisko jest zintegrowane ze wszystkimi narzędziami Apple: symulatorem urządzeń, Interface Builderem do projektowania graficznego oraz narzędziami do debugowania i testowania. Z mojego doświadczenia, jak ktoś zaczyna przygodę z aplikacjami mobilnymi dla Apple, to właśnie XCode jest pierwszym programem, z którym spędzi dużo czasu. I trochę ułatwia życie, bo automatycznie konfiguruje projekty pod standardy Apple, nie trzeba nic ręcznie ustawiać. To też świetne miejsce do nauki, bo dokumentacja jest wprost wbudowana w środowisko. Co ważne, XCode jest wymagany, żeby wrzucić gotową aplikację do App Store – tak jest po prostu zrobiony ekosystem Apple i żadna alternatywa nie daje tyle integracji i wsparcia dla natywnych rozwiązań Apple.
Pytanie 28
Jaką złożoność obliczeniową posiada podany algorytm? Dane: Tablica: tab[n] Index: i = 0, 1, ..., n-1 x: szukana
Wyjaśnienie poprawnej odpowiedzi: Analizując podany algorytm, warto zauważyć, że przechodzi on przez każdy element tablicy dokładnie raz, zaczynając od indeksu 0 aż do n-1. To jest klasyczny przykład przeszukiwania liniowego (linear search), które w najgorszym przypadku ma złożoność czasową O(n), gdzie n to liczba elementów w tablicy. Moim zdaniem to jedna z najbardziej podstawowych i jednocześnie często używanych technik, szczególnie tam, gdzie dane nie są posortowane albo kiedy oczekujemy prostoty implementacji. W praktyce taki algorytm stosuje się, gdy nie zależy nam na super efektywności, a raczej na łatwości zrozumienia kodu lub szybkim prototypowaniu, na przykład podczas pisania skryptów narzędziowych lub prostych aplikacji. Branżowe standardy, chociażby w programowaniu niskopoziomowym lub w zastosowaniach embedded, też często bazują na tego typu rozwiązaniach, ponieważ nie wymagają one dodatkowej pamięci ani zaawansowanych struktur danych. Fajnie zwrócić uwagę, że O(n) oznacza, iż czas wykonywania rośnie proporcjonalnie do liczby elementów – czyli dla 1 000 elementów algorytm wykona się około 1 000 razy wolniej niż dla pojedynczego elementu, chociaż w praktyce zależy to oczywiście od wielu czynników sprzętowych. Dobrym zwyczajem jest zawsze na początku próbować rozwiązać problem najprostszym algorytmem, takim jak ten, a dopiero potem – jeśli wydajność zawiedzie – szukać bardziej zaawansowanych rozwiązań, jak wyszukiwanie binarne czy struktury indeksujące.
Pytanie 29
Który z wymienionych programów jest przeznaczony do zarządzania projektami przy pomocy tablic kanban?
A. Word
B. TrelloPoprawna odpowiedź
C. Jira
D. Photoshop
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Trello to narzędzie do zarządzania projektami, które wykorzystuje tablice kanban do organizacji i monitorowania zadań. Użytkownicy mogą tworzyć karty reprezentujące poszczególne zadania, które następnie są przenoszone między kolumnami odzwierciedlającymi etapy realizacji. Dzięki swojej prostocie i intuicyjności Trello jest szeroko stosowane zarówno w małych zespołach, jak i dużych organizacjach. Umożliwia efektywne zarządzanie projektami, planowanie sprintów oraz monitorowanie bieżącego statusu prac. Tablice kanban pomagają wizualizować przepływ pracy, co ułatwia identyfikację wąskich gardeł i zarządzanie priorytetami.
Pytanie 30
Jakie jest przeznaczenie polecenia "git merge"?
A. Do pobierania aktualizacji zdalnego repozytorium
B. Do łączenia zmian z różnych gałęziPoprawna odpowiedź
C. Do zakładania nowego repozytorium
D. Do usuwania zmian w repozytorium
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Polecenie "git merge" służy w Git do łączenia zmian z różnych gałęzi. Kiedy pracujemy w zespole i każdy programista rozwija swój fragment kodu na osobnej gałęzi, w pewnym momencie trzeba te zmiany zebrać do kupy, żeby powstała jedna, wspólna wersja projektu. Tu właśnie pojawia się "merge" – pozwala w prosty sposób dołączyć zmiany z jednej gałęzi do drugiej, najczęściej z feature branch do develop albo main. Praktycznie rzecz biorąc, to polecenie sprawdza się zawsze wtedy, gdy chcemy zintegrować efekty pracy kilku osób lub wersje rozwojowe z główną linią kodu. Moim zdaniem, korzystanie z "git merge" to w zasadzie codzienność w projektach zespołowych, bo prawie nikt już nie pracuje tylko na jednej gałęzi. Warto też pamiętać, że merge może czasem prowadzić do konfliktów, jeśli te same fragmenty plików były zmieniane równolegle – wtedy trzeba ręcznie rozwiązać te rozbieżności. W praktyce, dobrą praktyką jest regularne mergowanie, żeby uniknąć lawiny konfliktów na koniec sprintu. Dla mnie "merge" to narzędzie absolutnie kluczowe, bez którego ciężko sobie wyobrazić sensowną pracę z Gitem. No i jeszcze – to nie to samo co "rebase", chociaż oba służą do integracji zmian, ale w różny sposób. Merge zostawia historię połączeń, co ułatwia śledzenie zmian w większych projektach.
Pytanie 31
Jakie są główne różnice między środowiskiem RAD (Rapid Application Development) a klasycznymi IDE?
A. RAD pozwala na szybkie tworzenie prototypów i rozwijanie aplikacji przy minimalnej ilości koduPoprawna odpowiedź
B. RAD funkcjonuje tylko w systemach operacyjnych Linux
C. RAD nie oferuje żadnych narzędzi do debugowania
D. RAD koncentruje się tylko na testowaniu programów
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: RAD (Rapid Application Development) to metodologia tworzenia oprogramowania, która kładzie nacisk na szybkie prototypowanie i iteracyjne podejście do rozwoju aplikacji, minimalizując czas poświęcany na pisanie kodu od podstaw. Kluczowym aspektem RAD jest możliwość szybkiego dostosowywania aplikacji do zmieniających się wymagań biznesowych oraz ciągła interakcja z klientem. Narzędzia RAD, takie jak Visual Studio, Delphi czy OutSystems, pozwalają na budowanie aplikacji przy użyciu graficznych interfejsów, gotowych komponentów i automatycznego generowania kodu, co znacząco skraca czas wprowadzenia produktu na rynek. RAD doskonale sprawdza się w przypadku projektów o krótkim cyklu życia i wymagających szybkich zmian.
Pytanie 32
Przedstawiony na filmie kod napisany w języku C++ nie kompiluje się. Co należy zmienić w tym kodzie, aby proces kompilacji wykonał się bez błędów?
A. poprawnie zapisać warunek w instrukcji if w linii 11, np. sprawdz(x)==true
B. dodać deklarację funkcji sprawdz przed funkcją mainPoprawna odpowiedź
C. zadeklarować zmienną sprawdz przed jej wykorzystaniem w linii 11
D. naprawić błąd w funkcji sprawdz, który polega na braku nawiasów {} w pętli for
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Odpowiedź jest trafna, bo w języku C++ kompilator musi wiedzieć o istnieniu funkcji zanim zostanie ona użyta w kodzie, np. w funkcji main. Bez wcześniejszej deklaracji, kompilator nie zna sygnatury funkcji i nie potrafi zweryfikować wywołania, co skutkuje błędem typu 'implicit declaration of function'. Deklaracja funkcji to taki sygnał informujący kompilator „hej, taka funkcja będzie i będzie przyjmować takie argumenty, a zwracać taki typ”. Praktycznie rzecz biorąc, przed funkcją main wystarczy wpisać np. 'bool sprawdz(int x);', żeby wszystko grało. To szczególnie ważne przy większych projektach czy pracy w zespołach, gdzie pliki nagłówkowe z deklaracjami funkcji są standardem. Pozwala to na lepszą czytelność i porządek w kodzie – kompilator wie, czego się spodziewać, a Ty unikasz dziwnych, trudnych do znalezienia błędów. Moim zdaniem taka organizacja kodu to podstawa, szczególnie jeśli kiedyś będziesz korzystać z bibliotek lub cudzych funkcji – deklaracje są wtedy wręcz obowiązkowe. To zasada, której trzyma się większość zespołów programistycznych i, szczerze mówiąc, sam kilka razy w młodości zapomniałem o deklaracji, przez co debugowanie trwało wieki. Warto od razu wyrobić sobie taki nawyk, bo to oszczędza sporo nerwów i czasu, a kod staje się solidniejszy i bardziej profesjonalny.
Pytanie 33
Jakie z poniższych narzędzi wspomaga projektowanie interfejsu użytkownika w aplikacjach mobilnych?
A. Android Studio Layout EditorPoprawna odpowiedź
B. PyCharm Debugger
C. Narzędzie do zarządzania bazami danych
D. Kompilator Javy
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Android Studio Layout Editor to narzędzie umożliwiające projektowanie interfejsu użytkownika aplikacji mobilnych w sposób wizualny, za pomocą metody 'przeciągnij i upuść'. Layout Editor pozwala na szybkie tworzenie responsywnych interfejsów, które automatycznie dostosowują się do różnych rozmiarów ekranów i rozdzielczości. Dzięki niemu programiści mogą łatwo dodawać elementy UI, takie jak przyciski, pola tekstowe, listy czy obrazy, oraz dostosowywać ich właściwości bez konieczności pisania dużych fragmentów kodu XML. Narzędzie to jest kluczowe dla szybkiego prototypowania aplikacji oraz iteracyjnego podejścia do budowy interfejsu użytkownika w środowisku Android Studio.
Pytanie 34
Który operator w języku C++ jest używany do uzyskiwania adresu zmiennej?
A.
*
B.
&
Poprawna odpowiedź
C.
delete
D.
>
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Operator & w języku C++ służy, w kontekście wyrażenia, do pobrania adresu obiektu w pamięci. Jeśli mamy zmienną int liczba = 10;, to zapis int* wsk = &liczba; oznacza: utwórz wskaźnik na int i wpisz do niego adres zmiennej liczba. To jest bardzo ważne przy pracy ze wskaźnikami, przekazywaniu danych do funkcji przez adres, obsłudze struktur danych oraz w starszym stylu programowania systemowego. Moim zdaniem warto od razu kojarzyć &: adres zmiennej, a *: dostęp do wartości pod adresem, bo te dwa operatory często występują razem. Przykład praktyczny: void zwieksz(int* p) { (*p)++; } można wywołać jako zwieksz(&liczba); i wtedy funkcja modyfikuje oryginalną zmienną, nie kopię. W nowoczesnym C++ często preferuje się referencje, inteligentne wskaźniki i kontenery standardowe, zgodnie z dobrymi praktykami C++ Core Guidelines, ale rozumienie operatora & dalej jest podstawą. Bez tego ciężko ogarnąć pamięć, wskaźniki, tablice dynamiczne czy interfejsy niskopoziomowe.
Pytanie 35
Który z dokumentów stosowanych w metodologii Agile zawiera listę funkcjonalności produktu uporządkowanych według ich ważności?
A. Backlog sprintu
B. Diagram Gantta
C. Product backlogPoprawna odpowiedź
D. Harmonogram projektu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Product backlog to dokument zawierający listę funkcjonalności produktu uporządkowanych według priorytetów. Jest to jedno z głównych narzędzi w metodykach Agile, szczególnie w Scrumie, gdzie backlog stanowi podstawę do planowania sprintów. Zawiera on wszystkie elementy, które muszą zostać zaimplementowane, w tym nowe funkcje, poprawki błędów oraz zadania techniczne. Priorytety są ustalane przez właściciela produktu (Product Ownera) i dostosowywane na bieżąco w zależności od zmieniających się wymagań i potrzeb biznesowych. Dzięki backlogowi zespół może skupić się na dostarczaniu najważniejszych funkcji, co pozwala na szybkie reagowanie na feedback i rozwój aplikacji zgodnie z oczekiwaniami klienta.
Pytanie 36
Jakie aspekty powinny być brane pod uwagę przy tworzeniu zestawów danych?
A. Ilość linii kodu programu
B. Typ zastosowanego kompilatora
C. Metoda alokacji pamięci dla danychPoprawna odpowiedź
D. Narzędzia do analizy błędów
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Sposób alokacji pamięci dla danych to kluczowy element projektowania zestawów danych, ponieważ wpływa na wydajność i efektywność programu. Dynamiczna alokacja pamięci pozwala na tworzenie struktur, których rozmiar jest zmienny i dostosowuje się w trakcie działania aplikacji. Dzięki temu programiści mogą optymalnie zarządzać zasobami systemowymi, unikając marnowania pamięci lub jej niedoboru. Wybór odpowiedniej metody alokacji, np. stosowanie wskaźników, dynamicznych tablic lub struktur danych takich jak lista czy mapa, pozwala na budowanie bardziej skalowalnych i elastycznych aplikacji.
Pytanie 37
Jakie stwierdzenie najlepiej tłumaczy cel podziału programu na funkcje (metody)?
A. Eliminuje potrzebę korzystania ze zmiennych globalnych
B. Umożliwia skrócenie kodu przez eliminację wszelkich komentarzy
C. Ułatwia proces debugowania oraz ponowne wykorzystanie fragmentów koduPoprawna odpowiedź
D. Gwarantuje automatyczną kompilację programu
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Dzielenie programu na funkcje (lub metody) jest jedną z kluczowych zasad programowania strukturalnego i obiektowego. Funkcje pozwalają na podzielenie dużych bloków kodu na mniejsze, łatwiejsze do zarządzania i ponownego wykorzystania fragmenty. Dzięki temu kod jest bardziej czytelny, zrozumiały i łatwiejszy do testowania. Ułatwia to także proces debugowania, ponieważ błędy można izolować w konkretnych funkcjach, zamiast przeszukiwać cały program. Ponadto funkcje umożliwiają wielokrotne używanie tego samego fragmentu kodu, co zwiększa efektywność i eliminuje konieczność powielania kodu, zmniejszając ryzyko błędów.
Pytanie 38
Który z poniższych procesów jest wyłącznie związany z kompilowaniem kodu?
A. Generating an executable filePoprawna odpowiedź
B. Real-time translation of instructions
C. Detection of logical errors during program execution
D. Executing code step by step
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Generowanie pliku wykonywalnego to jeden z najważniejszych kroków w kompilacji. Kiedy kod źródłowy zostaje przetworzony na język maszynowy, kompilator tworzy plik binarny, który można uruchomić na odpowiednim systemie operacyjnym. Taki plik jest samodzielny, więc nie trzeba go za każdym razem kompilować od nowa przy uruchamianiu. Dzięki kompilacji można też zoptymalizować kod, co jest mega ważne, zwłaszcza przy większych projektach. W przeciwieństwie do interpretacji, gdzie kod działa na bieżąco, kompilacja pozwala wyłapać błędy wcześniej i poprawić wydajność aplikacji. Moim zdaniem, to naprawdę spora zaleta!
Pytanie 39
Kolor Pale Green w modelu RGB przedstawia się jako RGB(152, 251, 152). Jaki jest szesnastkowy kod tego koloru?
A. 98 FB 98Poprawna odpowiedź
B. A0 FE A0
C. 98 FE 98
D. A0 FB A0
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Prawidłowa odpowiedź to RGB(152, 251, 152) zapisane w systemie szesnastkowym jako 98 FB 98. To nie jest przypadkowe – konwersja formatu RGB na HEX polega na przekształceniu każdej ze składowych (czerwony, zielony, niebieski) na odpowiadającą wartość heksadecymalną. W tym przypadku: 152 to 98 w systemie szesnastkowym, 251 to FB, a 152 znowu 98. W praktyce, takie zapisy są absolutną podstawą przy projektowaniu stron internetowych, stylów CSS albo aplikacji mobilnych, gdzie kolory opisuje się właśnie kodami HEX. Moim zdaniem, każdy kto chce działać w grafice komputerowej albo frontendzie, powinien mieć ten mechanizm w jednym palcu. Warto wiedzieć, że standardy W3C przewidują właśnie taki sposób zapisu i przyjmują zarówno notację z #, jak i bez spacji, czyli #98FB98. Często spotkasz ten format np. w plikach stylów LESS, SASS czy nawet podczas korzystania z generatorów palet. Sam nieraz miałem sytuację, że szybka konwersja RGB na HEX ratowała projekt, bo klient przesłał kolory tylko w jednym systemie. Dobrą praktyką jest też zawsze sprawdzać, czy konwersja nie zniekształciła zamierzonego koloru – niektóre programy graficzne lub biblioteki mogą dokonywać zaokrągleń, co minimalnie wpływa na odcień. Warto więc nie tylko ufać narzędziom, ale rozumieć manualnie, jak się to liczy. No, i to co ciekawe – Pale Green jest kolorem dość uniwersalnym, często spotykanym w projektowaniu UI, bo jest delikatny i nie męczy wzroku. Szczerze polecam pobawić się konwersją różnych kolorów, bo to po prostu się przydaje.
Pytanie 40
Która z dokumentacji funkcji odpowiada przedstawionemu kodowi źródłowemu?
Dokumentacja 1:/*******************
* nazwa: Abs
* opis: liczy wartość bezwzględną
* zwracana: brak
* argumenty: liczba całkowita
*******************/
Dokumentacja 2:/*******************
* nazwa: Abs
* opis: liczy wartość bezwzględną
* zwracana: wartość bezwzględna z liczby całkowitej
* argumenty: liczba całkowita
*******************/
Dokumentacja 3:/*******************
* nazwa: Abs
* opis: liczy potęgę liczby
* zwracana: potęga z liczby całkowitej
* argumenty: dwie liczby całkowite
*******************/
Dokumentacja 4:/*******************
* nazwa: Abs
* opis: liczy potęgę liczby
* zwracana: potęga z liczby całkowitej
* argumenty: liczba całkowita
*******************/
A. Dokumentacja 2Poprawna odpowiedź
B. Dokumentacja 1
C. Dokumentacja 4
D. Dokumentacja 3
Brak odpowiedzi na to pytanie.
Wyjaśnienie poprawnej odpowiedzi: Dokumentacja 2 zdecydowanie najlepiej pasuje do przedstawionej funkcji. Zwróć uwagę, że sama definicja funkcji „Abs” w kodzie przyjmuje jeden argument typu całkowitego (int) i zwraca także liczbę całkowitą. Jej zadaniem jest zwrócenie wartości bezwzględnej tej liczby, co dokładnie opisuje fragment: „zwracana: wartość bezwzględna z liczby całkowitej”. To bardzo ważne, bo w programowaniu – a szczególnie w językach takich jak C# czy C++ – jasna i kompletna dokumentacja pozwala potem innym korzystać z funkcji bez konieczności zaglądania do jej wnętrza. W praktyce, takie szczegółowe opisywanie co zwraca dana funkcja i jakie przyjmuje argumenty, znacznie przyspiesza pracę w większych zespołach. Standardem branżowym jest właśnie precyzyjne określanie typu zwracanego i opisu działania, a nie tylko suchy komentarz typu „zwraca: brak” (co byłoby niezgodne z kodem!). Co ciekawe, w wielu firmach stosuje się rozbudowane systemy dokumentacji (np. Doxygen czy XML doc w .NET), które niejako wymuszają takie dokładne opisy. Osobiście uważam, że przyzwyczajenie się do dobrych praktyk dokumentowania funkcji już na etapie nauki procentuje w przyszłości – mniej pytań w zespole, mniej nieporozumień. Ta konkretna dokumentacja spełnia wszystkie kluczowe kryteria: podaje nazwę, precyzyjny opis, prawidłowy typ zwracanej wartości oraz właściwy typ i opis argumentu. Idealnie odzwierciedla, co robi ten fragment kodu, a to podstawa w pisaniu czytelnych i bezpiecznych aplikacji.