Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 15 września 2026 12:23
Zakończenie: 15 września 2026 12:42
Egzamin zdany!
Wynik: 24/40 punktów (60,0%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 40% podejść do kwalifikacji INF.03.
Porównanie z 41535 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
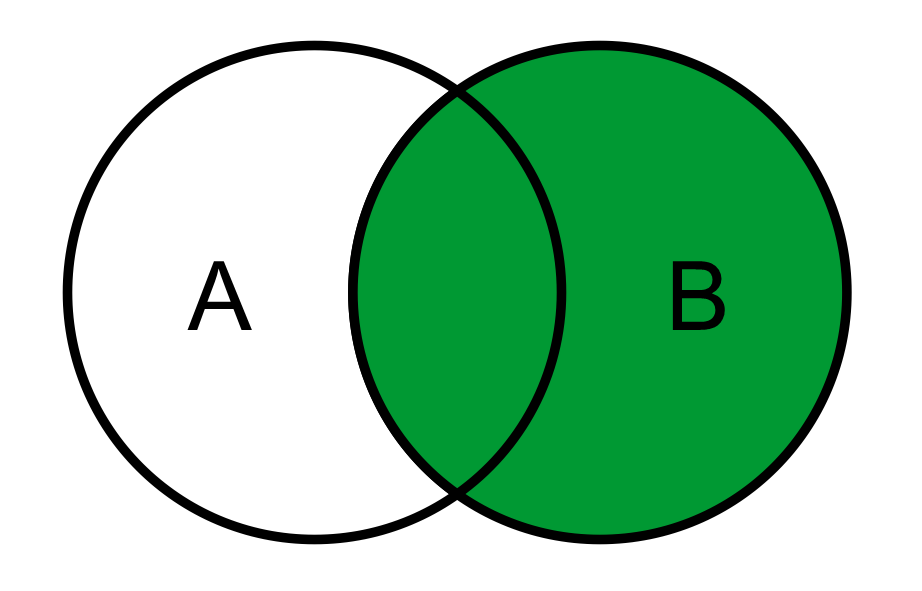
W języku SQL, aby wybrać wszystkie rekordy z tabeli B, w tym część wspólną z tabelą A, należy zastosować typ związku
A. A INNER JOIN BTwoja odpowiedź
B. A RIGHT JOIN BPoprawna odpowiedź
C. A FULL OUTER JOIN B
D. A LEFT JOIN B
Niepoprawna odpowiedź. W tym pytaniu pułapka polega na tym, że łatwo pomylić pojęcie części wspólnej z całością jednego ze zbiorów. Diagram pokazuje całą tabelę B (włącznie z przecięciem z A), a nie tylko przecięcie. W SQL typ złączenia określa, z której tabeli bierzemy wszystkie rekordy, a z której tylko te pasujące. To, że widzimy też obszar wspólny, jest naturalnym efektem działania złączeń zewnętrznych, ale nie oznacza jeszcze, że chodzi o `INNER JOIN`. Jeśli ktoś wybiera `A LEFT JOIN B`, to zwykle wynika z myślenia „chcę część wspólną i coś jeszcze”, ale myli kierunek. `LEFT JOIN` gwarantuje wszystkie rekordy z **lewej** tabeli (A), a z prawej (B) tylko dopasowane. Diagram z pytania pokazuje dokładnie odwrotną sytuację: komplet danych z B, a z A tylko tam, gdzie istnieje relacja. `A LEFT JOIN B` odpowiadałoby sytuacji, gdzie podświetlony jest cały zbiór A i przecięcie, a nie B. Z kolei `A INNER JOIN B` zwróciłby wyłącznie część wspólną A∩B, czyli tylko te rekordy, które mają dopasowanie po obu stronach. Na diagramie byłby wtedy zaznaczony wyłącznie środek, a nie cały zielony obszar B. To typowy błąd: utożsamianie każdego JOIN z „częścią wspólną”. INNER JOIN jest dobry, gdy interesują nas tylko powiązane dane (np. zamówienia, które mają istniejącego klienta), ale w zadaniu wyraźnie mowa o „wszystkich rekordach z B”. `A FULL OUTER JOIN B` idzie w drugą stronę – zwraca wszystko z A **i** wszystko z B, niezależnie od tego, czy jest dopasowanie, czy nie. To byłby diagram z zaznaczonymi obiema kółkami, czyli suma zbiorów A∪B. W standardzie SQL taki typ złączenia jest opisany jako pełne złączenie zewnętrzne i stosuje się go rzadziej, np. do porównywania różnic między dwiema tabelami. Tutaj jest to za szeroki zakres danych w stosunku do pytania. Poprawne podejście wymaga więc skojarzenia, że skoro chcemy wszystkie rekordy z tabeli B, to w zapisie `A ... JOIN B` tabela B musi być po tej stronie, która jest „obowiązkowa”. Właśnie to zapewnia `RIGHT JOIN`: pełny zestaw wierszy z prawej tabeli, plus dopasowania z lewej tam, gdzie istnieją. Świadome operowanie tymi pojęciami bardzo ułatwia projektowanie zapytań raportowych i unikanie nieoczekiwanych braków lub duplikacji danych.
Pytanie 2
Która funkcja PHP służy do załadowania (dołączenia) pliku z serwera?
A.
parse_str()
B.
include()
Poprawna odpowiedź
C.
echo()
D.
mysqli_connect()
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe funkcje robią co innego. mysqli_connect() łączy się z bazą danych, echo() wypisuje tekst, a parse_str() rozkłada ciąg zapytania na zmienne. Dołączanie pliku wykonuje include().
Pytanie 3
Który znacznik HTML służy do budowy STRUKTURY (układu) strony?
A.
<aside>
Twoja odpowiedź
B.
<input>
C.
<em>
D.
<mark>
Poprawna odpowiedź. Element <aside> to semantyczny znacznik HTML5 budujący STRUKTURĘ strony - wydziela treść poboczną powiązaną z głównym tematem, np. notki na marginesie czy panel boczny. Razem z <header>, <nav>, <section> i <footer> porządkuje układ dokumentu. Dlatego znacznikiem strukturalnym jest <aside>.
B. do tabeli nie można wpisywać ulic z polskimi znakami
C. rekordem tabeli nie może być „3 MAJA”
D. klauzula IFNOTEXISTS jest opcjonalna i zapobiega błędowi, gdy tabela już istniejeTwoja odpowiedź
Poprawna odpowiedź. Klauzula IFNOTEXISTS jest OPCJONALNA i zabezpiecza CREATETABLE - jeśli tabela o danej nazwie już istnieje, polecenie nie zgłosi błędu i nie utworzy jej ponownie. Dlatego prawdą jest, że IFNOTEXISTS jest opcjonalna i zapobiega błędowi przy istniejącej tabeli.
Pytanie 5
Którą funkcję z menu Kolory programu GIMP użyto, w celu uzyskania efektu przedstawionego w filmie?
A. Inwersja.
B. Barwienie.
C. Krzywe.
D. Progowanie.Twoja odpowiedź
Poprawna odpowiedź. Prawidłowo wskazana funkcja to „Progowanie”, bo dokładnie ona zamienia obraz kolorowy lub w odcieniach szarości na obraz dwuwartościowy: piksel jest albo czarny, albo biały, w zależności od tego, czy jego jasność przekracza ustawiony próg. W GIMP-ie znajdziesz ją w menu Kolory → Progowanie. Suwakami ustalasz zakres poziomów jasności, które mają zostać potraktowane jako „białe”, a wszystko poza tym zakresem staje się „czarne”. Efekt, który się wtedy uzyskuje, jest bardzo charakterystyczny: mocno kontrastowy, bez półtonów, coś w stylu skanu czarno-białego lub grafiki do druku na ploterze tnącym. Z mojego doświadczenia progowanie świetnie nadaje się do przygotowania logotypów, szkiców technicznych, schematów, a także do wyciągania konturów z lekko rozmytych zdjęć. Często używa się go też przed wektoryzacją, żeby program śledzący krawędzie miał wyraźne granice między czernią a bielą. W pracy z grafiką na potrzeby stron WWW próg bywa stosowany np. przy tworzeniu prostych ikon, piktogramów albo masek (maski przezroczystości można przygotować właśnie na bazie obrazu progowanego). Dobrą praktyką jest najpierw sprowadzenie obrazu do odcieni szarości i dopiero potem użycie progowania, bo wtedy masz większą kontrolę nad tym, jak rozkłada się jasność i gdzie wypadnie granica progu. Warto też pamiętać, że progowanie jest operacją destrukcyjną – traci się informacje o półtonach – więc najlepiej pracować na kopii warstwy, żeby w razie czego móc wrócić do oryginału i poprawić ustawienia progu.
Pytanie 6
W tabeli psy znajdują się kolumny: imie, rasa, telefon_wlasciciela, rok_szczepienia. Jakie polecenie SQL należy zastosować, aby uzyskać numery telefonów właścicieli psów, które były szczepione przed rokiem 2015?
A. SELECT psy FROM rok_szczepienia < 2015
B. SELECT telefon_wlasciciela FROM psy WHERE rok_szczepienia > 2015
C. SELECT imie, rasa FROM psy WHERE rok_szczepienia > 2015
D. SELECT telefon_wlasciciela FROM psy WHERE rok_szczepienia < 2015Twoja odpowiedź
Poprawna odpowiedź. Wybór odpowiedzi 'SELECT telefon_wlasciciela FROM psy WHERE rok_szczepienia < 2015' jest poprawny, ponieważ spełnia wszystkie kryteria zawarte w pytaniu. Kluczowym elementem jest zastosowanie klauzuli WHERE, która filtruje wyniki do tych, gdzie rok szczepienia jest mniejszy niż 2015. Używając SELECT, wybieramy tylko kolumnę 'telefon_wlasciciela', co odpowiada na konkretną potrzebę, jaką jest uzyskanie numerów telefonów właścicieli psów, które były szczepione przed określoną datą. W praktyce, takie zapytanie może być użyteczne w sytuacjach np. przypominania właścicielom o konieczności szczepień, co wpisuje się w szerszy kontekst zarządzania zdrowiem zwierząt. Dobre praktyki w SQL obejmują również staranność przy określaniu warunków filtracji, aby zminimalizować ryzyko błędnych wyników. Warto także pamiętać o indeksowaniu kolumn w bazie danych, co może przyspieszyć wykonywanie takich zapytań, zwłaszcza w dużych zbiorach danych.
Pytanie 7
Aby wygodnie wprowadzać i edytować dane w bazie danych, można posłużyć się:
A. kwerendą SELECT
B. raportem
C. formularzemTwoja odpowiedź
D. filtrowaniem
Poprawna odpowiedź. Formularz to wygodny interfejs do pracy z danymi: udostępnia pola odpowiadające kolumnom tabeli, dzięki czemu użytkownik może wprowadzać nowe rekordy i edytować istniejące bez ręcznego pisania zapytań SQL. Stosuje się go w aplikacjach i systemach baz danych, by uprościć i zabezpieczyć wpisywanie danych. Dlatego do wygodnego wprowadzania i modyfikowania danych służy właśnie formularz.
Pytanie 8
Komunikat ma pojawiać się tylko przy PIERWSZEJ wizycie użytkownika. Którą funkcję PHP wykorzystać?
A.
mysqli_change_user
B.
session_destroy
C.
setcookie
Twoja odpowiedź
D.
define
Poprawna odpowiedź. Aby rozpoznać, że użytkownik już odwiedził stronę, trzeba zapisać coś trwałego w jego przeglądarce - służy do tego ciasteczko zakładane funkcją setcookie(). Przy pierwszej wizycie cookie jeszcze nie ma, więc pokazujemy komunikat i je ustawiamy; przy kolejnych odczyt cookie pozwala komunikat pominąć. Dlatego należy użyć setcookie().
Pytanie 9
Aby strona poprawnie skalowała się na urządzeniach mobilnych, w sekcji <head> należy umieścić:
Poprawna odpowiedź. Znacznik <metaname="viewport"content="width=device-width, initial-scale=1"> mówi przeglądarce mobilnej, że szerokość rzutni (viewport) ma odpowiadać szerokości urządzenia, a strona ma startować w skali 1:1. Bez niego telefon renderuje stronę jako szeroką i pomniejsza ją, przez co media queries nie działają jak należy. Dlatego dla poprawnego skalowania na komórkach niezbędny jest meta viewport.
Pytanie 10
Które znaczniki HTML wyświetlą tekst „Dobre strony mojej strony” w JEDNYM wierszu, jeśli nie zastosowano żadnych reguł CSS?
Niepoprawna odpowiedź. Pozostałe znaczniki są BLOKOWE, więc każdy zaczyna się od nowej linii i rozbiłby tekst na osobne wiersze. Dotyczy to <p> (akapit), <h3> (nagłówek) oraz <div> (kontener). W jednym wierszu tekst utrzyma liniowy <span>.
Pytanie 11
Tablice superglobalne $_COOKIE oraz $_SESSION należą do języka:
A. Perl
B. C#
C. JavaScript
D. PHPTwoja odpowiedź
Poprawna odpowiedź. Tablice superglobalne $_COOKIE i $_SESSION to elementy języka PHP - dają dostęp odpowiednio do ciasteczek i danych sesji. Znak $ przed nazwą to charakterystyczny dla PHP zapis zmiennej. Dlatego należą do PHP.
Na podstawie przedstawionego kodu formularza HTML można powiedzieć, że pole edycyjne:
A. wymaga wpisania jedynie znaków alfanumerycznych.
B. nie powinno zawierać znaków numerycznych.
C. nie może być puste i wymaga wpisania tekstu ze znakiem @.Twoja odpowiedź
D. może być puste.
Poprawna odpowiedź. W tym fragmencie kodu HTML masz dwa bardzo ważne atrybuty: type="email" oraz required. To właśnie one razem powodują, że poprawna jest odpowiedź, że pole nie może być puste i wymaga wpisania tekstu ze znakiem @.
Atrybut required oznacza, że pole jest obowiązkowe. Przeglądarka, zgodnie ze specyfikacją HTML5, nie pozwoli wysłać formularza, dopóki pole nie będzie wypełnione. Użytkownik kliknie przycisk „Zapisz”, a formularz po prostu się nie wyśle – pojawi się komunikat walidacyjny po stronie przeglądarki. To jest tzw. walidacja po stronie klienta, domyślnie wbudowana w HTML.
Z kolei type="email" uruchamia specjalny mechanizm sprawdzania formatu wpisanego tekstu. Przeglądarka sprawdza, czy ciąg znaków wygląda jak adres e‑mail: musi zawierać co najmniej znak @ i jakąś część przed i po nim. To nie jest super zaawansowana walidacja, ale wystarcza jako pierwszy filtr, np. "[email protected]" przejdzie, a "jan.domena.pl" już nie. Moim zdaniem to bardzo wygodne, bo nie trzeba od razu pisać własnego JavaScriptu tylko po to, żeby odsiać oczywiste błędy.
W praktyce w aplikacjach webowych zwykle łączy się tę prostą walidację HTML5 z dodatkowymi sprawdzeniami po stronie serwera (np. w PHP czy w innym backendzie), bo dane z formularza zawsze trzeba traktować z ograniczonym zaufaniem. Dobrym nawykiem jest też dodanie atrybutu name, np. name="email", żeby serwer mógł poprawnie odebrać wartość pola.
Warto też wiedzieć, że niektóre przeglądarki mobilne, gdy widzą type="email", podpowiadają użytkownikowi specjalną klawiaturę z łatwym dostępem do znaku @ i kropki, co realnie poprawia wygodę wpisywania adresu. To taki mały szczegół, ale w profesjonalnych projektach UX ma znaczenie. Podsumowując: required blokuje puste wysłanie formularza, a type="email" wymusza poprawny, podstawowy format adresu ze znakiem @ – dokładnie to opisuje poprawna odpowiedź.
Pytanie 13
Które pojęcie OOP oznacza dostęp do pól i metod TYLKO z poziomu klasy, w której je zadeklarowano?
A.
static
B.
private
Poprawna odpowiedź
C.
const
Twoja odpowiedź
D.
public
Niepoprawna odpowiedź. Pozostałe pojęcia oznaczają co innego. public to PRZECIWIEŃSTWO - składowe dostępne wszędzie. static wiąże składową z klasą, a nie z konkretnym obiektem (nie ogranicza widoczności). const to stała (niezmienna wartość), nie modyfikator dostępu. Dostęp tylko z wnętrza klasy daje private.
Pytanie 14
W języku JavaScript zapisano fragment kodu. Po wykonaniu skryptu zmienna x
<script> var x = 10; x++; console.log(x); </script>
A. będzie równa 11 i zostanie wypisana w oknie popup.
B. będzie równa 11 i zostanie wypisana w konsoli przeglądarki internetowej.Twoja odpowiedź
C. będzie równa 10 i zostanie wypisana w głównym oknie przeglądarki internetowej.
D. będzie równa 10 i zostanie wypisana w dokumencie HTML.
Poprawna odpowiedź. Gratulacje, twoja odpowiedź jest poprawna! Odpowiedź 'będzie równa 11 i zostanie wypisana w konsoli przeglądarki internetowej' jest prawidłowa, ponieważ po zainicjalizowaniu zmiennej x wartością 10 następuje inkrementacja, która zwiększa wartość zmiennej o 1, dając w wyniku 11. Następnie wartość zmiennej x jest wypisywana w konsoli przeglądarki internetowej za pomocą metody console.log(). Jest to standardowa metoda w języku JavaScript do debugowania i śledzenia wartości zmiennych podczas wykonywania kodu. W praktyce, zrozumienie pracy z konsolą przeglądarki jest kluczowe dla efektywnego programowania JavaScript. To umiejętność, która pozwala na szybkie zlokalizowanie i rozwiązanie problemów z kodem. Dobrą praktyką jest również umiejętne korzystanie z operacji inkrementacji, które są podstawą sterowania przepływem i manipulowania danymi w JavaScript.
Pytanie 15
Jakie mechanizmy przyznawania zabezpieczeń, umożliwiające przeprowadzanie operacji na bazie danych, są powiązane z tematyką zarządzania kontami, użytkownikami oraz uprawnieniami?
A. Z przywilejami obiektowymi
B. Z zasadamiTwoja odpowiedź
C. Z atrybutami
D. Z przywilejami systemowymiPoprawna odpowiedź
Niepoprawna odpowiedź. Zagadnienia związane z zarządzaniem kontami, użytkownikami i uprawnieniami w kontekście baz danych są złożone i często mylone z innymi mechanizmami. Reguły, na przykład, są używane w kontekście polityk bezpieczeństwa, ale nie odnoszą się bezpośrednio do przydzielania uprawnień w systemie baz danych. W praktyce, reguły mogą służyć do definiowania warunków, pod którymi dane operacje są dozwolone, ale same w sobie nie kontrolują dostępu do zasobów. Przywileje obiektowe, z drugiej strony, dotyczą specyficznych obiektów w bazie danych, takich jak tabele czy procedury, i nie obejmują uprawnień na poziomie systemowym. W kontekście zarządzania użytkownikami są one używane do kontrolowania dostępu do konkretnych danych, a nie do wykonywania operacji administracyjnych na systemie. Z kolei atrybuty mogą odnosić się do właściwości obiektów w bazie danych, ale nie są to mechanizmy służące do zarządzania użytkownikami i ich uprawnieniami. Typowym błędem jest mylenie tych pojęć i uznawanie, że reguły czy przywileje obiektowe mają podobne zastosowanie do przywilejów systemowych. W realiach zarządzania bazą danych kluczowe jest zrozumienie, że każde z tych podejść ma swoje specyficzne zastosowanie i niezbędne jest stosowanie właściwych narzędzi oraz technik w celu zapewnienia odpowiedniego poziomu bezpieczeństwa i kontroli dostępu.
Pytanie 16
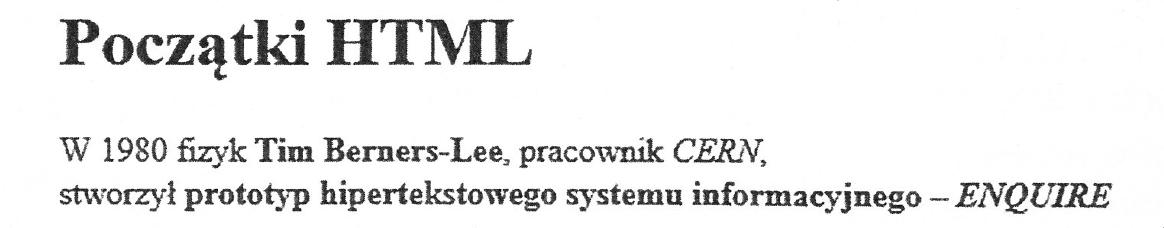
Strona internetowa została napisana w języku XHTML. Który z poniższych kodów przedstawia implementację zamieszczonego fragmentu strony, przy założeniu, że nie zdefiniowano żadnych stylów CSS?
A. <b>Początki HTML</b><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<hr /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>
B. <h1>Początki HTML</h1><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<i>prototyp hipertekstowego systemu informacyjnego - <b>ENQUIRE</b></i></p>
C. <b>Początki HTML</b><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>
D. <h1>Początki HTML</h1><p>W 1980 fizyk <b>Tim Berners-Lee</b>, pracownik <i>CERN</i>,<br /> stworzył<b>prototyp hipertekstowego systemu informacyjnego - <i>ENQUIRE</i></b></p>Twoja odpowiedź
Poprawna odpowiedź. Odpowiedź druga jest prawidłowa, ponieważ w XHTML stosowanie znaczników zgodnych z HTML jest kluczowe. Nagłówek <h1> wskazuje na najbardziej wyróżniający się element na stronie, co jest zgodne z prezentowanym obrazem, gdzie 'Początki HTML' jest nagłówkiem. XHTML wymaga, by wszystkie elementy były poprawnie zagnieżdżone i zamknięte, a tag <br /> jest poprawnie użyty jako samo zamykający się, co jest wymagane w XHTML. Ponadto, struktura dokumentu XHTML musi być bardziej restrykcyjna, co oznacza, że używanie semantycznych znaczników jak <h1> dla nagłówków sprzyja lepszej interpretacji struktury dokumentu przez przeglądarki i narzędzia dostępności. Poprawne użycie <b> i <i> do wyróżniania tekstu jest zgodne ze standardami, chociaż w nowoczesnym HTML5 zaleca się używanie <strong> i <em> dla semantycznego formatowania. Takie podejście wspomaga dostępność oraz ułatwia zrozumienie kodu przez inne osoby. Dobór tagów w tej odpowiedzi pokazuje zrozumienie zasad semantyki oraz poprawnej struktury dokumentów w XHTML co jest zgodne z dobrymi praktykami web developmentu.
Pytanie 17
Proces normalizacji tabel ma na celu
A. wyłącznie stworzenie tabel oraz powiązań w bazie
B. dodanie danych do bazy
C. wizualizację bazy
D. weryfikację i poprawę efektywności bazy danychTwoja odpowiedź
Poprawna odpowiedź. Normalizacja tabel jest procesem, który ma na celu organizację struktury bazy danych w taki sposób, aby zminimalizować redundancję danych oraz zapewnić integralność danych. Proces ten polega na podziale dużych tabel na mniejsze i łączeniu ich za pomocą relacji, co pozwala na efektywniejsze zarządzanie danymi. Przykładem normalizacji może być podział tabeli zawierającej informacje o klientach i ich zamówieniach na dwie oddzielne tabele: jedna do przechowywania danych klientów, a druga do danych zamówień, z relacją między nimi. W praktyce normalizacja, zgodna z metodologią Codd'a, obejmuje kilka poziomych form normalnych, takich jak 1NF, 2NF, i 3NF, z których każda wprowadza dodatkowe ograniczenia i zasady. Przy odpowiedniej normalizacji można uniknąć problemów z aktualizacją danych, takich jak anomalie aktualizacji czy usuwania, co jest kluczowe w utrzymywaniu wysokiej jakości danych w systemach bazodanowych.
Pytanie 18
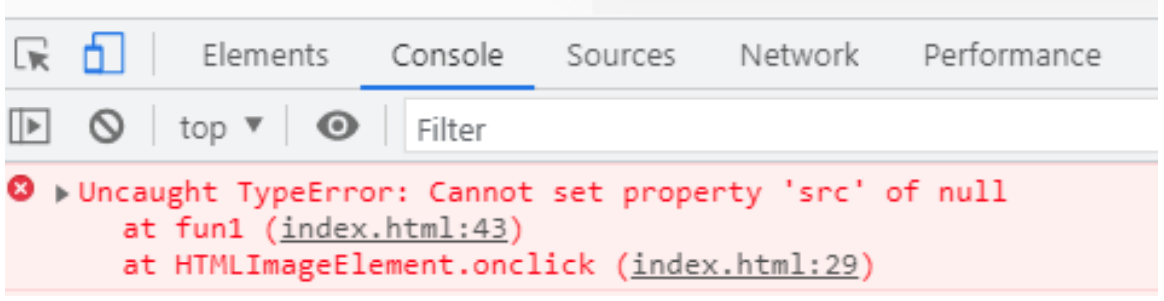
Podczas działania skryptu JavaScript został w konsoli wygenerowany błąd związany z działaniami na atrybucie elementu DOM. Z komunikatu wynika, że próbowano ustawić atrybut dla
A. paragrafu.
B. tabeli.
C. odnośnika.
D. obrazu.Twoja odpowiedź
Poprawna odpowiedź. Twoja odpowiedź była prawidłowa. Błąd 'Uncaught TypeError: Cannot set property 'src' of null' jest związany z próbą przypisania wartości do atrybutu 'src' nieistniejącego elementu DOM. Atrybut 'src' jest charakterystyczny dla elementów HTML obrazu, czyli <img>, i służy do określenia źródła obrazka. Gdy masz do czynienia z błędem tego typu, najczęściej wynika to z próby manipulacji atrybutem 'src' obrazu, który nie istnieje w strukturze DOM, co może wynikać na przykład z błędu w selektorze. Pamiętaj, że przed przypisaniem wartości atrybutu, warto upewnić się, że dany element DOM faktycznie istnieje. W przeciwnym razie, jak w tym przypadku, JavaScript zwróci błąd. Zrozumienie charakterystyki błędów i potrafiące identyfikowanie ich przyczyn jest kluczowe w procesie programowania.
Pytanie 19
Co powinno znaleźć się w dokumentacji TECHNICZNEJ aplikacji (dla programisty)?
A. opis algorytmów i struktury kodu źródłowegoTwoja odpowiedź
B. opis funkcji z perspektywy osoby obsługującej program
C. przewodnik pierwszego uruchomienia dla klienta
D. instrukcja obsługi krok po kroku dla użytkownika
Poprawna odpowiedź. Dokumentacja TECHNICZNA jest przeznaczona dla programisty, więc opisuje wnętrze aplikacji: zastosowane algorytmy, strukturę kodu źródłowego, architekturę i zależności między modułami. Ma ułatwić rozwój i utrzymanie programu. Dlatego znajdzie się w niej opis algorytmów i struktury kodu.
Pytanie 20
Funkcja agregująca MIN w języku SQL służy do obliczenia:
A. liczby wierszy zwróconych przez kwerendę
B. minimalnej wartości w kolumnie zwróconej przez kwerendęTwoja odpowiedź
C. liczby znaków w zwróconych rekordach
D. średniej wartości pól rekordu
Poprawna odpowiedź. Funkcja agregująca MIN zwraca najmniejszą wartość z podanej kolumny, np. SELECTMIN(cena)FROMprodukty poda najniższą cenę. Należy do rodziny funkcji agregujących obok MAX (maksimum), AVG (średnia), SUM (suma) i COUNT (liczność). Działa na kolumnach liczbowych, ale też tekstowych (porządek alfabetyczny) i datach (najwcześniejsza). Często łączy się ją z GROUPBY, by wyznaczyć minimum w każdej grupie. Dlatego MIN oblicza minimalną wartość kolumny.
Pytanie 21
Ile razy zostanie wykonana pętla przedstawiona w kodzie PHP?
for($i=0;$i<25;$i+=5) { ...... }
A. 25
B. 0
C. 5Twoja odpowiedź
D. 26
Poprawna odpowiedź. Pętla for w PHP, zdefiniowana jako for($i = 0; $i < 25; $i += 5), będzie wykonywana do momentu, gdy warunek $i < 25 będzie spełniony. Początkowa wartość $i to 0, a w każdej iteracji zwiększamy $i o 5. Wartości $i w kolejnych iteracjach będą wynosiły: 0, 5, 10, 15, 20. Po piątej iteracji, gdy $i osiągnie wartość 25, warunek $i < 25 przestanie być spełniony, co zakończy działanie pętli. W sumie, pętla wykona się dokładnie pięć razy. Zrozumienie działania pętli for jest kluczowe w programowaniu, ponieważ pozwala na automatyzację wielu zadań, co jest niezbędne w tworzeniu efektywnych i zoptymalizowanych aplikacji. Przykłady zastosowania to iteracja przez elementy tablic, generowanie numerów identyfikacyjnych czy przetwarzanie danych w bazach.
Pytanie 22
W tabeli uczniowie (kolumny: imie, nazwisko, klasa) chcemy wypisać uczniów, których nazwisko zaczyna się na literę M. Które zapytanie jest poprawne?
Poprawna odpowiedź. Do wyszukiwania według wzorca tekstowego służy operator LIKE w klauzuli WHERE. Znak % zastępuje dowolny ciąg znaków, więc nazwiskoLIKE"M%" dopasuje wszystkie nazwiska zaczynające się na M. Poprawne zapytanie to SELECTnazwisko,imieFROMuczniowieWHEREnazwiskoLIKE"M%". Dlatego ta odpowiedź jest właściwa.
Pytanie 23
Który z czynników ma negatywny wpływ na efektywną współpracę w zespole?
A. wzajemny szacunek
B. efektywna komunikacja
C. rywalizacja między członkami zespołuTwoja odpowiedź
D. jasny podział ról i obowiązków
Poprawna odpowiedź. Efektywna współpraca w zespole opiera się na zaufaniu, wzajemnym szacunku, dobrej komunikacji i jasnym podziale ról. Czynnikiem, który ją osłabia, jest rywalizacja między członkami zespołu - zamiast dążyć do wspólnego celu, ludzie zaczynają konkurować, ukrywać informacje i przypisywać sobie zasługi, co rodzi konflikty. Zdrowa współpraca stawia na wspólny wynik, a nie na pokonanie kolegów. Dlatego negatywny wpływ ma rywalizacja w zespole.
Pytanie 24
Podaj polecenie SQL, które wprowadza kolumnę miesiacSiewu do istniejącej tabeli rosliny?
A. ALTER TABLE rosliny ADD miesiacSiewu intTwoja odpowiedź
B. UPDATE rosliny ADD miesiacSiewu int
C. CREATE TABLE rosliny {miesiacSiewu int}
D. INSERT INTO rosliny VALUES (miesiacSiewu int)
Poprawna odpowiedź. Poprawna odpowiedź to ALTER TABLE rosliny ADD miesiacSiewu int. To polecenie SQL jest używane do modyfikacji istniejącej tabeli w bazie danych. W tym przypadku, zmiana dotyczy dodania nowego pola 'miesiacSiewu', które określi miesiąc siewu roślin. Typ danych 'int' oznacza, że wartość tego pola będzie przechowywana jako liczba całkowita, co jest odpowiednie, jeśli miesiące będą reprezentowane jako liczby od 1 do 12. Przykład użycia polecenia w praktyce: po dodaniu tego pola można wprowadzać dane o miesiącu siewu dla różnych roślin, co może być przydatne w systemach zarządzania uprawami. Dobrą praktyką jest zawsze dokumentować zmiany w schemacie bazy danych, aby zapewnić spójność i przejrzystość w zarządzaniu danymi. Ważne jest również, aby przed modyfikacją tabeli upewnić się, że nie wprowadza to konfliktów z istniejącymi danymi lub strukturami.
Pytanie 25
Jak w PHP przypisać wartość 4 do zmiennej sesyjnej o nazwie wyborID?
A.
session.wyborID={4};
B.
session.wyborID=4;
Twoja odpowiedź
C.
$_SESSION[4]=wyborID;
D.
$_SESSION["wyborID"]=4;
Poprawna odpowiedź
Niepoprawna odpowiedź. Pozostałe zapisy są błędne. session.wyborID=4 używa notacji kropkowej (z innych języków), a w PHP do sesji sięga się przez $_SESSION[...]. $_SESSION[4]=wyborID zamienia klucz z wartością miejscami. Poprawne jest $_SESSION["wyborID"]=4;.
Pytanie 26
Aby grupować sekcje na poziomie bloków, które będą stilizowane za pomocą znaczników, jakiego należy użyć?
A. <param>
B. <p>
C. <span>Twoja odpowiedź
D. <div>Poprawna odpowiedź
Niepoprawna odpowiedź. Znak <p> jest przeznaczony wyłącznie do definiowania akapitów tekstowych, co czyni go niewłaściwym narzędziem do ogólnego grupowania obszarów. Nie jest to element blokowy, który mógłby pomieścić inne znaczniki w sposób, który umożliwiałby ich efektywne stylizowanie jako całości. Zastosowanie <p> do grupowania elementów np. obrazków i przycisków mogłoby prowadzić do nieoczekiwanych rezultatów w prezentacji treści oraz problemów z dostępnością. Z kolei znacznik <span> jest elementem inline, co oznacza, że nie łamie linii i może być używany do stylizacji mniejszych fragmentów tekstu. Jego zastosowanie do grupowania bloków treści byłoby nieodpowiednie, ponieważ nie potrafi on zarządzać rozkładem elementów na stronie. Ostatnim błędem w wyborze niepoprawnych odpowiedzi jest <param>, który jest znakiem używanym do definiowania parametrów dla obiektów w znaczeniu <object>. Jest on całkowicie nieadekwatny w kontekście grupowania treści, ponieważ nie służy do stylizacji ani strukturalizacji dokumentu HTML. Użycie <param> w tym kontekście jest mylące i nie odzwierciedla rzeczywistych potrzeb związanych z organizacją treści w dokumentach webowych.
Pytanie 27
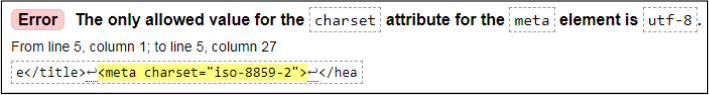
Podczas walidacji strony napotkano błąd. Co to oznacza?
A. znacznik meta nie zawiera atrybutu charset
B. w atrybucie charset dopuszczalna jest wyłącznie wartość "utf-8"Poprawna odpowiedź
C. określenie kodowania znaków musi być zapisane bez użycia myślników
D. oznaczenie ISO-8859-2 jest nieprawidłoweTwoja odpowiedź
Niepoprawna odpowiedź. Podczas walidacji strony często spotykany błąd może dotyczyć niepoprawnego kodowania znaków co jest kluczowe dla poprawnego wyświetlania treści w różnych językach. Oznaczenie ISO-8859-2 choć istnieje i jest stosowane dla niektórych kodowań środkowoeuropejskich nie jest zalecane w nowoczesnych standardach webowych. Właściwym podejściem jest stosowanie UTF-8 które jest bardziej uniwersalne i wspierane przez współczesne przeglądarki. Twierdzenie że w znaczniku meta nie występuje atrybut charset jest błędne ponieważ jest to jeden z podstawowych elementów definiujących jak przeglądarka powinna interpretować znaki na stronie internetowej. Użycie tego atrybutu jest kluczowe dla uniknięcia problemów z wyświetlaniem znaków specjalnych. Kolejna koncepcja że w atrybucie charset jest dozwolona wyłącznie wartość utf-8 jest prawidłowa ale wymaga zrozumienia że jest to jedynie zalecenie zgodne z HTML5 które zapewnia największą kompatybilność i elastyczność. Natomiast oznaczenie kodowania znaków bez myślników nie jest standardem przyjętym w żadnej popularnej specyfikacji co oznacza że takie podejście jest błędne. W praktyce zawsze warto sięgać po zalecane rozwiązania zapewniające poprawność i kompatybilność treści webowych. Użycie niepoprawnego kodowania może prowadzić do błędów w interpretacji i wyświetlaniu stron co jest szczególnie istotne w kontekście międzynarodowych aplikacji i stron internetowych. Współczesne standardy bezpieczeństwa i dostępności stron internetowych jednoznacznie wskazują że stosowanie UTF-8 jest najlepszą praktyką pozwalającą unikać wielu problematycznych sytuacji w międzynarodowym środowisku internetowym. Dążenie do zgodności z tym standardem jest nie tylko rekomendowane ale wręcz wymagane w kontekście tworzenia profesjonalnych i dostępnych stron internetowych. To podejście gwarantuje że treści będą prawidłowo odczytywane przez przeglądarki na całym świecie.
Pytanie 28
Dla strony internetowej stworzono styl, który będzie stosowany tylko do wybranych znaczników, takich jak niektóre nagłówki oraz kilka akapitów. W tej sytuacji, aby przypisać styl do konkretnych znaczników, najodpowiedniejsze będzie użycie
A. klasyPoprawna odpowiedź
B. pseudoklasy
C. identyfikatoraTwoja odpowiedź
D. selektora akapitu
Niepoprawna odpowiedź. Pseudoklasy w CSS są używane do stylizowania elementów w określonym stanie, np. :hover dla zmiany stylu po najechaniu myszą. Nie są odpowiednie do przypisywania unikalnych stylów do konkretnych elementów. Identyfikator w CSS, oznaczany przez #, jest używany do stylizowania jednego unikalnego elementu na stronie. Jego użycie jest ograniczone do jednego elementu, co jest zgodne z zasadą unikalności identyfikatorów w dokumencie HTML. Nie nadaje się do sytuacji, gdy ten sam styl ma być stosowany do wielu elementów, ponieważ zmuszałoby to do definiowania i przypisywania wielu unikalnych identyfikatorów do każdego z nich, co jest przeciwieństwem DRY (Don't Repeat Yourself). Selektor akapitu bezpośrednio odnosi się do wszystkich elementów danego typu, np. p dla wszystkich akapitów. Nie jest on elastyczny, gdy chcemy zastosować styl tylko do niektórych elementów danego typu. Klasy oferują większą elastyczność w zarządzaniu stylami wielu elementów, ponieważ mogą być stosowane do różnych typów elementów w różnych miejscach dokumentu HTML. Ponadto, klasy są bardziej czytelne i ułatwiają utrzymanie kodu, co jest zgodne z najlepszymi praktykami w programowaniu front-endowym. Użycie klas wspiera również lepszą strukturę i modularność kodu CSS, co jest istotne w kontekście pracy zespołowej oraz skalowalności projektu.
Pytanie 29
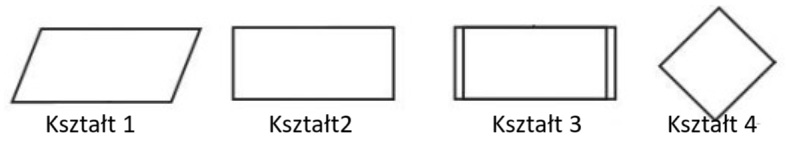
W algorytmie jeden z bloków ma wpisaną akcję "Wypisz liczbę". Który z kształtów może przyjąć tę akcję?
A. Kształt 3.
B. Kształt 1.Poprawna odpowiedź
C. Kształt 4.
D. Kształt 2.Twoja odpowiedź
Niepoprawna odpowiedź. Niestety, udzieliłeś nieprawidłowej odpowiedzi. W algorytmie, akcje takie jak 'wypisz liczbę' są zwykle zawarte w blokach oznaczających konkretne działania, które algorytm powinien wykonać. Kształt 1, który wybrałeś jako odpowiedź, jest standardowym oznaczeniem dla bloków akcji w notacjach diagramów przepływu, co oznacza, że algorytm powinien wykonać pewną operację lub działanie. Inne kształty, takie jak kształt 2, 3 lub 4, mogą reprezentować inne elementy algorytmu, takie jak decyzje, procesy wejścia lub wyjścia, lub podprocesy. Te kształty służą do oznaczania różnych aspektów przepływu sterowania w algorytmie, ale żaden z nich nie jest przeznaczony do reprezentowania akcji, takich jak 'wypisz liczbę'. Zrozumienie znaczenia i zastosowania tych różnych kształtów jest kluczowe dla efektywnego czytania i tworzenia diagramów przepływu, które są niezbędne w programowaniu i analizie systemów.
Pytanie 30
W JavaScript zdefiniowano obiekt. W jaki sposób można uzyskać dostęp do właściwości nazwisko?
var osoba = {imie: "Anna", nazwisko: "Kowalska", rok_urodzenia: 1985};
A. osoba[1]
B. osoba.nazwiskoTwoja odpowiedź
C. osoba::nazwisko
D. osoba[2]
Poprawna odpowiedź. Odpowiedź osoba.nazwisko jest prawidłowa, ponieważ w JavaScript do właściwości obiektu można odwoływać się za pomocą notacji kropkowej. Jest to jedna z najbardziej czytelnych i powszechnie stosowanych metod dostępu do właściwości obiektu w programowaniu obiektowym. Kiedy mamy obiekt o nazwie osoba, który został zdefiniowany z właściwościami takimi jak imie, nazwisko i rok_urodzenia, notacja kropkowa pozwala bezpośrednio i intuicyjnie odczytać wartość przypisaną do klucza nazwisko. Ważne jest, aby zrozumieć, że notacja kropkowa nie tylko zwiększa czytelność kodu, ale także ułatwia jego utrzymanie i modyfikację przez innych programistów. Stosowanie tego standardu jest zgodne z najlepszymi praktykami w branży, promującymi pisanie zrozumiałego i efektywnego kodu. Warto również pamiętać, że notacja kropkowa jest preferowana, gdy nazwy kluczy są znane i nie zawierają znaków, które mogą kolidować z syntaksą języka, takich jak spacje. W przypadku bardziej złożonych kluczy można używać notacji nawiasowej, która mimo że jest bardziej elastyczna, nie zawsze jest tak przejrzysta jak notacja kropkowa. Przykłady praktyczne obejmują zastosowania w aplikacjach webowych, gdzie obiekty mogą reprezentować zasoby użytkownika, a notacja kropkowa umożliwia bezpośredni dostęp do danych użytkownika w celu ich wyświetlenia lub edycji w interfejsie aplikacji.
Pytanie 31
Jak umieścić komentarz w kodzie PHP?
A. /* ... */Twoja odpowiedź
B. /? ... ?/
C. <!-- ... -->
D. <? ... ?>
Poprawna odpowiedź. Komentarze w kodzie PHP są kluczowym elementem, który pozwala programistom na dodawanie wyjaśnień, notatek czy informacji o kodzie, co znacznie ułatwia jego późniejsze zrozumienie i konserwację. Komentarze w PHP można umieszczać za pomocą podwójnego ukośnika (//) dla pojedynczych linii lub za pomocą /* ... */ dla komentarzy wieloliniowych. Wybrana odpowiedź /* ... */ jest poprawna, ponieważ umożliwia dodawanie dłuższych bloków tekstu, co jest praktyczne w przypadku skomplikowanych funkcji czy klas. Stosowanie komentarzy jest zgodne z dobrymi praktykami programowania, które zalecają dokumentowanie kodu, aby ułatwić współpracę w zespole oraz pomóc innym programistom w zrozumieniu funkcji i celu poszczególnych fragmentów kodu. Na przykład, podczas tworzenia złożonej aplikacji webowej, dobrze udokumentowany kod pozwoli zespołowi szybciej rozwiązywać problemy i wprowadzać zmiany, co jest kluczowe w dynamicznie zmieniającym się środowisku IT.
Pytanie 32
Jaki wynik wyświetli poniższy fragment kodu JavaScript?
x='Powodzenia na egzaminie'; z=x.substring(3,9); y=z.substring(2,4); document.write(y);
A. woTwoja odpowiedź
B. zePoprawna odpowiedź
C. owodzeni
D. wodzenia
Niepoprawna odpowiedź. W analizowanym zadaniu błędne odpowiedzi wynikają z nieprawidłowego zrozumienia działania funkcji substring w JavaScript która służy do ekstrakcji fragmentu tekstu z ciągu. Kluczowym elementem jest tutaj zrozumienie że indeksowanie stringów zaczyna się od zera co oznacza że pierwszy znak w ciągu ma indeks 0. W przypadku x.substring(3,9) funkcja ta wyodrębnia znaki od indeksu 3 do 8 ponieważ drugi parametr w tej funkcji jest ekskluzywny co oznacza że nie jest uwzględniany w wyniku. Dlatego daje to fragment wodzen. Kolejna operacja z.substring(2,4) bierze pod uwagę wycinek od indeksu 2 do 3 tego nowego ciągu co skutkuje wynikiem ze. Błędne odpowiedzi mogą wynikać z nieznajomości tego jak działa substr w porównaniu do substring ponieważ substr używa innego podejścia wskazując długość a nie końcowy indeks. Innym częstym błędem jest mylenie indeksów co prowadzi do nieprawidłowych wycinków tekstu. Błędy takie mogą prowadzić do problemów w kodzie zwłaszcza przy przetwarzaniu danych wejściowych czy dynamicznym generowaniu zawartości strony co jest częstym zadaniem w web development. Zrozumienie jak dokładnie działa każdy z tych mechanizmów jest kluczowe dla tworzenia poprawnego i bezpiecznego kodu. Warto także pamiętać o testowaniu kodu aby uniknąć nieprzewidywalnych zachowań wynikających z nieprawidłowych wycinków tekstu co może wpłynąć na całość aplikacji.
Pytanie 33
Tabela filmy dysponuje kluczem głównym id oraz kluczem obcym rezyserlD. Tabela rezyserzy posiada klucz główny id. Obie tabele są połączone relacją jeden do wielu, gdzie rezyserzy są po stronie jeden, a filmy po stronie wiele. Jak należy zapisać kwerendę SELECT, aby połączyć tabele filmy i rezyserzy?
A. ... filmy JOIN rezyserzy ON filmy.id = rezyserzy.filmylD ...Twoja odpowiedź
B. ... filmy JOIN rezyserzy ON filmy.id = rezyserzy.id ...
C. ... filmy JOIN rezyserzy ON filmy.rezyserlD = rezyserzy.id ...Poprawna odpowiedź
D. ... filmy JOIN rezyserzy ON filmy.rezyserlD = rezyserzy.filmylD ...
Niepoprawna odpowiedź. Wybór błędnych opcji opiera się na nieprawidłowym zrozumieniu relacji między tabelami oraz zasad normalizacji danych. W pierwszej z niepoprawnych odpowiedzi użycie 'filmy.rezyserlD = rezyserzy.filmylD' błędnie zakłada, że 'filmylD' jest kluczem w tabeli 'rezyserzy', podczas gdy w rzeczywistości jest to klucz obcy w tabeli 'filmy'. Może to prowadzić do nieporozumień podczas analizy danych. W drugiej odpowiedzi, porównanie 'filmy.id = rezyserzy.filmylD' wprowadza dodatkowy błąd, ponieważ klucz 'id' w tabeli 'filmy' jest niezwiązany z 'filmylD', co skutkuje odwołaniem do niewłaściwych danych. Z kolei trzecia odpowiedź, w której porównuje się 'filmy.id = rezyserzy.id', całkowicie ignoruje relację między tymi tabelami, co prowadzi do niepoprawnych wyników, jako że oba 'id' są kluczami głównymi w swoich tabelach i nie powinny być ze sobą porównywane. Typowe błędy myślowe w tym przypadku wynikają z nieprawidłowego rozumienia działania kluczy obcych oraz sposobu, w jaki tabele są ze sobą powiązane. Kluczowe jest, aby przy projektowaniu bazy danych zrozumieć, jak relacje między tabelami wpływają na struktury zapytań. Aby skutecznie pracować z bazami danych, ważne jest, aby przestrzegać zasad normalizacji oraz stosować odpowiednie klucze w relacjach, co zapewnia integralność danych i poprawność wyników zapytań.
Pytanie 34
Jak brzmi nazwa metody sortowania, która polega na wielokrotnym analizowaniu kolejnych elementów tablicy oraz zamianie miejscami sąsiadujących elementów, aby utrzymać porządek według ustalonej reguły?
A. Sortowanie kubełkoweTwoja odpowiedź
B. Sortowanie przez wybór
C. Sortowanie bąbelkowePoprawna odpowiedź
D. Sortowanie szybkie
Niepoprawna odpowiedź. Wybór sortowania przez wybór, sortowania szybkiego oraz sortowania kubełkowego odnosi się do różnych metod organizacji danych, które różnią się zarówno w zakresie algorytmicznym, jak i zastosowaniami praktycznymi. Sortowanie przez wybór (Selection Sort) polega na znajdowaniu najmniejszego (lub największego) elementu z nieposortowanej części tablicy i zamienieniu go z pierwszym elementem tej części. To podejście jest mniej efektywne dla dużych zbiorów danych, ponieważ również ma złożoność O(n²) i nie korzysta z optymalizacji, które mogłyby przyspieszyć proces sortowania. Z kolei sortowanie szybkie (Quick Sort) to bardziej zaawansowana technika, która dzieli tablicę na mniejsze podtablice i sortuje je rekurencyjnie, co daje średnią złożoność O(n log n). To sprawia, że jest preferowane w aplikacjach, gdzie wydajność jest kluczowa. Sortowanie kubełkowe (Bucket Sort) z kolei polega na podziale danych na kilka "kubełków" i sortowaniu ich wewnętrznie, co również ma na celu zwiększenie efektywności sortowania, zwłaszcza w przypadku danych rozłożonych równomiernie. Typowe błędy myślowe, które mogą prowadzić do niepoprawnych wniosków, to mylenie różnorodnych technik sortowania na podstawie ich nazwy lub złożoności, a także zakładanie, że prostsze metody, jak sortowanie bąbelkowe, są wystarczające dla wszystkich przypadków bez uwzględnienia wymagań dotyczących wydajności.
Pytanie 35
Zapis w języku JavaScript:
x=przedmiot.nazwa();
wskazuje, że
A. Zmienna x będzie przechowywać rezultat działania funkcji przedmiot.
B. nazwa jest polem w klasie przedmiot.
C. nazwa stanowi właściwość obiektu przedmiot.
D. Zmienna x będzie przechowywać rezultat wykonania metody nazwa.Twoja odpowiedź
Poprawna odpowiedź. W kodzie JavaScript zapis x = przedmiot.nazwa(); oznacza, że zmienna x będzie przechowywać wynik działania metody nazwa, która jest zdefiniowana w obiekcie przedmiot. W JavaScript metody są funkcjami przypisanymi do obiektów, co oznacza, że mogą one operować na danych wewnątrz tych obiektów. Przykładem może być klasa 'Osoba', która ma metodę 'pobierzImie', zwracającą imię danej osoby. W wywołaniu 'let imie = osoba.pobierzImie();', zmienna imie przechowa wynik działania tej metody. Dobrą praktyką jest, aby metody były odpowiedzialne za operacje związane z danymi, które przechowują, co zwiększa modularność i czytelność kodu. W kontekście standardów programowania, zachowanie to wspiera zasady OOP (programowania obiektowego), umożliwiając enkapsulację oraz ponowne wykorzystanie kodu. Dobrze zdefiniowane metody zwiększają spójność i ułatwiają testowanie jednostkowe. W efekcie, zawsze warto dążyć do klarownego definiowania metod w obiektach, aby poprawić jakość i efektywność pisania kodu.
Pytanie 36
Po uruchomieniu kodu PHP
echodate("Y-m");
na ekranie pojawi się bieżąca data w formacie:
A. dnia, miesiąca, roku
B. roku oraz miesiącaTwoja odpowiedź
C. dnia i roku
D. tylko roku
Poprawna odpowiedź. Odpowiedź 'rok i miesiąc' jest prawidłowa, ponieważ funkcja 'date' w PHP formatuje datę na podstawie podanego wzorca. W przypadku użycia wzorca 'Y-m', 'Y' oznacza pełny rok (np. 2023), a 'm' oznacza dwucyfrowy miesiąc (np. 03 dla marca). W wyniku działania 'echo date("Y-m");' na ekranie zostanie wyświetlona aktualna data w formacie YYYY-MM, co jest niezwykle przydatne w wielu aplikacjach, takich jak generowanie raportów miesięcznych, archiwizacja danych czy implementacja systemów zarządzania treścią. Użycie tego wzorca jest zgodne z najlepszymi praktykami programistycznymi, które zalecają właściwe formatowanie daty w celu jej późniejszej analizy lub prezentacji. Ponadto, umiejętność manipulacji datami w PHP jest kluczowa w kontekście tworzenia aplikacji webowych, które często wymagają interakcji z użytkownikami w czasie rzeczywistym, a także integracji z bazami danych, gdzie prawidłowe formatowanie daty ma kluczowe znaczenie dla integralności danych.
Pytanie 37
W języku HTML atrybut shape w znaczniku area, który definiuje typ obszaru, może mieć wartość
A. rect, square, circleTwoja odpowiedź
B. poly, square, circle
C. rect, poly, circlePoprawna odpowiedź
D. rect, triangle, circle
Niepoprawna odpowiedź. Wybór nieprawidłowych wartości atrybutu shape może prowadzić do istotnych deficytów w funkcjonalności interaktywnych map obrazów. Na przykład, odpowiedź z wykorzystaniem wartości triangle jest błędna, gdyż HTML nie definiuje obsługi trójkąta jako kształtu obszaru w znaczniku area. Użytkownicy mogą błędnie zakładać, że różne kształty mogą być dowolnie definiowane, co jest mylnym podejściem, ponieważ HTML ma ściśle określone standardy dotyczące kształtów. Odpowiedzi takie jak square czy rectangle mogą prowadzić do nieporozumień, gdyż square jest de facto specjalnym przypadkiem rect. W praktyce, zrozumienie różnicy pomiędzy tymi wartościami oraz ich właściwe wykorzystanie jest kluczowe dla osiągnięcia zamierzonych celów w zakresie interaktywności. Używanie niewłaściwych kształtów może skutkować niewłaściwą nawigacją na stronie, co negatywnie wpływa na doświadczenia użytkowników oraz dostępność treści. Dlatego ważne jest, aby projektanci stron WWW opierali się na rzetelnych źródłach dokumentacji oraz standardów W3C, które definiują, jakie kształty są dostępne oraz w jaki sposób powinny być stosowane. Zastosowanie niepoprawnych wartości nie tylko wpłynie na działanie mapy, ale również może prowadzić do błędów w SEO, ponieważ niewłaściwie zdefiniowane obszary mogą być pomijane przez wyszukiwarki, co ogranicza widoczność strony w sieci.
Pytanie 38
Jak przy użyciu języka PHP można zapisać w ciasteczku wartość z zmiennej dane na okres jednego dnia?
A. setcookie("dane",$dane,0)
B. setcookie("dane",$dane,time()+(3600*24))Poprawna odpowiedź
C. setcookie("dane",$dane,time())Twoja odpowiedź
D. setcookie("dane","dane",0)
Niepoprawna odpowiedź. W przypadku odpowiedzi, które nie spełniają wymagań dotyczących prawidłowego ustawienia ciasteczka, można zauważyć kilka typowych błędów myślowych. Na przykład odpowiedź setcookie("dane", $dane, 0); ustawia czas wygaśnięcia ciasteczka na 0, co oznacza, że ciasteczko będzie dostępne tylko przez bieżącą sesję, a po zamknięciu przeglądarki zostanie usunięte. To podejście nie spełnia założenia przechowywania danych na jeden dzień. Z kolei odpowiedź setcookie("dane", "dane", 0); również ustawia ciasteczko na czas trwania sesji, a dodatkowo przechowuje w nim literalny tekst "dane" zamiast wartości zmiennej, co może prowadzić do dezorientacji i błędów, jeśli zmienna $dane miała zawierać dynamiczne dane użytkownika. W odpowiedzi setcookie("dane", $dane, time()); brakuje określenia czasu wygaśnięcia, co skutkuje tym, że ciasteczko również wygasa po zamknięciu przeglądarki. Kluczowym błędem jest więc nieustawienie prawidłowego czasu, co jest fundamentalne w kontekście sesji użytkowników w aplikacjach webowych. Ciasteczka są często wykorzystywane do personalizacji doświadczeń użytkownika, a ich prawidłowe ustawienie jest kluczowe dla zachowania danych przez adekwatny czas. Dlatego ważne jest zrozumienie, że odpowiednie zarządzanie ciasteczkami wymaga świadomości dotyczącej czasu wygaśnięcia oraz poprawnego przypisywania wartości.
Pytanie 39
Jakie będzie rezultatem działania poniższego kodu PHP?
Niepoprawna odpowiedź. Analizowany kod PHP to przykład użycia operatorów logicznych w strukturze sterującej if-else, gdzie każda z odpowiedzi reprezentuje wynik działania konkretnego bloku kodu. Zmienna $a i $c są zainicjalizowane jako true, natomiast $b i $d jako false. Zrozumienie tego jest kluczowe dla poprawnej analizy logicznej. Pierwszy warunek if z ($a && $b) || ($c && $d) nie zostaje spełniony, ponieważ zarówno (true && false) jak i (true && false) zwracają false, co skutkuje false || false, czyli false. Kolejna sekcja elseif obejmuje ($a && $b) || ($c || $d). Tutaj (true && false) zwraca false, ale (true || false) daje true, co prowadzi do false || true, czyli true, co spełnia warunek i 'warunek2' zostaje wyświetlony. Trzeci warunek elseif, sprawdzający ($c && $d) || (!$a), nie jest rozpatrywany, ponieważ poprzedni warunek był już true. Warto podkreślić znaczenie logicznych operatorów w programowaniu: && i || odpowiadają za łączenie warunków, a ich poprawne zrozumienie pozwala na efektywne modelowanie logiki aplikacji. Typowym błędem jest mylenie znaczenia tych operatorów, co może prowadzić do błędnych decyzji warunkowych w kodzie. Programiści powinni zawsze upewniać się, że logika warunków jest zgodna z zamierzonym działaniem programu, a testowanie jest kluczowym elementem tego procesu. Zastosowanie testów jednostkowych może pomóc w zapewnieniu prawidłowego działania skomplikowanych struktur logicznych, pozwalając na wykrycie i korektę potencjalnych błędów logicznych.
Pytanie 40
Czynnością zalecaną przed wykonaniem kopii zapasowej bazy danych MySQL jest:
A. sprawdzenie, czy baza jest dostatecznie wydajna
B. sprawdzenie integralności bazy i ewentualna jej naprawaTwoja odpowiedź
C. nadanie administratorowi uprawnień do przeglądania bazy
D. zdefiniowanie systemu kodowania znaków w bazie
Poprawna odpowiedź. Kopia zapasowa ma sens tylko, gdy zapisuje sprawne dane. Jeśli baza jest uszkodzona, backup utrwali błędy i przy odtwarzaniu odzyskamy wadliwy stan. Dlatego przed wykonaniem kopii zaleca się sprawdzenie integralności bazy (np. CHECKTABLE) i ewentualną naprawę (REPAIRTABLE). Dopiero zdrową bazę warto archiwizować. Dlatego poprawne jest sprawdzenie integralności i ewentualna naprawa.