Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 00:08
Zakończenie: 29 września 2026 00:15 Rozwiązano w aplikacji mobilnej
Egzamin zdany!
Wynik: 24/40 punktów (60,0%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Jako strzał oznaczono 1 odpowiedź - trafionych: 0.
Z odpowiedzi deklarowanych jako pewne poprawnych było 24 z 39. Trafiony strzał to nie jest wiedza - te pytania warto powtórzyć w pierwszej kolejności.
Twój wynik na tle innych
Twój wynik jest lepszy niż 25% podejść do kwalifikacji INF.04.
Porównanie z 23416 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 70,0%, teraz 60,0% (-10,0 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Jakie metody pozwalają na przesłanie danych z serwera do aplikacji front-end?
A. formatu JSONTwoja odpowiedź
B. biblioteki jQuery
C. protokołu SSH
D. metody POST
Poprawna odpowiedź. Format JSON to zdecydowanie najpopularniejszy i najwygodniejszy sposób przesyłania danych pomiędzy serwerem a aplikacją front-end. JSON, czyli JavaScript Object Notation, jest lekkim formatem wymiany danych, który został zaprojektowany właśnie pod kątem prostoty odczytu i zapisu, zarówno przez ludzi, jak i maszyny. Moim zdaniem trudno dziś znaleźć nowoczesną aplikację webową, która nie korzysta z JSON-a. W praktyce wygląda to tak, że serwer generuje odpowiedź HTTP z danymi w formacie JSON, a front-end (często napisany w JavaScript lub TypeScript) potrafi je bez problemu sparsować i wykorzystać. Standardy branżowe – jak REST API czy GraphQL – bazują w dużej mierze na tym formacie, bo jest uniwersalny, prosty i dobrze wspierany przez frameworki. JSON wspiera nawet zagnieżdżone struktury, tablice, obiekty, więc przekazywanie danych jest bardzo elastyczne. Z mojego doświadczenia, dzięki JSON-owi można bardzo sprawnie integrować różne technologie na back-endzie i front-endzie, co się naprawdę często przydaje przy dużych projektach. Warto pamiętać, że praktycznie każdy język programowania ma biblioteki do obsługi JSON-a, więc nie ma tu żadnych barier technologicznych. Nawet przy komunikacji asynchronicznej (np. z użyciem fetch czy XMLHttpRequest) JSON jest domyślnym wyborem. Tak naprawdę, jeśli chodzi o wymianę danych w aplikacjach webowych, JSON jest po prostu standardem de facto i warto go dobrze znać.
Pytanie 2
Co należy do zadań interpretera?
A. przekładanie kodu na kod maszynowy
B. ulepszanie większej części kodu, aby przyspieszyć jego wykonanie
C. sprawdzanie składni całego programu przed jego uruchomieniem
D. wykonanie skryptu instrukcja po instrukcjiTwoja odpowiedź
Poprawna odpowiedź. Interpreter to taki program, który odczytuje kod źródłowy i wykonuje go krok po kroku, instrukcja po instrukcji, bez wcześniejszego tłumaczenia całości na kod maszynowy. W praktyce oznacza to, że interpreter analizuje każdą linię lub blok kodu i natychmiast realizuje odpowiadające im działania na komputerze. Przykładem są języki takie jak Python czy JavaScript – tam właśnie interpreter gra główną rolę. Umożliwia to szybkie testowanie i prototypowanie, bo nie trzeba czekać na kompilację całego programu, wystarczy wpisać polecenie i od razu widzimy efekt. Moim zdaniem to genialne rozwiązanie zwłaszcza do nauki programowania czy pisania prostych skryptów systemowych, gdzie liczy się szybka informacja zwrotna. Warto wiedzieć, że interpreter nie generuje pliku wykonywalnego na stałe – każdy raz trzeba uruchomić kod za jego pośrednictwem. W branży często używa się interpreterów do automatyzacji zadań, analizy danych czy tworzenia narzędzi do testów. Z własnego doświadczenia wiem, że interpreter pozwala łatwo wyłapać błędy logiczne na bieżąco, chociażby w konsoli Pythona. To świetne narzędzie, gdy chcemy eksperymentować z kodem, bo nic nie stoi na przeszkodzie, żeby szybko coś zmodyfikować i od razu zobaczyć rezultat. Trzeba tylko pamiętać, że takie podejście czasem może być wolniejsze niż wykonanie kodu skompilowanego, ale w wielu zadaniach wygoda i elastyczność przeważają nad wydajnością.
Pytanie 3
Jaka jest składnia komentarza jednoliniowego w języku Python?
A. ""
B. #Poprawna odpowiedź
C. //Twoja odpowiedź
D. !
Niepoprawna odpowiedź. W programowaniu bardzo ważne jest rozróżnianie składni danego języka, bo nawet drobny błąd może skutkować tym, że kod nie zadziała albo zachowa się nieprzewidywalnie. Jeśli chodzi o komentarze jednoliniowe, Python stosuje do tego wyłącznie znak #. Często osoby zaczynające naukę Pythona mylą ten język np. z C#, C++ czy Javą, gdzie do komentarzy jednoliniowych używa się dwóch ukośników, czyli //. Takie podejście w Pythonie niestety nie działa – interpreter potraktuje // jako operator dzielenia całkowitego, a nie jako sygnał zignorowania reszty linii. Z kolei cudzysłowy, czyli "", są w Pythonie używane do oznaczania łańcuchów znaków (stringów), natomiast pojedynczy wykrzyknik (!) nie ma żadnego specjalnego zastosowania w kontekście komentarzy. To typowy błąd początkujących: mylą składnię z innych języków lub próbują zgadywać, zamiast sprawdzić dokumentację. Przy projektach zespołowych takie nieporozumienia mogą spowodować, że kod staje się mniej czytelny albo wręcz wywołuje błędy. Warto pamiętać, że dobry komentarz to nie tylko kwestia znaków – to też wyjaśnienie intencji i logiki działania kodu dla siebie i innych. W standardzie Pythona (PEP 8) jasno określono, że jedyną poprawną formą komentarza jednoliniowego jest użycie #. Pomijanie tej reguły może skutkować nie tylko błędami, ale też nieczytelnością kodu i trudnościami w jego utrzymaniu. W praktyce im szybciej wypracuje się nawyk poprawnego komentowania, tym lepiej dla całego procesu programowania i wspólnej pracy nad projektem.
Pytanie 4
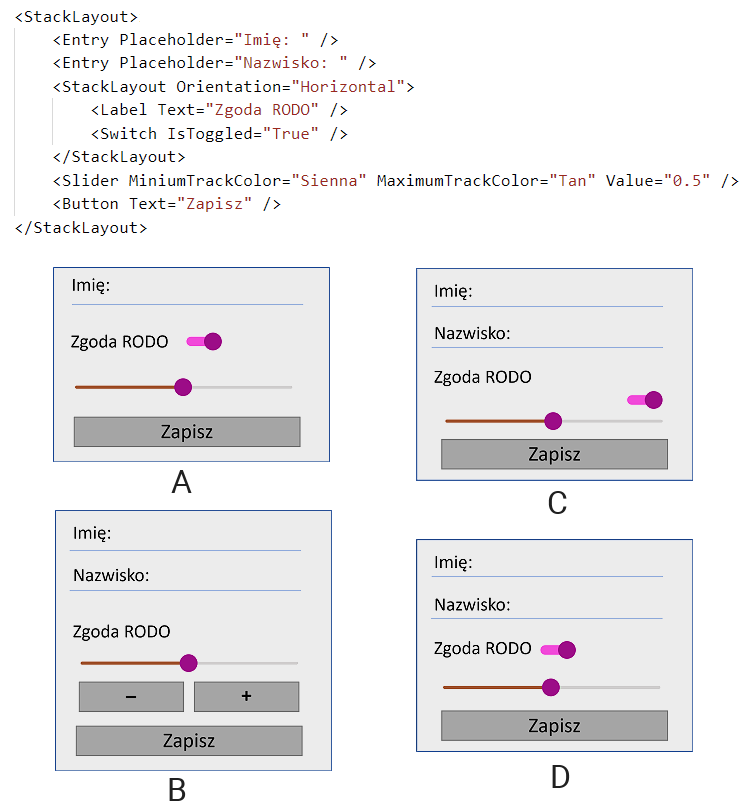
Kod XAML zaprezentowany powyżej zostanie wyświetlony jako:
A
B
C
DTwoja odpowiedź
Poprawna odpowiedź. Wybrałeś dokładnie taką odpowiedź, jaką powinien wskazać każdy, kto dobrze rozumie XAML i układ StackLayout. Zobacz, co tu się dzieje: dwa pola Entry wyświetlają się jedno pod drugim, co daje klasyczną strukturę formularza – najpierw pole "Imię", potem "Nazwisko". Dalej mamy StackLayout z orientacją poziomą (Horizontal), więc etykieta "Zgoda RODO" oraz przełącznik Switch pojawiają się obok siebie – to bardzo typowy sposób na prezentację zgody na coś w aplikacjach, bo nie ma sensu rozdzielać tego na dwie linie. Po nich pojawia się Slider z ustawionym Value na 0.5 i kolorami MinimumTrackColor oraz MaximumTrackColor, czyli dokładnie tak jak widać na obrazku – jeden kolor po lewej, drugi po prawej i kółko pośrodku. Na końcu jest Button "Zapisz". Moim zdaniem, taki układ to wręcz klasyka budowy prostych formularzy w aplikacjach mobilnych opartych na XAML. Swoją drogą, to świetny przykład, jak StackLayout pozwala na szybkie i czytelne układanie elementów na ekranie, bez zbędnego komplikowania interfejsu. W praktyce warto jeszcze pamiętać, że oddzielenie pól Entry podnosi czytelność, a stosowanie układów poziomych sprawdza się wtedy, gdy chcesz, żeby użytkownik od razu widział etykietę i jej kontrolkę. Widać tu też dbałość o kolory i spójność wizualną. Według mnie, warto od razu testować takie formularze na różnych urządzeniach, bo StackLayout zachowuje się przewidywalnie, ale warto mieć na uwadze responsywność – no i nie zapomnij, że Slider i Switch mają swoje domyślne wartości, które można łatwo sterować z kodu.
Pytanie 5
Narzędzie przeznaczone do rozwijania aplikacji w systemie WPf (ang. Windows Presentation Foundation) to
A. Visual StudioTwoja odpowiedź
B. NetBeans
C. PyCharm
D. XamarinStudio
Poprawna odpowiedź. Visual Studio to narzędzie, które według mnie jest praktycznie niezbędne do profesjonalnej pracy z WPF (Windows Presentation Foundation). WPF to technologia Microsoftu do budowania nowoczesnych, graficznych interfejsów użytkownika na platformie Windows. Visual Studio posiada wbudowane wsparcie dla projektów WPF – od kreatora nowych aplikacji, przez podpowiedzi składni XAML, aż po graficzny edytor interfejsów, tzw. designer. Na co dzień, gdy projektuję UI w WPF, doceniam funkcje takie jak live preview, debugger XAML czy możliwość natychmiastowego podglądu zmian. Z Visual Studio korzystają praktycznie wszyscy programiści .NET na świecie, bo daje ono dostęp nie tylko do edycji kodu, ale też do narzędzi takich jak NuGet, integracja z systemami kontroli wersji (np. Git), testowanie jednostkowe czy automatyczne refaktoryzacje. Warto wiedzieć, że Microsoft stale rozwija Visual Studio pod kątem WPF, dbając nie tylko o nowości w językach C# i VB.NET, ale też o wygodę pracy z XAML-em oraz wsparcie dla wzorców projektowych, takich jak MVVM. Z praktycznego punktu widzenia, jeśli chcesz tworzyć prawdziwie profesjonalne aplikacje WPF, to Visual Studio jest – moim zdaniem – bezkonkurencyjne. Często nawet początkujący szybko zauważają, jak bardzo przyspiesza ono codzienną pracę i rozwiązywanie problemów typowych dla tej technologii.
Pytanie 6
Na podstawie zamieszczonego fragmentu kodu można stwierdzić, że element o nazwie rysunek jest
MojaKlasaobj1= newMojaKlasa();obj1.rysunek();
A. konstruktoremTwoja odpowiedź
B. polem w klasie
C. metodą w klasiePoprawna odpowiedź
D. obiektem
Niepoprawna odpowiedź. Wielu początkujących programistów myli pojęcia takie jak pole, metoda, konstruktor czy obiekt – to całkiem powszechny błąd. Spójrzmy na ten fragment kodu: obj1.rysunek(). Najczęstsza pomyłka to uznanie rysunek za pole lub obiekt, bo wszystko wydaje się „należeć” do obj1. Jednak w językach takich jak Java czy C#, wywołanie z nawiasami okrągłymi oznacza jednoznacznie wywołanie metody, a nie dostęp do pola. Pola to najczęściej dane, które nie wymagają nawiasów do odczytu czy zapisu – np. obj1.wysokosc. Konstruktor to zupełnie inna sprawa: służy do inicjowania nowej instancji klasy, wywoływany jest tylko raz przy tworzeniu obiektu (czyli MojaKlasa obj1 = new MojaKlasa();), a nie przez notację kropkową na obiekcie. Kolejnym typowym problemem jest utożsamianie metody z obiektem, bo skoro działa na obiekcie, to może też nim być – ale to nie tak. Obiektem jest obj1, czyli konkretna instancja MojaKlasa, natomiast rysunek jest „czynnością”, którą ten obiekt może wykonać. To bardzo ważne rozróżnienie, bo mylenie tych pojęć prowadzi do chaotycznego kodu i trudności z utrzymaniem projektu. W nowoczesnych językach OOP przyjęło się, by metody nazywać czasownikami („narysuj”, „oblicz”), a pola rzeczownikami („kolor”, „wysokosc”). Takie podejście sprawia, że kod jest bardziej czytelny i łatwiej go rozwijać w zespole. Dlatego praktycy zawsze zwracają uwagę na właściwe rozróżnianie tych elementów, bo to podstawa dobrej architektury kodu.
Pytanie 7
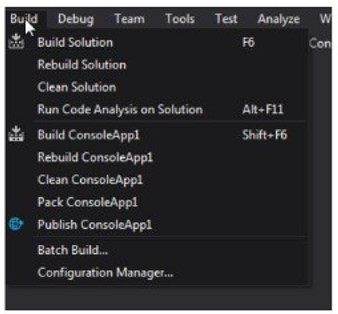
W środowisku do tworzenia aplikacji, gdzie przedstawiono menu, aby usunąć wszystkie pliki tymczasowe oraz wyniki projektu, należy wybrać opcję
A. Run Code Analysis on SolutionTwoja odpowiedź
B. Batch Build
C. Build Solution
D. Clean SolutionPoprawna odpowiedź
Niepoprawna odpowiedź. Tematyka usuwania plików tymczasowych i wyników kompilacji to jedno z podstawowych zagadnień w pracy z narzędziami typu Visual Studio. Często można się pogubić, która opcja menu służy do czego, zwłaszcza gdy brzmią podobnie i są w jednym miejscu. „Run Code Analysis on Solution” nie ma nic wspólnego z usuwaniem plików – to narzędzie sprawdzające jakość i poprawność kodu, szukające potencjalnych błędów, naruszeń konwencji lub miejsc wymagających refaktoryzacji. Bardzo przydatne, ale do porządkowania środowiska builda zupełnie niepotrzebne. Z kolei „Batch Build” pozwala uruchomić wiele buildów równocześnie (np. w różnych konfiguracjach), ale nie rusza żadnych plików tymczasowych ani starego outputu. To po prostu sposób na seryjne kompilowanie kilku wariantów projektu, co jest wygodne przy większych rozwiązaniach, lecz nie rozwiązuje problemu zalegających plików. „Build Solution” natomiast wykonuje standardową kompilację – czyli próbuje zaktualizować wynikową wersję plików na podstawie aktualnego kodu, nie przejmując się specjalnie tym, co pozostało po poprzednich buildach. Właśnie dlatego, gdy występują niejasne błędy lub zmieniają się zależności, samo Build Solution często nie wystarczy, bo stare pliki mogą przeszkadzać. Typowym błędem jest założenie, że każdy build „czyści” środowisko – a tak nie jest. Z perspektywy praktyka, to właśnie opcja Clean Solution gwarantuje, że wszystko zaczynamy od zera, a efekt końcowy będzie zgodny z aktualnym stanem kodu i konfiguracji. Błędne wybory często wynikają z automatycznego utożsamiania słowa „build” z całym procesem zarządzania plikami, a przecież w realnych narzędziach to są osobne mechanizmy. Warto to zapamiętać – Clean Solution to Twój najlepszy przyjaciel, gdy chcesz mieć czysto i bez niespodzianek.
Pytanie 8
Zestaw operatorów przedstawiony poniżej należy do kategorii operatorów:
* / ++ -- %
A. arytmetycznychTwoja odpowiedź
B. przypisania
C. logicznymi
D. porównawczymi
Poprawna odpowiedź. Operatorzy tacy jak *, /, ++, -- czy % należą do grupy operatorów arytmetycznych, ponieważ służą bezpośrednio do wykonywania operacji matematycznych na liczbach. To właśnie dzięki nim programista może realizować podstawowe działania, takie jak mnożenie, dzielenie, inkrementacja, dekrementacja oraz obliczanie reszty z dzielenia. W praktyce codziennej, np. przy obliczeniach faktur, przetwarzaniu danych liczbowych czy algorytmach związanych z obliczaniem średnich, te operatory są wręcz niezastąpione. Moim zdaniem bez solidnego zrozumienia operatorów arytmetycznych trudno ruszyć dalej w programowaniu, bo pojawiają się niemal we wszystkich zadaniach, od najprostszych po najbardziej zaawansowane. Warto też pamiętać, że zgodnie ze standardami języków takich jak C++, Java czy Python, te operatory mają swoje określone priorytety i kolejność wykonywania, którą trzeba znać, żeby uniknąć błędów logicznych. Przykładowo, operator ++ jest często wykorzystywany w pętlach do zwiększania wartości liczników, a % pozwala sprawdzić parzystość liczby. Osobiście uważam, że nawet jeśli na początku wydają się proste, to ich niuanse, np. różnice między ++i a i++, potrafią zaskoczyć, szczególnie w bardziej złożonych wyrażeniach.
Pytanie 9
Która funkcja z biblioteki jQuery w JavaScript służy do naprzemiennego dodawania oraz usuwania klasy z elementu?
A. .toggleClass()Poprawna odpowiedź
B. .switchClass()
C. .changeClass()Twoja odpowiedź
D. .bingClass()
Niepoprawna odpowiedź. Wybór innej funkcji niż .toggleClass() może wynikać z mylnego założenia, że mechanizm zmiany klas w jQuery działa intuicyjnie jak w czystym JavaScripcie, albo z braku doświadczenia z dokumentacją jQuery. Przykładowo, .switchClass() faktycznie istnieje w bibliotece jQuery UI (a nie w podstawowej wersji jQuery), lecz jej zadaniem jest płynne przejście z jednej klasy do drugiej, często z animacją. Nie obsługuje ona jednak naprzemiennego dodawania i usuwania pojedynczej klasy. .changeClass() oraz .bingClass() to natomiast funkcje wymyślone — w oficjalnej dokumentacji jQuery nie występują i ich użycie zakończyłoby się błędem w konsoli przeglądarki. Zdarza się, że osoby początkujące szukają metody z nazwą „change”, bo wydaje się to logiczne w języku angielskim, jednak w jQuery składnia i konwencje opierają się na słowach typu add, remove, a w tym przypadku toggle. Typowym błędem jest też mieszanie funkcjonalności jQuery z czystym JavaScriptem, gdzie operacje na klasach odbywają się przez classList.toggle(), co może wprowadzać w błąd podczas nauki. Dobra praktyka w branży polega na wykorzystywaniu wyłącznie udokumentowanych metod i czytaniu oficjalnych materiałów — w ten sposób łatwiej uniknąć nieporozumień i zyskać pewność, że kod będzie działał poprawnie we wszystkich przeglądarkach wspieranych przez jQuery. Moim zdaniem najwięcej zamieszania wprowadza podobieństwo nazw metod oraz chęć uproszczenia kodu, co czasami prowadzi do nieświadomego wybierania nieistniejących funkcji. Warto więc regularnie zaglądać do dokumentacji, bo nawet jeśli coś wydaje się logiczne, to nie zawsze jest zaimplementowane w bibliotece.
Pytanie 10
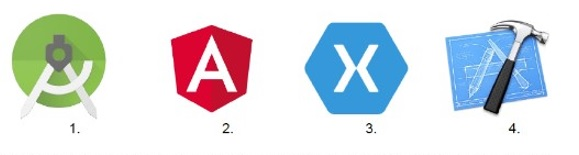
Które z podanych logo reprezentuje narzędzie, które nie jest używane do tworzenia aplikacji mobilnych?
A. 4
B. 1
C. 3
D. 2Twoja odpowiedź
Poprawna odpowiedź. Logo numer 2 przedstawia Angular, czyli framework front-endowy używany głównie do tworzenia aplikacji webowych typu SPA, a nie samodzielne narzędzie do tworzenia aplikacji mobilnych. To jest ważne rozróżnienie, bo Angular może pojawić się w projektach mobilnych, ale zwykle jako część większego stosu technologicznego, np. razem z Ionic, Capacitor albo dawniej Cordova. Sam Angular nie daje pełnego środowiska do budowania, podpisywania, uruchamiania na emulatorze i publikowania aplikacji w Google Play czy App Store. Dla porównania Android Studio jest typowym IDE do aplikacji Android, Xamarin pozwala tworzyć aplikacje mobilne wieloplatformowe w ekosystemie .NET, a Xcode służy do aplikacji na iOS i inne platformy Apple. Moim zdaniem to pytanie dobrze sprawdza praktyczne myślenie: nie wystarczy znać logo, trzeba wiedzieć, czy dane narzędzie jest frameworkiem UI, IDE, SDK czy platformą buildowania. W dobrej praktyce branżowej dobiera się narzędzia pod docelowy system, wymagania wydajnościowe, integracje natywne oraz proces wdrożenia.
Pytanie 11
Podaj wspólną cechę wszystkich kontrolek umieszczonych w ramce
Poprawna odpowiedź. W tym przypadku wskazałeś/aś, że wszystkie kontrolki mają tło w tym samym kolorze, i to jest faktycznie prawidłowa odpowiedź. Gdy spojrzymy na definicje: Label ma BackgroundColor="Blue", Stepper także BackgroundColor="Blue", Entry również BackgroundColor="Blue", a Slider—no właśnie—też BackgroundColor="Blue". To pokazuje, że niezależnie od typu kontrolki, wszystkie mają ustawione tło na dokładnie ten sam kolor. W praktyce bardzo często spotyka się wymóg zachowania spójności wizualnej interfejsu, szczególnie w aplikacjach profesjonalnych czy korporacyjnych. Ustalanie wspólnego BackgroundColor jest jednym z najprostszych kroków ku temu, by UI wyglądało porządnie i było czytelne dla użytkownika końcowego. Moim zdaniem, kiedy projektuje się cały ekran lub jakąś sekcję UI, warto od razu narzucić style lub korzystać z szablonów (np. Styles w XAML czy resourcach), żeby uniknąć przypadkowych rozbieżności kolorystycznych, które potem tylko irytują i programistów, i użytkowników. W branży jest to uznawane za dobrą praktykę – jednolity background ułatwia szybkie ogarnięcie, które elementy należą do jednej grupy funkcjonalnej. Poza tym, kolor tła bywa często wykorzystywany do komunikowania stanu albo priorytetu (np. alerty na czerwono itp.), więc to naprawdę ważne, żeby takie detale były przemyślane i konsekwentnie stosowane. No i jeszcze taka ciekawostka: nie wszystkie kontrolki domyślnie wyświetlają tło, więc czasem trzeba to jawnie ustawić, żeby efekt był taki sam na każdej platformie.
Pytanie 12Strzał
Zademonstrowana pętla wykorzystuje obiekt random do:
A. wielokrotnego generowania liczby, aby stworzyć ciąg z liczb pseudolosowychTwoja odpowiedź
B. uzupełniania tablicy danymi w postaci liczb pseudolosowych
C. jednorazowego wylosowania znaku z określonego zestawu znaków
D. stworzenia losowego napisu o długości 8 znaków składającego się z literPoprawna odpowiedź
Niepoprawna odpowiedź. W tym kodzie łatwo pomylić samo losowanie liczby z końcowym celem programu. Obiekt random faktycznie generuje liczby pseudolosowe, ale te liczby nie są zapisywane jako wynikowy ciąg. One pełnią rolę indeksów, czyli wskazują, który znak pobrać ze zmiennej pulaZnakow. Dlatego końcowym rezultatem nie jest ciąg liczb pseudolosowych, tylko napis złożony z liter. To ważna różnica, bo w programowaniu często losuje się nie wartość końcową, tylko pozycję elementu w kolekcji, tablicy albo napisie. Nie ma tu także uzupełniania tablicy danymi. Zmienna pulaZnakow jest napisem, a dostęp przez nawiasy kwadratowe pobiera znak z konkretnej pozycji. Kod nie tworzy nowej tablicy i nie wpisuje do niej żadnych liczb. Typowy błąd myślowy polega na tym, że widząc indeksowanie, ktoś od razu zakłada pracę na tablicy, a string w C# również można indeksować podobnie jak tablicę znaków. Nie chodzi też o jednorazowe wylosowanie znaku. Pętla for wykonuje się od i = 0 do i < 8, czyli dokładnie 8 iteracji. W każdej iteracji pobierany jest jeden losowy znak i dopisywany do zmiennej wynik. Dopiero suma tych operacji daje sens programu: wygenerowanie ośmioznakowego losowego napisu. Moim zdaniem przy analizowaniu takich fragmentów najlepiej zawsze sprawdzić, co dzieje się w jednej iteracji pętli, a potem pomnożyć to przez liczbę powtórzeń. Wtedy dużo trudniej zgubić główną intencję algorytmu.
Pytanie 13
Wskaż kod, który jest funkcjonalnie równoważny zaprezentowanemu poniżej:
Poprawna odpowiedź. W tym przypadku Kod 2 jest dokładnym odpowiednikiem funkcjonalnym dla przedstawionej instrukcji switch. To, co tu widać, to klasyczna zamiana konstrukcji switch-case na strukturę if-else if-else, co jest bardzo częstą praktyką w programowaniu, szczególnie w językach, które nie zawsze posiadają rozbudowaną wersję switch. Kod 2 najpierw sprawdza, czy nrTel to 999, jeśli tak – przypisuje "Pogotowie" i nie sprawdza dalszych warunków. Jeśli nie, przechodzi do kolejnego warunku, czyli nrTel == 998, potem 997, w końcu domyślnie daje "Inny numer". Dokładnie tak samo to działało w switchu – tylko jeden warunek się wykonuje i reszta jest ignorowana, co ma znaczenie np. gdybyśmy później rozbudowywali logikę. Takie podejście jest czytelne, uniwersalne i zgodne z dobrymi praktykami kodowania – łatwo to refaktoryzować, debugować i utrzymywać. W wielu firmowych projektach spotkałem się z preferencją dla if-else zamiast switcha, jeśli liczba przypadków nie jest ogromna, bo łatwiej potem dołożyć dodatkowe warunki (np. złożone, nie tylko proste porównanie wartości). Fajnie też wiedzieć, że takie zamiany to podstawa przy migracji kodu między różnymi językami – nie każdy język ma identycznie działający switch. Moim zdaniem, umiejętność takiego przełożenia to dobra baza do nauki algorytmiki i lepszego rozumienia logiki sterowania przepływem kodu.
Pytanie 14
Jakie jest oznaczenie komentarza wieloliniowego w języku Java?
A.
/* ... */
Twoja odpowiedź
B.
<!-- ... -->
C.
// ... //
D.
""" ... """
Poprawna odpowiedź. Komentarze wieloliniowe w języku Java zapisuje się właśnie w taki sposób: /* ... */. Taki zapis pozwala na umieszczenie kilku linii tekstu między znakami otwierającym /* i zamykającym */, które kompilator całkowicie ignoruje podczas tłumaczenia kodu. Z mojego doświadczenia to jest najwygodniejsza forma, kiedy trzeba wyłączyć większy fragment kodu – np. część algorytmu, której chwilowo nie chcemy wykonywać lub większy blok dokumentacji. Bardzo często używa się komentarzy wieloliniowych przy pisaniu tzw. docstringów, choć w Javie do dokumentacji API lepiej stosować komentarze JavaDoc z podwójnym ukośnikiem i gwiazdką (/** ... */), ale zwykłe /* ... */ są super uniwersalne – czy to na zajęciach, czy w dużych projektach zespołowych. Moim zdaniem, jeśli uczysz się Javy, warto pamiętać, żeby nie mieszać komentarzy wieloliniowych z jednoliniowymi (// ...), bo to czasem prowadzi do zamieszania, szczególnie przy większych refaktoryzacjach. Co ciekawe, takie same komentarze znajdziesz też w C czy C++, więc jak ktoś zna te języki, to szybko się odnajdzie. W sumie to prosta sprawa, ale zdziwiłbyś się ile osób próbuje stosować inne formaty, które działają w zupełnie innych technologiach. No i jeszcze taka drobna uwaga z praktyki: nigdy nie wstawiaj komentarza wieloliniowego wewnątrz innego; Java tego nie obsługuje i kompilator się pogubi.
Pytanie 15
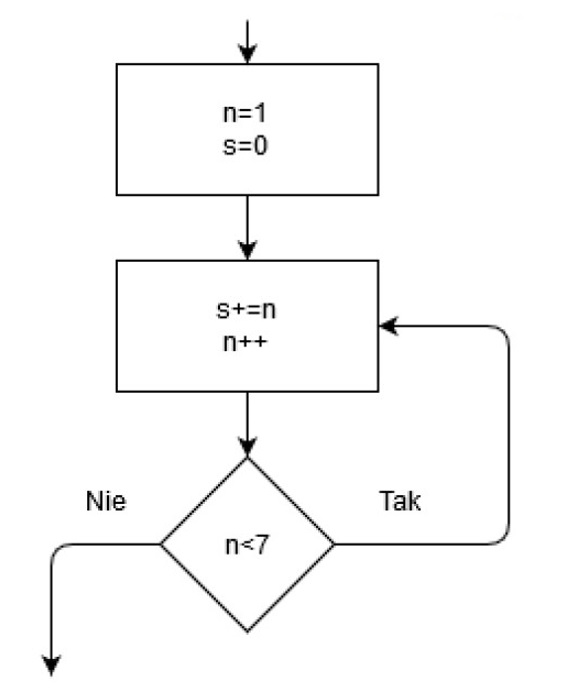
Na ilustracji pokazany jest fragment diagramu blokowego pewnego algorytmu. Ile razy warunek n<7 będzie badany?
A. 8
B. 5
C. 7
D. 6Twoja odpowiedź
Poprawna odpowiedź. Odpowiedź 4 jest prawidłowa ponieważ algorytm rozpoczyna od n równego 1 i zwiększa tę wartość o jeden w każdej iteracji aż do momentu gdy n stanie się równe 7 Wtedy warunek n mniejsze od 7 przestaje być spełniony co oznacza że warunek ten jest sprawdzany łącznie 6 razy tj dla n równych 1 2 3 4 5 i 6 Jest to typowa pętla kontrolna często spotykana w programowaniu gdzie warunek pętli decyduje o jej zakończeniu W praktyce takie podejście pozwala na efektywne zarządzanie liczbą iteracji i zapewnia klarowność kodu Co więcej użycie pętli z warunkiem końcowym jest zgodne z dobrymi praktykami projektowania algorytmów gdyż minimalizuje ryzyko błędów logicznych poprzez jawne określenie końca pętli Ponadto zrozumienie mechanizmu działania pętli i jej warunków jest kluczowe dla optymalizacji algorytmów i efektywnego zarządzania zasobami co ma bezpośrednie przełożenie na wydajność aplikacji szczególnie w środowiskach wymagających dużej mocy obliczeniowej
Pytanie 16
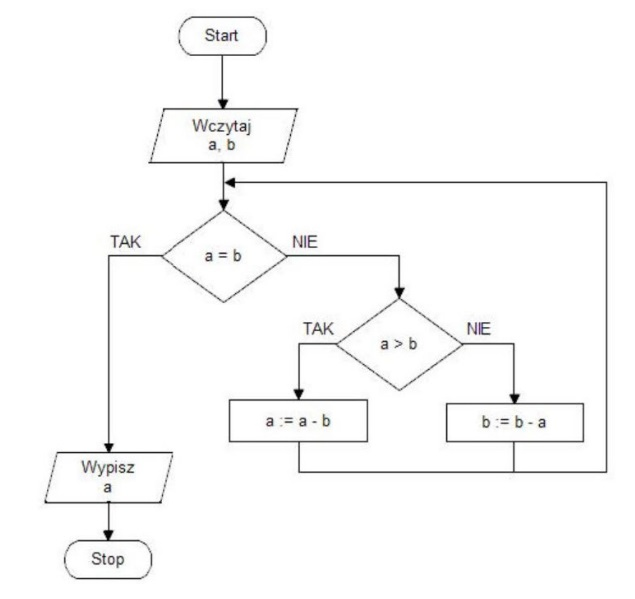
Algorytmu Euklidesa, przedstawionego na schemacie, należy użyć do obliczenia.
A. największego elementu w zbiorze liczbTwoja odpowiedź
B. najmniejszej liczby pierwszej w danym zakresie
C. Najmniejszej Wspólnej Wielokrotności
D. Największego Wspólnego DzielnikaPoprawna odpowiedź
Niepoprawna odpowiedź. Największy element zbioru liczb to zagadnienie, które nie ma związku z algorytmem Euklidesa. Wymaga to raczej prostego przeszukania zbioru, niż stosowania algorytmu opierającego się na operacjach arytmetycznych na dwóch liczbach. Z kolei najmniejsza liczba pierwsza w przedziale wymaga zastosowania zupełnie innych technik, jak na przykład sita Eratostenesa, które pozwala na znalezienie wszystkich liczb pierwszych mniejszych od określonej wartości. Algorytm Euklidesa nie jest w tym przypadku użyteczny, gdyż nie zajmuje się on pojęciem liczby pierwszej. Najmniejsza Wspólna Wielokrotność (NWW) to zagadnienie, które choć związane z NWD, wymaga innego podejścia. NWW można obliczyć mając już wyznaczony NWD dwóch liczb, korzystając ze wzoru NWW(a, b) = (a * b) / NWD(a, b). Dlatego algorytm Euklidesa może być pomocnym narzędziem w obliczaniu NWW, ale sam w sobie nie jest przeznaczony do bezpośredniego jej wyznaczania. Typowym błędem jest myślenie, że algorytmy matematyczne mają bardziej uniwersalne zastosowanie niż w rzeczywistości, co prowadzi do niewłaściwego użycia takich narzędzi. Algorytm Euklidesa jest wysoce wyspecjalizowany, dlatego warto zrozumieć jego ograniczenia i specyficzne zastosowania w kontekście matematyki i inżynierii komputerowej.
Pytanie 17
W jaki sposób procesor nawiązuje komunikację z pamięcią podręczną (cache)?
A. Poprzez linie danych w magistrali systemowejTwoja odpowiedź
B. Za pomocą systemu przerwań
C. Używając wyłącznie pamięci RAM
D. Bezpośrednio, omijając mostki systemowe
Poprawna odpowiedź. Procesor komunikuje się z pamięcią podręczną (cache) za pomocą linii danych w magistrali systemowej, co jest kluczowym elementem architektury komputerowej. Magistrala systemowa to zestaw ścieżek, które umożliwiają przesyłanie danych pomiędzy różnymi komponentami systemu, w tym procesorem, pamięcią RAM oraz pamięcią podręczną. Pamięć podręczna działa jako bufor, który przechowuje najczęściej używane dane, co pozwala na znaczne zwiększenie szybkości operacji, ponieważ dostęp do pamięci cache jest znacznie szybszy niż dostęp do pamięci RAM. W standardach takich jak Intel's QuickPath Interconnect (QPI) czy AMD's HyperTransport, linie danych odgrywają kluczową rolę w efektywnej komunikacji, co przekłada się na ogólną wydajność systemu. Przykładowo, w nowoczesnych procesorach wielordzeniowych, każda rdzeń może mieć własną pamięć podręczną, a komunikacja za pomocą magistrali pozwala na synchronizację danych pomiędzy tymi rdzeniami oraz współdzielenie zasobów. Efektywne zarządzanie pamięcią podręczną i magistralą jest kluczowe dla osiągnięcia wysokiej wydajności w obliczeniach oraz przetwarzaniu danych.
Pytanie 18
Które z wymienionych sformułowań najlepiej definiuje oprogramowanie typu ransomware?
A. Oprogramowanie uniemożliwiające dostęp do danych w celu wymuszenia zapłatyPoprawna odpowiedź
B. Programy zbierające prywatne dane bez zgody użytkownikaTwoja odpowiedź
C. Oprogramowanie stosowane do realizacji ataków DDoS
D. Złośliwe aplikacje wyświetlające reklamy
Niepoprawna odpowiedź. Odpowiedzi wskazujące na inne formy złośliwego oprogramowania, takie jak programy zbierające dane osobowe, oprogramowanie do ataków DDoS oraz złośliwe aplikacje wyświetlające reklamy, są niepoprawne w kontekście definicji ransomware. Programy zbierające dane osobowe działają w celu gromadzenia informacji o użytkownikach, często bez ich zgody, lecz nie mają na celu blokowania dostępu do danych ani wymuszania okupu. Z kolei oprogramowanie stosowane do ataków DDoS (Distributed Denial of Service) ma za zadanie zablokować dostęp do serwisów internetowych poprzez ich przeciążenie, a nie szyfrowanie danych użytkowników. Takie ataki są skierowane na infrastruktury sieciowe lub serwery, co różni się od typowych mechanizmów ransomware, które koncentrują się na lokalnych plikach. Złośliwe aplikacje wyświetlające reklamy, znane jako adware, generują dochody poprzez wyświetlanie niechcianych reklam, co nie ma związku z wymuszaniem okupu ani szyfrowaniem danych. Te rodzaje oprogramowania mają różne cele i metody działania, ale nie są zbliżone do funkcji i skutków ataku ransomware.
Pytanie 19
Jaki rodzaj ataku hakerskiego polega na bombardowaniu serwera ogromną ilością żądań, co prowadzi do jego przeciążenia?
A. Phishing
B. Man-in-the-Middle
C. DDoSTwoja odpowiedź
D. SQL Injection
Poprawna odpowiedź. Atak DDoS (Distributed Denial of Service) polega na zasypywaniu serwera dużą ilością zapytań, co prowadzi do jego przeciążenia i unieruchomienia. W tym rodzaju ataku, hakerzy wykorzystują sieć skompromitowanych komputerów, znanych jako botnety, aby wysłać ogromne ilości nieautoryzowanych żądań do docelowego serwera w krótkim czasie. Celem DDoS jest spowodowanie, że serwer nie jest w stanie odpowiedzieć na prawidłowe zapytania od autentycznych użytkowników, co skutkuje awarią usługi. Przykłady ataków DDoS obejmują SYN Flood, UDP Flood oraz HTTP Flood, gdzie każdy z tych typów wykorzystuje różne protokoły i metody do zablokowania normalnego ruchu. Standardy takie jak RFC 793 definiują protokół TCP, który może być narażony na ataki SYN Flood. Ważne jest, aby organizacje stosowały odpowiednie środki zabezpieczające, takie jak systemy detekcji intruzów (IDS), firewalle, oraz usługi ochrony DDoS, aby minimalizować ryzyko i skutki tych ataków.
Pytanie 20
Który z wymienionych aktów prawnych odnosi się do ochrony danych osobowych w krajach Unii Europejskiej?
A. GDPR (RODO)Poprawna odpowiedź
B. DMCATwoja odpowiedź
C. Creative Commons
D. Open Source Initiative
Niepoprawna odpowiedź. DMCA (Digital Millennium Copyright Act) dotyczy praw autorskich i ochrony własności intelektualnej, a nie danych osobowych. Creative Commons to system licencji umożliwiający twórcom dzielenie się swoimi dziełami, ale nie reguluje ochrony danych osobowych. Open Source Initiative promuje otwarte oprogramowanie i licencje, ale nie zajmuje się ochroną prywatności i danych użytkowników.
Pytanie 21
Jakie jest podstawowe założenie normalizacji krajowej?
A. Utrudnienie handlu międzynarodowego
B. Ujednolicenie wymagań technicznych i poprawa bezpieczeństwaTwoja odpowiedź
C. Zwiększenie ilości regulacji prawnych
D. Wzrost kosztów produkcji
Poprawna odpowiedź. Ujednolicenie wymagań technicznych i poprawa bezpieczeństwa to główne cele normalizacji krajowej. Normalizacja polega na opracowywaniu standardów, które są stosowane w różnych branżach w celu zapewnienia jakości, bezpieczeństwa i kompatybilności produktów oraz usług. Dzięki normalizacji producenci tworzą wyroby zgodne z określonymi normami, co zwiększa ich konkurencyjność na rynku krajowym i międzynarodowym. Wdrożenie jednolitych standardów wpływa także na bezpieczeństwo użytkowników, minimalizując ryzyko awarii lub niezgodności produktów.
Pytanie 22
Jaką kategorię reprezentuje typ danych "array"?
A. Typ danych prosty
B. Typ danych złożonyTwoja odpowiedź
C. Typ wskaźników
D. Typ logiczny
Poprawna odpowiedź. Tablica ('array') jest przykładem złożonego typu danych, który pozwala na przechowywanie wielu wartości tego samego typu pod wspólną nazwą. Każdy element tablicy jest dostępny za pomocą indeksu, co umożliwia szybkie i efektywne operacje na dużych zbiorach danych. Tablice są szeroko wykorzystywane w programowaniu do przechowywania list, macierzy i innych struktur, gdzie konieczne jest przechowywanie dużych ilości danych tego samego rodzaju. Dzięki tablicom można zorganizować dane w sposób uporządkowany, co ułatwia ich przetwarzanie, sortowanie i wyszukiwanie.
Pytanie 23
W jakiej sytuacji kolekcja typu lista okaże się bardziej wydajna niż tablica?
A. Gdy liczba elementów w kolekcji jest niezmienna
B. Gdy liczba elementów w kolekcji zmienia się dynamicznieTwoja odpowiedź
C. Gdy chcemy uzyskać dostęp do elementów przy pomocy indeksu
D. Gdy mamy pewność co do dokładnego rozmiaru kolekcji przed kompilacją
Poprawna odpowiedź. Lista to dynamiczna struktura danych, która pozwala na efektywne dodawanie i usuwanie elementów, zwłaszcza gdy liczba elementów zmienia się w trakcie działania programu. Listy są bardziej elastyczne niż tablice, ponieważ mogą dynamicznie dostosowywać swoją wielkość bez potrzeby alokacji dodatkowej pamięci. W przypadku dynamicznych operacji, takich jak częste wstawianie i usuwanie elementów, listy są znacznie bardziej wydajne niż tablice, które wymagają przesunięcia wszystkich elementów po każdej operacji. Listy świetnie sprawdzają się w implementacji kolejek, stosów oraz w strukturach, które muszą rosnąć i kurczyć się podczas działania aplikacji.
Pytanie 24
Który z wymienionych algorytmów jest algorytmem opartym na iteracji?
A. QuickSort
B. BubbleSortPoprawna odpowiedź
C. Fibonacci (rekurencyjnie)Twoja odpowiedź
D. DFS (przeszukiwanie w głąb)
Niepoprawna odpowiedź. QuickSort to algorytm rekurencyjny wykorzystujący podejście 'dziel i zwyciężaj' i działa znacznie szybciej niż Bubble Sort. Rekurencyjna wersja algorytmu obliczania Fibonacciego jest klasycznym przykładem rekurencji, a nie iteracji. DFS (Depth First Search) to algorytm przeszukiwania grafów, który może być zarówno rekurencyjny, jak i iteracyjny, ale nie jest algorytmem sortowania, co odróżnia go od Bubble Sort.
Pytanie 25
Jakie jest przeznaczenie polecenia "git merge"?
A. Do pobierania aktualizacji zdalnego repozytorium
B. Do łączenia zmian z różnych gałęziPoprawna odpowiedź
C. Do zakładania nowego repozytoriumTwoja odpowiedź
D. Do usuwania zmian w repozytorium
Niepoprawna odpowiedź. Wiele osób na początku nauki Gita myli różne polecenia, bo brzmią podobnie albo wydają się robić coś bliskiego. "git merge" często bywa mylone z poleceniami typu "git pull" czy "git clone", które mają jednak zupełnie inne zastosowanie. Pobieranie aktualizacji ze zdalnego repozytorium to domena "git pull" – to polecenie automatycznie pobiera nowe commity i próbuje je od razu zintegrować z lokalną gałęzią, często zresztą używając w tle właśnie "merge". Ale samo "git merge" nie ściąga niczego z internetu, ono tylko łączy zmiany już obecne w lokalnych gałęziach. Z kolei tworzenie nowego repozytorium to zadanie "git init"; to zupełnie inny etap pracy, bo dotyczy rozpoczęcia projektu, a nie zarządzania jego rozwojem. Usuwanie zmian w repozytorium – tutaj najczęściej używa się "git reset" czy "git revert", zależnie od tego czy chcemy cofnąć zmiany lokalnie czy naprawić coś w historii. Merge natomiast nie służy do usuwania ani cofania, tylko do scalania zmian – to kluczowe, żeby nie pomylić tych narzędzi, bo można przez to nieźle namieszać w kodzie. Moim zdaniem, głównym błędem jest założenie, że wszystkie polecenia związane z aktualizacją kodu robią to samo, podczas gdy w Git każde z nich ma bardzo konkretne zadanie i konsekwencje. Dla dobrych praktyk w zespole ważne jest, żeby rozumieć subtelne różnice między tymi operacjami. Praktyka pokazuje, że błędne użycie "merge" – jak również zamiana go z "pull" albo "reset" – potrafi prowadzić do chaosu w historii projektu. Warto zatem dobrze opanować przeznaczenie każdego z poleceń przed rozpoczęciem pracy nad większym projektem.
Pytanie 26
Jakie rozwiązanie jest najbardziej odpowiednie przy projektowaniu aplikacji, która ma funkcjonować na różnych systemach operacyjnych?
A. Opracowanie dedykowanego kodu dla każdej platformy
B. Wykorzystanie technik responsywnego projektowania interfejsuTwoja odpowiedź
C. Pełne dopasowanie aplikacji do systemu Windows
D. Koncentrowanie się wyłącznie na estetyce aplikacji
Poprawna odpowiedź. Wykorzystanie technik responsywnego projektowania interfejsu to obecnie jedno z najskuteczniejszych rozwiązań, jeśli chodzi o tworzenie aplikacji działających na różnych systemach operacyjnych. Moim zdaniem, to podejście daje największą elastyczność i wygodę zarówno dla użytkownika, jak i dla samego zespołu developerskiego. Responsywność nie sprowadza się tylko do zmiany rozmiaru okna, ale także do automatycznego dostosowania elementów interfejsu do różnych rozdzielczości, DPI czy nawet gestów obsługiwanych przez konkretne urządzenia. Dzięki temu aplikacja może wyglądać i działać spójnie niezależnie od tego, czy uruchamiana jest na Windowsie, MacOS, Linuksie czy nawet na mobilnych systemach operacyjnych. W praktyce często korzysta się z frameworków takich jak Flutter, React Native albo Electron, które już "z pudełka" oferują narzędzia do tworzenia responsywnych, wieloplatformowych aplikacji. Branżowe standardy, szczególnie te, które dotyczą UX/UI (na przykład wytyczne Material Design czy Human Interface Guidelines od Apple), mocno podkreślają wagę responsywności i uniwersalności rozwiązań. Co ciekawe, dobrze zaprojektowana responsywna aplikacja jest też łatwiejsza w utrzymaniu i rozwoju, bo zamiast kilku osobnych wersji kodu, mamy jedną, dobrze przemyślaną bazę. To oszczędza czas, zasoby i minimalizuje ryzyko powstawania błędów. Sam przećwiczyłem wiele takich przypadków i widać, że inżynieria oprogramowania idzie właśnie w stronę uniwersalnych, "adaptacyjnych" rozwiązań.
Pytanie 27
Jaką rolę odgrywa interpreter w kontekście programowania?
A. Przekłada kod źródłowy na język maszynowy w trakcie działania programuTwoja odpowiedź
B. Generuje plik wykonywalny dla systemu operacyjnego
C. Łączy kod źródłowy z zewnętrznymi bibliotekami
D. Zoptymalizowuje wydajność aplikacji w środowisku produkcyjnym
Poprawna odpowiedź. Interpreter tłumaczy kod źródłowy na język maszynowy instrukcja po instrukcji, co oznacza, że każda linia kodu jest analizowana i wykonywana na bieżąco. Dzięki temu programy interpretowane, takie jak te w Pythonie, Ruby czy JavaScript, mogą być szybko testowane i uruchamiane bez konieczności wcześniejszej kompilacji. Interpretacja pozwala na elastyczność w procesie rozwoju, ponieważ zmiany w kodzie są widoczne natychmiast po zapisaniu pliku. To czyni interpreter idealnym narzędziem do prototypowania i budowania aplikacji w dynamicznych środowiskach.
Pytanie 28
Jakie stwierdzenie najlepiej tłumaczy cel podziału programu na funkcje (metody)?
A. Umożliwia skrócenie kodu przez eliminację wszelkich komentarzy
B. Ułatwia proces debugowania oraz ponowne wykorzystanie fragmentów koduPoprawna odpowiedź
C. Gwarantuje automatyczną kompilację programu
D. Eliminuje potrzebę korzystania ze zmiennych globalnychTwoja odpowiedź
Niepoprawna odpowiedź. Usunięcie komentarzy w kodzie nie ma wpływu na podział programu na funkcje. Komentarze pełnią rolę informacyjną dla programistów i nie wpływają na działanie kodu. Automatyczna kompilacja programu to proces wykonywany przez kompilator i nie ma związku z dzieleniem programu na funkcje – kompilator przetwarza kod niezależnie od tego, czy program jest podzielony na funkcje czy napisany jako jeden blok. Eliminacja zmiennych globalnych to dobra praktyka, ale dzielenie programu na funkcje nie eliminuje automatycznie potrzeby ich stosowania. W rzeczywistości funkcje mogą nadal korzystać ze zmiennych globalnych, jeśli nie zostaną odpowiednio zaprojektowane.
Pytanie 29
Jakie pola powinny być umieszczone w klasie nadrzędnej w strukturze dziedziczenia?
A. Pola, które są charakterystyczne jedynie dla pojedynczej klasy pochodnejTwoja odpowiedź
B. Pola, które są wspólne dla wszystkich klas pochodnychPoprawna odpowiedź
C. Pola, które są tylko prywatne
D. Pola, które są wykorzystywane tylko w funkcjach statycznych
Niepoprawna odpowiedź. Pola specyficzne dla jednej klasy pochodnej nie powinny znajdować się w klasie bazowej, ponieważ zwiększałoby to złożoność i naruszało zasadę separacji odpowiedzialności. Prywatne pola są ukryte i nie są dziedziczone przez klasy pochodne – są dostępne wyłącznie w ramach klasy, w której zostały zdefiniowane. Pola używane wyłącznie w metodach statycznych nie muszą znajdować się w klasie bazowej, ponieważ są to elementy niezależne od instancji klasy i są przypisane do samej klasy, a nie jej obiektów.
Pytanie 30
Który z poniższych błędów wykonania aplikacji można obsłużyć za pomocą wyjątków?
A. Błąd składniowy
B. Błąd dzielenia przez zeroPoprawna odpowiedź
C. Błąd kompilacji
D. Niezgodność typów danych w kodzieTwoja odpowiedź
Niepoprawna odpowiedź. W tym pytaniu łatwo pomylić różne rodzaje błędów, bo wszystkie brzmią jak coś, co psuje program. Różnica jest jednak ważna: wyjątki służą głównie do obsługi problemów pojawiających się w czasie wykonania aplikacji, a nie do naprawiania kodu, który jest niepoprawny jeszcze przed uruchomieniem. Błąd składniowy oznacza, że zapis programu nie spełnia reguł języka, na przykład brakuje nawiasu, średnika albo użyto złej konstrukcji. Taki kod zwykle w ogóle się nie uruchomi, więc nie ma momentu, w którym try-catch mógłby zadziałać. Podobnie błąd kompilacji jest wykrywany przez kompilator lub narzędzia budujące projekt. To sygnał dla programisty, że trzeba poprawić źródła programu, zależności albo konfigurację, a nie obsługiwać sytuację w aplikacji podczas działania. Niezgodność typów danych w kodzie też najczęściej jest problemem statycznym, szczególnie w językach takich jak Java, C# czy C++. Jeśli próbujesz przypisać tekst do zmiennej liczbowej bez konwersji, kompilator powie stop. W językach dynamicznych część problemów z typami może wyjść dopiero podczas działania, ale w kontekście tej odpowiedzi chodzi o błąd zapisany w kodzie, a nie o typową sytuację obsługiwaną wyjątkiem biznesowo. Typowy błąd myślowy polega na wrzucaniu wszystkich awarii do jednego worka. W praktyce warto rozróżniać błędy składni i kompilacji, które poprawiamy przed wdrożeniem, od błędów wykonania, które możemy przewidywać, testować, logować i obsługiwać mechanizmem wyjątków.
Pytanie 31
Co to jest choroba związana z wykonywaniem zawodu?
A. Każda choroba, która występuje w czasie pracyTwoja odpowiedź
B. Choroba wynikająca z warunków pracy lub związanych z nimi czynnikówPoprawna odpowiedź
C. Stan zdrowia, który uniemożliwia pracę przez okres krótszy niż tydzień
D. Choroba występująca tylko w sektorze przemysłowym
Niepoprawna odpowiedź. Choroba, która pojawia się w trakcie zatrudnienia, ale nie jest związana z warunkami pracy, nie jest klasyfikowana jako choroba zawodowa. Może to być zwykłe przeziębienie lub inna przypadłość niezwiązana z charakterem wykonywanej pracy. Stan zdrowia, który uniemożliwia pracę przez krótki czas (np. tydzień), może być traktowany jako tymczasowa niezdolność do pracy, ale nie spełnia definicji choroby zawodowej. Choroby zawodowe występują nie tylko w sektorze przemysłowym – mogą pojawiać się również w pracy biurowej (np. problemy z kręgosłupem lub wzrokiem).
Pytanie 32
Jakie działania można podjąć, aby uniknąć pogorszenia wzroku podczas korzystania z komputera?
A. Używać filtrów przeciwodblaskowych na ekranieTwoja odpowiedź
B. Korzytać ze słuchawek tłumiących dźwięki
C. Zachować stałą temperaturę w biurze
D. Stosować ergonomiczne podkładki pod ręce
Poprawna odpowiedź. Stosowanie filtrów przeciwodblaskowych na monitorze to skuteczny sposób na zapobieganie pogorszeniu wzroku podczas pracy przy komputerze. Filtry te redukują odbicia światła, zmniejszając zmęczenie oczu i poprawiając komfort pracy. Długotrwała praca przy komputerze bez odpowiedniej ochrony może prowadzić do zespołu suchego oka, bólu głowy i problemów z widzeniem. Filtry przeciwodblaskowe to prosty, ale bardzo efektywny sposób na poprawę ergonomii stanowiska pracy. W połączeniu z odpowiednim ustawieniem monitora, regularnymi przerwami oraz ćwiczeniami wzrokowymi, pomagają one w utrzymaniu zdrowia oczu.
Pytanie 33
Który z objawów może sugerować zawał serca?
A. Intensywny ból w klatce piersiowej promieniujący do lewej rękiTwoja odpowiedź
B. Ból brzucha po spożyciu posiłku
C. Gorączka oraz dreszcze
D. Spadek nastroju
Poprawna odpowiedź. Silny ból w klatce piersiowej promieniujący do lewej ręki to klasyczny objaw zawału serca (ostrego zespołu wieńcowego). Ból ten często pojawia się nagle, jest intensywny, gniotący lub piekący i może towarzyszyć mu duszność, zawroty głowy, zimne poty i nudności. Zawał serca wynika z zablokowania jednej z tętnic wieńcowych, co prowadzi do niedokrwienia mięśnia sercowego. Szybka reakcja i wezwanie pomocy medycznej mogą uratować życie i zminimalizować uszkodzenia serca. Każda minuta jest kluczowa – nie należy czekać na ustąpienie objawów, lecz natychmiast zadzwonić na numer alarmowy 112 lub udać się do najbliższego szpitala.
Pytanie 34
Która z wymienionych bibliotek pozwala na obsługę zdarzeń związanych z myszą w aplikacjach desktopowych?
A. QtPoprawna odpowiedź
B. Numpy
C. Django
D. TensorFlowTwoja odpowiedź
Niepoprawna odpowiedź. Numpy to biblioteka do obliczeń numerycznych w języku Python i nie posiada narzędzi do obsługi zdarzeń graficznych w aplikacjach desktopowych. Django to framework do budowy aplikacji webowych w Pythonie, koncentrujący się na backendzie, a nie na tworzeniu GUI czy interakcji z myszą. TensorFlow to biblioteka do uczenia maszynowego i przetwarzania danych, nieprzystosowana do tworzenia aplikacji desktopowych obsługujących zdarzenia myszki i klawiatury.
Pytanie 35
Jakie środowisko developerskie służy do tworzenia aplikacji na platformę iOS?
A. Studio Androida
B. Visual Studio Code
C. XCodeTwoja odpowiedź
D. Eclipse
Poprawna odpowiedź. XCode to oficjalne środowisko programistyczne (IDE) firmy Apple, które jest wykorzystywane do tworzenia aplikacji na systemy iOS, macOS, watchOS i tvOS. XCode oferuje pełne wsparcie dla języków Swift i Objective-C oraz narzędzia do projektowania interfejsów użytkownika (Storyboard), debugowania aplikacji, testowania wydajności i optymalizacji kodu. XCode posiada także symulatory urządzeń Apple, co umożliwia testowanie aplikacji na różnych modelach iPhone’ów, iPadów oraz Apple Watch. XCode jest niezbędnym narzędziem dla deweloperów tworzących aplikacje na ekosystem Apple i pozwala na łatwą publikację aplikacji w App Store.
Pytanie 36
Jaką technologię stosuje się do powiązania aplikacji internetowej z systemem baz danych?
A. HTTP
B. SQLTwoja odpowiedź
C. CSS
D. JavaScript
Poprawna odpowiedź. SQL, czyli język do zarządzania danymi, to mega ważna rzecz, jeśli chodzi o relacyjne bazy danych. Dzięki niemu można tworzyć, modyfikować, a nawet usuwać tabele. To taki most, który łączy aplikacje webowe z bazą danych. Dzięki SQL programiści mogą łatwo przechowywać i przetwarzać różne informacje na serwerze. Przykłady? Można generować listy produktów, ogarniać użytkowników czy analizować dane z transakcji. Właściwie bez SQL-a nie dałoby się zbudować solidnych aplikacji, na przykład tych, które działają na MySQL, PostgreSQL czy Microsoft SQL Server. Chociaż pewnie o tym wiesz, ale warto to zaznaczyć.
Pytanie 37
Co oznacza walidacja kodu programu?
A. Czynnością związaną z tworzeniem dokumentacji kodu
B. Czynnością weryfikującą poprawność i zgodność kodu z założeniamiPoprawna odpowiedź
C. Czynnością polegającą na kompilowaniu koduTwoja odpowiedź
D. Czynnością dotyczącą publikacji aplikacji w sklepie
Niepoprawna odpowiedź. Tworzenie dokumentacji kodu polega na opisywaniu funkcji, klas i modułów aplikacji, co ułatwia zrozumienie projektu, ale nie jest tożsame z walidacją kodu. Kompilowanie kodu to proces tłumaczenia go na język maszynowy, co umożliwia jego uruchomienie, ale nie wykrywa wszystkich błędów logicznych. Publikowanie aplikacji w sklepie to końcowy etap wdrażania produktu, który nie obejmuje walidacji kodu – ten proces powinien zostać przeprowadzony wcześniej, w trakcie rozwoju aplikacji.
Pytanie 38
Które z poniższych nie jest algorytmem sortowania?
A. Binary SearchTwoja odpowiedź
B. Quick Sort
C. Merge Sort
D. Bubble Sort
Poprawna odpowiedź. Binary Search jest algorytmem, który służy do efektywnego przeszukiwania uporządkowanych zbiorów danych, a nie do sortowania. Działa na zasadzie dzielenia zbioru na pół i eliminowania połowy z nich w każdym kroku, co pozwala na szybkie znalezienie poszukiwanej wartości. Jest to przykład algorytmu o czasie działania O(log n), co sprawia, że jest znacznie szybszy od prostego przeszukiwania liniowego. Przykładowo, gdy mamy posortowaną tablicę liczb, Binary Search może być użyty do znalezienia konkretnej liczby, eliminując w każdym kroku połowę zbioru, aż do odnalezienia wartości lub stwierdzenia, że jej nie ma. W kontekście branżowym, Binary Search jest szeroko stosowany w różnych aplikacjach, gdzie wymagane jest szybkie przeszukiwanie danych, na przykład w bazach danych i aplikacjach wyszukiwania. Kluczowe jest zrozumienie różnicy między algorytmem przeszukiwania a algorytmem sortowania; sortowanie odnosi się do organizacji danych w określonym porządku, podczas gdy Binary Search koncentruje się na znajdowaniu elementów w już posortowanych zbiorach.
Pytanie 39
Które z poniższych NIE jest zasadą programowania SOLID?
A. Code Reuse Principle (Zasada ponownego użycia kodu)Twoja odpowiedź
B. Single Responsibility Principle (Zasada pojedynczej odpowiedzialności)
C. Open/Closed Principle (Zasada otwarte/zamknięte)
D. Dependency Inversion Principle (Zasada odwrócenia zależności)
Poprawna odpowiedź. Odpowiedź "Code Reuse Principle" jest prawidłowa, ponieważ nie stanowi ona jednej z pięciu zasad programowania SOLID. SOLID to akronim, który odnosi się do pięciu podstawowych zasad, które mają na celu ułatwienie tworzenia oprogramowania, które jest łatwe w utrzymaniu i rozwijaniu. W skład tych zasad wchodzą: Zasada pojedynczej odpowiedzialności (Single Responsibility Principle), Zasada otwarte/zamknięte (Open/Closed Principle), Zasada segregacji interfejsów (Interface Segregation Principle), Zasada odwrócenia zależności (Dependency Inversion Principle) oraz Zasada Liskov (Liskov Substitution Principle). Przykładowo, Zasada pojedynczej odpowiedzialności zakłada, że każda klasa powinna mieć jedną, jasno określoną odpowiedzialność, co pozwala na łatwiejsze testowanie i modyfikowanie kodu bez wpływu na inne jego części. Użycie zasad SOLID w praktyce prowadzi do lepszego rozdzielenia logiki aplikacji i ułatwia jej rozwój oraz utrzymanie, co jest kluczowe w długoterminowych projektach programistycznych.
Pytanie 40
Jaki będzie wynik działania poniższego kodu w języku C#?
intx=5;inty=10;Console.WriteLine($"Suma {x} i {y} wynosi {x + y}");
A. Suma 5 i 10 wynosi 15Twoja odpowiedź
B. Suma x i y wynosi 15
C. Suma 5 i 10 wynosi x + y
D. Error: niewłaściwa składnia
Poprawna odpowiedź. Kod w języku C# wykonuje operację dodawania dwóch zmiennych, x i y, oraz wyświetla wynik w sformatowanym ciągu tekstowym. Poprawna odpowiedź to 'Suma 5 i 10 wynosi 15', ponieważ zmienna x ma wartość 5, a zmienna y ma wartość 10. Kiedy dodajemy te dwie liczby, otrzymujemy 15. Warto zwrócić uwagę na wykorzystanie interpolacji ciągów, co jest istotnym elementem w nowoczesnym C#. Umożliwia to w prosty sposób łączyć tekst z wartościami zmiennych, co zwiększa czytelność kodu. Interpolacja jest szczególnie przydatna w kontekście generowania komunikatów użytkownika i raportów. Przykład zastosowania może obejmować aplikacje, które prezentują wyniki obliczeń lub statystyki, gdzie ważne jest, aby w przyjazny sposób przedstawiać dane. Dobre praktyki programistyczne sugerują, aby unikać twardego kodowania wartości zamiast tego używać zmiennych, co ułatwia późniejsze modyfikacje i utrzymanie kodu.