Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 7 października 2026 04:29
Zakończenie: 7 października 2026 04:32 Rozwiązano w aplikacji mobilnej
Egzamin niezdany
Wynik: 9/40 punktów (22,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 15% podejść do kwalifikacji INF.03.
Porównanie z 47749 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 52,5%, teraz 22,5% (-30,0 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin trafi na Twoje konto, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Baza danych MySQL uległa uszkodzeniu. Które z działań NIE pomoże w jej naprawie?
A. wykonanie replikacji bazy danych
Poprawna odpowiedź
B. próba naprawy poleceniem REPAIR
C. odtworzenie bazy z kopii zapasowej
Twoja odpowiedź
D. utworzenie nowej bazy i przeniesienie do niej tabel
Niepoprawna odpowiedź. Pozostałe trzy działania faktycznie ratują uszkodzoną bazę, więc nie są odpowiedzią na pytanie „które NIE pomoże”. Polecenie REPAIRTABLE próbuje odbudować uszkodzoną strukturę i indeksy tabeli. Odtworzenie z kopii zapasowej przywraca sprawny stan sprzed awarii. Utworzenie nowej bazy i przeniesienie do niej tabel pozwala porzucić uszkodzony kontener danych. Replikacja natomiast jedynie kopiuje dane na inny serwer - w tym także ewentualne uszkodzenia - więc to ona nie pomaga w naprawie.
Pytanie 2
W języku MySQL należy wykorzystać polecenie REVOKE, aby użytkownikowi anna cofnąć możliwość wprowadzania zmian wyłącznie w definicji struktury bazy danych. Polecenie, które służy do odebrania tych uprawnień, ma następującą formę
Niepoprawna odpowiedź. Wybór innego podejścia do odbierania uprawnień użytkownikowi 'anna' jest niewłaściwy z kilku powodów. Po pierwsze, REVOKE ALL ON tabela1 FROM 'anna'@'localhost' jest zbyt ogólnie sformułowane, jako że odbiera wszystkie przydzielone uprawnienia, w tym te, które mogą być konieczne do wykonywania podstawowych operacji na danych. Taki ruch mógłby całkowicie zablokować użytkownika w interakcji z tabelą, co nie odzwierciedla zamierzonego celu, jakim jest jedynie ograniczenie możliwości modyfikacji struktury. Drugą nieodpowiednią propozycją jest REVOKE CREATE UPDATE DROP ON tabela1 FROM 'anna'@'localhost'. Ta komenda również jest błędna, ponieważ wprowadza uprawnienie UPDATE, które nie jest związane z zarządzaniem strukturą bazy danych. Odbieranie tego uprawnienia sprawiłoby, że użytkownik nie mógłby wprowadzać danych do tabeli, co jest sprzeczne z intencją ograniczenia jedynie modyfikacji struktury. Kolejną niewłaściwą odpowiedzią jest REVOKE CREATE INSERT DELETE ON tabela1 FROM 'anna'@'localhost', która również nie spełnia wymogów, ponieważ odbiera uprawnienia związane z wstawianiem i usuwaniem danych, co jest istotne dla pracy z danymi w tabeli. W kontekście zarządzania bazami danych, istotne jest, aby precyzyjnie określać, jakie uprawnienia są odbierane, a także dokładnie rozumieć ich zastosowanie oraz potencjalne konsekwencje ich odebrania.
Pytanie 3
Z jakim problemem wiąże się poziom izolacji transakcji Repeatable Read (powtarzalny odczyt)?
A. z odczytami widmowymi (phantom reads)
Twoja odpowiedź
B. z utratą aktualizacji
C. z brudnymi odczytami
D. z niepowtarzalnymi odczytami
Poprawna odpowiedź. Poziom izolacji Repeatable Read gwarantuje, że te same wiersze odczytane w transakcji nie zmienią się - ale wciąż dopuszcza ODCZYTY WIDMOWE (phantom reads): gdy inna transakcja DODA nowe wiersze pasujące do warunku, powtórne zapytanie może zwrócić ich więcej. Zapamiętaj: Repeatable Read blokuje zmiany istniejących wierszy, lecz nie pojawianie się nowych (widm).
Pytanie 4
Które stwierdzenie o językach jest FAŁSZYWE?
A. C++ jest językiem obiektowym
B. JavaScript jest językiem skryptowym
C. SQL jest językiem programowania strukturalnego
Poprawna odpowiedź
D. PHP służy do tworzenia stron w czasie rzeczywistym
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe zdania są PRAWDZIWE, więc nie pasują do pytania o fałsz. C++ rzeczywiście jest obiektowy, JavaScript skryptowy, a PHP faktycznie generuje strony dynamicznie. Nieprawdą jest jedynie nazwanie SQL językiem programowania strukturalnego - to deklaratywny język zapytań.
Pytanie 5
W języku PHP wykonano operację przedstawioną w ramce. Jak wyświetlić wszystkie wyniki tego zapytania?
$tab=mysqli_query($db,"SELECT imie FROM Osoby WHERE wiek < 18");
A. pokazać zmienną $db
Twoja odpowiedź
B. użyć polecenia mysql_fetch
C. zastosować pętlę z poleceniem mysqli_fetch_row
Poprawna odpowiedź
D. zaindeksować zmienną tab, gdzie tab[0] to pierwsze imię
Niepoprawna odpowiedź. Opcja wyświetlenia zmiennej $db nie jest poprawna ponieważ $db reprezentuje połączenie z bazą danych a nie wyniki zapytania. Wydobycie danych wymaga co najmniej jednego kroku przetwarzania. Użycie polecenia mysql_fetch również jest błędne ponieważ funkcje z prefiksem mysql_ są przestarzałe i niezalecane do użycia w nowych projektach. PHP od wersji 7 całkowicie usunął wsparcie dla tych funkcji co oznacza że próba ich użycia w nowoczesnych środowiskach skutkowałaby błędami. Indeksowanie zmiennej tab jako tab[0] nie jest adekwatne gdyż mysqli_query zwraca zasób bazy danych a nie tablicę. Aby uzyskać dostęp do danych należy zastosować odpowiednią metodę przetwarzania zasobu taką jak mysqli_fetch_row mysqli_fetch_assoc lub inne odpowiednie funkcje dostępne w bibliotece mysqli. Typowe błędy myślowe to zakładanie że wyniki zapytania są automatycznie dostępne jako tablica co nie jest prawdą w przypadku pracy z zasobami bazodanowymi. Zrozumienie poprawnego przetwarzania zasobów jest kluczowe w projektowaniu aplikacji bazodanowych co podkreśla znaczenie praktyki w pracy z nowoczesnymi interfejsami API w PHP.
Pytanie 6
Jaka forma zabezpieczenia dostępu do tabel i kwerend działa w MS Access?
A. stosowanie makr
B. przypisanie uprawnień użytkownikom
Poprawna odpowiedź
C. określanie przestrzeni tabel
D. limity przestrzeni dyskowej
Twoja odpowiedź
Niepoprawna odpowiedź. Pozostałe odpowiedzi nie dotyczą ochrony dostępu. Makra automatyzują czynności (np. otwarcie formularza), ale nie bronią danych przed niepowołanymi osobami. Określanie przestrzeni tabel oraz limity przestrzeni dyskowej to kwestie zarządzania miejscem i wydajnością. Bezpieczeństwo obiektów zapewnia przypisanie uprawnień użytkownikom.
Pytanie 7
Czym jest relacja w bazach danych?
A. logicznym połączeniem tabel
Poprawna odpowiedź
B. kluczem głównym w relacji tabel
C. algebraicznym połączeniem tabel
Twoja odpowiedź
D. połączeniem dwóch pól w obrębie jednej tabeli
Niepoprawna odpowiedź. Niepoprawne odpowiedzi wskazują na nieporozumienia dotyczące definicji relacji w bazach danych. Klucz główny w relacji tabel nie jest definicją relacji, lecz elementem, który umożliwia identyfikację unikalnych rekordów w tabeli. Klucz główny jest atrybutem lub zestawem atrybutów, które zapewniają, że każdy rekord jest jednoznacznie zidentyfikowany, co jest istotne, ale nie definiuje samej relacji między tabelami. Algebraiczne połączenie tabel to termin, który może sugerować operacje wykonywane na danych, ale nie odnosi się bezpośrednio do logiki łączenia tabel, jak ma to miejsce w relacjach. W rzeczywistości, w kontekście baz danych, używa się terminów takich jak 'JOIN', które są technikami łączenia danych z różnych tabel w oparciu o relacje między nimi. Połączenie dwóch pól jednej tabeli to także niepoprawne stwierdzenie, ponieważ relacja odnosi się do powiązań między różnymi tabelami, a nie tylko do pól w jednej tabeli. Właściwe zrozumienie tych terminów jest kluczowe dla efektywnego projektowania baz danych oraz ich późniejszego użytkowania.
Pytanie 8
Tabela programy ma kolumny nazwa, producent, rokWydania. Która kwerenda zwróci producentów BEZ powtórzeń?
Poprawna odpowiedź. Aby wypisać producentów bez powtórzeń, dopisuje się DISTINCT zaraz po SELECT, przed nazwą kolumny: SELECTDISTINCTproducentFROMprogramy;. Słowo to każe bazie pominąć duplikaty i zwrócić każdą nazwę producenta tylko raz. Dlatego ta kwerenda jest poprawna.
Pytanie 9
Którego polecenia SQL użyć, aby utworzyć tabelę?
A.
ADDTABLE
B.
ALTERTABLE
C.
INSERTTABLE
D.
CREATETABLE
Twoja odpowiedź
Poprawna odpowiedź. Nową tabelę tworzy polecenie CREATETABLE, po którym podaje się nazwę i definicje kolumn. Należy do języka definicji danych (DDL). Dlatego do utworzenia tabeli służy CREATETABLE.
Pytanie 10
Jak nazywa się platforma wspierająca tworzenie oprogramowania w technologii .NET?
A. db2
B. eclipse
C. framework
Twoja odpowiedź
D. middleware
Poprawna odpowiedź. Platforma wspierająca tworzenie oprogramowania, dostarczająca gotowy zestaw bibliotek i strukturę (jak .NET Framework), nazywa się framework. Dlatego tą platformą jest framework.
Pytanie 11
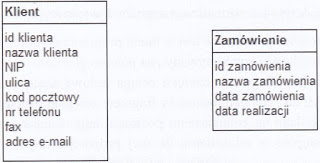
Jaką relację w projekcie bazy danych należy zdefiniować pomiędzy tabelami przedstawionymi na rysunku, zakładając, że każdy klient sklepu internetowego składa przynajmniej dwa zamówienia?
A. 1:1
B. 1:n, gdzie 1 jest po stronie Klienta, a wiele po stronie Zamówienia
Poprawna odpowiedź
C. 1:n, gdzie 1 jest po stronie Zamówienia, a wiele po stronie Klienta
Twoja odpowiedź
D. n:n
Niepoprawna odpowiedź. Zrozumienie poprawnej relacji między tabelami jest kluczowe w projektowaniu bazy danych. Relacja 1:1 oznacza, że każda rekord w jednej tabeli odpowiada dokładnie jednemu rekordowi w drugiej tabeli, co w tym przypadku byłoby nieefektywne, ponieważ ogranicza możliwość dodawania wielu zamówień dla jednego klienta. W praktyce rzadko stosuje się takie relacje, chyba że dane są bardzo specyficzne i nie mogą być rozdzielone. Relacja 1:n, gdzie 1 jest po stronie Zamówienia, a wiele po stronie Klienta, jest nieprawidłowa, ponieważ implikuje, że jedno zamówienie może być przypisane wielu klientom, co jest sprzeczne z rzeczywistością e-commerce, gdzie każde zamówienie jest związane z jednym klientem. Relacja n:n sugeruje, że wiele rekordów w jednej tabeli może być powiązanych z wieloma rekordami w drugiej tabeli. Choć czasami używana, wymaga dodatkowej tabeli pośredniczącej, aby uniknąć redundancji i anomalii. W tym kontekście relacja n:n nie jest potrzebna, ponieważ prosta relacja 1:n już spełnia wymagania funkcjonalne, umożliwiając jednemu klientowi złożenie wielu zamówień bez konieczności komplikowania struktury bazy danych. Prawidłowe zrozumienie tych koncepcji pozwala na projektowanie efektywnych i wydajnych systemów bazodanowych, które są kluczowe dla sukcesu w wielu branżach, zwłaszcza w handlu elektronicznym, gdzie zarządzanie relacjami klientów i ich zamówieniami jest podstawą działalności.
Pytanie 12
Zastosowanie poniższej kwerendy SQL spowoduje usunięcie
DELETEFROMmieszkaniaWHEREstatus=1;
A. tabeli mieszkania z systemu baz danych
B. pola o nazwie status w tabeli mieszkania
C. rekordów, dla których pole status ma wartość 1, z tabeli mieszkania
Poprawna odpowiedź
D. tabel, w których pole status ma wartość 1, z bazy danych mieszkania
Twoja odpowiedź
Niepoprawna odpowiedź. Patrząc na niepoprawne odpowiedzi, zauważam kilka typowych nieporozumień związanych z tym, jak działają kwerendy SQL. Jedna z odpowiedzi sugeruje, że można usunąć tabelę mieszkania z bazy danych, co jest błędne, bo do tego potrzeba polecenia DROP TABLE, a nie DELETE. To jest zasadnicza różnica! DROP TABLE kasuje całą tabelę, a DELETE tylko pojedyncze rekordy. Kolejny błąd to stwierdzenie, że usuwane jest pole o nazwie status. W rzeczywistości DELETE nie zmienia struktury tabeli ani kolumn; po prostu znika rekord na podstawie wskazanych kryteriów. I jeszcze, że całe tabele będą usunięte, gdzie status wynosi 1 - to też mija się z prawdą. W SQL nie da się usuwać tabeli na podstawie wartości w kolumnach; to działa tylko na danych w tabeli. Te błędy często wynikają z niepełnego zrozumienia, jak różne są operacje na danych i operacje na strukturze bazy. Dlatego ważne jest, aby nauczyć się, jak działają zapytania SQL, bo to pomoże uniknąć takich nieporozumień i skuteczniej zarządzać danymi.
Pytanie 13
W SQL, aby dokonać zmiany w strukturze tabeli, na przykład dodać lub usunąć kolumnę, powinno się użyć polecenia
A.
UPDATE
B.
TRUNCATE
C.
DROPTABLE
D.
ALTERTABLE
Twoja odpowiedź
Poprawna odpowiedź. Odpowiedź 'ALTER TABLE' jest prawidłowa, ponieważ to polecenie w SQL umożliwia modyfikację struktury istniejącej tabeli. Dzięki 'ALTER TABLE' możemy dodawać nowe kolumny, usuwać istniejące, zmieniać typy danych kolumn, a także ustawiać ograniczenia, takie jak klucze główne czy unikalne. Przykładowe zastosowanie to: 'ALTER TABLE employees ADD COLUMN birthdate DATE;' co dodaje kolumnę 'birthdate' do tabeli 'employees'. Użycie tego polecenia jest zgodne z dobrymi praktykami, ponieważ pozwala na elastyczne dostosowywanie struktury bazy danych w odpowiedzi na zmieniające się wymagania aplikacji. Warto również zaznaczyć, że 'ALTER TABLE' jest standardowym poleceniem w SQL, co oznacza, że jest obsługiwane przez większość systemów zarządzania bazami danych, takich jak MySQL, PostgreSQL czy SQL Server, co czyni je uniwersalnym narzędziem w pracy z danymi.
Pytanie 14
W SQL uprawnienie SELECT przydzielone za pomocą polecenia GRANT umożliwia użytkownikowi bazy danych
A. zmienianie danych w tabeli
B. generowanie tabeli
C. uzyskiwanie danych z tabeli
Twoja odpowiedź
D. usuwanie danych z tabeli
Poprawna odpowiedź. Przywilej SELECT w języku SQL, przyznawany przy użyciu polecenia GRANT, umożliwia użytkownikowi baz danych na wykonywanie operacji odczytu danych z określonych tabel. Oznacza to, że użytkownik może pobierać informacje zapisane w tabelach bazy danych, co jest kluczowe dla większości aplikacji korzystających z danych. Na przykład, w kontekście aplikacji analitycznych, dostęp do danych pozwala na generowanie raportów i analiz, które wspierają podejmowanie decyzji. W praktyce, przyznanie przywileju SELECT jest standardową procedurą zabezpieczającą, ponieważ pozwala na kontrolowanie, którzy użytkownicy mogą zobaczyć dane w bazie, minimalizując ryzyko nieautoryzowanego dostępu. Warto również zaznaczyć, że w bazach danych, takich jak MySQL, PostgreSQL czy Oracle, przywileje są zarządzane w sposób hierarchiczny, co oznacza, że użytkownik z przywilejem SELECT może dodatkowo dziedziczyć inne przywileje, co zwiększa elastyczność zarządzania dostępem.
Pytanie 15
Podano tabelę ksiazki z kolumnami: tytul, autor (w formacie tekstowym), cena (w formacie liczbowym). Aby zapytanie SELECT zwracało jedynie tytuły, dla których cena jest niższa niż 50zł, należy użyć:
A.
SELECTksiazkiFROMtytulWHEREcena<'50 zł'
B.
SELECTtytulFROMksiazkiWHEREcena>'50 zł'
Twoja odpowiedź
C.
SELECT*FROMksiazkiWHEREcena<50
D.
SELECTtytulFROMksiazkiWHEREcena<50
Poprawna odpowiedź
Niepoprawna odpowiedź. W analizowanych odpowiedziach występują różnorodne błędy związane z interpretacją składni SQL oraz zasad dotyczących typów danych. Zastosowanie 'SELECT ksiazki FROM tytul WHERE cena < '50 zł';' jest błędne, ponieważ nie tylko niewłaściwie odnosi się do nazw tabeli i kolumn, ale także używa złego formatu porównania. Cena powinna być traktowana jako wartość liczbową, więc użycie apostrofów wokół '50 zł' prowadzi do błędnej interpretacji i może skutkować błędem wykonania. Kolejny błąd występuje w 'SELECT tytul FROM ksiazki WHERE cena > '50 zł';', gdzie użycie operatora '>' zupełnie ignoruje założenie dotyczące ceny, które powinno być mniejsze niż 50 zł. To pokazuje typowy problem w myśleniu o logicznych warunkach zapytań SQL, w których kluczowe jest zrozumienie, jakie dane chcemy uzyskać. W ostatniej niepoprawnej odpowiedzi 'SELECT * FROM ksiazki WHERE cena < 50;' również występuje problem, ponieważ użycie '*' zwraca wszystkie kolumny z tabeli, podczas gdy pytanie sugeruje, że interesują nas tylko tytuły. To nieefektywne podejście do wyboru danych, ponieważ może prowadzić do zbędnego obciążenia systemu. W kontekście projektowania baz danych i pisania zapytań SQL istotne jest, aby doprecyzować, które kolumny są naprawdę potrzebne oraz stosować odpowiednie typy danych, co pozwala uniknąć problemów związanych z interpretacją wartości. Kluczową nauką jest to, aby nie tylko tworzyć zapytania, ale również zrozumieć ich logikę oraz efektywność w kontekście wydajności systemu.
Pytanie 16
Jaką cechę pola w tabeli należy ustalić, aby pole mogło przyjmować wyłącznie dane składające się z cyfr?
Ogólne
Rozmiar pola
255
Format
Maska wprowadzania
Tytuł
Wartość domyślna
Reguła spr. poprawności
Tekst reguły spr. poprawności
Wymagane
Nie
Zerowa dł. dozwolona
Tak
Indeksowane
Nie
Kompresja Unicode
Tak
Tryb IME
Bez formantu
Tryb zdania edytora IME
Brak
Tagi inteligentne
A. Tagi inteligentne
B. Maskę wprowadzania
Poprawna odpowiedź
C. Regułę sprawdzania poprawności
Twoja odpowiedź
D. Wartość domyślną
Niepoprawna odpowiedź. Tagi inteligentne to narzędzie, które można znaleźć w dokumentach czy w systemach do zarządzania danymi. Służą do automatycznego rozpoznawania danych, na przykład dat czy adresów, ale nie mają możliwości ograniczania wprowadzanych danych pod kątem ich formatu, jak na przykład cyfry. Reguły sprawdzania poprawności dane na poziomie tabeli, co oznacza, że można sprawdzać, czy spełniają pewne kryteria przy zapisywaniu. To działa, ale jest bardziej ogólne i nie zastąpi maski wprowadzania, bo te działają w czasie rzeczywistym. Z kolei wartość domyślna to coś, co automatycznie wprowadza dane w polu, jeśli użytkownik nic nie poda. To może być przydatne, gdy jakieś pole zawsze powinno mieć określoną wartość, chyba że użytkownik zadecyduje inaczej. Tylko że wartość domyślna nie reguluje, jakie dane mogą być wpisywane, co jest właśnie wymagane w pytaniu o ograniczenie danych do cyfr. Często myślimy, że wartość domyślna lub reguły mogą kontrolować format danych na bieżąco, ale to jest rola maski wprowadzania, która działa w momencie, gdy piszemy, więc chroni integralność już na etapie wprowadzania danych.
Pytanie 17
W jaki sposób można ocenić normalizację przedstawionej tabeli?
Firma
Adres
Forbot
ul. Krótka 11, 22-222 Warszawa
Marbot
ul. Długa 5, 33-333 Warszawa
A. Tabela znajduje się w pierwszej postaci normalnej
B. Tabela znajduje się w drugiej postaci normalnej
Twoja odpowiedź
C. Tabela nie została znormalizowana
Poprawna odpowiedź
D. Tabela jest w trzeciej postaci normalnej
Niepoprawna odpowiedź. Pierwsza postać normalna wymaga aby wszystkie wartości atrybutów w rekordzie były atomowe czyli nieredukowalne Tabela przedstawiona w zadaniu nie spełnia tego wymogu ponieważ adresy nie są rozbite na osobne elementy takie jak ulica miasto i kod pocztowy co uniemożliwia bardziej złożoną manipulację danymi oraz precyzyjne wyszukiwanie Druga postać normalna wymaga aby wszystkie atrybuty nie będące częścią klucza głównego były w pełni funkcjonalnie zależne od całego klucza Tabela z pytania nie spełnia tych kryteriów ponieważ istnieje redundancja i brak wyraźnej struktury Klucz główny w dobrze zaprojektowanej tabeli bazy danych powinien jednoznacznie identyfikować każdy wiersz co nie jest widoczne w tej strukturze Trzecia postać normalna idzie krok dalej eliminując zależności przechodnie między atrybutami co w przypadku tej tabeli również nie ma zastosowania Problemem tutaj jest brak rozdzielenia danych na mniejsze tabele co prowadzi do redundancji i potencjalnych błędów przy aktualizacji danych często określanych jako anomaly W dobrze znormalizowanej bazie danych oddzielenie informacji takich jak dane adresowe umożliwia lepszą organizację danych ich spójność oraz zwiększa efektywność operacji na bazie danych
Pytanie 18
W SQL, aby zaktualizować informacje w wierszach w tabeli, konieczne jest użycie polecenia
A.
ALTERTABLE
Twoja odpowiedź
B.
UPDATE
Poprawna odpowiedź
C.
INSERTINTO
D.
SELECT
Niepoprawna odpowiedź. Wybór innych poleceń SQL do aktualizacji danych w tabelach pokazuje pewne nieporozumienia co do funkcji tych komend. Polecenie ALTER TABLE jest do zmiany struktury tabeli, a nie do aktualizacji danych w wierszach. Używamy go do dodawania lub usuwania kolumn, zmiany typów danych, ale nie do zmiany informacji w istniejących rekordach. A INSERT INTO służy do dodawania nowych wierszy, a to także nie jest to, czego potrzebujemy w przypadku aktualizacji. Takie podejście często prowadzi do błędnych wniosków, bo nie każde polecenie SQL można stosować zamiennie, co jest błędne. SELECT natomiast służy do odczytywania danych, a nie do ich zmiany. Użytkownicy czasami mylą te komendy, zwłaszcza jak nie znają jeszcze dobrze podstaw SQL. Kluczowe jest, aby zrozumieć, jakie operacje są możliwe w SQL i do czego służą, bo to pozwoli unikać błędnych decyzji i poprawić efektywność pracy z bazami danych.
Pytanie 19
Elementem wykorzystywanym w bazie danych do podsumowywania, prezentowania oraz drukowania danych jest
A. raport
Poprawna odpowiedź
B. zapytanie
C. formularz
Twoja odpowiedź
D. zestawienie
Niepoprawna odpowiedź. Zapytanie, formularz i zestawienie, choć mogą być używane w kontekście pracy z danymi, pełnią inne funkcje niż raport. Zapytanie to instrukcja w języku zapytań, najczęściej SQL, która pozwala na pobranie określonych danych z bazy danych. Zapytania są fundamentalne dla interakcji z bazami danych, ponieważ umożliwiają użytkownikom selekcjonowanie, filtrowanie i sortowanie informacji, ale same w sobie nie dostarczają gotowych podsumowań ani analiz. Formulario to interaktywny element, który umożliwia użytkownikom wprowadzanie danych; jego głównym celem jest zbieranie informacji, a nie ich prezentacja. Użytkownicy często mylą formularze z raportami, co prowadzi do nieporozumień w zakresie ich zastosowania. Zestawienie, z kolei, może odnosić się do porównania wartości lub grup danych, ale nie jest standardowym terminem w kontekście raportów, co może powodować niejasności. Warto zrozumieć, że raporty są narzędziem do podsumowywania wyników, podczas gdy zapytania, formularze i zestawienia mają różne cele i funkcje. Kluczowa jest umiejętność rozróżniania tych elementów, aby skutecznie zarządzać danymi i prezentować je w odpowiedni sposób.
Pytanie 20
Na ilustracji przedstawiającej tabelę muzyka, zrealizowano poniższe zapytanie SQL. Jaki rezultat zwróci ta kwerenda?
SELECT wykonawca FROM`muzyka` WHERE wykonawca LIKE 'C%w';
ID
tytul_plyty
wykonawca
rok_nagrania
opis
1
Czas jak rzeka
Czesław Niemen
2005
Przyjdź W Taka Noc itp.
2
Ikona
Stan Borys
2014
3
Aerolit
Czesław Niemen
2017
Winylowa reedycja płyty "Aerolit"
4
Journey
Mikołaj Czechowski
2013
A. Czesław
B. pusty wynik
Poprawna odpowiedź
C. Czesław, Niemen
D. Czesław, Czechowski
Twoja odpowiedź
Niepoprawna odpowiedź. W przypadku zapytania SQL które wykorzystuje operator LIKE z wzorcem C%W często dochodzi do nieporozumienia dotyczącego działania tego operatora. LIKE jest używany do porównywania wzorców tekstowych a procent % służy do zastępowania dowolnej liczby znaków. Można by błędnie założyć że skoro zapytanie ma zwrócić wykonawców których imiona zaczynają się na C i kończą na W to którąś z dostępnych opcji w tabeli spełnia ten warunek. Jednakże w tej konkretnej tabeli nie ma wykonawcy który by spełniał te kryteria. Czesław Niemen kończy się na M a nie na W natomiast Mikołaj Czechowski rozpoczyna się od litery M zamiast C. Przykładem typowego błędu jest nieprawidłowa interpretacja tego jak działają wzorce w operatorze LIKE lub przeoczenie że wzorzec musi być dokładnie zgodny z wymaganiami. Ważnym aspektem jest też zrozumienie że w praktyce biznesowej dokładność danych jest kluczowa a niepoprawne zrozumienie wzorców prowadzi do niepoprawnych wyników zapytań. Dlatego zawsze warto przetestować zapytanie na mniejszym zbiorze danych aby upewnić się że zwraca oczekiwane wyniki co jest dobrą praktyką w zarządzaniu bazami danych.
Pytanie 21
Tabela uczniowie ma data_ur w formacie rrrr-mm-dd. Która kwerenda wyświetli imiona i nazwiska uczniów urodzonych w 2001?
Poprawna odpowiedź. Data ma format rrrr-mm-dd, więc samego roku nie da się porównać liczbą - trzeba dopasować POCZĄTEK tekstu wzorcem LIKE. Wzorzec "2001-%-%" oznacza rok 2001 oraz dowolny miesiąc i dzień (% to dowolny ciąg): SELECTimie,nazwiskoFROMuczniowieWHEREdata_urLIKE"2001-%-%";. Dlatego ta kwerenda jest poprawna.
Pytanie 22
Przedstawiona jest tabela pracownicy, w której umieszczono rekordy widoczne obok. Jaką wartość zwróci wykonanie umieszczonej w ramce kwerendy SQL?
SELECT MAX(pensja) FROM pracownicy WHERE pensja < 3000;
id
imie
nazwisko
pensja
1
Anna
Kowalska
3400
2
Monika
Nowak
1300
3
Ewelina
Nowakowska
2600
4
Anna
Przybylska
4600
5
Maria
Kowal
2200
6
Ewa
Nowacka
5400
A. 1300
B. 5400
Twoja odpowiedź
C. 2600
Poprawna odpowiedź
D. 2200
Niepoprawna odpowiedź. Rozważając pozostałe opcje odpowiedzi możemy zauważyć że błędem jest nieuwzględnianie warunku WHERE pensja < 3000 w kwerendzie. Opcja 1300 jest niższa niż 2600 ale nie jest maksymalną wartością z zestawu spełniającego kryteria zapytania. Wartość 5400 jest w ogóle poza zakresem warunku ponieważ nie spełnia kryterium pensja mniejsza niż 3000. Takie niepoprawne zrozumienie zapytania często wynika z nieuwzględnienia klauzuli ograniczającej co jest częstym błędem w analizie danych. Brak zrozumienia logiki warunkowej prowadzi do błędnych wniosków co w praktycznych zastosowaniach może skutkować wyciągnięciem nieprawidłowych danych. W pracy z SQL istotne jest dokładne zrozumienie działania klauzul takich jak WHERE oraz funkcji agregujących takich jak MAX które pozwalają na precyzyjne określenie zakresu analizowanych danych. Zrozumienie błędów logicznych w interpretacji danych jest kluczowe dla unikania pomyłek w rzeczywistych scenariuszach biznesowych. Wykorzystanie filtrów w SQL pozwala na tworzenie bardziej złożonych i precyzyjnych zapytań co jest niezbędne dla dokładnej analizy i raportowania w kontekście biznesowym co jest zgodne z najlepszymi praktykami w dziedzinie analizy danych.
Pytanie 23
Dostępna jest tabela pracownicy zawierająca pola id, nazwisko, imię oraz wynagrodzenie. Kolumnę wynagrodzenie można usunąć przy użyciu następującej instrukcji
A.
DROPTABLEpracownicyDELETECOLUMNwynagrodzenie
Twoja odpowiedź
B.
ALTERTABLEpracownicyDELETECOLUMNwynagrodzenie
C.
ALTERTABLEpracownicyDROPCOLUMNwynagrodzenie
Poprawna odpowiedź
D.
ALTERTABLEpracownicyDELETEwynagrodzenie
Niepoprawna odpowiedź. W niepoprawnych odpowiedziach pojawiają się błędy związane z użyciem SQL i polecenia ALTER TABLE. Na przykład w pierwszej odpowiedzi ktoś użył kombinacji DROP TABLE i DELETE COLUMN, co jest totalnie pomyłką, bo DROP TABLE usuwa całą tabelę, a nie tylko kolumnę. Może to wynikać z pomylenia usuwania tabeli z usuwaniem kolumny. W następnej odpowiedzi, ALTER TABLE pracownicy DELETE COLUMN, mamy do czynienia z błędem, bo w SQL nie ma czegoś takiego jak DELETE COLUMN. Ludzie mogą to mylić z instrukcją DELETE, która dotyczy usuwania wierszy, a nie kolumn. Ostatnia odpowiedź, czyli ALTER TABLE pracownicy DELETE wynagrodzenie, też jest błędna, bo nie zaznacza, że chodzi o kolumnę, a użycie słowa DELETE w tym kontekście jest mylące. Takie błędy mogą wynikać z niepełnego zrozumienia podstawowych konceptów związanych z bazami danych i SQL. Żeby tego uniknąć, dobrze jest regularnie przeglądać dokumentację oraz ćwiczyć pisanie zapytań, bo to naprawdę pomaga w lepszym rozumieniu tego, co się robi.
Pytanie 24
Jakie zadanie ma funkcja PHP o nazwie mysql_select_db()?
A. wyznaczyć bazę, z której będą pozyskiwane dane
Poprawna odpowiedź
B. nawiązać połączenie między bazą danych a serwerem SQL
C. uzyskać dane z bazy danych na podstawie zapytania
Twoja odpowiedź
D. wyznaczyć tabelę, z której będą pozyskiwane dane
Niepoprawna odpowiedź. Tutaj mamy parę pomyłek związanych z funkcją <span>mysql_select_db()</span>. Po pierwsze, mylisz ją z tym, jak łączymy bazę danych z serwerem SQL. W rzeczywistości, połączenie robi się przez <span>mysql_connect()</span>, a <span>mysql_select_db()</span> ma za zadanie pokazać, która z baz, które już mamy, ma być użyta. Kolejna sprawa to błędne zrozumienie, jak wyciągamy dane z bazy. Robimy to za pomocą funkcji jak <span>mysql_query()</span>, więc wybór bazy danych i ściąganie danych to dwa różne etapy. Mylenie bazy danych z tabelą też wprowadza w błąd, bo baza to tak naprawdę pojemnik dla tabel, a nie jedna konkretna tabela. Moim zdaniem, zrozumienie tej hierarchii jest kluczowe, żeby dobrze działać z bazami. Te nieporozumienia mogą skutkować poważnymi kłopotami, jak złe zapytania czy problemy z dostępem do danych. Lepiej wcześniej przejrzeć dokumentację i standardy SQL, bo one jasno tłumaczą różnice między połączeniem z serwerem, wyborem bazy danych a kwerendami.
Pytanie 25
W tabeli podzespoly należy zaktualizować wartość pola URL na "toshiba.pl" dla wszystkich wierszy, gdzie producent to TOSHIBA. W SQL zapis tej modyfikacji będzie wyglądać następująco:
Poprawna odpowiedź. Odpowiedź jest poprawna, ponieważ zawiera właściwą składnię polecenia SQL do aktualizacji wartości w tabeli. W SQL, instrukcja UPDATE jest używana do modyfikacji danych w istniejących rekordach. W tym przypadku, polecenie 'UPDATE podzespoly SET URL = 'toshiba.pl' WHERE producent = 'TOSHIBA';' zmienia wartość pola URL na 'toshiba.pl' tylko dla tych rekordów, gdzie producent jest równy 'TOSHIBA'. To podejście jest zgodne z dobrymi praktykami w zarządzaniu bazami danych, ponieważ pozwala na precyzyjne określenie, które rekordy mają zostać zaktualizowane. W praktyce, przed wykonaniem takiej aktualizacji, zaleca się zawsze wykonać zapytanie SELECT, aby zweryfikować, które rekordy zostaną zmodyfikowane. Zapewnia to dodatkową warstwę kontroli i zabezpiecza przed niezamierzonymi zmianami. Prawidłowe użycie klauzuli WHERE jest kluczowe, aby nie zmienić wszystkich rekordów w tabeli, co mogłoby doprowadzić do utraty danych. Zrozumienie struktury SQL i zasad działania instrukcji jest fundamentem pracy z relacyjnymi bazami danych.
Pytanie 26
Dana jest tabela uczniowie, do której wpisano rekordy jak na rysunku. Co będzie wynikiem działania przedstawionego zapytania SQL?
SELECT AVG(ocena) FROM uczniowie;
Nazwisko
Imie
ocena
Kowalski
Sebastian
4
Kaczmarek
Marta
3
Baryła
Zenon
4
Gota
Anna
3
A. Suma ocen równa 14
B. Dane 4, 3, 4, 3
Twoja odpowiedź
C. Wartość 3.5
Poprawna odpowiedź
D. Liczba wierszy równa 4
Niepoprawna odpowiedź. Widzę, że popełniłeś parę błędów w odpowiedziach. Stwierdzenie 'Suma ocen równa 14' pokazuje, że mogłeś nie do końca zrozumieć, jak działa AVG, bo ta funkcja nie sumuje wartości, ale liczy średnią. Z kolei odpowiedzi 'Dane 4, 3, 4, 3' i 'Liczba wierszy równa 4' też sugerują, że coś nie tak z interpretacją wyników. Pierwsza sugeruje, że zapytanie wyciąga konkretne liczby, a to nieprawda, bo AVG zwraca tylko jedną wartość – średnią. A druga odpowiedź wprowadza w błąd, mówiąc o liczbie wierszy, podczas gdy AVG operuje na wartościach, a nie ich ilości. Tego typu pomyłki mogą wynikać z nieznajomości funkcji agregujących w SQL. Ważne jest, żeby zrozumieć, co każda funkcja robi i jakie zwraca wyniki.
Pytanie 27
Tabela Pracownicy zawiera informacje na temat pracowników różnych działów, co jest zaznaczone przez pole liczbowe dzial. Z racji tego, że zazwyczaj kwerendy dotyczą tylko działu 2, można uprościć zapytania do tej tabeli, tworząc wirtualną tabelę o nazwie Prac_dzial2 przy użyciu zapytania
Niepoprawna odpowiedź. Wybór odpowiedzi, która nie zawiera pełnej składni SQL, prowadzi do nieporozumień w zrozumieniu, jak działa tworzenie widoków w bazach danych. Odpowiedzi takie jak 'CREATE VIEW Prac_dzial2 FROM Pracownicy WHERE dzial=2;' są błędne, ponieważ użycie słowa kluczowego 'FROM' jest niewłaściwe w kontekście definicji widoku. W standardowym SQL używa się 'AS' do określenia zapytania, które definiuje widok, co jest kluczowe dla poprawnego przetwarzania zapytania przez silnik bazy danych. Z kolei odpowiedzi, które zaczynają się od 'VIEW', takie jak 'VIEW Prac_dzial2 FROM Pracownicy WHERE dzial=2;' oraz 'VIEW Prac_dzial2 SELECT FROM Pracownicy WHERE dzial=2;', są całkowicie niepoprawne, ponieważ w SQL nie istnieje polecenie 'VIEW' jako samodzielne polecenie do tworzenia widoków. To może prowadzić do mylnego przekonania, że komendy SQL są bardziej elastyczne w kwestii składni, co nie jest zgodne z rzeczywistością. Użytkownicy powinni zawsze odnosić się do dokumentacji SQL oraz standardów, aby upewnić się, że struktura zapytań jest zgodna z wymaganiami danego systemu bazy danych. Rozumienie poprawnej składni i semantyki SQL jest podstawowym elementem efektywnego zarządzania bazami danych i kluczowym krokiem w procesie nauki oraz implementacji skutecznych rozwiązań bazodanowych.
Pytanie 28
Wskaż system do zarządzania treściami.
A. Joomla!
Poprawna odpowiedź
B. Apache
C. phpMyAdmin
Twoja odpowiedź
D. MariaDB
Niepoprawna odpowiedź. Wybór odpowiedzi innych niż Joomla! ukazuje istotne nieporozumienia dotyczące roli różnych technologii w kontekście zarządzania treścią. Apache to serwer HTTP, który obsługuje żądania użytkowników w Internecie, ale nie jest systemem zarządzania treścią. Jego funkcją jest dostarczanie plików z serwera do przeglądarki internetowej, co jest kluczowe, ale nie dotyczy bezpośredniego zarządzania treścią witryny. PhpMyAdmin to narzędzie do zarządzania bazami danych MySQL, które umożliwia użytkownikom wykonywanie operacji na bazach danych w interfejsie webowym, jednak nie pełni funkcji CMS. Jego głównym celem jest umożliwienie użytkownikom łatwego zarządzania danymi, a nie tworzenia i publikowania treści na stronach internetowych. MariaDB jest systemem zarządzania relacyjnymi bazami danych, będącym rozwidleniem MySQL, który również nie jest CMS-em. Jest używany do przechowywania danych, ale nie oferuje funkcji do zarządzania treścią w kontekście tworzenia i edycji stron. Kluczowym błędem myślowym, który prowadzi do takich odpowiedzi, jest mylenie różnych technologii webowych i ich funkcji. W rzeczywistości system zarządzania treścią, taki jak Joomla!, łączy w sobie zarówno zarządzanie danymi, jak i interfejs do tworzenia treści, co czyni go bardziej kompleksowym rozwiązaniem dla użytkowników pragnących budować i utrzymywać witryny internetowe.
Pytanie 29
Tabela góry zawiera polskie pasma górskie wraz z ich szczytami - w kolumnie pasmo nazwę pasma, a w kolumnie wysokosc wysokość szczytu. Wskaż kwerendę liczącą dla każdego pasma górskiego średnią wysokość jego szczytów.
A.
SELECTpasmo,AVG(wysokosc)FROMgoryGROUPBYpasmo;
Poprawna odpowiedź
B.
SELECTpasmo,AVG(wysokosc)FROMgoryLIMITpasmo;
C.
SELECTpasmo,COUNT(wysokosc)FROMgoryORDERBYpasmo;
Twoja odpowiedź
D.
SELECTpasmo,SUM(wysokosc)FROMgoryGROUPBYpasmo;
Niepoprawna odpowiedź. Niestety, wybrana przez Ciebie odpowiedź jest błędna. Przyjrzyjmy się bliżej wszystkim niepoprawnym odpowiedziom. W odpowiedzi 'SELECT pasmo, AVG(wysokosc) FROM gory LIMIT pasmo;' użyto niepoprawnie klauzuli LIMIT. Klauzula LIMIT w SQL jest wykorzystywana do ograniczenia liczby zwracanych wierszy, a nie do grupowania wyników. W zapytaniu 'SELECT pasmo, COUNT(wysokosc) FROM gory ORDER BY pasmo;' użyto funkcji COUNT() zamiast AVG(). Funkcja COUNT() zlicza liczbę wartości, a nie oblicza ich średniej. Dodatkowo, zamiast grupowania wyników klauzulą GROUP BY, użyto klauzuli ORDER BY, która służy do sortowania wyników, a nie grupowania. Ostatnia błędna odpowiedź 'SELECT pasmo, SUM(wysokosc) FROM gory GROUP BY pasmo;' używa funkcji SUM() zamiast AVG(). Funkcja SUM() oblicza sumę wartości, a nie ich średnią. Klauzula GROUP BY jest poprawnie użyta do grupowania wyników. Pamiętaj, że wybór odpowiedniej funkcji agregującej i klauzuli jest kluczowy dla uzyskania prawidłowych wyników zapytania SQL.
Pytanie 30
Który zapis służy do zdefiniowania klucza obcego w MySQL?
W przedstawionym kodzie PHP przeprowadzono operację na bazie danych. Jaką funkcję należy wywołać, aby uzyskać liczbę wierszy, które zostały zmienione w tabeli?
$zapytanie="UPDATE kadra SET stanowisko='Programista' WHERE id < 10";mysqli_query($db, $zapytanie);
A. mysqli_num_rows()
Twoja odpowiedź
B. mysqli_use_result()
C. mysqli_field_count()
D. mysqli_affected_rows()
Poprawna odpowiedź
Niepoprawna odpowiedź. Wybór innych funkcji zamiast mysqli_affected_rows() prowadzi do nieporozumień dotyczących ich przeznaczenia i zastosowania. Przykładowo, funkcja mysqli_num_rows() jest używana w kontekście kwerend SELECT, gdzie zwraca liczbę wierszy w zestawie wyników. Nie może być zastosowana po operacjach modyfikujących bazę danych, takich jak UPDATE, ponieważ nie dostarcza informacji o efektach tych operacji. Z kolei mysqli_use_result() jest przeznaczona do przetwarzania zestawów wyników z zapytań, co znowu nie odnosi się do sytuacji, w której chcemy znać liczbę zmienionych wierszy. Funkcja mysqli_field_count() zwraca liczbę kolumn w ostatnim zapytaniu, które zwróciło rezultat, co również nie ma zastosowania w kontekście zapytań modyfikujących. Typowym błędem myślowym jest mieszanie funkcji związanych z różnymi rodzajami zapytań. Ważne jest, aby rozumieć, jak różne funkcje w PHP dotyczące MySQL są ze sobą powiązane i jakie mają specyficzne zastosowania. Nieprawidłowe użycie tych funkcji może prowadzić do błędnych wniosków o stanie bazy danych i utrudniać debugowanie aplikacji. W związku z tym kluczowym elementem efektywnego zarządzania bazami danych jest znajomość odpowiednich funkcji oraz ich funkcji i ograniczeń.
Pytanie 32
Jakiej kwerendy w bazie MariaDB należy użyć, aby wybrać artykuły, których ceny mieszczą się w przedziale domkniętym <10, 20>?
A.
SELECT*FROMArtykulyWHERECenaIN(10,20)
Twoja odpowiedź
B.
SELECT*FROMArtykulyWHERECenaLIKE1%,2%
C.
SELECT*FROMArtykulyWHERECenaBETWEEN10AND20
Poprawna odpowiedź
D.
SELECT*FROMArtykulyWHERECena>10ANDCena<20
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi, 'SELECT * FROM Artykuly WHERE Cena IN (10, 20);', jest błędna, ponieważ operator IN służy do sprawdzania, czy wartość znajduje się w określonej liście wartości. W tym przypadku zwróci tylko artykuły, których cena wynosi dokładnie 10 lub 20, a nie wszystkie artykuły w przedziale między tymi wartościami. Operator IN nie obsługuje zakresów, co może prowadzić do niepełnych wyników w analizach cenowych. Odpowiedź 'SELECT * FROM Artykuly WHERE Cena LIKE 1%, 2%;' również nie jest poprawna, ponieważ operator LIKE jest używany do wyszukiwania wzorców w tekstach, a nie do porównywania wartości liczbowych. Użycie LIKE w tym kontekście jest całkowicie niewłaściwe i prowadzi do błędnych interpretacji wyników, co jest typowym błędem wśród początkujących użytkowników SQL. Z kolei kwerenda 'SELECT * FROM Artykuly WHERE Cena > 10 AND Cena < 20;' z kolei nie obejmuje wartości granicznych 10 i 20, co sprawia, że nie zwróci artykułów, których cena wynosi równo 10 lub 20. To pokazuje typowy błąd myślowy, polegający na niepełnym zrozumieniu zastosowania operatorów porównawczych w SQL. W praktyce, aby uzyskać pełny zakres wartości w analizach, kluczowe jest zrozumienie różnic między tymi operatorami oraz ich właściwe zastosowanie w kontekście wymagań dotyczących danych.
Pytanie 33
W bazie MySQL zdefiniowano podczas tworzenia tabeli pole
idintNOT NULL AUTO_INCREMENT
Wpis AUTO_INCREMENT oznacza, że
A. możliwe jest wprowadzenie rekordu z dowolną wartością dla kolumny id
B. kolumna id będzie mogła przyjmować wartości: NULL, 1, 2, 3, 4 i tak dalej
C. wartości tej kolumny będą automatycznie tworzone w trakcie dodawania nowego rekordu do bazy
Poprawna odpowiedź
D. wartość kolumny id zostanie automatycznie przypisana przez system i będzie to przypadkowo wygenerowana liczba całkowita
Twoja odpowiedź
Niepoprawna odpowiedź. Wybór niepoprawnych odpowiedzi najczęściej wynika z niepełnego zrozumienia działania mechanizmu AUTO_INCREMENT w MySQL. Zgłoszenie, że dozwolone jest dodawanie rekordu z dowolną wartością pola id, jest błędne, ponieważ pole z AUTO_INCREMENT nie pozwala na wprowadzenie wartości ręcznie; to system bazy danych przydziela kolejne wartości. Ponadto, sugestia, że pole id może przyjmować wartość NULL jest również nieprawidłowa. W definicji pola 'id int NOT NULL AUTO_INCREMENT' zawiera się klauzula NOT NULL, co oznacza, że pole to nie może być puste - każdemu rekordowi musi być przypisana właściwa wartość. Inną mylną koncepcją jest stwierdzenie, że wartość pola id zostanie wygenerowana losowo. AUTO_INCREMENT nie generuje wartości losowych, lecz sekwencyjne, co oznacza, że wartości będą rosły o jeden w stosunku do ostatniego zarejestrowanego identyfikatora. Takie podejście zapewnia porządek i przewidywalność w bazie danych. Często zdarza się, że osoby korzystające z baz danych nie zdają sobie sprawy z tych mechanizmów, co prowadzi do mylnych wniosków. Zrozumienie zasad działania AUTO_INCREMENT jest kluczowe dla efektywnego projektowania baz danych oraz zapewnienia integralności danych.
Pytanie 34
Aby przygotować czytelne zestawienie danych z bazy, przeznaczone do wydruku, należy posłużyć się:
A. formularzem
B. raportem
Poprawna odpowiedź
C. kwerendą INSERT
Twoja odpowiedź
D. indeksem
Niepoprawna odpowiedź. Pozostałe odpowiedzi dotyczą innych zadań niż prezentacja danych. Formularz to interfejs do wprowadzania i edycji rekordów - pomaga zasilać bazę, ale nie tworzy zestawień do druku. Kwerenda INSERT również służy do zapisu: dodaje nowe wiersze do tabeli, więc nie ma związku z prezentacją. Indeks to mechanizm przyspieszający wyszukiwanie i sortowanie - działa „w tle” i niczego nie wyświetla użytkownikowi. Czytelne zestawienie danych gotowe do wydruku przygotowuje raport, dlatego to on jest poprawną odpowiedzią.
Pytanie 35
ALTER TABLEartykulyMODIFYcenafloat;
Przedstawiona kwerenda ma za zadanie w tabeli artykuly
A. usunąć kolumnę cena typu float.
B. zmienić typ na float dla kolumny cena.
Poprawna odpowiedź
C. zmienić nazwę kolumny z cena na float.
D. dodać kolumnę cena o typie float, jeśli nie istnieje.
Twoja odpowiedź
Niepoprawna odpowiedź. W tej kwerendzie łatwo pomylić znaczenie słów kluczowych, bo wszystkie dotyczą struktury tabeli, ale robią zupełnie inne rzeczy. ALTER TABLE informuje bazę danych, że chcemy zmienić budowę tabeli artykuly, natomiast MODIFY odnosi się do zmiany definicji istniejącej kolumny. Nie usuwa kolumny, bo do tego w SQL używa się konstrukcji DROP COLUMN, na przykład ALTER TABLE artykuly DROP COLUMN cena. Gdyby taka operacja została wykonana, kolumna zniknęłaby razem z danymi, więc jest to dużo bardziej destrukcyjne działanie. Tutaj tego nie ma. Nie chodzi też o zmianę nazwy kolumny z cena na float. W składni MySQL do zmiany nazwy często używa się CHANGE albo RENAME COLUMN, zależnie od wersji i systemu bazodanowego. W zapisie MODIFY cena float słowo cena wskazuje istniejącą kolumnę, a float jest typem danych, nie nową nazwą. Błędne jest również założenie, że zapytanie doda kolumnę tylko wtedy, gdy jej nie ma. Dodawanie kolumn wykonuje się przez ADD COLUMN, a nie MODIFY. Jeśli kolumna cena nie istnieje, taka kwerenda zakończy się błędem. Typowy błąd myślowy polega tu na traktowaniu float jak zwykłego identyfikatora albo na zgadywaniu znaczenia po samym ALTER TABLE. W SQL warto patrzeć na całe polecenie, bo jedno słowo kluczowe, takie jak MODIFY, DROP czy ADD, kompletnie zmienia sens operacji.
Pytanie 36
Przy użyciu polecenia ALTER TABLE można
A. usuwać tabelę
B. tworzyć nową tabelę
C. zmieniać strukturę tabeli
Poprawna odpowiedź
D. zmieniać wartości zapisane w rekordach tabeli
Twoja odpowiedź
Niepoprawna odpowiedź. W kontekście zarządzania bazami danych istnieje wiele podstawowych operacji, które można wykonywać, a polecenie ALTER TABLE jest jednoznacznie związane z modyfikowaniem struktury tabeli, co wyklucza możliwość jego użycia do usuwania lub tworzenia tabel. Odpowiedź sugerująca, że ALTER TABLE może usuwać tabelę, jest merytorycznie błędna. Tego rodzaju operacje realizowane są przez inne polecenia, takie jak DROP TABLE, które służy do usuwania tabeli i jej danych. Podobnie, tworzenie tabeli jest realizowane poleceniem CREATE TABLE. Mylne stwierdzenie, że ALTER TABLE może być używane do modyfikacji wartości w rekordach, również jest niepoprawne, ponieważ zmiana wartości zapisanych w tabeli jest realizowana za pomocą polecenia UPDATE. Niezrozumienie różnicy pomiędzy tymi poleceniami może prowadzić do błędnych operacji na bazie danych, narażających na utratę danych lub nieprawidłowe funkcjonowanie aplikacji. Dlatego tak ważne jest zrozumienie, jakie konkretne operacje można wykonać za pomocą poszczególnych poleceń SQL oraz ich właściwego zastosowania w praktyce, aby zapewnić integralność i bezpieczeństwo danych.
Pytanie 37
W systemie baz danych zdefiniowano tabelę Mieszkancy, która zawiera dane. W celu usunięcia tej tabeli oraz jej zawartości, należy użyć polecenia
A.
DROPTABLEMieszkancy;
Poprawna odpowiedź
B.
DELETEFROMMieszkancy;
C.
ALTERTABLEMieszkancy;
D.
TRUNCATETABLEMieszkancy;
Twoja odpowiedź
Niepoprawna odpowiedź. Wybór nieprawidłowych poleceń do usunięcia tabeli często wynika z niepełnego zrozumienia różnicy między różnymi instrukcjami SQL. Polecenie 'DELETE FROM Mieszkancy;' usuwa wszystkie rekordy z tabeli, ale sama tabela oraz jej struktura pozostają nienaruszone. To oznacza, że tabela nadal będzie istnieć w bazie danych, co może być mylące, gdy celem jest całkowite usunięcie obiektu. Z drugiej strony, 'ALTER TABLE Mieszkancy;' służy do zmiany struktury tabeli, takiej jak dodawanie kolumn czy zmiana typów danych, a nie do jej usuwania. Zastosowanie tego polecenia w kontekście usuwania tabeli wskazuje na niezrozumienie roli, jaką pełnią różne instrukcje w SQL. Ostatecznie, 'TRUNCATE TABLE Mieszkancy;' również może wydawać się odpowiednie, gdyż usuwa wszystkie wiersze z tabeli, ale pozostawia jej strukturę, co jest różne od całkowitego usunięcia tabeli. Kluczowym błędem jest mylenie operacji na danych z operacjami na strukturze obiektów w bazie danych. Zrozumienie tych różnic jest fundamentalne dla skutecznego zarządzania bazami danych oraz ich optymalizacji.
Pytanie 38
Do przechowywania jakich wartości przeznaczony jest typ DECIMAL?
A. liczb zapisanych w systemie binarnym
B. danych tekstowych o określonej długości
C. liczb rzeczywistych zmiennoprzecinkowych
Twoja odpowiedź
D. liczb rzeczywistych stałoprzecinkowych
Poprawna odpowiedź
Niepoprawna odpowiedź.DECIMAL to dokładny typ liczbowy o ustalonej precyzji, a nie zmiennoprzecinkowy (od tego są FLOAT/DOUBLE, które mogą zaokrąglać). Nie służy do tekstu (CHAR/VARCHAR) ani do zapisu binarnego. DECIMAL przechowuje liczby rzeczywiste stałoprzecinkowe.
Pytanie 39
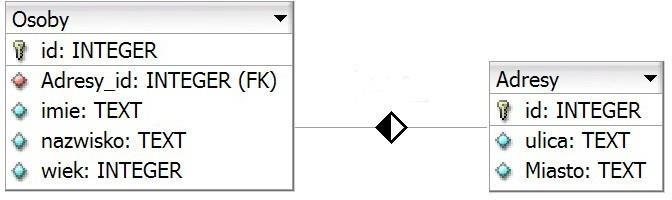
Tabele Osoby i Adresy są połączone relacją jeden do wielu. Które zapytanie SQL należy wykonać, aby korzystając z tej relacji, prawidłowo wyświetlić nazwiska oraz przyporządkowane im miasta?
Niepoprawna odpowiedź. W tym zadaniu widać kilka typowych pułapek związanych z łączeniem tabel w SQL. Często spotyka się podejście, że wystarczy wypisać kilka tabel po przecinku w klauzuli FROM i baza danych sama się domyśli, jak je połączyć. Niestety tak to nie działa. Jeśli podamy FROM Osoby, Adresy bez żadnego warunku, otrzymamy tzw. iloczyn kartezjański. Oznacza to, że każda osoba zostanie połączona z każdym adresem, co w praktyce daje ogromny, kompletnie bezsensowny zestaw danych. To jest bardzo częsty błąd początkujących: zapytanie technicznie się wykonuje, ale wynik nie ma żadnego logicznego związku z modelem danych. Drugi problem to łączenie tabel po niewłaściwych kolumnach. Zdarza się założenie, że skoro obie tabele mają kolumnę id, to można je po prostu zrównać w warunku WHERE Osoby.id = Adresy.id. Jest to myślenie intuicyjne, ale błędne z punktu widzenia projektowania relacyjnego. Kolumna id w każdej tabeli jest zwykle osobnym kluczem głównym i nie ma powodu, żeby ich wartości się pokrywały. W poprawnym modelu relacji używa się klucza obcego, tutaj Osoby.Adresy_id, który jawnie wskazuje na Adresy.id. To właśnie te dwie kolumny należy ze sobą powiązać. Kolejna pułapka to mylenie składni JOIN z warunkiem łączenia. Fragment Osoby.Adresy_id = Adresy.id nie może znajdować się w miejscu, gdzie SQL oczekuje listy tabel po FROM albo słowa kluczowego JOIN. To jest wyrażenie logiczne, które powinno znaleźć się w klauzuli ON (w przypadku JOIN) lub w WHERE (w starszym stylu zapisu). Moim zdaniem ważne jest, żeby w głowie rozdzielić trzy elementy: najpierw wymieniamy tabele, które chcemy połączyć, potem określamy typ złączenia (JOIN, LEFT JOIN itd.), a dopiero na końcu definiujemy warunek powiązania ON klucz_obcy = klucz_główny. Jeśli pomieszamy te poziomy, wychodzą dziwne konstrukcje, które są po prostu niezgodne ze składnią SQL. Dobra praktyka branżowa jest taka, że używamy jawnych JOIN-ów z precyzyjnym warunkiem ON i zawsze sprawdzamy, czy łączymy po właściwych kolumnach wynikających z relacji w modelu danych.
Pytanie 40
Do usuwania czego stosuje się w MySQL polecenie TRUNCATETABLE?
A. tabel
B. kolumn
C. baz danych
D. wierszy tabeli
Twoja odpowiedź
Poprawna odpowiedź. Polecenie TRUNCATETABLE usuwa z tabeli WSZYSTKIE wiersze naraz, zostawiając jej strukturę (kolumny, definicję) nienaruszoną. Działa szybciej niż DELETE bez warunku, bo nie kasuje wiersz po wierszu. Dlatego TRUNCATETABLE usuwa wiersze tabeli.