Kwalifikacja: INF.03 - Tworzenie i administrowanie stronami i aplikacjami internetowymi oraz bazami danych
Rozpoczęcie: 17 września 2026 14:19
Zakończenie: 17 września 2026 14:58
Egzamin zdany!
Wynik: 25/40 punktów (62,5%)
Wymagane minimum: 20 punktów (50%)
Twój wynik na tle innych
Twój wynik jest lepszy niż 48% podejść do kwalifikacji INF.03.
Porównanie z 42099 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Program napisany w PHP ma na celu obliczenie średniej pozytywnych ocen ucznia w zakresie od 2 do 6. Warunek selekcji ocen w pętli liczącej średnią powinien zawierać wyrażenie logiczne
A. $ocena >= 2 and $ocena <= 6Twoja odpowiedź
B. $ocena >= 2 or $ocena <= 6
C. $ocena > 2 or $ocena < 6
D. $ocena > 2 and $ocena < 6
Poprawna odpowiedź. Wybór odpowiedzi $ocena >= 2 and $ocena <= 6 jest poprawny, ponieważ precyzyjnie określa zakres, w jakim dopuszczalne są oceny ucznia. Operator logiczny 'and' zapewnia, że obie części warunku muszą być spełnione jednocześnie: ocena musi być większa lub równa 2 oraz mniejsza lub równa 6. Taki sposób definiowania zakresu jest zgodny z dobrymi praktykami programowania, gdzie ważne jest, aby warunki logiki były jednoznaczne i precyzyjne. Dla przykładu, w kontekście obliczania średniej, wykorzystanie tego warunku pozwala na uwzględnienie wszystkich ocen, które są zgodne z regulaminem szkoły, co jest kluczowe dla uzyskania dokładnego wyniku. W praktyce, przy implementacji tego typu logiki w PHP, możemy spotkać się z używaniem podobnych zapytań w kontekście przetwarzania danych uczniów, co podkreśla znaczenie poprawnego definiowania warunków w programach. Dodatkowo, stosowanie takich wyrażeń pozwala na łatwe rozbudowywanie kodu, gdyż łatwo można dodawać nowe warunki lub modyfikować istniejące, co wpisuje się w założenia elastyczności i czytelności kodu.
Pytanie 2
W języku JavaScript, funkcja Math.pow() wykorzystuje się do obliczenia
A. wartości bezwzględnej liczby
B. wartości przybliżonej liczby
C. pierwiastka kwadratowego liczbyTwoja odpowiedź
D. potęgi liczbyPoprawna odpowiedź
Niepoprawna odpowiedź. Wybierając odpowiedzi, które nie są zgodne z funkcją Math.pow(), można popełnić pewne typowe błędy myślowe. Odpowiedź dotycząca wartości bezwzględnej liczby nie ma związku z działania funkcji Math.pow(). Funkcja ta nie jest zaprojektowana do obliczania wartości bezwzględnej, co jest zadaniem funkcji Math.abs(). Wartość bezwzględna to odległość liczby od zera na osi liczbowej, a obliczenia potęgowania nie mają tutaj zastosowania. Z kolei pierwiastek kwadratowy liczy się zupełnie inaczej. Aby obliczyć pierwiastek kwadratowy z liczby, należy użyć funkcji Math.sqrt(), która zwraca liczbę, która podniesiona do kwadratu daje oryginalną liczbę. Zastosowanie Math.pow() do wyznaczenia pierwiastka kwadratowego, na przykład Math.pow(9, 0.5), daje prawidłowy wynik, ale jest mniej klarowne i mniej wydajne niż użycie dedykowanej funkcji. Ostatnia opcja, dotycząca wartości przybliżonej liczby, również jest błędna, ponieważ Math.pow() nie służy do przybliżania wartości, a jedynie do podnoszenia jej do odpowiedniej potęgi. Ważne jest, aby zrozumieć, jakie funkcje są dostępne w JavaScript i jak mają być stosowane w odpowiednich kontekstach, aby uniknąć nieporozumień oraz poprawić czytelność i efektywność kodu w projektach programistycznych.
Pytanie 3
W języku PHP predefiniowana zmienna $_SESSION przechowuje
A. zmienne przesyłane do skryptu przy pomocy ciastek (cookie)
B. zmienne przesyłane do skryptu przez formularz
C. zmienne zarejestrowane w aktualnej sesjiTwoja odpowiedź
D. listę zarejestrowanych sesji na serwerze WWW
Poprawna odpowiedź. Zmienna predefiniowana $_SESSION w języku PHP jest używana do przechowywania zmiennych, które są dostępne w trakcie trwania sesji użytkownika. Sesja pozwala na utrzymanie stanu między różnymi żądaniami HTTP, co jest istotne w aplikacjach webowych, gdzie HTTP jest protokołem bezstanowym. Dzięki $_SESSION, programiści mogą przechowywać dane użytkownika, takie jak identyfikatory, koszyki zakupowe czy inne ustawienia, bez konieczności przesyłania ich za każdym razem przez formularze lub ciasteczka. Przykładem może być sytuacja, w której użytkownik loguje się do serwisu – po zalogowaniu, jego identyfikator sesji jest przechowywany w $_SESSION, co pozwala na identyfikację użytkownika w kolejnych żądaniach. Ważne jest, aby pamiętać o odpowiednim zarządzaniu sesjami, np. poprzez regularne ich odnawianie, a także zabezpieczanie danych przechowywanych w $_SESSION, aby uniknąć ataków takich jak hijacking sesji. Praktyka ta jest zgodna z najlepszymi standardami bezpieczeństwa w programowaniu aplikacji webowych.
Pytanie 4
Który z podanych jest plikiem konfiguracyjnym serwera Apache?
A.
configuration.php
B.
.configuration
C.
htaccess.cnf
D.
.htaccess
Twoja odpowiedź
Poprawna odpowiedź. Plik .htaccess to plik konfiguracyjny serwera Apache działający na poziomie katalogu - umieszczony w folderze zmienia ustawienia Apache dla niego i podkatalogów, bez ruszania głównej konfiguracji. Stosuje się go m.in. do przekierowań i reguł mod_rewrite, ochrony katalogu hasłem czy ustawień stron błędów. Główna, serwerowa konfiguracja Apache mieści się w pliku httpd.conf (lub apache2.conf), ale spośród podanych opcji to .htaccess jest realnym plikiem konfiguracyjnym Apache. Dlatego ta odpowiedź jest poprawna.
Pytanie 5
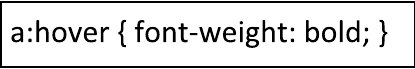
W podanym przykładzie pseudoklasa hover spowoduje, że styl pogrubiony zostanie zastosowany
A. dla każdego odnośnika bez względu na jego aktualny stan
B. dla wszystkich odwiedzonych odnośników
C. dla wszystkich nieodwiedzonych odnośników
D. odnośnikowi, gdy kursor myszy na nim spocznieTwoja odpowiedź
Poprawna odpowiedź. Pseudoklasa hover w CSS jest stosowana do definiowania stylu elementu, gdy użytkownik umieszcza nad nim kursor myszy. W kontekście odnośników, stosowanie pseudoklasy hover pozwala na dynamiczne dostosowywanie ich wyglądu, co jest kluczowe dla poprawy interaktywności i użyteczności stron internetowych. W przykładzie a:hover { font-weight: bold; } styl pogrubiony zostanie zastosowany do odnośnika, gdy użytkownik najedzie na niego kursorem myszy. Jest to częsta praktyka w projektowaniu stron, która pomaga użytkownikom łatwiej identyfikować aktywne elementy nawigacyjne. Standardy sieciowe, takie jak W3C, rekomendują stosowanie takich interakcji w celu poprawy doświadczenia użytkownika. Praktyczne zastosowanie pseudoklasy hover jest szerokie, od prostych efektów wizualnych, po skomplikowane animacje i przejścia. Ważne jest jednak, aby pamiętać o zapewnieniu alternatywnych metod interakcji dla użytkowników korzystających z urządzeń dotykowych, gdzie hover nie jest obsługiwany. Zrozumienie i właściwe stosowanie pseudoklas w CSS jest podstawą tworzenia nowoczesnych i dostępnych interfejsów użytkownika.
Pytanie 6
Jak nazywa się mechanizm, dzięki któremu klasa pochodna przejmuje pola i metody klasy bazowej?
A. polimorfizmem
B. dziedziczeniemTwoja odpowiedź
C. hermetyzacją
D. wirtualizacją
Poprawna odpowiedź. Mechanizm, dzięki któremu klasa pochodna (potomna) przejmuje pola i metody klasy bazowej, nazywa się DZIEDZICZENIEM. Pozwala wielokrotnie wykorzystać i rozszerzać istniejący kod. Dlatego to dziedziczenie.
Pytanie 7
Według którego parametru oraz dla ilu tabel zostaną zwrócone wiersze na liście w wyniku przedstawionego zapytania?
SELECT * FROM producent, hurtownia, sklep, serwis WHERE producent.nr_id = hurtownia.nr_id AND producent.wyrob_id = serwis.wyrob_id AND hurtownia.nr_id = sklep.nr_id AND sklep.nr_id = serwis.nr_id AND producent.nr_id = 1;
A. Według parametru wyrób id dla wszystkich tabel.
B. Według parametru nr id wyłącznie dla trzech tabel.
C. Według parametru nr id dla wszystkich tabel.Twoja odpowiedź
D. Według parametru wyrób Jd wyłącznie dla trzech tabel.
Poprawna odpowiedź. Brawo! Wybrałeś poprawną odpowiedź, zgodnie z którą parametrem nr id zwraca wiersze dla wszystkich tabel. To zapytanie SQL odnosi się do czterech tabel: producent, hurtownia, sklep i serwis. Zwraca ono wiersze, gdzie wartość kolumny nr_id jest taka sama we wszystkich tych tabelach i równa 1. Dodatkowo, jakość danych jest wspierana przez fakt, że zapytanie sprawdza zgodność wartości kolumny wyrob_id między tabelami producent i serwis. Zrozumienie tego, jak działa to zapytanie i dlaczego to jest ważne, jest kluczowe w praktyce programistycznej. Zapewnia to, że możemy skutecznie i efektywnie manipulować danymi, a także zrozumieć, jak nasze zapytania wpływają na wyniki, które otrzymujemy. Dobra praktyka jest zawsze zrozumienie, jakie dane są zwracane przez nasze zapytanie, zanim zaczniemy z nich korzystać w naszym kodzie. Ostatecznie, zrozumienie, jak korzystać z zapytań SQL do manipulacji i odzyskiwania danych, jest kluczowym elementem dowolnej roli programistycznej.
Pytanie 8
Aby zmienić wartość atrybutu elementu opisanego w CSS przy użyciu skryptu JavaScript, należy zastosować następujący zapis
A. document.getElementById(id).<nazwa-atrybutu> = <nowa wartość>Twoja odpowiedź
B. document.getElementById(id).<nazwa właściwości> = <nowa wartość>
C. document.getElementById(id).style.<nazwa właściwości> = <nowa wartość>Poprawna odpowiedź
D. document.getElementById(id).innerHTML = <nowa wartość>
Niepoprawna odpowiedź. Odpowiedzi, które nie zawierają poprawnego odniesienia do właściwości style, wskazują na istotne nieporozumienia dotyczące manipulacji elementami DOM w JavaScript. Użycie document.getElementById(id).innerHTML = <nowa wartość>; nie jest odpowiednie do zmiany elementów stylu, ponieważ innerHTML służy do modyfikacji zawartości HTML wewnątrz elementu, a nie jego stylów. Zmiana zawartości może prowadzić do nadpisania istniejących elementów i wprowadzenia niezamierzonych skutków, takich jak utrata zdarzeń przypisanych do tych elementów. Kolejny błąd tkwi w użyciu document.getElementById(id).<nazwa właściwości> = <nowa wartość>; gdzie <nazwa właściwości> może odnosić się do atrybutów DOM, ale nie do właściwości stylu CSS. Na przykład, ustawienie document.getElementById(id).className = 'newClass'; zmieni klasę CSS elementu, ale nie bezpośrednio jego styl. Ostatnia propozycja, document.getElementById(id).<nazwa-atrybutu> = <nowa wartość>; jest również myląca, ponieważ nie odnosi się do modyfikacji stylów, lecz do manipulacji atrybutami HTML, co może prowadzić do nieprawidłowego działania strony. Zrozumienie zasadniczej różnicy między manipulowaniem treścią a stylem, a także umiejętność właściwego korzystania z DOM, są kluczowe dla skutecznego programowania w JavaScript.
Pytanie 9
Reprezentacja znacznika HTML w formacie
<a href="#hobby">przejdź</a>
A. jest poprawny, po kliknięciu w odnośnik otworzy się strona internetowa o URL "hobby"
B. jest błędny, użyto niewłaściwego znaku "#" w atrybucie href
C. jest poprawny, po kliknięciu w odnośnik strona zostanie przewinięta do sekcji o nazwie "hobby"Twoja odpowiedź
D. jest błędny, w atrybucie href należy wpisać adres URL
Poprawna odpowiedź. Zapis znacznika HTML przedstawiony w pytaniu jest poprawny i spełnia standardy języka HTML. Użycie elementu <a> z atrybutem href i wartością #hobby oznacza, że użytkownik po kliknięciu w ten link zostanie przewinięty do sekcji na stronie, która ma przypisany identyfikator "hobby". Takie podejście jest zgodne z dobrymi praktykami w projektowaniu stron internetowych, umożliwiając tworzenie nawigacji wewnętrznej. Warto zaznaczyć, że użycie znaku hash (#) w atrybucie href wskazuje na lokalizację w obrębie tej samej strony. To jest powszechnie stosowane w przypadkach, gdy chcemy ułatwić użytkownikom dostęp do różnych sekcji na tej samej stronie, bez konieczności ładowania nowej strony. Przykładem zastosowania może być strona z długim artykułem, gdzie linki do poszczególnych nagłówków ułatwiają orientację czytelników. Oprócz tego, korzystając z takiej struktury, możemy również poprawić doświadczenia użytkowników oraz zwiększyć efektywność SEO, ponieważ wyszukiwarki są w stanie lepiej zrozumieć organizację treści na stronie.
Pytanie 10
Który typ danych obsługiwany przez PHP jest przeznaczony do obsługi zmiennych typu logicznego?
A. String
B. FloatTwoja odpowiedź
C. BooleanPoprawna odpowiedź
D. Integer
Niepoprawna odpowiedź. Typy Float, Integer oraz String nie są odpowiednie do przechowywania informacji logicznych. Float reprezentuje liczby zmiennoprzecinkowe, co oznacza, że przechowuje dane numeryczne z częścią dziesiętną. Używanie typu float do logiki programistycznej może prowadzić do nieścisłości, ponieważ nie potrafi on właściwie reprezentować wartości logicznych, takich jak prawda czy fałsz. Z kolei Integer to typ całkowity, który również nie ma zastosowania w kontekście zmiennych logicznych. Przechowuje tylko liczby całkowite, a jego użycie w decyzjach logicznych może prowadzić do błędnych interpretacji, gdyż wartości całkowite nie są bezpośrednio związane z pojęciem prawdy i fałszu. String, będący typem reprezentującym dane tekstowe, również nie jest odpowiedni do tego celu. Choć można konwertować ciągi tekstowe na zmienne logiczne, takie jak poprzez interpretację 'true' jako prawdy i 'false' jako fałszu, nie jest to efektywne ani zalecane w praktyce ze względu na możliwość wystąpienia błędów. W programowaniu ważne jest, aby stosować odpowiednie typy danych, co zwiększa czytelność oraz jakość kodu, a także ułatwia jego utrzymanie. Prawidłowe stosowanie typów danych, w tym boolean, jest kluczowe dla tworzenia efektywnych i błędoodpornych aplikacji.
W tabeli klient o polach: id, imie, nazwisko, miejscowosc znajduje się 5 rekordów o id od 1 do 5. Dla których wartości kolumny id przedstawiona kwerenda zaktualizuje zawartość pola miejscowosc na Warszawa?
A. 3
B. 2, 3, 4Twoja odpowiedź
C. 2, 4Poprawna odpowiedź
D. 1, 5
Niepoprawna odpowiedź. W tym zadaniu kluczowe jest dokładne zrozumienie, jak działa klauzula WHERE w instrukcji UPDATE oraz jak interpretować zapis z operatorem IN. Konstrukcja `UPDATE klient SET miejscowosc='Warszawa' WHERE id IN(2,4);` nie wybiera „jakichś tam” rekordów losowo ani nie aktualizuje wszystkich wierszy, tylko bardzo konkretną podgrupę danych. Warunek `id IN (2,4)` jest równoważny zapisowi `id = 2 OR id = 4`. To oznacza, że silnik bazy danych przechodzi po rekordach i sprawdza: jeśli id danego rekordu jest równe 2 lub 4, to ustawia miejscowosc na 'Warszawa'. Jeśli id ma inną wartość, rekord jest pomijany. Częsty błąd myślowy polega na tym, że ktoś skupia się na liczbie rekordów w tabeli (tu: 5 wierszy o id 1–5) i próbuje dopasować odpowiedź na zasadzie „a może chodzi o środkowy”, „a może o wszystkie poza tymi z listy” albo „może IN działa jak jakiś zakres”. To złe podejście. Operator IN nie oznacza przedziału, tylko dokładną listę dopuszczalnych wartości. Jeżeli na przykład ktoś uznał, że zaktualizowany zostanie tylko rekord o id=3, to najpewniej zignorował treść warunku lub pomylił IN z BETWEEN. Podobnie wybieranie pary 1,5 czy trójki 2,3,4 sugeruje, że myśli się raczej o odcinku lub o „skrajnych” identyfikatorach, a nie o literalnie podanych liczbach wewnątrz nawiasu. W SQL, gdy chcemy objąć zakresem wszystkie id od 2 do 4, używamy `WHERE id BETWEEN 2 AND 4`, a nie `IN(2,4)`. Warto też utrwalić sobie, że brak dopasowania do warunku WHERE oznacza brak jakiejkolwiek zmiany w danym wierszu, więc rekordy o id 1, 3 i 5 pozostaną nietknięte. Dobra praktyka w pracy z bazami danych to zawsze czytanie warunku WHERE „na głos” i zastanowienie się, jakie dokładnie wartości są dopuszczone. Pozwala to uniknąć groźnych pomyłek, kiedy przypadkowo zmienilibyśmy zbyt wiele danych lub zupełnie nie te rekordy, które planowaliśmy edytować.
Pytanie 12
Aby walidować pole formularza na bieżąco, w trakcie wpisywania znaków przez użytkownika, można wykorzystać zdarzenie:
A.
onClick
B.
onLoad
C.
onKeyDown
Twoja odpowiedź
D.
onFocusOut
Poprawna odpowiedź. Aby reagować na dane w trakcie ich wpisywania, używa się zdarzeń klawiatury, takich jak onKeyDown (lub onInput), które zachodzą przy każdym naciśnięciu klawisza. Dzięki temu skrypt może sprawdzać poprawność pola na bieżąco i od razu informować użytkownika o błędzie. Dlatego do walidacji podczas pisania nadaje się onKeyDown.
Pytanie 13
Który operator w PHP oznacza sumę logiczną (logiczne LUB)?
A.
+
B.
&&
Twoja odpowiedź
C.
||
Poprawna odpowiedź
D.
!
Niepoprawna odpowiedź. Pozostałe operatory oznaczają co innego. && to iloczyn logiczny (logiczne ORAZ) - wymaga obu warunków, czyli przeciwieństwo „lub”. ! to NEGACJA (odwraca wartość logiczną). + to dodawanie arytmetyczne. Sumę logiczną daje ||.
Pytanie 14
Aby poprawić wydajność strony z grafiką o wymiarach 2000 px na 760 px, konieczne jest zmniejszenie jej rozmiarów
A. za pomocą właściwości CSS, podając rozmiar w procentach
B. w programie graficznymTwoja odpowiedź
C. za pomocą właściwości CSS, podając rozmiar w pikselach
D. za pomocą atrybutów HTML
Poprawna odpowiedź. Odpowiedź "w programie graficznym" jest prawidłowa, ponieważ zmniejszenie rozmiaru grafiki w sposób, który rzeczywiście wpływa na jej wielkość pliku oraz jakość wizualną, powinno być przeprowadzane w programie graficznym. Programy takie jak Adobe Photoshop, GIMP czy Canva umożliwiają precyzyjne dostosowanie wymiarów oraz kompresję grafiki, co pozwala na optymalizację jej do użytku w internecie. Przykładowo, zmieniając rozmiar grafiki do wymiarów 1000 px na 380 px i zapisując ją w odpowiednim formacie (np. JPEG lub PNG z odpowiednią jakością), można znacznie zmniejszyć wielkość pliku, co przyczyni się do szybszego ładowania strony. Ponadto, odpowiednia kompresja umożliwia zachowanie dobrego balansu między jakością a rozmiarem pliku, co jest istotne dla doświadczeń użytkowników. W branży internetowej stosuje się różne techniki optymalizacji grafiki, takie jak lazy loading czy formaty WebP, które wspierają szybkie ładowanie stron. Warto również zwrócić uwagę na znaczenie odpowiedniej rozdzielczości grafiki, aby uniknąć zniekształceń i zapewnić optymalną jakość wizualną.
Pytanie 15
Co zwraca funkcja mysqli_query() po pomyślnym wykonaniu zapytania SELECT?
A. zawsze wartość true
B. nazwę odpytywanej tabeli
C. zbiór wynikowy (rekordy do odczytania)Twoja odpowiedź
D. liczbę usuniętych wierszy
Poprawna odpowiedź. Funkcja mysqli_query() wykonuje zapytanie i przy zapytaniu zwracającym dane (np. SELECT) zwraca zbiór wynikowy - obiekt wyniku. Z niego pobiera się kolejne wiersze, np. funkcją mysqli_fetch_assoc() w pętli. Dla zapytań bez wyniku (jak INSERT) zwraca true, a przy błędzie false. Dlatego dla SELECT zwraca zbiór wynikowy.
Pytanie 16
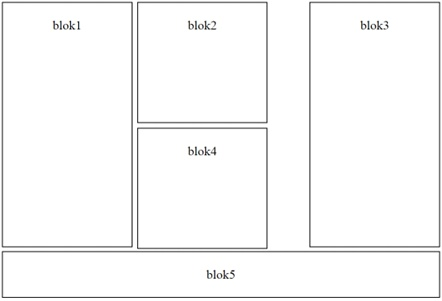
Na przedstawionej grafice znajduje się struktura sekcji dla witryny internetowej. Przyjmując, że blok5 nie ma przypisanej szerokości, a bloki są określone w dokumencie HTML w kolejności ich numeracji, jak powinno wyglądać zdefiniowanie opływania?
Poprawna odpowiedź. Odpowiedź 3 jest poprawna, ponieważ odpowiada układowi bloków na stronie i ich pozycjonowaniu. Użycie właściwości CSS float: left; dla bloków 1, 2 i 4 pozwala im ułożyć się w linii po lewej stronie. Blok 3 z float: right; zostanie umieszczony po prawej stronie, co jest zgodne z przedstawionym układem. Blok 5 natomiast, znajdujący się na dole i rozciągający się na całą szerokość, wymaga użycia clear: both;, aby nie opływały go inne bloki i mógł zająć całą dostępną przestrzeń poziomą. Takie zastosowanie float i clear jest zgodne z najlepszymi praktykami w projektowaniu układów stron internetowych. Stylowanie za pomocą float jest powszechnie używane w CSS do tworzenia dynamicznych układów, a właściwość clear zapewnia, że element nie będzie opływany przez poprzedzające elementy pływające, co jest szczególnie istotne dla elementów podsumowujących lub końcowych na stronie.
Pytanie 17
Poniżej przedstawiono fragment kodu języka HTML. Jest on definicją listy:
Niepoprawna odpowiedź. Twoja odpowiedź niestety nie była prawidłowa. Kluczową częścią zadania była interpretacja struktury kodu HTML prezentującej listę numerowaną (<ol>) z trzema elementami listy (<li>). W szczególności, zwróć uwagę na to, że w drugim elemencie listy znajduje się zagnieżdżona lista nieuporządkowana (<ul>) z trzema podpunktami. Fakt, że podpunkty są oznaczone kropkami, jest charakterystyczny dla listy nieuporządkowanej, co sugerowało, że prawidłową odpowiedzią jest C. W przypadku innych odpowiedzi, nie odzwierciedlały one prawidłowo struktury przedstawionego kodu, co mogło wynikać z niezrozumienia znaczenia poszczególnych tagów HTML. Pamiętaj, że w HTML istotne jest zrozumienie, jak tagi są zagnieżdżone w sobie, tworząc strukturę strony. Przy dalszej nauce zwracaj uwagę na to, jak poszczególne elementy HTML są ze sobą powiązane.
Pytanie 18
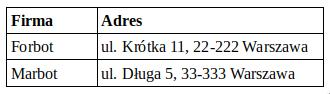
Jakie informacje można uzyskać na temat normalizacji tej tabeli?
A. Tabela znajduje się w trzeciej postaci normalnej
B. Tabela znajduje się w pierwszej postaci normalnejTwoja odpowiedź
C. Tabela nie jest znormalizowanaPoprawna odpowiedź
D. Tabela jest w drugiej postaci normalnej
Niepoprawna odpowiedź. Tabela przedstawiona w pytaniu nie spełnia wymogów żadnej z trzech podstawowych postaci normalnych co oznacza że nie jest znormalizowana. Pierwsza postać normalna wymaga aby wszystkie wartości w tabeli były atomowe co oznacza że kolumna Adres powinna być podzielona na kilka kolumn takich jak ulica miasto i kod pocztowy. Druga postać normalna wymaga że wszystkie atrybuty niekluczowe muszą być deterministycznie zależne od całego klucza głównego co w tym przypadku nie ma zastosowania ponieważ tabela zawiera tylko dwa atrybuty i brak jest klucza złożonego. Trzecia postać normalna eliminuje wszelkie przejściowe zależności funkcyjne pomiędzy atrybutami niekluczowymi co również nie ma zastosowania w tej prostej strukturze. Typowe błędy myślowe prowadzące do niewłaściwych wniosków mogą obejmować niepełne zrozumienie zasad atomowości danych oraz błędne założenie że nieskomplikowana struktura tabeli automatycznie spełnia zasady normalizacji. Dlatego kluczowe jest aby dokładnie rozumieć i identyfikować zależności między danymi oraz jak te zależności wpływają na integralność i efektywność bazy danych co jest szczególnie istotne w dużych systemach gdzie dane są intensywnie modyfikowane i wykorzystywane przez wiele aplikacji jednocześnie. Właściwa normalizacja pozwala na optymalizację czasu dostępu do danych oraz minimalizację redundancji co jest uznawane za dobrą praktykę w branży projektowania baz danych. W kontekście projektowania systemów informatycznych poprawna normalizacja jest nieodłącznym elementem cyklu życia projektu zapewniającym że struktura danych jest odporna na zmiany w wymaganiach użytkowników oraz skalowalna w przypadku wzrostu ilości danych do obsługi przez system. Dlatego zrozumienie i prawidłowe stosowanie zasad normalizacji jest kluczowe dla przyszłych profesjonalistów w dziedzinie IT którzy będą odpowiedzialni za projektowanie i utrzymanie złożonych systemów bazodanowych.
Pytanie 19
Jaką funkcję pełni atrybut name w polu formularza, np. <inputtype="text"name="login">?
A. ogranicza maksymalną długość pola
B. określa nazwę pola, pod którą dane trafiają na serwerTwoja odpowiedź
C. określa wartość domyślną pola
D. ustawia pole jako tylko do odczytu
Poprawna odpowiedź. Atrybut name nadaje polu formularza nazwę, pod którą jego wartość jest przesyłana na serwer. To po niej skrypt odbierający (np. w PHP przez $_POST["login"]) rozpoznaje konkretne pole. Bez name wartość pola zwykle nie zostanie wysłana. Dlatego name określa nazwę pola w formularzu.
Pytanie 20
Którego znacznika użyć do sekcji cytatu (mogącej zawierać kilka akapitów, z wcięciem)?
A.
<q>
B.
<blockquote>
Poprawna odpowiedź
C.
<indent>
Twoja odpowiedź
D.
<blockq>
Niepoprawna odpowiedź. Pozostałe znaczniki nie pasują. <q> to cytat KRÓTKI, liniowy (otaczany cudzysłowami w tekście), nie blok z akapitami. <indent> i <blockq> w HTML nie istnieją. Dłuższy cytat z wcięciem to <blockquote>.
Pytanie 21
Z jakich elementów składa się tabela generowana przez poniższy kod?
D. jednego wiersza oraz dwóch kolumnTwoja odpowiedź
Poprawna odpowiedź. Kod w pytaniu przedstawia strukturę HTML dla tabeli. Tabela składa się z jednej pary znaczników <tr>, co oznacza, że zawiera jeden wiersz. Wewnątrz tego wiersza znajdują się dwa znaczniki <td>, reprezentujące dwie komórki, czyli kolumny. Praktyczne zastosowanie tabel w HTML obejmuje prezentację danych w sposób strukturalny, co jest szczególnie użyteczne w przypadku raportów, cenników czy kalendarzy. Dobre praktyki w projektowaniu stron internetowych sugerują stosowanie tabel do prezentacji danych, nie zaś do układania treści na stronie, co było popularne w starszych wersjach HTML. W nowoczesnym podejściu do front-endu, używa się CSS i Flexbox lub Grid do układania elementów. Jednak zrozumienie podstaw HTML, takich jak prawidłowa struktura tabeli, jest kluczowe dla tworzenia semantycznych i dostępnych stron WWW. Tabele powinny być też wzbogacone o elementy takie jak <thead>, <tbody> i <tfoot> dla lepszej organizacji danych i wsparcia przez technologie asystujące dla osób z niepełnosprawnościami.
Pytanie 22
Przedstawiony kod PHP nawiązuje połączenie z serwerem bazy danych. Jakiego typu operacje powinny się znaleźć w instrukcji warunkowej w miejscu trzech kropek?
B. Informacja o pomyślnym nawiązaniu połączenia z baząTwoja odpowiedź
C. Obsługa błędu przy nawiązywaniu połączeniaPoprawna odpowiedź
D. Przetwarzanie danych uzyskanych z bazy
Niepoprawna odpowiedź. Zamknięcie bazy danych w kontekście nawiązywania połączenia z bazą danych nie ma sensu, ponieważ w momencie, gdy kod wykonuje sprawdzenie połączenia, to takie połączenie nie zostało jeszcze nawiązane. Próba zamknięcia niezainicjowanego połączenia nie tylko nie przyniesie żadnego efektu, ale także może prowadzić do mylnych wniosków dotyczących kodu. Ponadto, zachowanie takie może wprowadzać w błąd, sugerując, że operacje na bazie danych mogłyby być przeprowadzone w tym momencie, co jest nieprawdziwe. Obsługa danych pobranych z bazy również nie jest właściwym podejściem w momencie, gdy połączenie nie zostało jeszcze ustanowione - przed przetwarzaniem jakichkolwiek danych, najpierw musimy upewnić się, że połączenie jest aktywne. Natomiast komunikat o pomyślnym połączeniu z bazą nie powinien być używany w instrukcji warunkowej, gdyż działa on na zasadzie potwierdzenia, a nie na detekcji błędów. Ważne jest, aby zrozumieć, że każda z tych odpowiedzi nie odpowiada na istotę problemu - w przypadku problemów z połączeniem zwłaszcza w aplikacjach produkcyjnych, brak odpowiedniego komunikatu o błędzie może prowadzić do poważnych trudności w diagnozowaniu i naprawie problemów, co może wpływać na całkowitą funkcjonalność systemu oraz jego niezawodność.
Pytanie 23
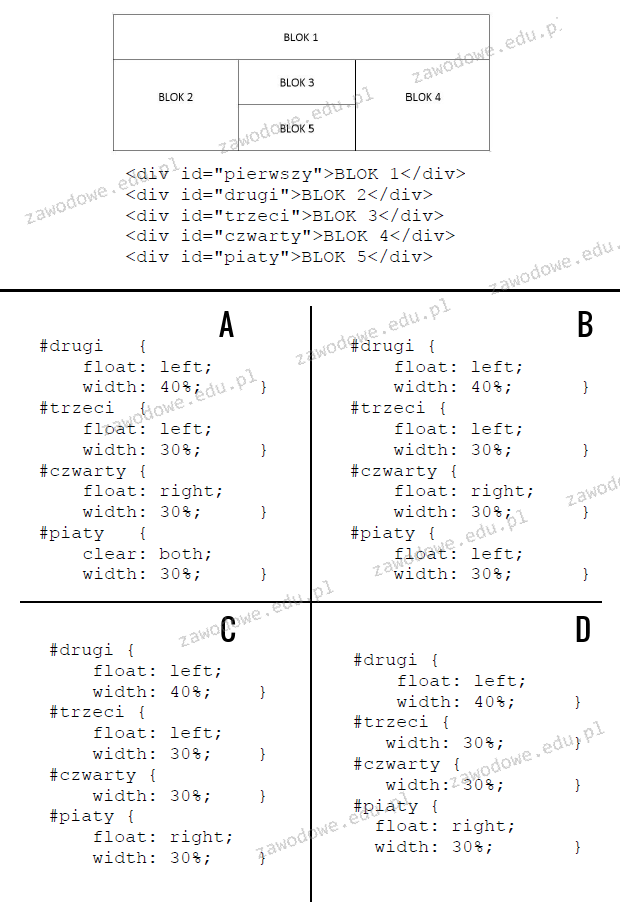
Wskaż fragment kodu CSS, który odpowiada układowi bloków 2 - 5, zakładając, że są one oparte na poniższym kodzie HTML.
A. C
B. ATwoja odpowiedź
C. D
D. BPoprawna odpowiedź
Niepoprawna odpowiedź. Niepoprawne odpowiedzi często wynikają z błędnego zrozumienia działania właściwości float oraz szerokości elementów w układzie blokowym. Float jest potężnym narzędziem które pozwala na pływające rozmieszczenie elementów ale wymaga precyzyjnego planowania aby uniknąć niepożądanych efektów takich jak elementy wychodzące poza przewidywane miejsca. Przy wyborze błędnych odpowiedzi można zauważyć że nieodpowiednie użycie float może prowadzić do nieprawidłowego wyświetlania bloków. Na przykład brak odpowiedniego ustawienia float left lub right dla niektórych bloków może skutkować ich przesunięciem poza zamierzony układ. Dodatkowo nieprawidłowe zarządzanie szerokością bloków może spowodować że układ przekroczy dostępny obszar wyświetlania co szczególnie jest problematyczne w responsywnym projektowaniu stron. Typowym błędem jest również brak uwzględnienia clearfix co może prowadzić do nieprawidłowego przepływu kolejnych elementów w układzie. Zrozumienie jak float wpływa na otaczające elementy oraz jak kontrolować szerokość i przepływ elementów jest kluczowe w tworzeniu stabilnych i przewidywalnych układów stron internetowych. Poprawne zastosowanie tych zasad jest kluczowe dla zgodnego z dobrymi praktykami projektowania stron które są nie tylko estetyczne ale i funkcjonalne w różnych kontekstach urządzeń i środowisk użytkownika.
Pytanie 24
Definicja formularza została wykorzystana na stronie www, która przesyła dane do pliku w języku PHP. W której tablicy będą dostępne informacje z formularza?
<formaction="plik.php"method="post">
A. $_POSTTwoja odpowiedź
B. $_ACTION
C. $_COOKIE
D. $_GET
Poprawna odpowiedź. Formularze w HTML służą do przesyłania danych do serwera, a w kontekście języka PHP dane te są dostępne poprzez różne superglobalne tablice, z których najczęściej używaną przy metodzie POST jest tablica $_POST. Metoda POST, określona w atrybucie 'method' formularza, jest używana do przesyłania danych w bardziej bezpieczny sposób niż metoda GET, ponieważ nie pokazuje przesyłanych informacji w URL. Kiedy dane są wysyłane do skryptu PHP z formularza, wszystkie klucze i wartości formularza stają się dostępne jako elementy tablicy $_POST. Przykładowo, jeśli w formularzu znajduje się pole tekstowe o nazwie 'username', po wysłaniu formularza na stronie 'plik.php' można uzyskać dostęp do wartości tego pola za pomocą $_POST['username']. Ta metoda jest zalecana w przypadku przesyłania danych poufnych, takich jak hasła, ponieważ nie są one widoczne w pasku adresu przeglądarki. Dodatkowo, korzystając z $_POST, można przesyłać dane o większej objętości, co jest niemożliwe w przypadku $_GET, który ma ograniczenia długości URL.
Pytanie 25
Która z pętli w PHP umożliwia przeprowadzenie operacji na wszystkich elementach tablicy z automatycznym przypisaniem indeksów tych elementów?
A. while
B. foreachTwoja odpowiedź
C. do...while
D. for
Poprawna odpowiedź. Odpowiedź 'foreach' jest poprawna, ponieważ ta konstrukcja w języku PHP została stworzona specjalnie do iteracji po elementach tablicy. Zastosowanie 'foreach' pozwala na komfortowe i czytelne przeglądanie każdego elementu tablicy bez potrzeby ręcznego zarządzania indeksami, co jest szczególnie przydatne w przypadku tablic asocjacyjnych, gdzie klucze mogą być dowolnymi typami danych. Przykład zastosowania 'foreach': dla tablicy $fruits = ['jabłko', 'banan', 'gruszka']; używamy pętli: foreach ($fruits as $fruit) { echo $fruit; } To pozwala na wypisanie każdego owocu w tablicy. Warto również podkreślić, że 'foreach' jest bardziej wydajny i bardziej intuicyjny niż inne pętle, takie jak 'for' czy 'while', które wymagają dodatkowego zarządzania indeksami. W praktyce, 'foreach' jest standardem w iteracji tablic w PHP i jego użycie jest zgodne z najlepszymi praktykami programistycznymi.
Pytanie 26
Którym poleceniem w MySQL wyświetli się listę uprawnień nadanych użytkownikowi anna?
A.
GRANT*TOanna;
B.
REVOKEGRANTSFROManna;
C.
SELECTGRANTSFORanna;
D.
SHOWGRANTSFORanna;
Twoja odpowiedź
Poprawna odpowiedź. Listę uprawnień nadanych użytkownikowi wyświetla w MySQL polecenie SHOWGRANTSFORanna; - zwraca zestaw poleceń GRANT opisujących jego prawa. Używa się go np. do audytu, kto i co może robić w bazie. Dlatego poprawne jest SHOWGRANTSFORanna;.
Pytanie 27
Fragment kwerendy SQL zaprezentowany w ramce ma na celu uzyskanie
SELECT COUNT(wartosc) FROM ...
A. średnią wartość w kolumnie wartosc.
B. sumę wartości w kolumnie wartosc.Twoja odpowiedź
C. liczbę kolumn.
D. liczbę wierszy.Poprawna odpowiedź
Niepoprawna odpowiedź. SELECT COUNT(wartosc) w zapytaniu SQL jest często mylone z innymi funkcjami agregującymi, co może prowadzić do nieporozumień dotyczących jego działania. COUNT jest specyficznie zaprojektowany do zliczania niepustych wartości w określonej kolumnie, dlatego nie jest używany do obliczania sumy czy średniej wartości. Suma w kolumnie wartosc wymagałaby użycia funkcji SUM(wartosc), która zlicza wartości liczbowe. Z kolei obliczanie średniej wartości w kolumnie wymagałoby zastosowania funkcji AVG(wartosc), która dzieli sumę wartości przez liczbę niepustych wierszy. Mylenie tych funkcji może prowadzić do błędnych interpretacji danych i niepoprawnych wyników, co jest kluczowe w środowisku biznesowym, gdzie precyzja i dokładność są niezbędne. Warto zauważyć, że zrozumienie różnic w działaniu funkcji agregujących jest fundamentalne dla efektywnej analizy danych. Stosowanie odpowiednich funkcji pozwala na optymalizację zapytań oraz zapewnia, że uzyskane wyniki są zgodne z oczekiwaniami analitycznymi, co jest kluczowe w podejmowaniu decyzji opartych na danych.
Pytanie 28
Określ wynik wykonania poniższego fragmentu kodu JavaScript.
A. Dodanie akapitu na samym końcu stronyTwoja odpowiedź
B. Wstawienie akapitu na początku strony
C. Wyświetlenie okna dialogowego z komunikatem "akapit"
D. Usunięcie akapitu z treści strony
Poprawna odpowiedź. Kod JavaScript, który tutaj widzisz, tworzy nowy element paragrafu (p) przy użyciu metody createElement. Potem ten nowy element dodaje się do dokumentu na końcu, przez appendChild do body. To wszystko dotyczy manipulacji DOM, co jest kluczowe w JavaScript. Zrozumienie tych operacji to naprawdę ważna sprawa, bo pozwala na tworzenie dynamicznych, interaktywnych stron internetowych. Dzięki createElement można w czasie rzeczywistym generować nowe elementy HTML, a appendChild pozwala je umieścić w wybranym miejscu na stronie. To są praktyki, które są standardem w dobrym kodowaniu i często wykorzystuje się je w nowoczesnych aplikacjach webowych. Manipulacja DOM to podstawowy temat w technologiach front-endowych i pozwala na zmiany w treści stron bez ich przeładowywania. Kiedy dobrze rozumiesz te techniki, możesz budować bardziej responsywne aplikacje, co teraz jest normą w branży.
Pytanie 29
Język HTML posiada nagłówki, które służą do tworzenia hierarchii treści. Nagłówki te występują tylko w zakresie
A. h1 – h8
B. h1 – h4
C. h1 – h6Twoja odpowiedź
D. h1 – h10
Poprawna odpowiedź. Odpowiedź h1 – h6 jest poprawna, ponieważ język HTML udostępnia sześć poziomów nagłówków, od h1 do h6, które służą do tworzenia hierarchii treści na stronie internetowej. Nagłówek h1 jest najważniejszy i powinien być używany do oznaczenia głównego tytułu strony, podczas gdy h2, h3, h4, h5 i h6 wskazują na kolejne poziomy nagłówków, które pomagają w organizacji treści. Przykładowo, nagłówek h2 może być używany do sekcji, natomiast h3 może oznaczać podsekcje w ramach danej sekcji. Używanie nagłówków w ten sposób nie tylko poprawia czytelność i zrozumienie treści przez użytkowników, ale także pozytywnie wpływa na SEO (optymalizację dla wyszukiwarek). Warto pamiętać, że zgodnie z najlepszymi praktykami, powinno się unikać pomijania poziomów nagłówków, co zapewnia logiczną strukturę treści i ułatwia indeksację przez roboty wyszukiwarek.
Pytanie 30
Do utworzenia czego niezbędne jest zdefiniowanie klucza obcego?
A. relacji jeden-do-jednego (1..1)
B. klucza podstawowego
C. transakcji
D. relacji jeden-do-wielu (1..n)Twoja odpowiedź
Poprawna odpowiedź. Klucz obcy jest niezbędny do utworzenia relacji jeden-do-wielu (1..n) - to on, umieszczony po stronie „wielu”, wskazuje klucz główny tabeli po stronie „jeden”. Dlatego klucz obcy potrzebny jest do relacji 1..n.
Pytanie 31
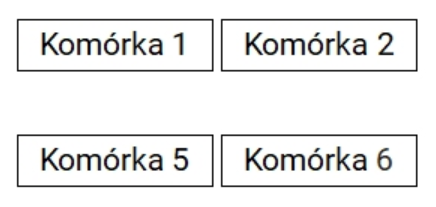
Przedstawiono kod tabeli 3x2. Której z modyfikacji w jej drugim wierszu należy dokonać, aby tabela wyglądała jak na obrazku z niewidocznym wierszem?
Poprawna odpowiedź. Na obrazku drugi wiersz jest niewidoczny, ale zostało po nim puste miejsce – między wierszem z komórkami 1 i 2 a wierszem z komórkami 5 i 6 widać wyraźną lukę. Dokładnie tak działa visibility: hidden: element przestaje być widoczny, lecz nadal zajmuje swoje miejsce w układzie, więc nic się nie przesuwa. Reguła do zapamiętania: visibility steruje samą widocznością, a display decyduje o tym, czy element w ogóle bierze udział w przepływie dokumentu. Stąd prosty sposób rozpoznania na egzaminie: jeśli po ukryciu zostaje pusta przestrzeń, to visibility: hidden; jeśli sąsiednie elementy przesuwają się na zwolnione miejsce, to display: none. Ta sama różnica dotyczy nie tylko wierszy tabeli, ale każdego elementu HTML.
A. nazwy miast bez powtórzeń oraz sumę pensji dla każdego z nich.
B. nazwy miast z powtórzeniami oraz średnią pensję dla każdego z nich.Twoja odpowiedź
C. nazwy miast bez powtórzeń oraz średnią pensję dla każdego z nich.Poprawna odpowiedź
D. nazwy miast z powtórzeniami oraz sumę pensji dla każdego z nich.
Niepoprawna odpowiedź. Zapytanie z klauzulą GROUP BY i funkcją AVG bywa mylone z sumowaniem danych lub zwykłym wybieraniem rekordów jeden po drugim. W tym konkretnym przypadku bardzo łatwo pomylić średnią z sumą albo nie zauważyć, że grupowanie usuwa powtórzenia wartości w kolumnie grupującej. Warto to uporządkować. Funkcja AVG(pensja) jest klasyczną funkcją agregującą, której zadaniem jest obliczenie średniej arytmetycznej z wartości w danej grupie rekordów. Nie dodaje ona wszystkich pensji „na kupę” tak jak SUM, tylko dzieli ich sumę przez liczbę rekordów w grupie. Jeżeli ktoś spodziewa się sumy, to patrzy bardziej w stronę SUM(pensja), a nie AVG(pensja). To jest typowy błąd: widzimy funkcję agregującą i automatycznie myślimy „to pewnie suma”, bez dokładnego przeczytania nazwy funkcji. Druga kwestia to powtórzenia miast. Klauzula GROUP BY miasto mówi silnikowi bazy danych: pogrupuj wszystkie wiersze według wartości w kolumnie miasto. W efekcie wszystkie rekordy z tym samym miastem są łączone w jedną grupę. Dla każdej takiej grupy zwracany jest dokładnie jeden wiersz wyniku. To oznacza, że w rezultacie zapytania nie ma powtórzonych nazw miast, nawet jeśli w tabeli jest tysiąc pracowników z Warszawy czy Krakowa. Częsty błąd myślowy polega na przenoszeniu intuicji z prostego SELECT bez GROUP BY, gdzie miasto faktycznie się powtarza, na zapytanie z agregacją, gdzie logika jest już inna. W odpowiedziach, które sugerują „z powtórzeniami”, ignorowane jest działanie GROUP BY. Z kolei odpowiedzi mówiące o „sumie pensji” mylą AVG z SUM, co w praktyce może prowadzić do bardzo poważnych błędów analitycznych – wyobraź sobie raport płacowy, w którym zamiast średniej ktoś pokaże sumę wynagrodzeń i na tej podstawie będzie porównywał miasta. Moim zdaniem dobrą praktyką jest zawsze czytanie zapytania fragment po fragmencie: najpierw jakie kolumny są wybierane, potem jakie funkcje agregujące są użyte, a na końcu po czym następuje grupowanie. Taka metoda pozwala uniknąć właśnie takich nieporozumień i lepiej rozumieć, co dokładnie zwróci baza danych, co jest kluczowe przy pracy z realnymi systemami produkcyjnymi.
Funkcję policz wywołano z wartością argumentu $Z = 1. Jaki rezultat zostanie zwrócony?
A. 1
B. 7Twoja odpowiedź
C. 13Poprawna odpowiedź
D. 4
Niepoprawna odpowiedź. Niestety, tutaj coś nie zagrało. W pytaniu była funkcja 'policz' w PHP, która iteracyjnie zwiększa wartość zmiennej $Z, aż ta nie przekroczy 5. W każdej iteracji $Z rośnie o 2 * $Z + 1. Jak widać, przy odpowiednim argumencie początkowym wartość $Z rośnie bardzo szybko. W naszym przypadku zaczynamy z $Z równym 1. Po dwóch krokach mamy już 13, co kończy działanie pętli. Zamiast 1, 7 czy 4, funkcja 'policz' zwraca 13. Kluczowe jest zrozumienie, jak działają te iteracje i pętle w PHP.
Pytanie 34
Dla których imion klauzula LIKE jest prawdziwa?
SELECTimieFROMmieszkancyWHEREimieLIKE'o_%_a';
A. Oda, Oksana, Oktawia
B. Oksana, Ola, Olga
C. Oktawia, Oktawian, Olga
D. Oksana, Oktawia, OlgaTwoja odpowiedź
Poprawna odpowiedź. Odpowiedź „Oksana, Oktawia, Olga" jest prawidłowa. Aby zrozumieć, dlaczego właśnie te imiona spełniają warunek, należy dokładnie przeanalizować wzorzec użyty w klauzuli LIKE. Wzorzec 'o_%_a' składa się z pięciu elementów: litery „o" na początku, znaku podkreślenia oznaczającego dokładnie jeden dowolny znak, symbolu procentu reprezentującego zero lub więcej dowolnych znaków, kolejnego znaku podkreślenia (znów dokładnie jeden znak) oraz litery „a" na końcu. Z tej struktury wynika, że prawidłowe imię musi spełniać trzy warunki: zaczynać się od litery „o", kończyć się na literę „a" oraz mieć co najmniej cztery znaki długości. Ta ostatnia zasada jest kluczowa - dwa znaki podkreślenia wymuszają obecność minimum dwóch znaków pomiędzy pierwszą a ostatnią literą. Dlatego imiona takie jak „Ola" czy „Oda", mimo że zaczynają się na „o" i kończą na „a", są zbyt krótkie. Z kolei „Oktawian" odpada, ponieważ kończy się na literę „n", nie „a". Pozostają więc Oksana, Oktawia i Olga - każde z nich ma odpowiednią długość i właściwe litery na początku oraz końcu.
Pytanie 35
Efekt przedstawiony w filmie powinien być zdefiniowany w selektorze
A. tr:active { background-color: Pink; }
B. tr { background-color: Pink; }
C. td, th { background-color: Pink; }
D. tr:hover { background-color: Pink; }Twoja odpowiedź
Poprawna odpowiedź. Poprawny selektor to tr:hover { background-color: Pink; }, bo dokładnie opisuje sytuację pokazaną na filmie: efekt pojawia się dopiero po najechaniu kursorem na cały wiersz tabeli. Pseudo-klasa :hover w CSS służy właśnie do definiowania stylów w momencie, gdy użytkownik „najeżdża” myszką na dany element. Jeśli więc chcemy, żeby podświetlał się cały rząd tabeli, logiczne i zgodne z dobrymi praktykami jest przypięcie efektu do znacznika tr, a nie do pojedynczych komórek.
W praktyce taki zapis stosuje się bardzo często w interfejsach webowych: w panelach administracyjnych, listach zamówień, tabelach z uczniami, produktami, logami systemowymi itd. Dzięki temu użytkownik łatwiej śledzi, który wiersz właśnie ogląda. To niby detal, ale z punktu widzenia UX robi sporą różnicę. Z mojego doświadczenia to jeden z tych prostych trików CSS, które od razu poprawiają „odczuwalną” jakość strony.
Ważne jest też to, że :hover jest częścią standardu CSS (opisane m.in. w specyfikacji CSS Selectors Level 3/4) i działa w praktycznie wszystkich współczesnych przeglądarkach. Nie trzeba do tego żadnego JavaScriptu, żadnych skomplikowanych skryptów – czysty CSS. Dobrą praktyką jest również używanie bardziej stonowanych kolorów niż Pink w prawdziwych projektach, np. #f5f5f5 albo lekki odcień niebieskiego, tak żeby kontrast był czytelny i nie męczył wzroku. Warto też pamiętać, że podobny mechanizm możesz zastosować na innych elementach: np. a:hover dla linków, button:hover dla przycisków czy nawet div:hover dla całych kafelków w layoutach. Kluczowe jest to, żeby pseudo-klasa :hover była przypięta dokładnie do tego elementu, który ma reagować na interakcję użytkownika.
Pytanie 36
W bazie danych znajduje się tabela pracownicy z kolumnami: id, imie, nazwisko, pensja. W nowym roku postanowiono zwiększyć wynagrodzenie wszystkim pracownikom o 100 zł. Jak powinno wyglądać to w aktualizacji bazy danych?
A. UPDATE pracownicy SET pensja = pensja + 100;Twoja odpowiedź
B. UPDATE pracownicy SET pensja = 100;
C. UPDATE pensja SET +100;
D. UPDATE pensja SET 100;
Poprawna odpowiedź. Odpowiedź 'UPDATE pracownicy SET pensja = pensja + 100;' jest prawidłowa, ponieważ wprowadza właściwą składnię SQL, która aktualizuje pole 'pensja' w tabeli 'pracownicy'. To polecenie wykorzystuje operator przypisania '=', aby zaktualizować wartość 'pensja', dodając do niej 100 zł. W praktyce jest to typowy sposób na modyfikację danych w bazach danych relacyjnych, przy użyciu SQL. Kluczowym aspektem jest zrozumienie, że 'pensja' w tym kontekście odnosi się do istniejącej wartości w danym rekordzie, a nie do jakiejś stałej. Operator '+' w tym przypadku informuje system, że chcemy zwiększyć aktualną wartość o 100. Użycie tego typu składni jest zgodne z najlepszymi praktykami w programowaniu baz danych, co sprzyja przejrzystości i zrozumiałości kodu. Tego rodzaju aktualizacje są kluczowe w zarządzaniu danymi pracowników, zwłaszcza w kontekście systemów wynagrodzeń, gdzie regularne zmiany pensji są normą.
Pytanie 37
Jakie imiona spełniają warunki klauzuli LIKE w zapytaniu?
SELECTimieFROMmieszkancyWHEREimieLIKE'_r%';
A. Krzysztof, Krystyna, Romuald
B. Arleta, Krzysztof, Krystyna, TristanTwoja odpowiedź
C. Rafał, Rebeka, Renata, Roksana
D. Gerald, Jarosław, Marek, Tamara
Poprawna odpowiedź. Zapytanie SQL wykorzystuje klauzulę LIKE, która pozwala na wyszukiwanie wzorców w danych tekstowych. W tym przypadku wzór '_r%' oznacza, że szukamy imion, które mają na drugiej pozycji literę 'r' i mogą mieć dowolne znaki po tej literze. W analizowanych imionach, Arleta, Krzysztof, Krystyna oraz Tristan spełniają ten warunek, ponieważ: Arleta ma 'r' na drugiej pozycji, Krzysztof również, Krystyna także, a Tristan ma 'r' na drugiej pozycji. Przykład użycia klauzuli LIKE jest szczególnie przydatny w systemach, gdzie często zachodzi potrzeba filtrowania danych tekstowych na podstawie określonych wzorców. W praktyce, stosowanie klauzuli LIKE w zapytaniach SQL powinno być zgodne z najlepszymi praktykami, takimi jak optymalizacja indeksów i unikanie nadmiernego używania znaków wieloznacznych, które mogą prowadzić do spadku wydajności. Warto również pamiętać, że w wielu systemach baz danych klauzula LIKE jest czuła na wielkość liter, co może wpływać na wyniki zapytań.
Pytanie 38
Polecenie MySQL pokazane poniżej spowoduje, że użytkownikowi tkowal zostaną odebrane określone uprawnienia:
A. przydzielone uprawnienia do usuwania oraz aktualizacji danych w tabeli pracownicy
B. odebrane uprawnienia do usuwania i modyfikacji danych w tabeli pracownicyPoprawna odpowiedź
C. przydzielone uprawnienia do wszelkich zmian struktury tabeli pracownicy
D. odebrane uprawnienia do usuwania i dodawania rekordów w tabeli pracownicyTwoja odpowiedź
Niepoprawna odpowiedź. W kontekście zarządzania uprawnieniami w MySQL istotne jest zrozumienie różnicy między przydzielaniem a odbieraniem praw dostępu. Polecenie REVOKE nie przydziela uprawnień lecz je odbiera co jest kluczowym aspektem w zarządzaniu bezpieczeństwem bazy danych. Przydzielanie uprawnień odbywa się za pomocą polecenia GRANT które umożliwia nadanie użytkownikowi określonych praw dostępu do tabeli lub innych obiektów bazy danych. Zrozumienie tego rozróżnienia jest fundamentalne ponieważ wpływa ono na sposób w jaki zarządzamy dostępem użytkowników do wrażliwych danych. W niektórych przypadkach można błędnie założyć że REVOKE dotyczy struktury tabeli co jest mylnym podejściem ponieważ takie działania związane są z prawami DDL a nie DML. Dlatego pomyłka w interpretacji tego polecenia może prowadzić do niezamierzonych konsekwencji takich jak niekontrolowane modyfikacje danych. Typowym błędem jest także przypuszczenie że REVOKE może być używane do przydzielania praw co pokazuje brak zrozumienia podstawowych mechanizmów kontroli dostępu w MySQL. Zarządzanie dostępem jest kluczowe w zapewnieniu integralności i poufności danych dlatego ważne jest aby jasno rozróżniać między przydzielaniem i odbieraniem uprawnień.
Pytanie 39
Aby zwiększyć wydajność operacji w bazie danych, należy skupić się na polach, które są często wyszukiwane lub sortowane
A. stworzyć oddzielną tabelę przechowującą wyłącznie te pola
B. dodać klucz obcyTwoja odpowiedź
C. dodać więzy integralności
D. utworzyć indeksPoprawna odpowiedź
Niepoprawna odpowiedź. Dodawanie kluczy obcych nie jest bezpośrednią metodą na przyspieszenie operacji na bazie danych. Klucze obce są używane do zapewnienia integralności referencyjnej, co oznacza, że ich celem jest zapewnienie spójności danych w relacjach pomiędzy tabelami. Choć klucze obce mogą wpłynąć na wydajność w kontekście zapytań, nie przyspieszają one ani nie optymalizują wyszukiwania w obrębie pojedynczych tabel. Tworzenie osobnych tabel przechowujących tylko te pola również nie jest metodą optymalizacji efektywności wyszukiwania. Tego rodzaju podejście może prowadzić do komplikacji w zarządzaniu danymi oraz zmniejszenia wydajności przy łączeniu tabel w zapytaniach. Dodanie więzów integralności, które zapewniają, że dane w tabelach są poprawne i zgodne z określonymi zasadami, jest również istotne, ale nie wpływa bezpośrednio na szybkość operacji na bazie danych. Takie podejścia mogą prowadzić do błędnych przekonań, że poprawa wydajności bazy danych można osiągnąć poprzez wprowadzenie dodatkowych ograniczeń lub zmian w strukturze danych, co w rzeczywistości może generować dodatkowe koszty obliczeniowe przy wykonywaniu podstawowych operacji. Kluczowe jest stosowanie odpowiednich technik indeksacji, które są powszechnie uznawane za najlepszą praktykę w kontekście optymalizacji zasobów bazy danych.
Pytanie 40
Zdefiniowana jest tabela uczniowie z polami id, nazwisko, imie oraz klasa. Jakie zapytanie SQL pozwoli nam uzyskać liczbę osób w danym klasa i wskazać jej nazwę?
A. SELECT COUNT(id), klasa FROM uczniowie ORDER BY klasa
B. SELECT SUM(id), klasa FROM uczniowie GROUP BY klasa
C. SELECT SUM(id), klasa FROM uczniowie ORDER BY klasa
D. SELECT COUNT(id), klasa FROM uczniowie GROUP BY klasaTwoja odpowiedź
Poprawna odpowiedź. Odpowiedź 'SELECT COUNT(id), klasa FROM uczniowie GROUP BY klasa;' jest prawidłowa, ponieważ wykorzystuje funkcję agregującą COUNT do zliczenia liczby uczniów w każdej klasie. Kluczowym elementem jest tutaj klauzula GROUP BY, która grupuje wyniki według kolumny 'klasa'. Dzięki temu uzyskujemy dla każdej klasy osobny wynik z liczbą uczniów. To podejście jest zgodne z dobrymi praktykami w SQL, gdzie użycie funkcji agregujących z grupowaniem pozwala na efektywne przetwarzanie danych. Przykładowo, w przypadku szkoły, taka analiza może być użyta do zarządzania zasobami lub planowania, na przykład, przy ustalaniu liczby nauczycieli potrzebnych w danej klasie. Użycie COUNT zapewnia również, że wynik będzie liczbowy, co jest istotne dla dalszej analizy danych. Warto również pamiętać, że korzystanie z odpowiednich aliasów dla wyników może poprawić czytelność wyników zapytania.