Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 22 września 2026 23:17
Zakończenie: 23 września 2026 00:02
Egzamin zdany!
Wynik: 23/40 punktów (57,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Żadna odpowiedź nie została oznaczona jako strzał.
Przy następnym egzaminie zaznaczaj niepewne odpowiedzi - zobaczysz wtedy, ile wyniku bierze się z wiedzy, a ile ze szczęścia.
Twój wynik na tle innych
Twój wynik jest lepszy niż 25% podejść do kwalifikacji INF.04.
Porównanie z 23192 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Taki sam wynik jak poprzednio (57,5%).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Który z wymienionych typów testów najlepiej ocenia odporność aplikacji na intensywne obciążenie?
A. Testy zgodności
B. Testy funkcjonalne
C. Testy bezpieczeństwa
D. Testy obciążenioweTwoja odpowiedź
Poprawna odpowiedź. Testy obciążeniowe to rodzaj testów, które sprawdzają, jak aplikacja radzi sobie z dużym ruchem użytkowników lub przetwarzaniem dużych ilości danych. Celem testów obciążeniowych jest wykrycie potencjalnych wąskich gardeł, identyfikacja problemów z wydajnością oraz określenie maksymalnej przepustowości aplikacji. Testy te są kluczowe dla aplikacji o wysokim natężeniu ruchu, takich jak sklepy internetowe czy systemy bankowe, gdzie stabilność pod obciążeniem jest krytyczna dla sukcesu.
Pytanie 2
Który z wymienionych poniżej przykładów ilustruje użycie systemu informatycznego w działalności gospodarczej?
A. System wentylacji
B. System sterowania ruchem miejskim
C. E-sklepTwoja odpowiedź
D. System nawigacji GPS
Poprawna odpowiedź. E-sklep, jako przykład zastosowania systemu informatycznego w działalności biznesowej, reprezentuje złożony ekosystem technologiczny, który umożliwia przedsiębiorstwom sprzedaż produktów i usług w Internecie. E-sklepy wykorzystują różnorodne technologie, takie jak systemy zarządzania treścią (CMS), bazy danych oraz systemy płatności, co pozwala na efektywne zarządzanie ofertą, realizację zamówień oraz obsługę klienta. Przykładem może być platforma Shopify, która oferuje funkcjonalności umożliwiające łatwe tworzenie i zarządzanie sklepem online. E-sklepy są zgodne z różnymi standardami, takimi jak PCI DSS, które zapewniają bezpieczeństwo transakcji płatniczych. Dzięki integracji z systemami analitycznymi, właściciele e-sklepów mogą śledzić zachowania użytkowników, co pozwala na optymalizację oferty oraz strategii marketingowej. Tego rodzaju rozwiązania informatyczne fundamentalnie zmieniają sposób, w jaki przedsiębiorstwa prowadzą działalność i komunikują się z klientami, czyniąc procesy bardziej wydajnymi i zautomatyzowanymi.
Pytanie 3
Co to jest XSS (Cross-Site Scripting)?
A. Luka bezpieczeństwa pozwalająca na wstrzyknięcie złośliwego kodu do stron przeglądanych przez innych użytkownikówPoprawna odpowiedź
B. Protokół komunikacyjny używany w aplikacjach internetowych
C. Framework do tworzenia responsywnych stron internetowychTwoja odpowiedź
D. Technika optymalizacji kodu JavaScript do zwiększenia wydajności strony
Niepoprawna odpowiedź. Luka Cross-Site Scripting (XSS) jest często mylona z różnymi technikami i narzędziami stosowanymi w tworzeniu aplikacji webowych, co prowadzi do nieporozumień na temat jej rzeczywistego znaczenia i konsekwencji. Na przykład, techniki optymalizacji kodu JavaScript, które mogą wpływać na wydajność strony, nie mają nic wspólnego z zagrożeniami bezpieczeństwa wynikającymi z XSS. Optymalizacja kodu może poprawić czas ładowania strony, ale nie chroni przed atakami, które mogą wykorzystać luki w zabezpieczeniach. Ponadto, frameworki do tworzenia responsywnych stron internetowych, choć przydatne w projektowaniu, nie są instrumentami zapobiegającymi wstrzykiwaniu złośliwego kodu. Protokół komunikacyjny używany w aplikacjach internetowych również nie ma związku z XSS, ponieważ jest to podstawowy element technologii, który nie odnosi się bezpośrednio do bezpieczeństwa. Warto pamiętać, że ignorowanie zagrożeń związanych z XSS może prowadzić do poważnych incydentów bezpieczeństwa, dlatego kluczowe jest stosowanie sprawdzonych praktyk zabezpieczeń, takich jak sanitizacja danych wejściowych i monitorowanie aplikacji w celu wykrywania potencjalnych ataków.
Pytanie 4
Które z poniższych nie jest rodzajem bazy danych?
A. Grafowa baza danych
B. Routing DatabaseTwoja odpowiedź
C. Relacyjna baza danych
D. Dokumentowa baza danych
Poprawna odpowiedź. Routing Database to termin, który nie odnosi się do konkretnego rodzaju bazy danych w tradycyjnym sensie, jak to ma miejsce w przypadku relacyjnych, grafowych czy dokumentowych baz danych. Relacyjne bazy danych organizują dane w tabelach oraz umożliwiają wykonywanie złożonych zapytań przy użyciu języka SQL, co jest standardem branżowym. Grafowe bazy danych, z kolei, są zoptymalizowane do przechowywania i przetwarzania danych o relacjach, co sprawia, że są idealne do zastosowań w obszarze analizy sieci społecznych czy systemów rekomendacyjnych. Dokumentowe bazy danych przechowują dane w formie dokumentów, co ułatwia ich przechowywanie i przetwarzanie, szczególnie w kontekście aplikacji webowych i mobilnych. Routing Database nie jest typowym przykładem bazy danych w tym sensie, ponieważ odnosi się do mechanizmów zarządzania ruchem w sieciach komputerowych, co nie jest związane z obiegiem danych w stylu relacyjnym lub NoSQL. Zrozumienie tych różnic jest kluczowe dla właściwego wyboru technologii bazodanowej w zależności od potrzeb aplikacji.
Pytanie 5
W przedstawionym filmie ukazano kreator interfejsu użytkownika, dla którego automatycznie powstaje
A. obsługa przycisku ekranu dotykowego
B. obsługa wciśniętego przycisku
C. kod XMLTwoja odpowiedź
D. kod Java
Poprawna odpowiedź. Kod XML jest obecnie najczęściej stosowanym formatem do definiowania wyglądu interfejsów użytkownika w takich narzędziach jak Android Studio czy różnego rodzaju designery graficzne. Kiedy projektujesz layout aplikacji mobilnej albo desktopowej, duża część nowoczesnych narzędzi tworzy właśnie pliki XML, które następnie są interpretowane przez system w czasie uruchamiania aplikacji. Ułatwia to rozdzielenie logiki aplikacji od jej prezentacji, co wydaje się fundamentalne przy większych projektach. Moim zdaniem takie podejście daje ogromne korzyści – można łatwo modyfikować wygląd bez dotykania kodu źródłowego. W praktyce, jeśli używasz np. Android Studio, zbudujesz interfejs przeciągając przyciski czy pola tekstowe, a pod spodem dostaniesz czytelny plik XML. To przyspiesza pracę, zwiększa czytelność projektu i pozwala na późniejsze automatyczne generowanie dokumentacji albo testów interfejsu. Takie standardy są rekomendowane nie tylko przez Google, ale też szeroko stosowane w innych środowiskach, jak chociażby XAML w Microsoft czy FXML w JavaFX. Przezroczystość działania tych narzędzi sprawia, że łatwiej jest pracować zespołowo, bo każdy może szybko zorientować się w strukturze UI patrząc na XML-a. Samo generowanie kodu XML przez narzędzia graficzne to duży krok w kierunku lepszej organizacji pracy i zgodności ze współczesnymi praktykami branżowymi.
Pytanie 6
Co oznacza skrót SOLID w programowaniu obiektowym?
A. Zbiór pięciu zasad projektowania oprogramowania ułatwiających tworzenie czytelnego koduTwoja odpowiedź
B. Popularna metodologia testowania aplikacji mobilnych i webowych
C. System organizacji zadań w metodologii zwinnej używany w Scrum
D. Standard tworzenia dokumentacji technicznej dla aplikacji
Poprawna odpowiedź. Skrót SOLID odnosi się do pięciu podstawowych zasad projektowania obiektowego, które zostały sformułowane przez Roberta C. Martina. Zasady te, a mianowicie: Single Responsibility Principle (SRP), Open/Closed Principle (OCP), Liskov Substitution Principle (LSP), Interface Segregation Principle (ISP) oraz Dependency Inversion Principle (DIP), mają na celu ułatwienie tworzenia czytelnego, łatwego do modyfikacji i rozszerzenia kodu. Przykładowo, zasada SRP mówi o tym, że każda klasa powinna mieć jedną odpowiedzialność, co pozwala na łatwiejsze wprowadzanie zmian oraz testowanie. Implementacja SOLID sprzyja także lepszej organizacji kodu, co jest kluczowe w dużych projektach, gdzie złożoność i liczba współpracujących komponentów mogą prowadzić do trudności w zarządzaniu. Przykład praktyczny można zobaczyć w aplikacji używającej wzorców projektowych, gdzie zasady SOLID pomagają w tworzeniu elastycznych i dobrze zorganizowanych systemów. W branży programistycznej, przestrzeganie tych zasad jest uznawane za dobrą praktykę, co przyczynia się do zwiększenia jakości oprogramowania oraz satysfakcji zespołów developerskich.
Pytanie 7
Która z poniższych metod nie należy do cyklu życia komponentu w React.js?
A.
componentWillPublish()
Poprawna odpowiedź
B.
componentDidMount()
C.
componentWillUnmount()
Twoja odpowiedź
D.
componentDidUpdate()
Niepoprawna odpowiedź. Dla osób pracujących z React.js kluczowe jest zrozumienie cyklu życia komponentów, który składa się z określonych metod umożliwiających zarządzanie stanem komponentów w różnych momentach ich życia. Wśród powszechnie używanych metod znajdują się componentDidMount(), componentDidUpdate() oraz componentWillUnmount(). Każda z tych metod pełni istotną rolę w kontekście zarządzania komponentami. Metoda componentDidMount() jest pierwszym momentem, kiedy komponent jest dostępny w DOM, co sprawia, że jest idealna do wykonywania wszelkich operacji związanych z inicjalizacją, takich jak pobieranie danych z serwera. Z kolei componentDidUpdate() umożliwia reagowanie na zmiany stanu lub propów, co jest niezbędne w dynamicznych interfejsach użytkownika. Metoda componentWillUnmount() pozwala na odpowiednie czyszczenie zasobów, co zapobiega wyciekom pamięci, na przykład poprzez usuwanie nasłuchiwaczy. Użytkownicy mogą błędnie interpretować metodę componentWillPublish(), sądząc, że jest ona częścią standardowego cyklu życia komponentów, jednak nie jest to zgodne ze specyfikacją React. Kluczowe jest, aby nie mylić terminologii i zrozumieć, że właściwe metody cyklu życia są jasno zdefiniowane w dokumentacji React. Ignorowanie tego aspektu może prowadzić do problemów w zarządzaniu komponentami, ich stanem oraz interakcjami z użytkownikiem, co w dłuższej perspektywie wpływa na jakość i wydajność aplikacji.
Pytanie 8
Jakie jest główne zadanie debuggera w środowisku programowania?
A. Analiza i usuwanie błędów w kodzieTwoja odpowiedź
B. Tworzenie kodu źródłowego
C. Generowanie plików wykonywalnych
D. Kompilowanie kodu źródłowego
Poprawna odpowiedź. Debugger to narzędzie programistyczne służące do analizy i usuwania błędów w kodzie źródłowym. Pozwala na krokowe wykonywanie programu, śledzenie wartości zmiennych i identyfikowanie miejsc, w których występują błędy logiczne lub składniowe. Debugger umożliwia zatrzymanie wykonania programu w dowolnym miejscu, ustawienie tzw. breakpointów (punktów przerwania) i monitorowanie przepływu sterowania. Dzięki temu programista może dokładnie przeanalizować, dlaczego program nie działa zgodnie z oczekiwaniami i szybko znaleźć przyczynę problemu. Debuggery są dostępne w większości zintegrowanych środowisk programistycznych (IDE), takich jak Visual Studio, PyCharm czy IntelliJ IDEA.
Pytanie 9
Mobilna aplikacja przedstawia listę, w której każdy element można dotknąć palcem, aby zobaczyć jego detale. Zdarzenie, które odpowiada tej czynności, to
A. button clicked.
B. value changed.
C. tapped.Twoja odpowiedź
D. toggled.
Poprawna odpowiedź. Zdarzenie 'tapped' oznacza, że stuknęliśmy w coś na liście na naszym telefonie. To takie podstawowe zdarzenie, które przydaje się w aplikacjach mobilnych. Dzięki temu możemy wchodzić w interakcje z różnymi elementami, na przykład, gdy klikniemy na coś w liście, pojawią się dodatkowe szczegóły. Ta obsługa zdarzeń 'tap' jest naprawdę ważna w aplikacjach mobilnych, bo to w zasadzie główny sposób, w jaki poruszamy się po interfejsie.
Pytanie 10
Jakie są kluczowe etapy realizacji projektu programistycznego?
A. Planowanie, analiza, implementacja, wdrożenieTwoja odpowiedź
B. Analiza, implementacja, testowanie, aktualizacja
C. Planowanie, projektowanie, debugowanie, konserwacja
D. Projektowanie, testowanie, aktualizacja, implementacja
Poprawna odpowiedź. Wybrałeś poprawną sekwencję etapów realizacji projektu programistycznego – to naprawdę ma kluczowe znaczenie w praktyce. Planowanie jest absolutnym fundamentem, bo pozwala zdefiniować cele, wymagania i zakres projektu. Bez porządnego planu łatwo się pogubić już na starcie, a potem robi się tylko drożej i trudniej. Następnie analiza – tutaj wchodzi się głębiej w temat: zbiera się szczegółowe wymagania, analizuje ryzyka i szuka ewentualnych problemów, które mogą pojawić się później. Implementacja to etap, gdzie programiści faktycznie piszą kod, ale – i to warto podkreślić – bez wcześniejszego solidnego planowania i analizy, ten etap bardzo często kończy się chaosem i ciągłymi poprawkami. Wdrożenie oznacza przekazanie gotowego produktu użytkownikom czy klientowi, często połączone z testami akceptacyjnymi i dokumentacją. Takie podejście jest zgodne z klasycznymi metodologiami typu waterfall, ale też w metodykach zwinnych te fazy się pojawiają, choć czasem są bardziej rozmyte – moim zdaniem, nawet w agile trzeba mieć minimum planowania i analizy, żeby nie robić rzeczy na ślepo. W prawdziwych projektach to jest właśnie ten główny szkielet pracy, do którego wszystko się sprowadza – znam sporo przykładów z branży, gdzie pominięcie choćby jednego z tych kroków kończyło się katastrofą. Dobrze jest mieć ten schemat w głowie, bo pomaga zarówno na etapie małych aplikacji, jak i dużych, wieloosobowych przedsięwzięć. Warto też pamiętać, że każdemu z tych etapów towarzyszą różne narzędzia i techniki – np. przy planowaniu często robi się diagramy Gantta, w analizie korzysta się z UML, a podczas wdrożenia dobrze mieć plan migracji i dokumentację użytkownika. Tak po prostu robi się to dobrze w świecie IT.
Pytanie 11
Jakie znaczenie ma termin "hierarchia dziedziczenia" w kontekście programowania obiektowego?
A. Układ klas w strukturę, w której klasy pochodne dziedziczą cechy od klas bazowychTwoja odpowiedź
B. Zbiór klas, które nie mają wspólnych powiązań
C. Zespół metod i pól posiadających ten sam modyfikator dostępu
D. Układ klas, który ogranicza występowanie dziedziczenia wielokrotnego
Poprawna odpowiedź. Hierarchia dziedziczenia to fundamentalna koncepcja programowania obiektowego, polegająca na organizacji klas w strukturę, w której klasy pochodne dziedziczą właściwości (pola i metody) od klas bazowych. Pozwala to na wielokrotne wykorzystanie kodu, co zwiększa jego modularność i zmniejsza redundancję. Klasa bazowa dostarcza ogólne cechy i metody, podczas gdy klasy pochodne rozszerzają lub modyfikują tę funkcjonalność, dostosowując ją do bardziej specyficznych wymagań. Przykładem jest klasa 'Pojazd', po której mogą dziedziczyć klasy 'Samochód' i 'Motocykl', zachowując wspólne atrybuty, takie jak 'maksymalna prędkość' czy 'masa'.
Pytanie 12
Który element HTML5 służy do osadzania wideo na stronie?
A. <video>Twoja odpowiedź
B. <player>
C. <media>
D. <movie>
Poprawna odpowiedź. Element HTML5 <video> jest standardowym tagiem służącym do osadzania wideo na stronach internetowych. Umożliwia on integrację multimediów w sposób, który jest zgodny z aktualnymi standardami sieciowymi. W porównaniu do starszych metod, które wymagały użycia zewnętrznych wtyczek, takich jak Flash, <video> pozwala na bezproblemowe odtwarzanie wideo w przeglądarkach nowej generacji, co zwiększa bezpieczeństwo i wydajność. Element ten oferuje wiele atrybutów, takich jak controls, autoplay, loop, preload, oraz width i height, które pozwalają na dostosowanie odtwarzacza do potrzeb użytkownika. Na przykład, używając atrybutu controls, można dodać przyciski odtwarzania, zatrzymywania lub regulacji głośności, co poprawia interaktywność i użyteczność. Dodatkowo, aby zapewnić dostępność treści wideo, warto stosować atrybuty takie jak <track>, który umożliwia dodawanie napisów, co jest szczególnie ważne dla osób z niepełnosprawnościami słuchowymi. Używanie <video> w projektach webowych to najlepsza praktyka, która wspiera rozwój dostępnych i przyjaznych dla użytkownika doświadczeń wizualnych.
Pytanie 13
Który z poniższych przykładów ilustruje deklarację złożonego typu w języku C++?
A.
intwynik=100;
B.
floatocena=4.5;
C.
boolstatus;
Twoja odpowiedź
D.
classStudent{};
Poprawna odpowiedź
Niepoprawna odpowiedź. `bool status;` deklaruje zmienną logiczną, a nie typ złożony. `int wynik = 100;` to deklaracja zmiennej całkowitej, co również nie jest typem złożonym. `float ocena = 4.5;` definiuje zmienną zmiennoprzecinkową, co oznacza przechowywanie liczb z częściami dziesiętnymi. Żadna z tych deklaracji nie odnosi się do definicji klasy lub innego złożonego typu danych, jakim jest `class` w C++.
Pytanie 14
Modyfikator dostępu, który znajduje się przed definicją metody Dodaj() w klasie Kalkulator, powoduje, że
protectedvoidDodaj() {}
A. jest ona dostępna w programie głównym i może być wywoływana na rzecz instancji klasy Kalkulator
B. nie jest ona dostępna z poziomu klas zaprzyjaźnionych z klasą Kalkulator
C. jest ona dostępna zarówno wewnątrz klasy, jak i w klasach dziedziczących po klasie KalkulatorTwoja odpowiedź
D. nie jest ona dostępna w klasach, które dziedziczą po klasie Kalkulator
Poprawna odpowiedź. Modyfikator dostępu protected jest kluczowym elementem programowania obiektowego, umożliwiającym kontrolę nad widocznością i dostępem do składników klasy. Gdy metoda jest oznaczona jako protected, jak w przypadku metody Dodaj() w klasie Kalkulator, oznacza to, że jest ona dostępna nie tylko w ramach tej klasy, ale również w dowolnych klasach, które dziedziczą po klasie Kalkulator. To podejście wspiera koncepcję dziedziczenia, umożliwiając klasom potomnym korzystanie z funkcjonalności klasy bazowej bez konieczności ponownego definiowania metod. Na przykład, jeśli stworzymy klasę DziecięcyKalkulator dziedziczącą po Kalkulator, metoda Dodaj() będzie dostępna w tej klasie potomnej. Takie rozwiązanie jest często stosowane w projektach, gdzie istnieje potrzeba rozszerzania funkcjonalności bazowych klas bez naruszania ich enkapsulacji. Dobre praktyki programistyczne sugerują stosowanie protected tam, gdzie chcemy umożliwić dziedziczenie oraz uniknąć nadmiernego udostępniania elementów klasy zewnętrznym użytkownikom. Dzięki temu kod staje się bardziej modularny i elastyczny, co jest istotne w dużych projektach programistycznych. Zrozumienie roli modyfikatorów dostępu, takich jak protected, jest kluczowe dla efektywnego projektowania i implementacji systemów obiektowych.
Pytanie 15
Co to jest IndexedDB?
A. Indeks danych używany przez wyszukiwarki internetowe
B. Format indeksowania danych w bazach NoSQL
C. System zarządzania bazami SQL w aplikacjach backendowychTwoja odpowiedź
D. Niskopoziomowe API do przechowywania dużych ilości danych w przeglądarce użytkownikaPoprawna odpowiedź
Niepoprawna odpowiedź. Odpowiedzi, które wskazują na inne znaczenia IndexedDB, wynikają z nieporozumień dotyczących funkcji i zastosowania tej technologii. IndexedDB nie jest indeksem danych używanym przez wyszukiwarki internetowe, ponieważ jego głównym celem jest przechowywanie danych lokalnie na urządzeniu użytkownika, a nie indeksowanie ich w sieci. Takie myślenie prowadzi do błędnych wniosków na temat jego funkcjonalności, ponieważ indeksy w wyszukiwarkach takie jak Google służą do szybkiego odnajdywania informacji w ogromnych zbiorach danych dostępnych w Internecie, a nie do lokalnego przechowywania czy manipulacji informacjami. Ponadto, nie jest to system zarządzania bazami SQL w aplikacjach backendowych. IndexedDB działa w przeglądarkach i jest zaprojektowane do pracy w środowisku klienta, podczas gdy bazy SQL, takie jak MySQL czy PostgreSQL, są zazwyczaj używane na serwerach i wymagają odrębnego podejścia do zarządzania danymi. Również twierdzenie, że IndexedDB jest formatem indeksowania danych w bazach NoSQL, jest mylące. IndexedDB to nie format, lecz interfejs API, który wspiera przechowywanie danych w strukturze obiektowej, co czyni go bardziej elastycznym w kontekście przechowywania danych niż tradycyjne bazy NoSQL. W rezultacie, błędne koncepcje wynikają z niepełnego zrozumienia, jak działa IndexedDB oraz jakie są jego główne zastosowania i ograniczenia.
Pytanie 16
Celem zastosowania wzorca Obserwator w tworzeniu aplikacji WEB jest
A. zarządzanie funkcjami synchronicznymi w kodzie aplikacji
B. dostosowanie interfejsu użytkownika do różnych typów odbiorców
C. monitorowanie interakcji użytkownika i wysyłanie wyjątkówTwoja odpowiedź
D. informowanie obiektów o modyfikacji stanu innych obiektówPoprawna odpowiedź
Niepoprawna odpowiedź. Wszystkie pozostałe odpowiedzi są błędne z kilku powodów. Dopasowanie interfejsu użytkownika do różnych typów użytkowników nie jest funkcją wzorca Obserwator, lecz bardziej związane jest z koncepcjami UX/UI (User Experience/User Interface) i personalizacją. Chociaż interfejs może korzystać z danych powiadomień od wzorca Obserwator, sam wzorzec nie zajmuje się dostosowywaniem interfejsu do preferencji użytkownika. Obserwowanie interakcji użytkownika i wysyłanie wyjątków również nie jest celem wzorca Obserwator. Takie działania zazwyczaj są obsługiwane przez mechanizmy zdarzeń lub kontrolery, które rejestrują interakcje, ale nie mają na celu bezpośredniego monitorowania i reagowania na zmiany stanu innych obiektów. Wreszcie, obsługa funkcji synchronicznych w kodzie aplikacji jest zupełnie inną kwestią, powiązaną z asynchronicznością, obiegiem zdarzeń i obiektami Promise, a nie z tym, co oferuje wzorzec Obserwator. Wzorzec ten nie ma na celu synchronizacji, a raczej dążenie do luźnego powiązania między obiektami, co jest kluczowe dla efektywnej i elastycznej architektury aplikacji.
Pytanie 17
Środowiskiem dedykowanym do tworzenia aplikacji mobilnych dla urządzeń Apple i wykorzystującym do tego celu różne języki programowania w tym Java i Objective C jest
A. XCodePoprawna odpowiedź
B. React NativeTwoja odpowiedź
C. NetBeans
D. Android Studio
Niepoprawna odpowiedź. Wybór innego środowiska niż XCode do tworzenia aplikacji mobilnych na urządzenia Apple to dość często spotykany błąd, zwłaszcza na etapie nauki, bo z zewnątrz narzędzia te mogą wydawać się podobne lub uniwersalne. Android Studio kojarzy się z programowaniem na urządzenia mobilne, ale to środowisko jest w pełni dedykowane systemowi Android i nie da się w nim przygotować aplikacji natywnych dla iOS czy macOS – jest to narzędzie stworzone przez Google i opiera się głównie na Javie oraz Kotlinie, które Apple w ogóle nie wspiera w swoim ekosystemie. NetBeans też pojawia się często w rozmowach o programowaniu, bo obsługuje wiele języków, w tym Java, ale nie ma żadnych natywnych narzędzi do budowy iOS-owych aplikacji ani nie zapewnia integracji z narzędziami Apple, takimi jak symulator czy App Store Connect. Jest wykorzystywany głównie do aplikacji desktopowych lub webowych, a nie mobilnych na iOS. Z kolei React Native to całkiem ciekawa opcja, bo pozwala tworzyć aplikacje mobilne „wieloplatformowe” – czyli takie, które działają i na Androidzie, i na iOS-ie, ale nie jest to środowisko natywne. React Native opiera się na JavaScript i renderuje interfejsy za pomocą natywnych komponentów, ale i tak do finalnego budowania aplikacji na iOS zawsze potrzebny jest XCode, bo tylko on umożliwia publikację w App Store czy korzystanie z zaawansowanych funkcji systemowych. Nierzadko osoby zaczynające programowanie myślą, że każde IDE „zadziała” na każdy system, ale Apple od zawsze bardzo pilnuje swojego ekosystemu i wymaga korzystania z własnych narzędzi przy natywnym programowaniu. Nawet jeśli wybierze się narzędzia wieloplatformowe, to ostatecznie bez XCode nie da się złożyć, podpisać cyfrowo ani opublikować aplikacji na iOS. To typowe nieporozumienie wynika często z nieznajomości zasad publikacji w ekosystemie Apple i różnic między platformami.
Pytanie 18
Jakie są różnice między procesem kompilacji a interpretacją kodu?
A. Kompilacja przekształca cały kod źródłowy przed jego wykonaniem, podczas gdy interpretacja tłumaczy kod na bieżącoTwoja odpowiedź
B. Interpretacja umożliwia tworzenie bibliotek dynamicznych, a kompilacja bibliotek statycznych
C. Kompilacja jest stosowana jedynie w programowaniu obiektowym
D. Kompilacja wymaga użycia debuggera, natomiast interpretacja tego nie potrzebuje
Poprawna odpowiedź. Kompilacja i interpretacja to dwa różne sposoby, żeby uruchomić kod. Kiedy kompilujesz, to cały kod jest zamieniany na język maszynowy przed uruchomieniem programu, a na końcu dostajesz plik, który można odpalić. Z kolei w interpretacji, kod jest analizowany i wykonywany linia po linii „na żywo”. Kompilacja jest bardziej typowa dla języków takich jak C czy C++, a interpretacja jest popularna w językach skryptowych jak Python czy JavaScript. Kompilacja daje większą wydajność, ale musisz poczekać, aż cały kod się skompiluje, a interpretacja pozwala na szybkie testowanie i łatwiejsze znajdowanie błędów.
Pytanie 19
Jakie są kluczowe różnice między typami stałoprzecinkowymi a zmiennoprzecinkowymi?
A. Typy stałoprzecinkowe obsługują liczby ujemne, natomiast typy zmiennoprzecinkowe tylko dodatnie
B. Typy zmiennoprzecinkowe przechowują wyłącznie liczby ujemne
C. Typy stałoprzecinkowe przechowują liczby całkowite, a typy zmiennoprzecinkowe przechowują liczby z ułamkami dziesiętnymiTwoja odpowiedź
D. Typy stałoprzecinkowe wymagają większej ilości pamięci niż typy zmiennoprzecinkowe
Poprawna odpowiedź. Główna różnica między typami stałoprzecinkowymi a zmiennoprzecinkowymi polega na tym, że stałoprzecinkowe przechowują liczby całkowite, podczas gdy zmiennoprzecinkowe przechowują liczby z częściami dziesiętnymi. Stałoprzecinkowe typy, takie jak 'int', są bardziej efektywne pod względem wydajności i zajmują mniej pamięci, co czyni je idealnym rozwiązaniem w przypadkach, gdzie precyzja dziesiętna nie jest wymagana. Z kolei typy zmiennoprzecinkowe, takie jak 'float' i 'double', umożliwiają dokładne reprezentowanie wartości niecałkowitych, co jest niezbędne w aplikacjach matematycznych i graficznych. Każdy z tych typów ma swoje zastosowanie w zależności od wymagań projektu.
Pytanie 20
W środowisku IDE przeznaczonym do tworzenia aplikacji okienkowych zdefiniowano okno Form1. Aby wprowadzić zmiany w ustawieniach, w kolejności: tytuł okna na górnym pasku, standardowy kursor na strzałkę oraz kolor tła okna, należy dostosować następujące pola w oknie Properties:
A. (Name), Cursor, BackgroundImage
B. (Name), UseWaitCursor, BackgroundImage
C. Text, Cursor, BackColorTwoja odpowiedź
D. Text, UseWaitCursor, BackColor
Poprawna odpowiedź. Wybrana odpowiedź jest prawidłowa, bo dokładnie te trzy właściwości – Text, Cursor i BackColor – odpowiadają w Windows Forms za ustawienia tytułu okna, domyślnego kursora myszy oraz koloru tła formularza. W praktyce, edytując pole Text w Properties, określasz, co użytkownik zobaczy na belce tytułowej okna. To często pierwszy krok w customizacji okna – tytuł powinien jednoznacznie identyfikować aplikację i jej funkcję, zgodnie z dobrymi praktykami UX/UI. Następnie pole Cursor umożliwia wybranie rodzaju kursora, który pojawi się, gdy użytkownik najedzie myszą na dany formularz. Najczęściej używany jest domyślny wskaźnik (strzałka), ale można tu ustawić na przykład kursor oczekiwania czy rękę, jeśli wymaga tego logika aplikacji. Zmiana BackColor to podstawa, jeśli chcesz wizualnie wyróżnić okno lub dostosować je do kolorystyki firmowej. Moim zdaniem, te trzy pola to podstawa podstaw w pracy z IDE do Windows Forms – bez ich zrozumienia ciężko mówić o jakimkolwiek sensownym projektowaniu interfejsu. Warto też zwrócić uwagę, że te właściwości są uniwersalne i pojawiają się praktycznie w każdym tutorialu czy dokumentacji Microsoftu dla .NET – to już taki żelazny standard branżowy. Z mojego doświadczenia często początkujący programiści mają z tym problem, bo szukają skomplikowanych rozwiązań, a tu chodzi po prostu o poprawne posługiwanie się Properties. Dzięki temu nawet najprostsza apka wygląda profesjonalniej i jest bardziej intuicyjna dla użytkownika.
Pytanie 21
Wykorzystując React.js oraz Angular, stworzono funkcjonalnie równoważne kody źródłowe. Aby móc w metodzie handleSubmit pokazać zawartość kontrolki input w miejscu oznaczonym ???, należy odwołać się do atrybutu o nazwie: React.js:
Poprawna odpowiedź. To właśnie nazwa1 jest właściwym atrybutem, do którego trzeba się odwołać, żeby wyciągnąć wartość inputa zarówno w React, jak i w Angularze. W React, kiedy chcemy pobrać wartość z inputa przez refa, to przekazujemy ref={this.nazwa1}, a potem w handleSubmit robimy this.nazwa1.current.value. To po prostu dokładnie ta sama nazwa, którą przypisałeś do refa, nie ma tu żadnej magii. W Angularze z kolei input posiada ngModel oraz name="nazwa1" – i to name jest kluczowe, bo obiekt f.value generowany przez ngForm zawiera wszystkie pola po kluczach odpowiadających atrybutom name. Dzięki temu możesz potem użyć f.value.nazwa1 i dostajesz wartość inputa. W praktyce zawsze warto pilnować, żeby atrybut name był sensowny i jednoznaczny, bo to na nim opierają się frameworki przy serializacji danych formularza i obsłudze ich stanu. Moim zdaniem to jest jedna z bardziej praktycznych umiejętności przy pracy z dynamicznymi formularzami – jeśli ktoś nie dba o spójność nazw atrybutów name, to łatwo o błędy, które są potem trudne do wykrycia. Warto jeszcze pamiętać, że atrybuty typu id, class czy for mają zupełnie inne zastosowanie – służą do stylowania, powiązań z labelkami, itd. Name natomiast to podstawa logicznej obsługi wartości pól formularza. Często spotykam się z sytuacjami, że ktoś próbuje pobierać dane po id czy class, ale to nie jest zgodne z dobrymi praktykami – dla czytelności kodu i łatwości refaktoryzacji o wiele lepiej korzystać z name. Takie rozwiązania są też zalecane w oficjalnej dokumentacji zarówno React, jak i Angulara.
Pytanie 22
Które z poniższych twierdzeń najlepiej charakteryzuje bibliotekę w kontekście programowania?
A. Zbiór zmiennych globalnych, które są dostępne w trakcie działania aplikacjiTwoja odpowiedź
B. Zestaw funkcji i klas, które mogą być wykorzystywane w aplikacjachPoprawna odpowiedź
C. Plik wykonywalny, który funkcjonuje jako odrębny program
D. Zbiór kodu źródłowego, który jest stosowany wyłącznie w fazie kompilacji aplikacji
Niepoprawna odpowiedź. Biblioteka nie służy tylko podczas kompilacji – funkcje, które zawiera, są też dostępne w trakcie działania programu. Plik wykonywalny to właściwie finalny produkt kompilacji, a nie biblioteka, która jest bardziej narzędziem do budowy aplikacji. Zbiór zmiennych globalnych, które są dostępne w czasie działania programu, to raczej cecha środowiska, w którym działa program, lub interpreterów, a nie to, co definiuje bibliotekę.
Pytanie 23
Co to jest CSS Grid?
A. Format plików graficznych obsługiwany przez CSS3
B. Metoda optymalizacji plików CSS dla lepszej wydajności strony
C. Biblioteka komponentów wizualnych dla aplikacji webowych
D. Dwuwymiarowy system układu elementów na stronie opary na siatkachTwoja odpowiedź
Poprawna odpowiedź. CSS Grid to nowoczesny, dwuwymiarowy system układu elementów na stronie internetowej, który umożliwia projektantom i deweloperom łatwe i elastyczne tworzenie skomplikowanych układów. Dzięki CSS Grid możemy definiować zarówno kolumny, jak i wiersze, co pozwala na precyzyjne umieszczanie elementów w kontekście całego układu. Przykładem zastosowania CSS Grid może być stworzenie responsywnej galerii zdjęć, gdzie można łatwo zmieniać liczbę kolumn w zależności od szerokości ekranu. CSS Grid jest zgodny z najnowszymi standardami W3C i stał się kluczowym elementem w nowoczesnym web designie. Dzięki właściwościom takim jak grid-template-areas, grid-template-columns, czy grid-auto-rows, projektanci mogą w intuicyjny sposób organizować treści, co poprawia zarówno estetykę, jak i użyteczność stron. Ponadto, korzystanie z CSS Grid pozwala na zmniejszenie zależności od zewnętrznych bibliotek JavaScript do układania elementów, co podnosi wydajność i usprawnia proces tworzenia stron.
Pytanie 24
Który z poniższych przykładów stanowi aplikację mobilną wykorzystującą bazę danych?
A. Aplikacja wyświetlająca lokalny czas
B. Aplikacja do robienia zdjęć
C. Aplikacja gromadząca listę kontaktów użytkownikaTwoja odpowiedź
D. Aplikacja kalkulator
Poprawna odpowiedź. Aplikacja przechowująca listę kontaktów użytkownika korzysta z bazy danych do przechowywania, odczytywania i zarządzania danymi. Tego typu aplikacje mobilne muszą efektywnie zarządzać dużą ilością danych i zapewniać ich szybki dostęp. Bazy danych, takie jak SQLite czy Firebase, są szeroko stosowane w aplikacjach mobilnych, umożliwiając przechowywanie kontaktów, wiadomości, notatek i innych informacji użytkownika. Dzięki bazom danych możliwe jest także synchronizowanie danych pomiędzy urządzeniami i przechowywanie ich w chmurze.
Pytanie 25
Jaką kategorię własności intelektualnej reprezentują znaki towarowe?
A. Prawa pokrewne
B. Dobra niematerialne
C. Własność przemysłowaPoprawna odpowiedź
D. Autorskie prawa majątkoweTwoja odpowiedź
Niepoprawna odpowiedź. Dobra niematerialne to szersza kategoria obejmująca różne aspekty własności intelektualnej, ale znaki towarowe są formalnie klasyfikowane jako własność przemysłowa. Autorskie prawa majątkowe dotyczą utworów literackich, muzycznych i filmowych, ale nie obejmują znaków towarowych. Prawa pokrewne chronią wykonawców i producentów nagrań, lecz nie odnoszą się do znaków towarowych i brandingu firm.
Pytanie 26
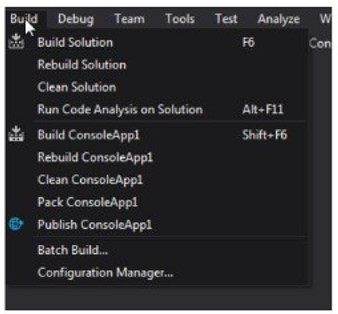
W środowisku do tworzenia aplikacji, gdzie przedstawiono menu, aby usunąć wszystkie pliki tymczasowe oraz wyniki projektu, należy wybrać opcję
A. Run Code Analysis on Solution
B. Build Solution
C. Clean SolutionTwoja odpowiedź
D. Batch Build
Poprawna odpowiedź. Opcja „Clean Solution” to dokładnie to, czego używa się w Visual Studio lub innych środowiskach IDE, gdy chce się pozbyć wszystkich plików tymczasowych oraz wyników kompilacji powiązanych z bieżącym projektem lub rozwiązaniem. To bardzo praktyczna funkcja – zwłaszcza wtedy, gdy mamy problemy ze zbudowaniem projektu po wprowadzeniu wielu zmian lub gdy różne konfiguracje builda zaczynają się mieszać. Clean Solution usuwa wszystkie foldery bin i obj, co pozwala rozpocząć proces kompilacji od zera, eliminując potencjalne konflikty wynikające ze starych plików. Moim zdaniem warto korzystać z tej opcji regularnie, szczególnie w większych projektach czy zespołach, gdzie często zmieniają się zależności. W branży IT, według dobrych praktyk, „czyszczenie” rozwiązania przed puszczeniem pełnego builda pomaga zredukować liczbę nieprzewidzianych błędów kompilacji. Dla mnie to trochę taki techniczny reset – zanim zaczniesz szukać błędów w kodzie, upewnij się, że budujesz wszystko na świeżo. Zresztą, w dokumentacji Microsoftu też znajdziesz zalecenia, by właśnie Clean Solution stosować do rozwiązywania problemów z nieaktualnymi artefaktami builda. Bez tej funkcji czasem trudno dojść, czemu kompilator się buntuje.
Pytanie 27
Jakie jest najważniejsze właściwość algorytmów szyfrowania symetrycznego?
A. Szyfrowanie wyłącznie tekstowych plików
B. Zastosowanie odmiennych kluczy do szyfrowania i deszyfrowania
C. Zastosowanie identycznego klucza do szyfrowania oraz deszyfrowaniaTwoja odpowiedź
D. Funkcjonowanie bez użycia klucza
Poprawna odpowiedź. Algorytmy szyfrowania symetrycznego to takie, które używają tego samego klucza do szyfrowania i deszyfrowania danych. To jedna z najstarszych metod i, co ważne, bardzo często stosowanych, bo działa dość szybko i nie wymaga wielkich zasobów. Przykłady, które na pewno słyszałeś, to AES i DES. Symetryki są super w komunikacji sieciowej, przy przechowywaniu danych, a także w różnych protokołach bezpieczeństwa. Fajnie, że są szybkie, ale z drugiej strony trzeba pamiętać o tym, żeby klucz był bezpiecznie przechowywany, bo to może stanowić nie lada problem.
Pytanie 28
Zasada programowania obiektowego, która polega na ukrywaniu elementów klasy tak, aby były one dostępne wyłącznie dla metod tej klasy lub funkcji zaprzyjaźnionych, to
A. hermetyzacjaPoprawna odpowiedź
B. dziedziczenieTwoja odpowiedź
C. wyjątki
D. polimorfizm
Niepoprawna odpowiedź. W programowaniu obiektowym często pojawiają się takie pojęcia jak wyjątki, polimorfizm czy dziedziczenie, ale żadne z nich nie opisuje procesu ukrywania danych wewnątrz klasy. Wyjątki to mechanizm obsługi błędów, który pozwala na reagowanie na nieprzewidziane sytuacje w trakcie działania programu, ale nie ma on nic wspólnego z kontrolą dostępu do danych czy zabezpieczaniem pól klasy. Polimorfizm z kolei polega na tym, że obiekty różnych klas mogą być traktowane jako obiekty wspólnej klasy bazowej – tu chodzi o możliwość wywoływania metod w taki sam sposób na różnych typach, co ułatwia projektowanie elastycznego kodu, ale nie dotyka kwestii ukrywania szczegółów przed użytkownikiem klasy. Dziedziczenie umożliwia tworzenie nowych klas na podstawie już istniejących, co pozwala na przejmowanie właściwości i metod, ale samo w sobie nie ogranicza dostępu do danych – wręcz przeciwnie, nieumiejętne użycie dziedziczenia może prowadzić do nadmiernego ujawnienia szczegółów implementacji. Typowym błędem myślowym jest mylenie hermetyzacji z samą ochroną przed błędami (czyli wyjątkami) lub utożsamianie jej z mechanizmami dziedziczenia – tymczasem hermetyzacja to przede wszystkim kontrola dostępu i świadome ograniczanie widoczności danych oraz metod. W codziennej praktyce programistycznej hermetyzacja jest kluczowa dla bezpieczeństwa, utrzymania i rozwoju oprogramowania, dlatego warto rozróżniać te koncepcje i wiedzieć, do czego służy każda z nich.
Pytanie 29
W klasie pracownik zdefiniowano następujące metody:
Która z nich jest odpowiednia do dodania elementu diagnostycznego o treści:
cout << "Obiekt został usunięty";
A.
operator==
B.
wypisz
Twoja odpowiedź
C.
pracownik
D.
~pracownik
Poprawna odpowiedź
Niepoprawna odpowiedź. Metoda wypisz jest często używana do prezentacji danych obiektu użytkownikowi ale nie jest miejscem do umieszczania kodu diagnostycznego dotyczącego usuwania obiektu. Wypisz jest zazwyczaj metodą statyczną lub instancyjną odpowiedzialną za wyświetlanie stanu obiektu i nie zajmuje się zarządzaniem jego cyklem życia. Umieszczenie w niej elementu diagnostycznego dotyczącego destrukcji obiektu mogłoby wprowadzać w błąd użytkownika klasy i utrudniać utrzymanie spójności kodu. Konstruktor klasy pracownik jest odpowiedzialny za inicjalizację obiektu a nie za jego usuwanie. Dodanie elementu cout<<Obiekt został usunięty; w konstruktorze nie miałoby sensu ponieważ ten komunikat dotyczy momentu zniszczenia obiektu a nie jego tworzenia. Konstruktor powinien skoncentrować się na alokacji zasobów i przygotowaniu obiektu do użycia. Operator== jest używany do porównywania dwóch obiektów zazwyczaj w celu sprawdzenia ich równości. Jego użycie do umieszczania komunikatów diagnostycznych związanych z usunięciem obiektu byłoby nieodpowiednie i mylące gdyż jest to operacja logiczna i semantycznie niezwiązana z zarządzaniem cyklem życia obiektów. Rozumienie ról poszczególnych metod w klasach jest kluczowe dla pisania poprawnego i zgodnego z zasadami dobrych praktyk kodu co wpływa na jego czytelność i łatwość utrzymania. Stosowanie odpowiednich metod w odpowiednich kontekstach jest podstawą profesjonalnego programowania obiektowego w C++ i innych językach obiektowych co znacząco zwiększa efektywność i niezawodność oprogramowania.
Pytanie 30
Co to jest Redux?
A. Biblioteka do zarządzania stanem aplikacji w JavaScriptPoprawna odpowiedź
B. System kontroli wersji dla projektów JavaScript
C. Narzędzie do optymalizacji wydajności aplikacji ReactTwoja odpowiedź
D. Framework do tworzenia aplikacji mobilnych
Niepoprawna odpowiedź. Chociaż odpowiedzi związane z frameworkami do tworzenia aplikacji mobilnych, narzędziami do optymalizacji wydajności czy systemami kontroli wersji mogą być interesujące, nie są one związane z funkcją, jaką pełni Redux. Frameworki do tworzenia aplikacji mobilnych, takie jak React Native, pozwalają na rozwijanie aplikacji mobilnych z użyciem JavaScript, ale nie zarządzają one stanem aplikacji w sposób, w jaki robi to Redux. Optymalizacja wydajności aplikacji React nie jest bezpośrednią funkcją Redux; chociaż biblioteka ta może pośrednio przyczynić się do lepszej wydajności przez poprawne zarządzanie stanem, nie jest narzędziem służącym do optymalizacji. Z kolei systemy kontroli wersji, takie jak Git, służą do zarządzania historią zmian w kodzie źródłowym aplikacji, a nie do zarządzania stanem wykonawczej logiki aplikacji. Wybór niewłaściwego narzędzia wynika często z braku zrozumienia ich funkcji oraz zastosowania w procesie tworzenia aplikacji. Aby skutecznie zarządzać stanem w aplikacji, kluczowe jest zrozumienie różnic między tymi narzędziami oraz ich zastosowaniem w architekturze aplikacji, co jest fundamentalnym elementem współczesnego rozwijania oprogramowania.
Pytanie 31
Jakie jest rozwiązanie dla dodawania binarnego liczb 1011 oraz 110?
A. 11001
B. 11101
C. 10001Poprawna odpowiedź
D. 10101Twoja odpowiedź
Niepoprawna odpowiedź. W analizie błędnych odpowiedzi, pierwsza niepoprawna odpowiedź 11001 wynika z błędu w dodawaniu ostatniej kolumny. Osoba, która udzieliła tej odpowiedzi, mogła popełnić pomyłkę, nie uwzględniając przeniesienia z drugiej kolumny. W systemie binarnym nie można uzyskać wyniku 11001, ponieważ suma 0 + 1 w ostatnich kolumnach prowadzi do przeniesienia, a nie do dodania wartości. Druga propozycja, 10101, może być efektem pomylenia wartości i przeniesień w trakcie dodawania. Wartości w odpowiednich kolumnach są zinterpretowane niepoprawnie. Tutaj również brakuje uwzględnienia przeniesienia, co prowadzi do wyniku, który nie odzwierciedla rzeczywistego sumowania w systemie binarnym. Ostatnia niepoprawna odpowiedź, 11101, zawiera błąd związany z dodawaniem wartości bez przeniesienia. Sumowanie 1 + 1 w drugiej kolumnie prowadzi do 0 z przeniesieniem, co zostało pominięte. W każdej z tych odpowiedzi występuje zrozumienie błędów w arytmetyce binarnej, które są fundamentalne dla prawidłowego obliczania w systemach cyfrowych.
Pytanie 32
Programista projektuje obsługę bufora drukowania dokumentów. Najnowsze zadanie drukowania jest ustawiane na końcu kolejki, a najstarsze jest przekazywane do wydruku. Strukturą danych najlepiej pasującą do problemu jest
A. stosTwoja odpowiedź
B. LIFO
C. FIFOPoprawna odpowiedź
D. sterta
Niepoprawna odpowiedź. W tym zadaniu łatwo pomylić pojęcia, bo kilka odpowiedzi brzmi podobnie technicznie, ale opisują zupełnie inne zachowanie. Stos działa według zasady LIFO, czyli Last In, First Out. Oznacza to, że element dodany jako ostatni jest zdejmowany jako pierwszy. Gdyby bufor drukowania działał jak stos, to najnowszy dokument byłby drukowany przed starszymi. W praktyce byłoby to dość kiepskie i niesprawiedliwe, bo starsze zadania mogłyby czekać bardzo długo, a nawet zostać ciągle spychane przez nowsze dokumenty. Z mojego doświadczenia uczniowie często kojarzą dodawanie na koniec z operacją push na stosie, ale zapominają, że kluczowe jest też to, skąd element jest później pobierany.
Sterta też nie jest właściwym wyborem dla zwykłego bufora drukowania. Heap służy głównie do sprawnego wybierania elementu o największym albo najmniejszym priorytecie, na przykład w kolejce priorytetowej. To ma sens, gdy zadania mają priorytety, terminy lub koszty, ale w treści pytania nie ma nic o priorytetach. Jest za to wyraźnie powiedziane, że najstarsze zadanie ma iść do wydruku. LIFO jako sama zasada również odpada, bo jest przeciwieństwem oczekiwanego zachowania. Poprawne myślenie jest takie: skoro pierwszy dokument, który trafił do bufora, ma być pierwszy obsłużony, to potrzebujemy kolejki FIFO. W profesjonalnych systemach taki wybór daje przewidywalność, prostszą diagnostykę i zachowanie zgodne z intuicją użytkownika.
Pytanie 33
Który z poniższych elementów nie jest związany z architekturą mikroserwisów?
A. Komunikacja przez APITwoja odpowiedź
B. Niezależne wdrażanie usług
C. Monolityczny kod źródłowyPoprawna odpowiedź
D. Skalowalność poszczególnych usług
Niepoprawna odpowiedź. Każda z pozostałych odpowiedzi na pytanie odnosi się do kluczowych aspektów architektury mikroserwisów. Niezależne wdrażanie usług jest jednym z głównych założeń mikroserwisów, ponieważ umożliwia autonomiczne aktualizacje i rozwój poszczególnych komponentów systemu bez konieczności przerywania działania całej aplikacji. Komunikacja przez API jest niezbędna dla współpracy między mikroserwisami, ponieważ pozwala na wymianę danych i poleceń w sposób zorganizowany i niezależny. Wreszcie, skalowalność poszczególnych usług oznacza, że można dostosować zasoby do zmieniających się potrzeb i obciążenia systemu, co jest kluczowe w dzisiejszych dynamicznych środowiskach IT. Typowym błędem jest zrozumienie architektury mikroserwisów jako jedynie rozdzielenia kodu. W rzeczywistości wymaga to zmiany podejścia do projektowania, wdrażania i zarządzania systemami. Nieprawidłowa interpretacja tych pojęć może prowadzić do stworzenia systemu, który nie wykorzystuje pełnych korzyści płynących z mikroserwisów, takich jak elastyczność, łatwość w skalowaniu i efektywne zarządzanie zespołami. Zamiast tego można wprowadzić architekturę, która jest jedynie zbiorem monolitów, co nie spełnia oczekiwań nowoczesnych aplikacji internetowych i mobilnych.
Pytanie 34
Jakie wartości jest w stanie przechować zmienna o typie logicznym?
A. Wartość w reprezentacji binarnej
B. Tylko ciąg znaków
C. Dowolną liczbę rzeczywistą
D. Jedną z dwóch opcji: true lub falseTwoja odpowiedź
Poprawna odpowiedź. Zmienna typu logicznego (boolean) może przechowywać jedną z dwóch wartości: 'true' lub 'false'. Są to podstawowe wartości wykorzystywane w operacjach warunkowych i pętlach, które decydują o przepływie sterowania w programach. Wartości logiczne są kluczowe w konstrukcjach takich jak 'if-else', pętlach 'while' oraz w porównaniach. W wielu językach programowania 'true' jest równoznaczne z 1, a 'false' z 0, co pozwala na łatwą integrację z typami całkowitymi. Typ boolean jest niezbędny w programowaniu, umożliwiając implementację decyzji, walidacji danych i automatyzacji procesów.
Pytanie 35
Z jakiej kolekcji powinno się korzystać, aby przechowywać informacje związane z elementem interfejsu użytkownika w taki sposób, aby ten element był informowany przez kolekcję o dodaniu, usunięciu lub zmianie jej zawartości?
A. Collection
B. KeyedCollection
C. ObservableCollectionPoprawna odpowiedź
D. ReadOnlyCollectionTwoja odpowiedź
Niepoprawna odpowiedź. Wiele osób potrafi pomylić, która kolekcja faktycznie nadaje się do powiązania z elementem UI, szczególnie gdy pracują z .NET i mają do wyboru tyle różnych klas. Collection czy KeyedCollection mogą kusić, bo na pierwszy rzut oka wydają się elastyczne – Collection to po prostu bazowa kolekcja generyczna, można ją dziedziczyć i rozszerzać, ale nie powiadamia automatycznie interfejsu o zmianach. KeyedCollection to niby sprytna hybryda listy i słownika, czasem się przydaje, gdy potrzebujesz szybkiego wyszukiwania po kluczu, ale znowu – nie ma mechanizmu powiadomień, więc UI się w ogóle o niczym nie dowie. Niektórzy błędnie myślą, że jakakolwiek kolekcja generyczna wystarczy do zbudowania dynamicznego widoku, ale to niestety prowadzi do konieczności manualnego odświeżania widoków albo tworzenia niepotrzebnych wrapperów. ReadOnlyCollection wydaje się atrakcyjna, bo zapewnia bezpieczeństwo, nie pozwala na modyfikacje przez użytkownika, ale tak naprawdę to tylko opakowanie, które nie wnosi żadnych zdarzeń informujących o zmianach. Moim zdaniem, jeśli zależy Ci na nowoczesnym, elastycznym i dynamicznym interfejsie opartym o wzorce MVVM czy MVU, to tylko ObservableCollection daje sensowne narzędzia do pracy. Pozostałe typy kolekcji są świetne, ale bardziej do scenariuszy nieinteraktywnych albo tam, gdzie synchronizacja z widokiem nie jest wymagana. Typowym błędem jest myślenie, że wystarczy po prostu zamienić List na cokolwiek innego, a UI się jakoś „odświeży” samo – to niestety tak nie działa. Prawidłowe powiązanie danych w .NET wymaga wsparcia dla notyfikacji zmian, a to zapewnia wyłącznie ObservableCollection i implementacje interfejsów powiadamiających o zmianie stanu kolekcji.
Pytanie 36
Jaka jest podstawowa funkcja narzędzia do zarządzania projektami?
A. Opracowanie bazy danych dla projektu
B. Zarządzanie zadaniami i czasem w projekcieTwoja odpowiedź
C. Poprawa wydajności kodu programu
D. Produkcja animacji komputerowych
Poprawna odpowiedź. Zarządzanie zadaniami i czasem to naprawdę kluczowa sprawa w projektach. Dzięki narzędziom takim jak Microsoft Project, Jira, Trello, czy Monday, zespoły mogą lepiej planować, przydzielać role i śledzić, co się dzieje. Możliwości tych narzędzi pozwalają ustalać deadline’y, priorytety, a nawet automatycznie przypominają o zbliżających się terminach. To super pomaga w unikaniu opóźnień i pozwala lepiej zorganizować pracę. Wizualizacja projektu w formie osi czasu czy tablicy kanban też jest mega przydatna, bo wszystko staje się bardziej czytelne.
Pytanie 37
Jaki będzie wynik działania poniższego kodu JavaScript?
letx=5;lety='10';console.log(x+y);
A. 15
B. undefined
C. 510Twoja odpowiedź
D. error
Poprawna odpowiedź. Wynik działania podanego kodu to 510, co może być zaskakujące dla osób nieznających typów danych w JavaScript. W tym przypadku zmienna x jest liczbą całkowitą (5), a zmienna y jest łańcuchem tekstowym ('10'). Kiedy używamy operatora + w JavaScript, następuje tzw. "przesunięcie typów". Gdy jeden z operandów jest łańcuchem, to JavaScript konwertuje pozostałe typy na łańcuch, a następnie wykonuje konkatenację. W efekcie 5 konwertowane jest na '5', a wynik końcowy to '5' + '10', co daje '510'. To zachowanie jest zgodne z regułami języka JavaScript i jego dynamicznym typowaniem. Warto zwrócić uwagę, że taka konwersja może prowadzić do niezamierzonych wyników, dlatego ważne jest, aby zrozumieć, kiedy i jak działają operatory w JavaScript. Dla większej jasności, w sytuacjach, gdy chcemy dodać dwie liczby, lepiej jest upewnić się, że obie zmienne mają ten sam typ danych, np. przez użycie funkcji parseInt() lub parseFloat().
Pytanie 38
Zgodnie z dokumentacją dotyczącą menu Navbar z biblioteki Bootstrap 4, w celu stworzenia menu należy zdefiniować listę
A standard navigation bar is created with the .navbar class, followed by a responsive collapsing class: .navbar-expand-xl|lg|md|sm (stacks the navbar vertically on extra large, large, medium or small screens). To add links inside the navbar, use a <ul> element with class="navbar-nav". Then add <li> elements with a .nav-item class followed by a <a> element with a .nav-link class... Use any of the .bg-color classes to change the background color of the navbar (.bg-primary, .bg-success, .bg-info, .bg-warning, .bg-danger, .bg-secondary, .bg-dark and .bg-light) Tip: Add a white text color to all links in the navbar with the .navbar-dark class, or use the .navbar-light class to add a black text color.
Źródło: https://www.w3schools.com/bootstrap4
A.
< ol class="a, .nav-item" > ... < /ol>
B.
< ol class="navbar-nav" > ... < /ol>
Twoja odpowiedź
C.
< ul class="navbar-nav" > ... < /ul>
Poprawna odpowiedź
D.
< ul class="a, .nav-item" > ... < /ul>
Niepoprawna odpowiedź. Wiele osób zaczynających przygodę z Bootstrappem myli się, jeśli chodzi o strukturę nawigacji. Często wynika to z przyzwyczajeń z HTML-a, gdzie listy uporządkowane (ol) czy inne niestandardowe klasy wydają się równie dobre. Jednak Bootstrap opiera swoje style i działanie navbarów właśnie na nieuporządkowanej liście (<ul>) z klasą "navbar-nav". Jeśli zastosujesz <ol> zamiast <ul>, nawet z poprawną klasą, efekty mogą być nieprzewidywalne – style nie będą się nakładały, elementy mogą być nieprawidłowo ustawione, a całość przestanie być responsywna. Podobnie wpisanie do atrybutu class kilku klas naraz, które nie istnieją razem w dokumentacji (np. "a, .nav-item"), nie wywoła żadnego efektu – przeglądarka po prostu je zignoruje lub potraktuje jako pojedynczą dziwną klasę, co oczywiście nie jest intencją Bootstrapa. Z mojego doświadczenia wynika, że najczęstszym błędem jest próba uproszczenia lub skrócenia kodu z pominięciem standardów frameworka – to prowadzi do chaosu w kodzie i problemów przy dalszym rozwoju. Warto pamiętać, że Bootstrap 4 jest bardzo rygorystyczny, jeśli chodzi o mapowanie selektorów CSS na konkretne struktury HTML. To dlatego lista <ul> z klasą "navbar-nav" jest wymagana – bez niej navbar po prostu nie zadziała poprawnie. Zbyt wiele razy widziałem strony, gdzie menu było rozjechane, bo ktoś próbował użyć <ol>, <div> albo nieprawidłowych klas. Dla zachowania kompatybilności i ułatwienia sobie życia, zdecydowanie polecam trzymać się zalecanej przez dokumentację struktury. Nawet jeśli wygląda to na powtarzalność, to w rzeczywistości pozwala zaoszczędzić sporo czasu i uniknąć problemów podczas testowania na różnych urządzeniach czy przeglądarkach.
Pytanie 39
W zamieszczonej ramce znajdują się notatki testera dotyczące przeprowadzanych testów aplikacji. Jakiego typu testy planuje przeprowadzić tester?
zmierzyć czas zalogowania się użytkownika
ustalić domyślną liczbę produktów na stronie, dla której renderowanie jest akceptowalne czasowo
czy wizualizacja danych na mapie przebiega bez opóźnień?
czy czas logowania wzrasta znacznie przy logowaniu 10 użytkowników, 100, 1000?
jaka minimalna prędkość pobierania jest wymagana, aby aplikacja była zaakceptowana przez klienta?
A. WydajnościoweTwoja odpowiedź
B. Bezpieczeństwa
C. Jednostkowe
D. Interfejsu
Poprawna odpowiedź. Testy wydajnościowe są kluczowe dla zapewnienia, że system działa sprawnie pod różnym obciążeniem. Są one wykonywane, aby zrozumieć, jak aplikacja zachowuje się w warunkach rzeczywistych, kiedy wiele użytkowników korzysta z niej jednocześnie. W pytaniu wymienione zostały zadania takie jak mierzenie czasu logowania się użytkowników oraz sprawdzanie, czy czas ten wzrasta wraz ze wzrostem liczby użytkowników. To typowe aspekty testów wydajnościowych. Takie testy pomagają określić limity skalowalności i zapewniają, że aplikacja może obsługiwać oczekiwaną liczbę użytkowników bez spadku wydajności. Standardy branżowe, takie jak ISO/IEC 25010, zwracają uwagę na konieczność testowania wydajności, by zidentyfikować potencjalne wąskie gardła i zapewnić satysfakcjonujące doświadczenia użytkownikom. Dobrymi praktykami są używanie narzędzi takich jak JMeter czy LoadRunner, które umożliwiają symulację obciążenia i analizę wyników w celu optymalizacji kodu i infrastruktury. Tego typu testy są nieodzowne przed wdrożeniem aplikacji produkcyjnej, aby zapewnić jej niezawodne działanie.
Pytanie 40
W przedsiębiorstwie IT obowiązują określone zasady dotyczące zarządzania projektami, co wskazuje, że firma wykorzystuje model zarządzania
Prace dzielimy na sprinty 1 tygodniowe.
Każdy sprint obejmuje mały fragment funkcjonalności aplikacji.
Sprint rozpoczynamy od podziału prac i dyskusji.
Sprint kończymy na zatwierdzeniu testów przez klienta.
A. prototypowy
B. kaskadowy
C. zwinnyPoprawna odpowiedź
D. spiralnyTwoja odpowiedź
Niepoprawna odpowiedź. W zarządzaniu projektami IT bardzo łatwo pomylić różne modele, zwłaszcza gdy pojawiają się podobne pojęcia, takie jak iteracje czy testowanie. Model prototypowy polega na szybkim tworzeniu wstępnych wersji produktu (prototypów), które następnie są pokazywane klientowi w celu zebrania opinii i stopniowego dopracowania finalnej wersji. Jednak nie ma tam stałej struktury czasowej jak np. sprinty, a główny nacisk jest na iteracyjne budowanie kolejnych wersji, a nie regularne, powtarzalne cykle pracy. Model kaskadowy (waterfall) jest wręcz przeciwieństwem zwinności – to sztywny, liniowy proces, gdzie każda faza (analiza, projektowanie, implementacja, testowanie, wdrożenie) musi być ukończona przed przejściem do następnej. Tutaj nie ma miejsca na podział na krótkie sprinty ani na regularne zatwierdzanie przez klienta po każdej iteracji – klient zazwyczaj widzi produkt dopiero na końcu projektu. Spiralny to z kolei model ryzyka, gdzie projektowanie, budowanie i testowanie odbywa się cyklicznie, ale głównym celem jest minimalizacja ryzyka przy każdej „spirali”, a nie iteracyjna budowa małych fragmentów systemu. W praktyce, błędne przypisanie tych modeli do opisanej sytuacji często wynika z utożsamiania jakiejkolwiek iteracyjności z podejściem zwinnym. Ale tylko zwinność (agile) stawia na krótki, powtarzalny cykl (sprint), ciągły kontakt z klientem i szybkie dostarczanie drobnych przyrostów funkcjonalności, przy czym klient aktywnie uczestniczy w każdym etapie, a nie tylko na początku i końcu. No i najważniejsze – to właśnie zwinne metody jak Scrum czy Kanban są obecnie standardem w większości firm IT zatrudniających zespoły programistyczne. Pozostałe modele stosuje się raczej tam, gdzie wymagania są z góry bardzo dobrze znane, albo tam, gdzie ryzyko musi być zarządzane w wyjątkowo formalny sposób, np. w branży lotniczej czy militarnej.