Kwalifikacja: INF.04 - Projektowanie, programowanie i testowanie aplikacji
Rozpoczęcie: 29 września 2026 00:48
Zakończenie: 29 września 2026 01:08 Rozwiązano w aplikacji mobilnej
Egzamin zdany!
Wynik: 25/40 punktów (62,5%)
Wymagane minimum: 20 punktów (50%)
Pewność odpowiedzi
Jako strzał oznaczono 7 odpowiedzi - trafionych: 2.
Z odpowiedzi deklarowanych jako pewne poprawnych było 23 z 33. Trafiony strzał to nie jest wiedza - te pytania warto powtórzyć w pierwszej kolejności.
Twój wynik na tle innych
Twój wynik jest lepszy niż 31% podejść do kwalifikacji INF.04.
Porównanie z 23418 zakończonymi podejściami do tej kwalifikacji (dane zbiorcze, bez wyników indywidualnych).
Poprzednio 80,0%, teraz 62,5% (-17,5 p.p.).
Zachowaj ten wynik na koncie
Załóż darmowe konto albo zaloguj się - ten egzamin przypiszemy do Twojego konta, więc wrócisz do swoich błędów, będziesz śledzić postęp i dostaniesz powtórki dobrane do Twoich odpowiedzi.
Poprawna odpowiedź. Ta odpowiedź dobrze pokazuje, jak działa dziedziczenie i modyfikatory dostępu w C#. W klasie GoldCustomer masz dostęp do własnych pól, czyli GoldPoints, oraz do pól odziedziczonych po klasie bazowej Customer. Tutaj kluczowe jest rozumienie, które pola są faktycznie dostępne. Skoro Name jest publiczne, to bez żadnych kombinacji można się do niego dobrać z dowolnego miejsca – nawet spoza klasy. Id jest chronione (protected), więc według zasad OOP dostępne jest w klasie bazowej oraz wszystkich pochodnych – czyli właśnie w GoldCustomer. To bardzo praktyczne, bo często się zdarza, że potrzebujemy pracować na polach z klasy bazowej, ale nie chcemy, żeby były one widoczne na zewnątrz klasy (np. przez innych programistów korzystających z API). Age jest prywatne i tu już nie da się go bezpośrednio użyć w klasie pochodnej. Z mojego doświadczenia korzystanie z protected dla rzeczy, które mają być dostępne tylko w hierarchii dziedziczenia, to codzienność – pozwala zachować elastyczność, ale i bezpieczeństwo enkapsulacji. Praktycznie rzecz biorąc, jak piszesz klasy dziedziczące po innych, zawsze warto zerknąć na poziomy dostępu, bo od nich zależy, do czego masz dostęp i co możesz odziedziczyć. Wzorce projektowe, jak np. Template Method, mocno polegają na mechanizmach dziedziczenia i odpowiedniego ustawienia widoczności pól czy metod. Przemyślany dobór public, protected, private ułatwia utrzymanie kodu oraz chroni przed przypadkowym wykorzystaniem nieodpowiednich elementów klasy, co w większych projektach bywa naprawdę kluczowe.
Pytanie 2
Kod w bibliotece React.js oraz w frameworku Angular, który został zaprezentowany, ma na celu wyświetlenie
D. wyłącznie przycisku oraz obsłużenie zdarzenia click, które ono generujeTwoja odpowiedź
Niepoprawna odpowiedź. Wydaje się, że łatwo tu popaść w uproszczenia lub ulec pierwszemu wrażeniu na temat działania tego kodu, zwłaszcza jeśli nie patrzy się na całą strukturę zarówno w React, jak i Angularze. Sam przycisk z napisem BTN_1 faktycznie występuje, ale nie to jest sednem – komponenty nie ograniczają się tylko do wyświetlania przycisku. Ich główną rolą jest obsługa interakcji: kliknięcie nie tylko wywołuje zdarzenie, lecz przede wszystkim modyfikuje stan licznika i od razu aktualizuje widok. Sądząc, że program ma wyświetlać „tylko napis” lub „tylko przycisk i obsługę click”, pomija się istotę działania frameworków: dynamiczną prezentację danych w odpowiedzi na działania użytkownika. Pojawia się też czasem mylne założenie, że widok pokazuje wartość 0 po kliknięciu – to nieprawda, bo oba fragmenty kodu startują z wartością 0, ale po kliknięciu ta wartość jest zwiększana i od razu pokazuje nową liczbę kliknięć. To bardzo typowy błąd, wynikający z niezrozumienia jak aktualizowany jest stan komponentu i jak natychmiast to wpływa na renderowanie widoku. Trzeba jeszcze pamiętać, że samo „obsłużenie zdarzenia click” jest tylko częścią procesu – pełna funkcjonalność polega na wyświetleniu aktualnej liczby kliknięć, czyli dynamicznej reakcji na akcje użytkownika. Dlatego w branży kładzie się nacisk na powiązanie warstwy widoku z logiką biznesową poprzez stan komponentu – to jest podstawa nowoczesnych aplikacji. Zakładając, że chodzi tylko o statyczny element lub samo zdarzenie, zupełnie pomija się sedno tego typu zadań, gdzie właśnie dynamiczna aktualizacja UI po akcji użytkownika jest kluczowa. Takie błędne założenia często biorą się z pobieżnego czytania kodu lub nieznajomości mechanizmów reaktywności i data bindingu, które są fundamentem zarówno Reacta, jak i Angulara.
Pytanie 3
W jakim modelu Cyklu Życia Projektu Informatycznego znajduje się etap analizy ryzyka?
A. W spiralnymPoprawna odpowiedź
B. W kaskadowymTwoja odpowiedź
C. W modelu z prototypem
D. W modelu Fry’ego
Niepoprawna odpowiedź. Często spotyka się przekonanie, że analiza ryzyka jest obecna w każdym modelu cyklu życia projektu informatycznego, ale to nie do końca tak działa. W modelu kaskadowym, czyli tzw. waterfall, wszystko odbywa się etapami – analiza, projektowanie, implementacja i tak dalej, w sztywno określonej kolejności. Tu niestety nie ma miejsca na systematyczną analizę ryzyka na każdym etapie, bo cała koncepcja tego modelu polega na tym, że raz wykonane czynności trudno potem cofnąć lub poprawić, szczególnie gdy coś pójdzie nie tak. To, moim zdaniem, jest jeden z powodów, dla których model kaskadowy bywa krytykowany – brak elastyczności i mała odporność na niespodziewane problemy. Podobnie jest w modelu z prototypem – tam niby tworzy się szybkie makiety czy prototypy, ale głównym celem jest poznanie potrzeb użytkownika i szybkie zebranie informacji zwrotnej, a nie formalna analiza ryzyka. Ryzyko oczywiście można zidentyfikować przy okazji, ale nie jest to centralny punkt tego podejścia. Model Fry’ego to już zupełnie inna bajka – jest bardzo liniowy, nacisk kładzie raczej na dokumentację i ścisłe trzymanie się etapów, a nie na adaptacyjność czy zarządzanie niepewnością. Z mojego punktu widzenia, błędne wybranie któregoś z tych modeli jako tego, gdzie analizuje się ryzyko, wynika z przekonania, że wszędzie jest miejsce na refleksję nad zagrożeniami – niestety, tylko model spiralny wprost i metodycznie wpisuje analizę ryzyka w swój rdzeń. W innych przypadkach analiza ryzyka jeśli się pojawia, to głównie z inicjatywy zespołu, a nie jako zaplanowany, powtarzający się etap procesu. Warto o tym pamiętać przy wyborze metodyki do danego projektu – nie każda zapewni takie same mechanizmy zabezpieczające przed błędami i nieprzewidzianymi zdarzeniami.
Pytanie 4
Z jakiej kolekcji powinno się korzystać, aby przechowywać informacje związane z elementem interfejsu użytkownika w taki sposób, aby ten element był informowany przez kolekcję o dodaniu, usunięciu lub zmianie jej zawartości?
A. ObservableCollectionTwoja odpowiedź
B. KeyedCollection
C. Collection
D. ReadOnlyCollection
Poprawna odpowiedź. ObservableCollection to zdecydowanie najlepszy wybór w sytuacji, gdy zachodzi potrzeba powiadamiania elementów interfejsu użytkownika o zmianach w kolekcji. W praktyce, kiedy pracujesz np. z WPF, UWP albo MAUI, to ObservableCollection automatycznie informuje UI o dodaniu, usunięciu czy modyfikacji elementów. Wszystko dzięki temu, że implementuje interfejs INotifyCollectionChanged. Moim zdaniem praktyczne zastosowanie jest mega – gdy masz np. listę produktów, która wyświetla się użytkownikowi, to po prostu dokładasz lub usuwasz elementy z ObservableCollection i nie musisz ręcznie odświeżać widoku. Framework sam ogarnia powiązanie danych, bo kolekcja emituje zdarzenia CollectionChanged. Takie podejście jest spójne z zasadami MVVM i ogólnie promowane przez Microsoft w oficjalnych dokumentacjach. Często spotkać można rozwiązania, gdzie ktoś używa zwykłej List lub Collection, ale wtedy tracisz te automatyczne powiadomienia i pojawia się masa kodu-boilerplate. Szczerze mówiąc, nie widzę sensu kombinować z innymi kolekcjami, jeśli zależy Ci na dynamicznym, responsywnym UI. ObservableCollection to po prostu standard branżowy w .NET, jak dla mnie nie ma lepszej opcji na takie zastosowania.
Pytanie 5
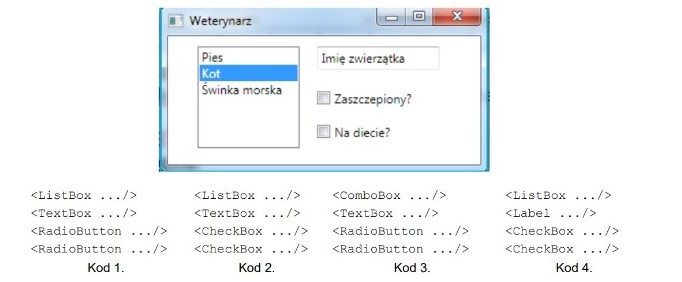
Wskaż uproszczoną wersję kodu XAML dla elementów w pokazanym oknie dialogowym?
Kod 3
Kod 1
Kod 2Twoja odpowiedź
Kod 4
Poprawna odpowiedź. Dobrze jest znać podstawowe różnice pomiędzy ListBox, ComboBox, CheckBox, RadioButton oraz Label w XAML. W tym oknie dialogowym widać wyraźnie, że po lewej stronie użytkownik ma możliwość wyboru gatunku zwierzęcia spośród kilku opcji wyświetlonych jednocześnie. Takie zadanie najlepiej spełnia ListBox, bo umożliwia wygodną selekcję z widocznej listy. U góry po prawej jest pole tekstowe do wpisania imienia zwierzaka, więc TextBox jak najbardziej pasuje. Poniżej mamy dwa pola wyboru – „Zaszczepiony?” i „Na diecie?” – to są typowe przypadki na CheckBoxy: można zaznaczyć dowolne lub oba naraz. Kluczowe jest to, że CheckBox pozwala użytkownikowi wybrać dowolną kombinację, a nie tylko jedną opcję jak RadioButton. Z mojego doświadczenia często początkujący mylą ComboBox z ListBoxem, ale tu akurat lista jest zawsze widoczna, co jest typowe dla ListBoxa. Stosowanie CheckBoxów dla takich dwustanowych opcji też jest zgodne z dobrymi praktykami UX i standardami opisu formularzy w XAML. W pracy zawodowej często się to wykorzystuje, bo kod jest czytelny i łatwo go rozszerzać. Właśnie taki zestaw – ListBox, TextBox, CheckBox – jest najbardziej przejrzysty i zgodny z zamysłem projektanta interfejsów. Fajnie jest to zapamiętać, bo ta kombinacja pojawia się w wielu firmowych projektach.
Pytanie 6
Przedstawiony na filmie kod napisany w języku C++ nie kompiluje się. Co należy zmienić w tym kodzie, aby proces kompilacji wykonał się bez błędów?
A. dodać deklarację funkcji sprawdz przed funkcją mainPoprawna odpowiedź
B. poprawnie zapisać warunek w instrukcji if w linii 11, np. sprawdz(x)==true
C. naprawić błąd w funkcji sprawdz, który polega na braku nawiasów {} w pętli for
D. zadeklarować zmienną sprawdz przed jej wykorzystaniem w linii 11Twoja odpowiedź
Niepoprawna odpowiedź. Wielu początkujących programistów skupia się na szczegółach składniowych lub drobiazgach logicznych, kiedy pojawia się błąd kompilacji w C++. Jednak często przyczyną jest coś bardzo podstawowego, jak brak deklaracji funkcji przed jej użyciem. Jeśli chodzi o zapis warunku w instrukcji 'if', to kompilator nie zgłasza błędu, gdy używamy wyrażenia typu 'if (sprawdz(x))' – to całkowicie poprawna składnia, a dopisywanie '==true' jest redundantne i nie wnosi niczego nowego. Bardzo często widzę, że ktoś skupia się na tym, żeby warunek koniecznie porównywać do true, ale tak naprawdę to kwestia stylu, nie poprawności. Pozostawienie nawiasów klamrowych w pętli for jest oczywiście dobrą praktyką, ale ich brak nie zawsze generuje błąd kompilacji, jeśli pętla ma tylko jedną instrukcję. Kompilator C++ potrafi to rozpoznać i nie zgłasza błędu – sprowadza się to bardziej do czytelności i unikania błędów logicznych niż do samej poprawności kompilacji. Odpowiedź dotycząca deklarowania zmiennej 'sprawdz' to już nieporozumienie – 'sprawdz' to funkcja, a nie zmienna, więc nie deklarujemy jej w ten sposób. Ten błąd pokazuje, jak łatwo pomylić pojęcia w językach programowania, zwłaszcza jeśli dopiero zaczynamy przygodę z kodowaniem. Główna zasada, którą warto tu zapamiętać, to: każda funkcja używana przed jej zdefiniowaniem musi być zadeklarowana – to właśnie tego brakuje w typowym przykładzie z pytania. Bez deklaracji kompilator nie wie, jaką sygnaturę ma funkcja, a to skutkuje błędem już na poziomie kompilacji. Z mojego doświadczenia wynika, że takie drobne rzeczy potrafią skutecznie utrudnić życie, dlatego warto czytać komunikaty kompilatora i znać podstawowe zasady działania języka C++.
Pytanie 7Strzał
Aby zdefiniować zmienną, która będzie działała jako licznik instancji danej klasy, należy wprowadzenie takiego zmiennej poprzedzić słowem kluczowym
A.
register
B.
static
Twoja odpowiedź
C.
operator
D.
virtual
Poprawna odpowiedź. Słowo kluczowe static jest absolutnie podstawą, jeśli chodzi o definiowanie zmiennych, które mają być współdzielone przez wszystkie instancje danej klasy. Gdy w klasie utworzysz zmienną statyczną, nie jest ona powiązana z żadnym konkretnym obiektem, tylko istnieje jedna taka zmienna dla całej klasy, niezależnie od liczby utworzonych obiektów. To niesamowicie przydatne, np. właśnie przy liczeniu instancji – wystarczy inkrementować taką zmienną w konstruktorze. W C++ czy Javie jest to standardowy sposób na śledzenie, ile obiektów danego typu zostało utworzonych. Z mojej perspektywy, korzystanie ze static to nie tylko wygoda, ale też sygnał dla innych programistów, że dana wartość jest globalna w kontekście klasy, a nie obiektu. Przykład praktyczny: jeżeli masz klasę Samochód i chcesz wiedzieć, ile samochodów zostało już utworzonych, to deklarujesz static int licznik; i za każdym razem, gdy konstruktor się odpala, robisz licznik++. Takie podejście jest bardzo czytelne i od razu wiadomo, o co chodzi. Warto też pamiętać, że static może być używany nie tylko do liczenia instancji, ale też do przechowywania różnych konfiguracji czy referencji do wspólnych zasobów. Zdecydowanie jest to jedna z lepszych praktyk, szczególnie kiedy program zaczyna rosnąć i zależy nam na porządku w kodzie.
Pytanie 8Strzał
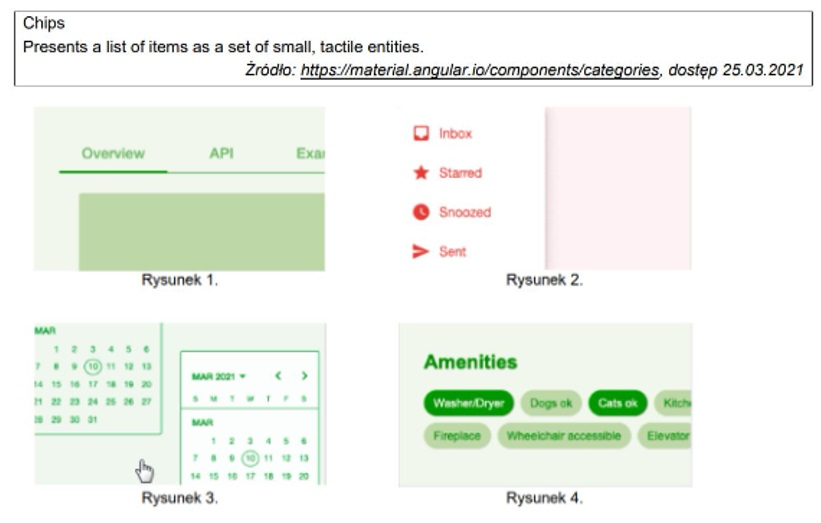
Na podstawie definicji zamieszczonej w ramce, wskaż, który z rysunków ilustruje komponent Chip zdefiniowany w bibliotece Angular Material?
Rysunek 1
Rysunek 2
Rysunek 3
Rysunek 4Twoja odpowiedź
Poprawna odpowiedź. Komponent Chip w bibliotece Angular Material to interaktywny element, który reprezentuje fragment informacji, tag lub wybór. Może zawierać tekst, ikonę lub być klikalny, co czyni go niezwykle użytecznym w projektowaniu nowoczesnych interfejsów użytkownika. Komponenty tego typu często wykorzystywane są w formularzach lub systemach tagowania, umożliwiając użytkownikowi intuicyjne dodawanie lub usuwanie elementów. Wyróżnia się swoją minimalistyczną formą i możliwością dostosowania do różnych potrzeb projektowych.
Pytanie 9
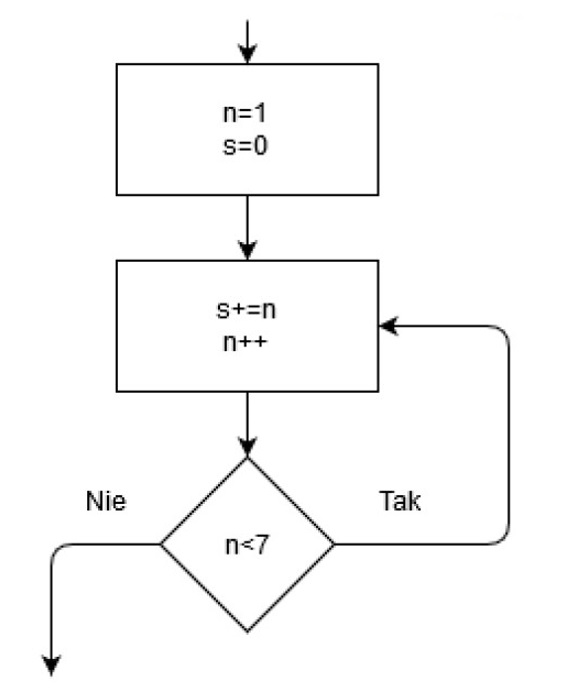
Na ilustracji pokazany jest fragment diagramu blokowego pewnego algorytmu. Ile razy warunek n<7 będzie badany?
A. 8
B. 5
C. 7
D. 6Twoja odpowiedź
Poprawna odpowiedź. Odpowiedź 4 jest prawidłowa ponieważ algorytm rozpoczyna od n równego 1 i zwiększa tę wartość o jeden w każdej iteracji aż do momentu gdy n stanie się równe 7 Wtedy warunek n mniejsze od 7 przestaje być spełniony co oznacza że warunek ten jest sprawdzany łącznie 6 razy tj dla n równych 1 2 3 4 5 i 6 Jest to typowa pętla kontrolna często spotykana w programowaniu gdzie warunek pętli decyduje o jej zakończeniu W praktyce takie podejście pozwala na efektywne zarządzanie liczbą iteracji i zapewnia klarowność kodu Co więcej użycie pętli z warunkiem końcowym jest zgodne z dobrymi praktykami projektowania algorytmów gdyż minimalizuje ryzyko błędów logicznych poprzez jawne określenie końca pętli Ponadto zrozumienie mechanizmu działania pętli i jej warunków jest kluczowe dla optymalizacji algorytmów i efektywnego zarządzania zasobami co ma bezpośrednie przełożenie na wydajność aplikacji szczególnie w środowiskach wymagających dużej mocy obliczeniowej
Pytanie 10Strzał
Jak nazywa się wzorzec projektowy, do którego odnosi się ta definicja?
Wzorzec projektowy należący do grupy wzorców strukturalnych. Służy do ujednolicenia dostępu do złożonego systemu poprzez wystawienie uproszczonego, uporządkowanego interfejsu programistycznego, który ułatwia jego użycie.
Źródło Wikipedia. Wolna encyklopedia
A. FasadaPoprawna odpowiedź
B. Prototyp
C. DekoratorTwoja odpowiedź
D. Kompozyt
Niepoprawna odpowiedź. Prototyp to wzorzec kreacyjny, który koncentruje się na tworzeniu nowych obiektów poprzez klonowanie istniejących. Różni się od fasady, ponieważ nie zajmuje się uproszczeniem interfejsów, lecz optymalizacją procesu tworzenia obiektów. Jest używany, gdy klasy instancji mają podobne stany i konieczne jest szybkie ich generowanie z zachowaniem pewnych właściwości. Dekorator natomiast to wzorzec strukturalny umożliwiający dynamiczne dodawanie nowych funkcjonalności do obiektów, bez modyfikacji ich struktury bazowej. Podstawowym celem dekoratora jest rozszerzenie możliwości obiektów, co odróżnia go od fasady, która skupia się na upraszczaniu dostępu do złożonych systemów. Dekorator działa na poziomie pojedynczych komponentów, gdzie fasada dotyczy całego systemu. Kompozyt umożliwia tworzenie hierarchicznych struktur obiektowych, pozwalając na jednolite traktowanie indywidualnych obiektów i ich złożonych struktur. Umożliwia pracę z drzewiastymi strukturami danych, co czyni go bardziej odpowiednim do zastosowań, gdzie istotna jest praca z kolekcjami obiektów jako całością. Wszystkie te wzorce mają odmienne założenia i zastosowania, a błąd w ich rozpoznaniu może wynikać z braku zrozumienia ich specyficznych ról i miejsc w architekturze oprogramowania. Wybór odpowiedniego wzorca wymaga zrozumienia zarówno wymagań systemowych, jak i ich długoterminowych implikacji na projekt i utrzymanie oprogramowania. Każdy z tych wzorców wnosi unikalne wartości, ale ich zastosowanie powinno być zgodne z konkretnymi potrzebami projektowymi i architektonicznymi systemu, nad którym się pracuje.
Pytanie 11
Zapisany fragment w C# wskazuje na definicję klasy Car, która:
public classCar: Vehicle{ ... }
A. jest powiązana z klasą Vehicle
B. używa prywatnych pól klasy Vehicle
C. stanowi klasę bazową (nie dziedziczy po żadnej klasie)
D. dziedziczy po VehicleTwoja odpowiedź
Poprawna odpowiedź. W przedstawionym kodzie w języku C# mamy definicję klasy Car, która dziedziczy po klasie Vehicle. Dziedziczenie to fundamentalny mechanizm programowania obiektowego, pozwalający jednej klasie przejąć właściwości i metody innej klasy. W praktyce oznacza to, że klasa Car automatycznie zyskuje dostęp do metod i właściwości publicznych oraz chronionych klasy Vehicle, co umożliwia ponowne użycie kodu i zwiększa jego przejrzystość. Dziedziczenie jest kluczowe w projektowaniu skalowalnych systemów, gdzie umożliwia tworzenie bardziej specyficznych klas na podstawie klas ogólnych, co jest zgodne z zasadą DRY (Don't Repeat Yourself). Przykładowo, jeżeli klasa Vehicle zawiera metody takie jak Start() i Stop(), klasa Car może je wykorzystać bez konieczności ponownego definiowania. Dobre praktyki w programowaniu obiektowym zalecają wykorzystywanie dziedziczenia do tworzenia hierarchii klas, które logicznie odwzorowują relacje „jest-a” pomiędzy obiektami w systemie. Ważne jest też unikanie zbyt głębokiego dziedziczenia, co może prowadzić do skomplikowanego i trudnego w utrzymaniu kodu. Zrozumienie dziedziczenia jest kluczowe dla efektywnego wykorzystania wzorców projektowych, takich jak wzorzec projektowy Adapter czy Dekorator.
Pytanie 12
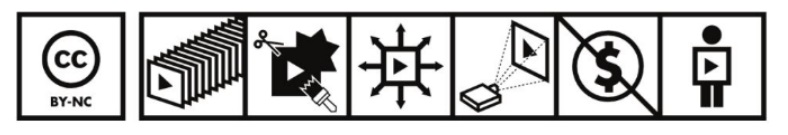
Zaprezentowane oznaczenie praw Creative Commons umożliwia bezpłatne wykorzystywanie utworu
A. w celach komercyjnych
B. pod warunkiem zachowania go w pierwotnej formie
C. w celu dokonywania zmian lub remiksowaniaPoprawna odpowiedź
D. pod warunkiem udostępnienia go na takiej samej licencjiTwoja odpowiedź
Niepoprawna odpowiedź. Pozostałe odpowiedzi zawierają błędne interpretacje dotyczące warunków licencji Creative Commons. Licencje takie jak CC BY-NC jasno określają, że utwory nie mogą być wykorzystywane w celach komercyjnych, co wyklucza możliwość zarabiania na nich bez zgody autora. To ograniczenie jest istotnym elementem licencji i zapewnia, że twórcy zachowują kontrolę nad komercyjnymi aspektami swojego dzieła. Przekonanie, że można swobodnie używać utworu w celach komercyjnych, jest częstym błędem wynikającym z niepełnego zrozumienia oznaczeń licencyjnych. Dodatkowo, sugerowanie że utwór musi być zostawiony w oryginalnej postaci jest charakterystyczne dla licencji NoDerivs (ND), która nie jest tu zastosowana. Taki wymóg ogranicza możliwość modyfikacji, co nie dotyczy licencji umożliwiających remiksowanie. Co więcej, niektóre licencje wymagają udostępniania dzieł pochodnych na tej samej licencji (ShareAlike), jednak nie jest to regułą dla wszystkich typów licencji i nie dotyczy bezpośrednio analizowanego przypadku. Pomyłki te często wynikają z niewłaściwego zapoznania się z symboliką i opisami licencji Creative Commons, co podkreśla potrzebę dokładnej analizy warunków przed ich zastosowaniem. Właściwe zrozumienie zasad i ograniczeń każdej licencji jest kluczowe, aby uniknąć nieintentionalnych naruszeń praw autorskich i promować odpowiedzialne podejście do wykorzystania zawartości twórczej w zróżnicowanych projektach i inicjatywach twórczych. Zrozumienie tych zasad nie tylko wspiera prawidłowe stosowanie licencji, ale także promuje etyczne zachowania wśród twórców i użytkowników zasobów cyfrowych.
Pytanie 13
Zaproponowany fragment kodu w Android Studio realizuje metodę nasłuchującą do obsługi wydarzenia:
Poprawna odpowiedź. Metoda OnClickListener, to coś, co na pewno warto znać, gdy pracujesz z aplikacjami na Androida. Gdy użytkownik klika przycisk, wywoływana jest metoda onClick. I tu możesz zrobić różne rzeczy, jak na przykład przejść do innego ekranu, zapisać dane albo uruchomić jakąś akcję w tle. To jest dobry przykład wzorca projektowego zwanego Delegacja, który pomaga oddzielić to, co widzisz w interfejsie, od tego, co dzieje się w aplikacji. Dzięki temu łatwiej zarządzać kodem i wprowadzać zmiany. Fajnie jest, gdy logikę umieszczasz w osobnych metodach, bo wtedy testowanie całej aplikacji staje się prostsze. Przykłady? Możesz na przykład użyć OnClickListenera, żeby zrobić logowanie po kliknięciu przycisku lub wysłać formularz. Pamiętaj też, żeby unikać ciężkich operacji w metodzie onClick, żeby aplikacja działała płynnie.
Pytanie 14
W zestawieniu zaprezentowano doświadczenie zawodowe pracowników firmy IT. Do stworzenia aplikacji front-end powinien/powinna zostać wyznaczony/a
Pracownik
Znajomość technologii lub programów
Anna
Inkscape, Corel Draw
Krzysztof
Angular
Patryk
HTML, CSS
Ewa
Django, .NET
A. KrzysztofPoprawna odpowiedź
B. Anna
C. PatrykTwoja odpowiedź
D. Ewa
Niepoprawna odpowiedź. Anna zna programy graficzne jak Inkscape czy Corel Draw, które są spoko do tworzenia grafiki wektorowej, ale nie nadają się do budowy aplikacji front-end. Te narzędzia bardziej są w rękach grafików, którzy robią ilustracje i projekty wizualne, więc to nie do końca pasuje do front-endu, gdzie liczy się programowanie interakcji i logiki. Patryk ogarnia HTML i CSS, co jest podstawą do stawiania stron, ale niestety to nie wystarczy do budowy nowoczesnych aplikacji front-end. Musi znasz również frameworki JavaScript, takie jak Angular, React czy Vue.js, żeby aplikacja była interaktywna i by dało się z danymi lepiej zarządzać. Ewa ma umiejętności w Django i .NET, które są używane po stronie serwera. Django to framework w Pythonie, a .NET obsługuje różne języki, w tym C#. Te technologie są super do backendu, ale do front-endu już nie bardzo. Dlatego Ewa może być świetna w budowie serwerowej części aplikacji, ale nie w tworzeniu interfejsu użytkownika. Zrozumienie różnic między backendem a frontendem jest kluczowe, bo jeśli wybierzesz niewłaściwą osobę do zadania, mogą być kłopoty z integracją i wydajnością aplikacji. Dlatego ważne, żeby do front-endu był ktoś z odpowiednim doświadczeniem, tak jak Krzysztof, który zna Angulara.
Pytanie 15
Algorytm zaprezentowany w zadaniu można zrealizować w języku Java wykorzystując instrukcję
A.
if
Twoja odpowiedź
B.
switch
C.
try
D.
while
Poprawna odpowiedź
Niepoprawna odpowiedź. Rozwiązanie problemu przy użyciu instrukcji if jest niewłaściwe, ponieważ instrukcja if służy do wykonywania pojedynczego bloku kodu raz na podstawie spełnienia danego warunku. Nie jest ona przeznaczona do iteracyjnego wykonywania operacji, co jest wymagane w przedstawionym algorytmie. Zastosowanie jej w tym kontekście oznaczałoby konieczność ręcznego powtarzania kodu, co jest nieefektywne i niezgodne z zasadami DRY (Don't Repeat Yourself). Instrukcja switch również nie jest odpowiednia do tego zadania. Switch jest używany do selekcji jednej spośród wielu możliwych ścieżek wykonania na podstawie wartości wyrażenia, zazwyczaj typu całkowitego. Nie obsługuje dynamicznych iteracji ani nie pozwala na wykonywanie kodu w pętli na podstawie zmiany wartości warunku. Instrukcja try w Javie służy do obsługi wyjątków i nie jest konstrukcją służącą do kontrolowania przepływu iteracyjnego. Jej użycie w tym kontekście byłoby nie tylko niepoprawne, ale i niezgodne z praktykami programistycznymi dotyczącymi obsługi błędów. Często spotykanym błędem jest mylenie konstrukcji kontrolujących przepływ wykonania programu z mechanizmami obsługi wyjątków czy wyrażeń selekcyjnych. Prawidłowe zrozumienie różnic między tymi konstrukcjami jest kluczowe w efektywnym programowaniu i pozwala na tworzenie czytelnych i zoptymalizowanych aplikacji. Każda z tych konstrukcji ma swoje specyficzne zastosowanie i znajomość ich właściwego użycia jest istotnym elementem wiedzy każdego programisty Java, co wpływa na jakość i wydajność tworzonych aplikacji.
Pytanie 16
W przypadku przedstawionych kodów źródłowych, które są funkcjonalnie równoważne, wartość, która zostanie zapisana w zmiennej b po wykonaniu operacji, to
Python:
C++ / C# / Java:
x = 5.96; b = int(x);
double x = 5.96; int b = (int)x;
A. 6
B. 596
C. 5Twoja odpowiedź
D. 5.96
Poprawna odpowiedź. W tym zadaniu mamy do czynienia z fajnym przykładem konwersji liczby 5.96 na liczbę całkowitą w różnych językach, takich jak Python czy C++. Kiedy robimy rzutowanie, to po prostu odcinamy część ułamkową, co daje nam 5 w zmiennej b. To jest trochę klasyczne rzutowanie albo konwersja typu, gdzie w większości języków po prostu się to robi. Ciekawostką jest, że w Pythonie działa to przez funkcję int(), która zawsze zaokrągla w dół. A w C++ czy Javie używasz po prostu (int) i efekt jest ten sam. Warto też zwrócić uwagę, że przy liczbach ujemnych rzutowanie działa inaczej, bo zawsze zmierza w stronę zera. Z doświadczenia wiem, że warto być świadomym użycia takich konwersji, bo w niektórych przypadkach, jak operacje finansowe, nawet małe różnice mogą się okazać bardzo istotne.
Pytanie 17
Jednym z kroków przy publikacji aplikacji mobilnej w sklepie Google Play są testy Beta, które charakteryzują się tym, że są one
A. przeprowadzane przez grupę docelowych użytkowników aplikacjiPoprawna odpowiedź
B. realizowane przez zespół testerów zatrudnionych przez firmę GoogleTwoja odpowiedź
C. podzielone na testy funkcjonalne, wydajnościowe oraz skalowalności
D. przeprowadzane na podstawie dokumentu zawierającego przypadki testowe
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi wskazuje na to, że testy Beta są wykonywane przez grupę zatrudnionych testerów z firmy Google. Jest to błędne założenie, ponieważ testy Beta są w rzeczywistości przeprowadzane przez rzeczywistych użytkowników, którzy nie są profesjonalnymi testerami. Użytkownicy ci mogą być entuzjastami technologii, a ich opinie są wartościowe, ponieważ odzwierciedlają rzeczywiste doświadczenia i oczekiwania rynku. Kolejna niepoprawna odpowiedź sugeruje, że testy Beta są podzielone na testy funkcjonalne, wydajnościowe i skalowalności. Choć te kategorie testów są istotne w cyklu życia oprogramowania, testy Beta koncentrują się głównie na ogólnym doświadczeniu użytkownika i funkcjonalności aplikacji w praktyce. Ostatnia niepoprawna odpowiedź wskazuje, że testy Beta są przeprowadzane w oparciu o dokument z przypadkami testowymi. W rzeczywistości, testy Beta są bardziej elastyczne i opierają się na rzeczywistych interakcjach użytkowników z aplikacją, co oznacza, że nie są one sztywno zdefiniowane przez dokumentację, a raczej na podstawie ich naturalnego użytkowania. Wszelkie założenia dotyczące formalnych przypadków testowych są więc mylące w kontekście testów Beta.
Pytanie 18
Jak wygląda kod uzupełnienia do dwóch dla liczby -5 w formacie binarnym przy użyciu 8 bitów?
A. 11111011Poprawna odpowiedź
B. 00000101Twoja odpowiedź
C. 11111101
D. 10000101
Niepoprawna odpowiedź. Pierwsza z niepoprawnych odpowiedzi, która przedstawia wartość 00000101, jest błędna, ponieważ jest to binarna reprezentacja liczby 5, a nie -5. Kod uzupełnieniowy do dwóch wymaga przedstawienia liczby ujemnej poprzez inwersję bitów i dodanie jedynki. Ta odpowiedź nie ma zastosowania przy obliczaniu liczb ujemnych, stąd jest niewłaściwa. Kolejna odpowiedź, 11111101, również jest nieprawidłowa. W przypadku tej liczby, zainwersowanie bitów liczby 5 dawałoby 11111010, a dodanie 1 do tej wartości prowadziłoby do 11111011, co wskazuje, że ta odpowiedź nie jest zgodna z zasadą uzupełnienia do dwóch. Ostatnia z niepoprawnych odpowiedzi, 10000101, jest również błędna, ponieważ nie odpowiada żadnej z reprezentacji liczby -5. Gdybyśmy spróbowali konwertować ją z powrotem na wartość dziesiętną, otrzymalibyśmy 133, co jest zdecydowanie niepoprawne. Warto zauważyć, że każda z tych niepoprawnych odpowiedzi wskazuje na brak zrozumienia zasad konwersji liczb ujemnych w systemie binarnym, co jest kluczowe w informatyce i programowaniu, a ich użycie w praktycznych aplikacjach mogłoby prowadzić do poważnych błędów w obliczeniach.
Pytanie 19
Jakie z wymienionych czynności może zagrażać cyfrowej tożsamości?
A. Tworzenie unikalnych oraz mocnych haseł
B. Klikanie w podejrzane linki w wiadomościach e-mailTwoja odpowiedź
C. Cykliczna zmiana haseł do kont
D. Aktywacja uwierzytelniania dwuskładnikowego
Poprawna odpowiedź. Klikanie w podejrzane linki w wiadomościach e-mail to jedno z najczęstszych źródeł infekcji i naruszenia cyfrowej tożsamości. Cyberprzestępcy często wykorzystują phishing, czyli technikę polegającą na wysyłaniu fałszywych wiadomości, które wyglądają na autentyczne. Kliknięcie w link może prowadzić do zainstalowania złośliwego oprogramowania lub przekierowania na stronę wyłudzającą dane logowania. Aby uniknąć tego zagrożenia, zaleca się sprawdzanie adresu nadawcy, unikanie otwierania załączników z nieznanych źródeł i korzystanie z filtrów antyphishingowych.
Pytanie 20
Która z wymienionych sytuacji stanowi naruszenie praw autorskich?
A. Używanie programu typu open-source zgodnie z warunkami licencji
B. Udostępnianie filmu objętego prawami autorskimi bez zgody właścicielaTwoja odpowiedź
C. Nabycie licencji na oprogramowanie
D. Tworzenie kopii zapasowej legalnie zakupionego programu
Poprawna odpowiedź. Publikowanie filmu chronionego prawami autorskimi bez zgody właściciela jest naruszeniem praw autorskich. Prawa autorskie chronią twórców przed nieuprawnionym kopiowaniem, dystrybucją i rozpowszechnianiem ich dzieł. W przypadku filmów, muzyki czy oprogramowania, każde użycie bez odpowiednich licencji lub zgody właściciela jest niezgodne z prawem. Twórcy mają prawo do wynagrodzenia za swoją pracę, a naruszenia mogą skutkować wysokimi grzywnami, a nawet postępowaniem sądowym. Przestrzeganie praw autorskich wspiera rozwój kultury i technologii, chroniąc interesy twórców.
Pytanie 21
Jakiego rodzaju zmiennej użyjesz w C++, aby przechować wartość "true"?
A. tekst
B. boolTwoja odpowiedź
C. liczba całkowita
D. liczba zmiennoprzecinkowa
Poprawna odpowiedź. Typ danych 'bool' w języku C++ jest przeznaczony do przechowywania wartości 'true' lub 'false'. Deklaracja 'bool isReady = true;' to przykład poprawnego przypisania wartości logicznej do zmiennej. Typ boolean jest kluczowy w warunkach decyzyjnych, pętlach i operacjach porównawczych. W programowaniu typ 'bool' jest wykorzystywany do kontroli przepływu programu, obsługi wyjątków oraz sprawdzania poprawności danych. Użycie booleanów w kodzie zwiększa jego czytelność i pozwala na bardziej przejrzyste budowanie logiki aplikacji.
Pytanie 22Strzał
Który z wymienionych typów kolekcji pozwala na dostęp do ostatnio dodanego elementu w pierwszej kolejności?
A. Lista
B. StosPoprawna odpowiedź
C. Kolejka
D. Tablica dwuwymiarowaTwoja odpowiedź
Niepoprawna odpowiedź. Lista to struktura liniowa, która umożliwia dostęp do dowolnego elementu, ale nie działa na zasadzie LIFO. Kolejka działa zgodnie z zasadą FIFO (First In First Out) i przechowuje elementy w kolejności ich dodania. Tablica dwuwymiarowa to struktura do przechowywania danych w postaci macierzy, ale nie działa na zasadzie LIFO ani FIFO, lecz umożliwia dostęp do danych za pomocą indeksów.
Pytanie 23Strzał
W jakich sytuacjach zastosowanie rekurencji może być bardziej korzystne niż użycie iteracji?
A. Kiedy liczba iteracji przewyższa maksymalny zakres zmiennej licznikowej
B. Gdy algorytm wymaga naturalnego podziału na mniejsze podproblemyPoprawna odpowiedź
C. Kiedy program jest uruchamiany w środowisku wielowątkowymTwoja odpowiedź
D. Gdy kod źródłowy ma być zoptymalizowany dla starszych kompilatorów
Niepoprawna odpowiedź. Przekroczenie zakresu zmiennej licznikowej nie jest powodem, dla którego rekurencja jest bardziej efektywna. Problemy z zakresami zmiennych licznikowych można rozwiązać poprzez odpowiedni dobór typów danych, a nie przez zastosowanie rekurencji. Programowanie wielowątkowe nie jest bezpośrednio związane z rekurencją – chociaż niektóre algorytmy rekurencyjne mogą być implementowane w środowisku wielowątkowym, nie jest to ich główne zastosowanie. Optymalizacja kodu dla starszych kompilatorów nie ma związku z rekurencją, ponieważ starsze kompilatory mogą mieć ograniczoną obsługę rekurencji lub generować mniej efektywny kod rekurencyjny.
Pytanie 24
Jakie znaczenie ma deklaracja zmiennej w programowaniu?
A. Stworzenie nowej wartości w bazie danych
B. Określenie typu oraz nazwy zmiennej w kodzie programuTwoja odpowiedź
C. Przypisanie zmiennej wartości domyślnej
D. Zarezerwowanie miejsca w pamięci dla wyników operacji arytmetycznych
Poprawna odpowiedź. Deklaracja zmiennej to podstawowy krok w programowaniu, który polega na określeniu typu oraz nazwy zmiennej, zanim zostanie do niej przypisana wartość. W językach takich jak C++, Java, czy C# deklaracja wygląda na przykład tak: `int liczba;`. Określenie typu zmiennej pozwala kompilatorowi lub interpreterowi zarezerwować odpowiednią ilość pamięci oraz kontrolować, jakie operacje mogą być na niej wykonywane. Deklaracja zmiennej zwiększa czytelność kodu, umożliwia wykrywanie błędów na wczesnym etapie kompilacji i jest kluczowa w zarządzaniu zasobami aplikacji.
Pytanie 25
Która metoda w obrębie klasy jest uruchamiana automatycznie podczas tworzenia kopii obiektu?
A. Metoda statyczna
B. Konstruktor kopiującyTwoja odpowiedź
C. Destruktor
D. Metoda zaprzyjaźniona
Poprawna odpowiedź. Konstruktor kopiujący to taka specyficzna metoda w klasie, która działa, kiedy robimy nowy obiekt jako kopię już istniejącego. Dzięki temu możemy skopiować wartości pól z jednego obiektu do drugiego. To naprawdę ważne, zwłaszcza gdy mówimy o zarządzaniu pamięcią. Na przykład w C++ może to wyglądać tak: `Samochod(const Samochod &inny) { marka = inny.marka; przebieg = inny.przebieg; }`. Konstruktor kopiujący ma na celu uniknięcie problemów związanych z tzw. płytkim kopiowaniem, co może prowadzić do różnych błędów, jak wielokrotne zwolnienie tej samej pamięci. Generalnie mówiąc, jest to kluczowy mechanizm, który pomaga utrzymać bezpieczeństwo i poprawność działania naszej aplikacji.
Pytanie 26
Które z poniższych zdań najlepiej określa funkcję zaprzyjaźnioną w ramach klasy?
A. Funkcja, która uruchamia się automatycznie po stworzeniu obiektu
B. Funkcja, która ma dostęp do prywatnych pól i metod klasy, z którą jest zaprzyjaźnionaTwoja odpowiedź
C. Funkcja, która pozwala na dziedziczenie wielokrotne
D. Funkcja, która jest statyczna i nie ma możliwości modyfikacji pól klasy
Poprawna odpowiedź. Funkcja zaprzyjaźniona (ang. friend function) to funkcja, która ma dostęp do prywatnych i chronionych pól oraz metod klasy, mimo że nie jest jej częścią. Służy do realizacji operacji wymagających bezpośredniego dostępu do wewnętrznych elementów klasy, ale bez naruszania zasad hermetyzacji. Przykład w C++: `class Konto { private: double saldo; friend void wyswietlSaldo(Konto k); }`. Funkcja `wyswietlSaldo` może odczytać pole `saldo`, mimo że jest ono prywatne. Funkcje zaprzyjaźnione są używane, gdy konieczna jest bliska współpraca między klasami lub funkcjami, ale nie chcemy nadmiernie otwierać interfejsu klasy.
Pytanie 27
Jaką rolę pełni element statyczny w klasie?
A. Pozwala na dynamiczne dodawanie nowych metod
B. Zachowuje wspólną wartość dla wszystkich instancji tej klasyTwoja odpowiedź
C. Ogranicza dostęp do metod publicznych w klasie
D. Automatycznie likwiduje obiekty klasy po zakończeniu działania programu
Poprawna odpowiedź. Składnik statyczny klasy przechowuje wartości współdzielone przez wszystkie obiekty tej klasy. Jest to jedno z najbardziej efektywnych narzędzi w programowaniu obiektowym, pozwalające na ograniczenie zużycia pamięci oraz zapewnienie spójności danych. Główna rola składnika statycznego polega na utrzymaniu jednej kopii zmiennej lub metody, która jest dostępna niezależnie od liczby instancji klasy. To oznacza, że zmiana wartości składowej statycznej jest natychmiast widoczna dla wszystkich obiektów klasy. Przykładem jest licznik instancji klasy lub konfiguracja globalna aplikacji, gdzie statyczność pozwala na scentralizowanie danych i ich jednolite zarządzanie.
Pytanie 28
W jakiej sytuacji należy ułożyć poszkodowanego w pozycji bezpiecznej?
A. Kiedy poszkodowany jest przytomny, ale ma uraz kończyny
B. Kiedy poszkodowany jest nieprzytomny, ale oddychaTwoja odpowiedź
C. Kiedy poszkodowany nie oddycha
D. Kiedy poszkodowany ma krwotok zewnętrzny
Poprawna odpowiedź. Pozycję bezpieczną stosuje się wtedy, gdy poszkodowany jest nieprzytomny, ale oddycha prawidłowo. To bardzo ważne rozróżnienie, bo taka osoba nie kontroluje w pełni swoich mięśni, język może opaść do tyłu, a wymiociny albo ślina mogą zablokować drogi oddechowe. Ułożenie na boku, z odchyloną głową i stabilnym podparciem ciała, pomaga utrzymać drożność dróg oddechowych i zmniejsza ryzyko zachłyśnięcia. Z mojego doświadczenia to jedna z tych czynności, które wyglądają prosto, ale w stresie łatwo o pomyłkę, więc warto ją dobrze przećwiczyć praktycznie. Zgodnie z zasadami pierwszej pomocy najpierw oceniamy bezpieczeństwo miejsca, sprawdzamy reakcję poszkodowanego, udrażniamy drogi oddechowe i kontrolujemy oddech przez około 10 sekund. Jeśli oddech jest obecny, wzywamy pomoc pod 112 lub 999 i układamy poszkodowanego w pozycji bezpiecznej, cały czas monitorując oddech. Gdyby oddech zanikł, trzeba natychmiast obrócić osobę na plecy i rozpocząć RKO. W praktyce, np. w szkole, pracowni komputerowej czy na korytarzu, taka reakcja może naprawdę uratować komuś życie, bo zabezpiecza najważniejszą funkcję życiową: oddychanie.
Pytanie 29
Jakie są główne różnice między środowiskiem RAD (Rapid Application Development) a klasycznymi IDE?
A. RAD koncentruje się tylko na testowaniu programów
B. RAD pozwala na szybkie tworzenie prototypów i rozwijanie aplikacji przy minimalnej ilości koduTwoja odpowiedź
C. RAD nie oferuje żadnych narzędzi do debugowania
D. RAD funkcjonuje tylko w systemach operacyjnych Linux
Poprawna odpowiedź. RAD (Rapid Application Development) to metodologia tworzenia oprogramowania, która kładzie nacisk na szybkie prototypowanie i iteracyjne podejście do rozwoju aplikacji, minimalizując czas poświęcany na pisanie kodu od podstaw. Kluczowym aspektem RAD jest możliwość szybkiego dostosowywania aplikacji do zmieniających się wymagań biznesowych oraz ciągła interakcja z klientem. Narzędzia RAD, takie jak Visual Studio, Delphi czy OutSystems, pozwalają na budowanie aplikacji przy użyciu graficznych interfejsów, gotowych komponentów i automatycznego generowania kodu, co znacząco skraca czas wprowadzenia produktu na rynek. RAD doskonale sprawdza się w przypadku projektów o krótkim cyklu życia i wymagających szybkich zmian.
Pytanie 30
Jakie środowisko deweloperskie jest powszechnie wykorzystywane do produkcji aplikacji webowych w języku Java?
A. EclipseTwoja odpowiedź
B. XCode
C. Android Studio
D. PyCharm
Poprawna odpowiedź. Eclipse to jedno z najpopularniejszych środowisk programistycznych (IDE) wykorzystywanych do tworzenia aplikacji webowych w języku Java. Jest to potężne narzędzie, które wspiera zarówno tworzenie aplikacji desktopowych, jak i rozbudowanych systemów backendowych. Eclipse oferuje wiele wtyczek i rozszerzeń umożliwiających integrację z narzędziami do zarządzania bazami danych, serwerami aplikacji oraz systemami kontroli wersji. Dzięki temu programiści mogą efektywnie budować i testować aplikacje webowe napisane w Javie.
Pytanie 31
Jaki komponent środowiska IDE jest niezbędny do tworzenia aplikacji webowych?
A. Narzędzie do tworzenia grafiki
B. Emulator urządzeń mobilnych
C. Debugger, edytor kodu, integracja z systemem kontroli wersjiTwoja odpowiedź
D. Zarządzanie bazami danych
Poprawna odpowiedź. Debugger, edytor kodu oraz integracja z systemem kontroli wersji to kluczowe elementy środowiska IDE, które umożliwiają efektywną pracę nad aplikacjami webowymi. Debugger pozwala na wykrywanie i naprawianie błędów w czasie rzeczywistym, edytor kodu umożliwia szybkie pisanie i modyfikowanie kodu, a integracja z systemem kontroli wersji (np. Git) pozwala śledzić zmiany i współpracować w zespołach programistycznych. Te narzędzia stanowią podstawę pracy każdego dewelopera webowego.
Pytanie 32
Jakie informacje mogą być zapisywane w cookies przeglądarki?
A. Prywatne dane użytkownika, na przykład hasła
B. Preferencje użytkownika, takie jak język lub styl stronyTwoja odpowiedź
C. Dane przechowywane w systemie baz danych
D. Kod źródłowy aplikacji internetowej
Poprawna odpowiedź. Preferencje użytkownika, takie jak język strony, motyw kolorystyczny lub preferencje dotyczące układu, są typowymi danymi przechowywanymi w ciasteczkach przeglądarki. Mechanizm ciasteczek pozwala na personalizację doświadczenia użytkownika i jest szeroko stosowany w aplikacjach webowych w celu dostosowania interfejsu do indywidualnych potrzeb. Cookies umożliwiają także zapamiętywanie sesji użytkownika, co pozwala uniknąć konieczności wielokrotnego logowania. Informacje te są przechowywane lokalnie w przeglądarce użytkownika i mogą być odczytywane przez aplikację podczas każdej wizyty. Stosowanie ciasteczek zgodnie z przepisami, takimi jak RODO (GDPR), wymaga informowania użytkownika o ich przeznaczeniu oraz uzyskiwania jego zgody na ich przechowywanie, co zapewnia transparentność i zgodność z prawem.
Pytanie 33
Która z poniższych technologii nie jest używana do tworzenia aplikacji mobilnych?
A. COBOLTwoja odpowiedź
B. Kotlin
C. React Native
D. Flutter
Poprawna odpowiedź. COBOL, czyli Common Business Oriented Language, jest językiem programowania opracowanym w latach 50. XX wieku, głównie do zastosowań w administracji i biznesie, takich jak systemy bankowe czy zarządzanie danymi. Nie jest on przeznaczony do tworzenia aplikacji mobilnych, które wymagają nowoczesnych technologii i frameworków dostosowanych do dynamicznego rozwoju rynku. W przeciwieństwie do Kotlin, React Native i Flutter, które są współczesnymi technologiami umożliwiającymi tworzenie aplikacji mobilnych, COBOL nie posiada narzędzi ani bibliotek, które wspierałyby rozwój aplikacji na systemy iOS czy Android. W praktyce, programiści wykorzystujący te nowoczesne technologie, mogą tworzyć aplikacje, które są responsywne i działają płynnie na różnych urządzeniach mobilnych, co znacząco wpływa na doświadczenia użytkowników. Warto zatem znać różnice między tymi technologiami, aby dobrze zrozumieć, jakie języki i narzędzia są adekwatne do danego projektu.
Pytanie 34Strzał
Który z poniższych jest popularnym systemem zarządzania bazami danych NoSQL?
A. MongoDBPoprawna odpowiedź
B. MySQL
C. PostgreSQLTwoja odpowiedź
D. Oracle
Niepoprawna odpowiedź. MySQL, PostgreSQL i Oracle to systemy zarządzania bazami danych, które opierają się na tradycyjnym modelu relacyjnym, co oznacza, że są zoptymalizowane do pracy z danymi, które mają ustaloną strukturę, często w postaci tabel. W tym kontekście, ich architektura i sposób przechowywania danych różnią się znacznie od systemów NoSQL, takich jak MongoDB. MySQL i PostgreSQL są znane jako bazy danych SQL, co oznacza, że wykorzystują język zapytań SQL do interakcji z danymi. Dzięki temu są one szczególnie skuteczne w przypadkach, gdzie dane mają ściśle zdefiniowaną strukturę i relacje między nimi są kluczowe, ale mogą być mniej elastyczne w obsłudze danych o zróżnicowanej strukturze. Oracle to z kolei jeden z najbardziej rozbudowanych i kompleksowych systemów zarządzania bazami danych, jednak jego złożoność oraz koszty mogą być barierą dla mniejszych projektów. Wybierając system zarządzania bazą danych, warto zwrócić uwagę na specyfikę wymagań aplikacji oraz rodzaj przechowywanych danych. Przyjęcie błędnych założeń co do modelu danych może prowadzić do trudności w skalowaniu, ograniczonej wydajności oraz większych kosztów utrzymania. Dlatego kluczowe jest zrozumienie, że wybór między systemami SQL a NoSQL powinien być uzależniony od charakterystyki danych i wymagań projektowych.
Pytanie 35
Co to jest CORS (Cross-Origin Resource Sharing)?
A. Mechanizm bezpieczeństwa, który określa, które domeny mogą uzyskiwać dostęp do zasobów na serwerzeTwoja odpowiedź
B. Protokół komunikacji między różnymi bazami danych
C. Metoda udostępniania API dla aplikacji mobilnych
D. Technika optymalizacji ładowania zasobów statycznych
Poprawna odpowiedź. CORS, czyli Cross-Origin Resource Sharing, to mechanizm bezpieczeństwa stosowany w aplikacjach internetowych, który reguluje, które zewnętrzne domeny mają prawo uzyskiwać dostęp do zasobów na serwerze. Jest to szczególnie istotne w kontekście aplikacji klienckich działających w przeglądarkach, gdzie zapytania do różnych źródeł (tzw. cross-origin requests) mogą prowadzić do problemów z bezpieczeństwem, takich jak ataki typu CSRF (Cross-Site Request Forgery) czy XSS (Cross-Site Scripting). Przykładowo, jeśli aplikacja internetowa hostowana na domenie A próbuje uzyskać dane z API na domenie B, serwer na domenie B może poprzez nagłówki CORS określić, czy i jakie żądania od domeny A będą honorowane. Przy odpowiedniej konfiguracji, serwer może zezwolić na dostęp tylko dla zaufanych źródeł, co zapobiega nieautoryzowanym operacjom. W praktyce, stosowanie CORS przyczynia się do stworzenia bezpieczniejszych aplikacji webowych, zgodnych z aktualnymi standardami bezpieczeństwa w sieci, takimi jak W3C i OWASP.
Pytanie 36
Jaka będzie zawartość zmiennej filteredItems po wykonaniu poniższego kodu?
Poprawna odpowiedź. Zmienna filteredItems zawiera tylko te elementy, których cena jest większa niż 600. W tym przypadku w tablicy items mamy trzy obiekty: 'phone' z ceną 500, 'laptop' z ceną 1000 oraz 'tablet' z ceną 750. Funkcja filter przeszukuje tablicę items i zwraca tylko te obiekty, które spełniają warunek price > 600, co daje nam 'laptop' oraz 'tablet'. Następnie, metoda map przekształca te obiekty w tablicę ich nazw, co skutkuje finalnym wynikiem ['laptop', 'tablet']. Takie podejście do filtrowania danych i mapowania ich na inne wartości jest niezwykle przydatne w programowaniu, szczególnie w pracy z danymi, gdzie często potrzebujemy wyodrębnić i przekształcić dane w bardziej użyteczne formy. Użycie metod filter i map jest zgodne z najlepszymi praktykami w JavaScript i przyczynia się do bardziej czytelnego oraz zwięzłego kodu.
Pytanie 37
Które narzędzie najlepiej nadaje się do analizy wydajności aplikacji JavaScript?
A. Chrome DevTools PerformanceTwoja odpowiedź
B. Webpack
C. Babel
D. npm
Poprawna odpowiedź. Chrome DevTools Performance to potężne narzędzie, które jest integralną częścią przeglądarki Google Chrome i służy do analizy wydajności aplikacji JavaScript. Dzięki niemu możemy monitorować czas ładowania, identyfikować wąskie gardła w kodzie oraz analizować, jak różne elementy strony wpływają na ogólną wydajność. Narzędzie to umożliwia nagrywanie sesji wydajności, co pozwala na szczegółowe zbadanie, jak różne operacje wpływają na czas odpowiedzi aplikacji. Przykładowo, możemy użyć DevTools do analizy, które skrypty zajmują najwięcej czasu lub które zadania blokują wątek główny, co jest kluczowe dla zapewnienia płynności interfejsu użytkownika. Dodatkowo, narzędzie to oferuje różne metryki, takie jak FPS (frames per second), co jest niezbędne do oceny płynności animacji. Warto również podkreślić, że DevTools jest zgodne z najlepszymi praktykami branżowymi, a jego umiejętne wykorzystanie może znacząco poprawić jakość aplikacji.
Pytanie 38Strzał
Co oznacza pojęcie 'hoisting' w JavaScript?
A. Proces podnoszenia deklaracji zmiennych i funkcji na górę zakresuPoprawna odpowiedź
B. Technika optymalizacji kodu przez silnik JavaScript
C. Mechanizm zarządzania pamięcią w przeglądarce
D. Metoda ładowania skryptów z zewnętrznych źródełTwoja odpowiedź
Niepoprawna odpowiedź. Omawiając inne odpowiedzi, warto zauważyć, że niektóre z nich mogą wprowadzać w błąd. Na przykład, technika optymalizacji kodu przez silnik JavaScript nie ma nic wspólnego z hoistingiem. Hoisting nie jest związany z optymalizacją, ale z tym, jak JavaScript interpretuje kod. Optymalizacja kodu odnosi się do sposobu, w jaki silniki JavaScript, takie jak V8, przetwarzają kod, aby działał szybciej, poprzez różne techniki, takie jak JIT (Just-In-Time) compilation, a nie przez przenoszenie deklaracji. Z kolei mechanizm zarządzania pamięcią dotyczy sposobu, w jaki JavaScript radzi sobie z pamięcią w czasie wykonania, co również nie jest bezpośrednio związane z hoistingiem. Pamięć jest zarządzana przez garbage collector, który usuwa nieużywane obiekty. Metoda ładowania skryptów z zewnętrznych źródeł także nie ma związku z hoistingiem, ponieważ odnosi się to do sposobu, w jaki zasoby są pobierane i wykonywane w przeglądarkach. Wszystkie te koncepcje, choć dotyczą JavaScriptu, nie mają związku z mechanizmem hoistingu, co prowadzi do powszechnych nieporozumień wśród programistów. Dlatego tak ważne jest zrozumienie, jak działa hoisting, aby uniknąć błędów w kodzie oraz poprawić zrozumienie działania JavaScriptu.
Pytanie 39
Które z poniższych nie jest wzorcem architektonicznym aplikacji mobilnych?
A. Linear Sequential FlowPoprawna odpowiedź
B. MVC (Model-View-Controller)
C. MVVM (Model-View-ViewModel)
D. Clean ArchitectureTwoja odpowiedź
Niepoprawna odpowiedź. Wszystkie wymienione odpowiedzi, z wyjątkiem Linear Sequential Flow, są uznawane za wzorce architektoniczne aplikacji mobilnych. MVC, MVVM i Clean Architecture to powszechnie stosowane podejścia, które mają swoje unikalne cechy i zalety. MVC, czyli Model-View-Controller, dzieli aplikację na trzy główne komponenty, co ułatwia zarządzanie kodem oraz rozdzielanie logiki biznesowej od logiki prezentacji. Dzięki temu, programiści mogą pracować nad różnymi częściami aplikacji równolegle, co przyspiesza rozwój i ułatwia testowanie. MVVM, z kolei, jest często wykorzystywany w aplikacjach opartych na technologiach takich jak WPF czy Xamarin, gdzie wprowadza dwukierunkowe powiązania danych, co poprawia interaktywność i responsywność aplikacji. Clean Architecture jest bardziej złożonym podejściem, które sugeruje, aby aplikacja była podzielona na warstwy, co ułatwia jej rozwój, testowanie i utrzymanie. Wybierając niewłaściwy wzorzec, jak Linear Sequential Flow, programiści mogą napotkać problemy z elastycznością i możliwością dostosowania aplikacji do zmieniających się wymagań. Często takie podejście prowadzi do tzw. „technical debt”, gdzie trudności w wprowadzaniu zmian kumulują się, co w dłuższym okresie może być kosztowne i czasochłonne.
Pytanie 40
Jakie jest główne zadanie kontrolera w architekturze MVC (Model-View-Controller)?
A. Obsługa logiki biznesowej i przetwarzanie danych wejściowych od użytkownikaPoprawna odpowiedź
B. Przechowywanie danych aplikacjiTwoja odpowiedź
C. Prezentowanie danych użytkownikowi
D. Zarządzanie sesją użytkownika
Niepoprawna odpowiedź. W architekturze MVC każda z trzech warstw pełni ściśle określoną rolę. W przypadku odpowiedzi wskazującej, że kontroler przechowuje dane aplikacji, jest to błędne, ponieważ za przechowywanie i zarządzanie danymi odpowiada model. Model jest odpowiedzialny za dostęp do danych, ich walidację i przechowywanie, co pozwala na zachowanie integralności danych oraz izolację od pozostałych elementów architektury. Odpowiedź sugerująca, że kontroler prezentuje dane użytkownikowi, również jest niepoprawna. Za prezentację danych odpowiada warstwa widoku, która przekształca dane otrzymane z modelu w formę zrozumiałą dla użytkownika. Widok jest odpowiedzialny za interfejs użytkownika i sposób, w jaki dane są wyświetlane. Ostatnia z błędnych odpowiedzi sugeruje, że kontroler zarządza sesją użytkownika. Sesje zazwyczaj są zarządzane na poziomie aplikacji webowej poprzez mechanizmy takie jak cookies czy sesje serwerowe, często poza bezpośrednim zakresem kontrolera w MVC. Choć kontroler może odczytywać dane sesji, jego główna funkcja nie obejmuje bezpośredniego zarządzania nimi. Takie rozdzielenie obowiązków pozwala na większą modularność aplikacji i lepszą separację zadań, co jest kluczowe w efektywnym projektowaniu systemów informatycznych.