Na dołączonym obrazku ukazano proces
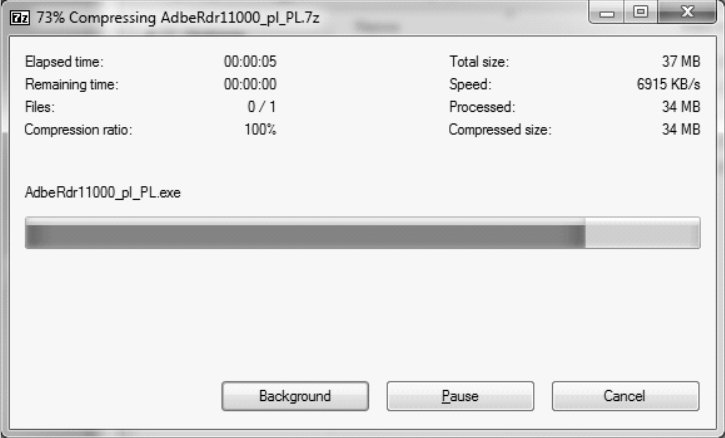
Kompresja danych to proces polegający na zmniejszaniu objętości danych poprzez zastosowanie algorytmów, które eliminują zbędne informacje lub optymalizują ich strukturę. Na załączonym obrazku widzimy interfejs programu 7-Zip, który jest jednym z popularniejszych narzędzi służących do kompresji plików. Proces ten ma na celu zwiększenie efektywności przechowywania i przesyłania danych, co jest szczególnie istotne w przypadku dużych plików lub ograniczonej przestrzeni dyskowej. Kompresja może być stratna lub bezstratna; w przypadku zastosowań, gdzie istotne jest zachowanie integralności danych, najczęściej wybiera się metody bezstratne. W kontekście standardów branżowych, formaty takie jak ZIP, RAR czy 7Z są powszechnie stosowane i wspierane przez większość systemów operacyjnych. Praktyczne zastosowania kompresji danych obejmują archiwizację, redukcję kosztów transferu danych oraz szybsze ładowanie stron internetowych. Kluczowym aspektem jest również znajomość różnicy między metodami kompresji i umiejętność wyboru odpowiedniej w zależności od potrzeb i ograniczeń technologicznych. Dobre praktyki w tej dziedzinie obejmują regularne aktualizowanie narzędzi kompresji oraz świadomość potencjalnych zagrożeń związanych z dekompresją podejrzanych lub nieznanych plików. Kompresja danych odgrywa istotną rolę w informatyce i telekomunikacji, będąc nieodłącznym elementem optymalizacji przepływu informacji.
Błędne zrozumienie procesów takich jak fuzja danych, kasowanie danych czy kompilacja danych może prowadzić do nieprawidłowych wniosków w kontekście operacji związanych z plikami. Fuzja danych to proces, który polega na łączeniu danych z różnych źródeł w jeden spójny zestaw, co jest kluczowe w analityce i big data, jednak nie odnosi się do zmniejszania objętości danych, co jest istotą kompresji. Kompresja jest często mylona z kasowaniem danych, co jest całkowicie odmiennym procesem, mającym na celu usunięcie danych z systemu. Kasowanie jest nieodwracalne w przypadku skasowania danych bez zastosowania kopii zapasowej, a jego celem jest ochrona poufności i zwolnienie przestrzeni dyskowej, nie zaś zmniejszenie rozmiaru plików. Kompilacja danych, z kolei, odnosi się do procesu przekształcania kodu źródłowego w kod wykonywalny przez maszynę, i nie dotyczy samego rozmiaru danych, ale ich formy i interpretacji przez komputer. Typowe błędy to mylenie procesów logicznych z fizycznymi operacjami na danych oraz brak zrozumienia właściwego zastosowania tych procesów w praktykach IT. Ważne jest, aby rozróżniać te procesy oraz znać ich specyfikę i zastosowanie w różnych dziedzinach technologii informatycznych. Rozumienie tych różnic umożliwia bardziej efektywne wykorzystanie narzędzi i technologii w codziennej pracy z systemami komputerowymi, a także unikanie potencjalnych problemów wynikających z niewłaściwego zarządzania danymi.