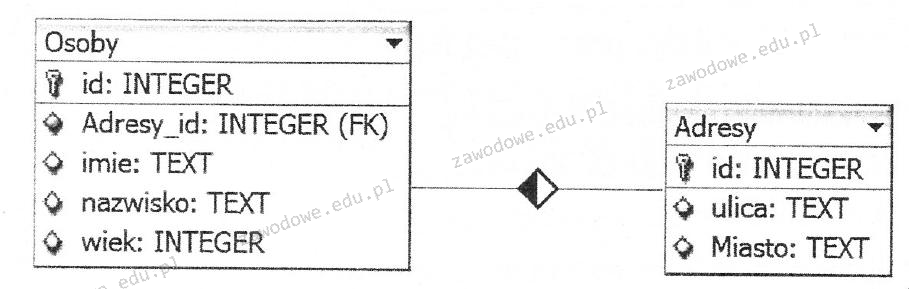
Tabele Osoby i Adresy są połączone relacją jeden do wielu. Które zapytanie SQL, korzystając z tej relacji, wyświetli nazwy miast wraz z liczbą osób przypisanych do każdego z nich?
A.
SELECT Miasto, COUNT(*) FROM Osoby, Adresy GROUP BY Miasto;
B.
SELECT Miasto, COUNT(*) FROM Osoby JOIN Adresy ON Osoby.id = Adresy.id GROUP BY Miasto;
C.
SELECT Miasto, COUNT(*) FROM Osoby JOIN Adresy ON Osoby.Adresy_id = Adresy.id GROUP BY Miasto;
D.
SELECT Miasto, COUNT(*) FROM Osoby JOIN Adresy ON Osoby.Adresy_id = Adresy.id;
Ta odpowiedź jest poprawna, bo wykorzystuje rzeczywistą relację między tabelami: Osoby.Adresy_id jest kluczem obcym wskazującym na Adresy.id. Dzięki warunkowi JOIN ON Osoby.Adresy_id = Adresy.id baza łączy każdą osobę z właściwym rekordem adresu, a potem GROUP BY Miasto grupuje wyniki według miasta. Funkcja COUNT(*) liczy liczbę wierszy w każdej grupie, czyli w praktyce liczbę osób przypisanych do danego miasta. To jest klasyczny przykład zapytania agregującego w SQL, bardzo często używany np. do raportów: ilu klientów mieszka w danym mieście, ilu pracowników jest przypisanych do oddziału albo ile zamówień pochodzi z regionu. Z mojego doświadczenia warto pisać to jeszcze czytelniej z aliasami, np. SELECT a.Miasto, COUNT(o.id) FROM Osoby o JOIN Adresy a ON o.Adresy_id = a.id GROUP BY a.Miasto;. To jest zgodne z dobrą praktyką, bo warunek złączenia opiera się na kluczu obcym, a grupowanie obejmuje kolumnę nieagregowaną z SELECT.
W niepoprawnych podejściach problem polega głównie na tym, że zapytanie albo nie korzysta właściwie z relacji między tabelami, albo miesza agregację z brakiem grupowania. Samo wpisanie dwóch tabel po przecinku w klauzuli FROM nie oznacza jeszcze poprawnego połączenia danych. W standardowym SQL taki zapis bez warunku łączenia tworzy iloczyn kartezjański, czyli każdy rekord z tabeli Osoby zostaje zestawiony z każdym rekordem z tabeli Adresy. Wyniki wtedy są sztucznie pomnożone i COUNT(*) pokazuje liczby, które nie mają sensu biznesowego. To dość częsty błąd, bo na pierwszy rzut oka zapytanie wygląda „jakby działało”, ale raport wychodzi przekłamany. Innym problemem jest łączenie po Osoby.id = Adresy.id. Obie kolumny mogą być kluczami głównymi w swoich tabelach, ale nie opisują tej samej zależności. Identyfikator osoby nie jest identyfikatorem adresu. Relacja na diagramie mówi jasno: klucz obcy znajduje się w Osoby.Adresy_id i dopiero on wskazuje na Adresy.id. Jeśli ktoś łączy po dwóch kolumnach id tylko dlatego, że mają taką samą nazwę, to jest to typowe myślenie „po nazwie”, a nie po modelu danych. Jest też wariant z poprawnym JOIN, ale bez GROUP BY. W standardowym SQL nie powinno się wybierać jednocześnie Miasto i COUNT(*) bez określenia, według czego dane mają być grupowane. Niektóre silniki baz mogą coś zwrócić w luźnym trybie, ale będzie to nieprzenośne i raczej zła praktyka. Moim zdaniem przy takich zadaniach najlepiej zawsze sprawdzić trzy rzeczy: gdzie jest klucz obcy, czy JOIN ma poprawny warunek oraz czy każda kolumna nieagregowana z SELECT występuje w GROUP BY.